ホスティング環境のグラフでは280 tokens per secondといった数字が出ているが、ノートPCで実際に動かすと、ハードウェアやランタイムによって8〜220 tok/sまで大きく変わる。Inkling 2 Miniは、オフラインのコーディングエージェント向けとして有力な選択肢だ。26.4Bのオープンウェイトモデルで、サイズはおよそ20GB。ただし、ダウンロードする前にチャット性能、事実性、API提供状況の弱点は押さえておきたい。
Inkling 2 Miniが向いている人、見送るべき人
Inkling 2 Miniは得意な仕事と苦手な仕事がはっきりしている。ベンチマークの数字を見る前に、まず自分の用途と照らし合わせたい。ツールや検索を組み合わせたオフラインのコーディング支援は得意分野だが、チャット中心の利用やAPIだけで使う用途には向かない。
| 用途 | Miniの評価 |
|---|---|
| 32GB以上のMacまたはDGX Sparkで動かすオフラインのコーディングエージェント | 有力:報告されている最高スコアはこの用途で出ている |
| プライベートな長文脈処理(公称で最大1Mトークン) | 試す価値あり:実運用ではまず32Kコンテキストから |
| マルチターンチャットや厳密な指示追従 | 見送り:この分野はQwen3.8-27Bのほうが良い |
| 現時点でのホスト型API利用 | 見送り:サーバーレス提供はまだなく、確認できるのはサンプリングとファインチューニングの料金のみ |
ここからは、この評価が分かれる理由を数字で見ていく。ループ構造が何を変えるのか、どのベンチマークを信頼できるのか、ローカルでの速度はどの程度なのか、そして価格に何が含まれるのかを整理する。
Inkling 2 Miniの構成とループの仕組み
Thinking Machines Labは2026年11月20日、Apache 2.0ライセンスのオープンウェイトとしてInkling 2 Miniを公開した。重みはHugging Faceでthinkingmachines/Inkling-2-Miniとして配布されている。テキストと画像を入力でき、出力はテキスト。最大コンテキスト長は100万トークンとされている。
| 仕様 | Inkling 2 Mini |
|---|---|
| リリース | 2026年11月20日、Thinking Machines Lab |
| ライセンス | Apache 2.0 |
| パラメータ | 合計26.4B / トークンあたりのアクティブ部分3.4B / ループ込みの実効値5.4B |
| レイヤー | 保存時は24層。中央の12層をトークンごとに3回実行(6 + 3x12 + 6 = 48回の適用) |
| MoEルーティング | 各レイヤーでトークンごとに128個中8個のエキスパートを使用 |
| 精度 | 20層はNVFP4、最後の4層はMXFP8。チェックポイントは約20GB(19.5GB + predictor 0.64GB) |
| コンテキスト / モダリティ | 最大1Mトークン。テキスト+画像入力、テキスト出力 |
| ローカル動作の対象 | Ollama経由で32GB以上のメモリを搭載したMac、またはモデルカードによればNVIDIA DGX Spark 1台 |
3.4Bという数字は、保存されているアクティブパラメータを指す。ループを3回通す計算量まで含めると、実効的にはおよそ5.4B相当になる。重みを再利用することでファイルサイズは小さく抑えられる一方、1トークンあたりの計算量は増える。この仕組みはHugging Faceの技術解説で詳しく説明されている。
ループで増えるのは計算量であって、蓄積された知識ではない。発表時の説明でも、事実の想起については大型のInklingモデルに劣るとされている。知識量は主に総パラメータ数に左右されるため、このモデルでは検索や外部ツールの活用が特に重要になる。
信頼できるベンチマークと、割り引いて見るべき数字
以下のスコアはすべて、Hugging Faceのモデルカードに掲載された同ラボ独自のハーネスによるものだ。Miniはツールを使うコーディングや検索で強く、推論、画像理解、チャットの指示規律では互角か後れを取る。
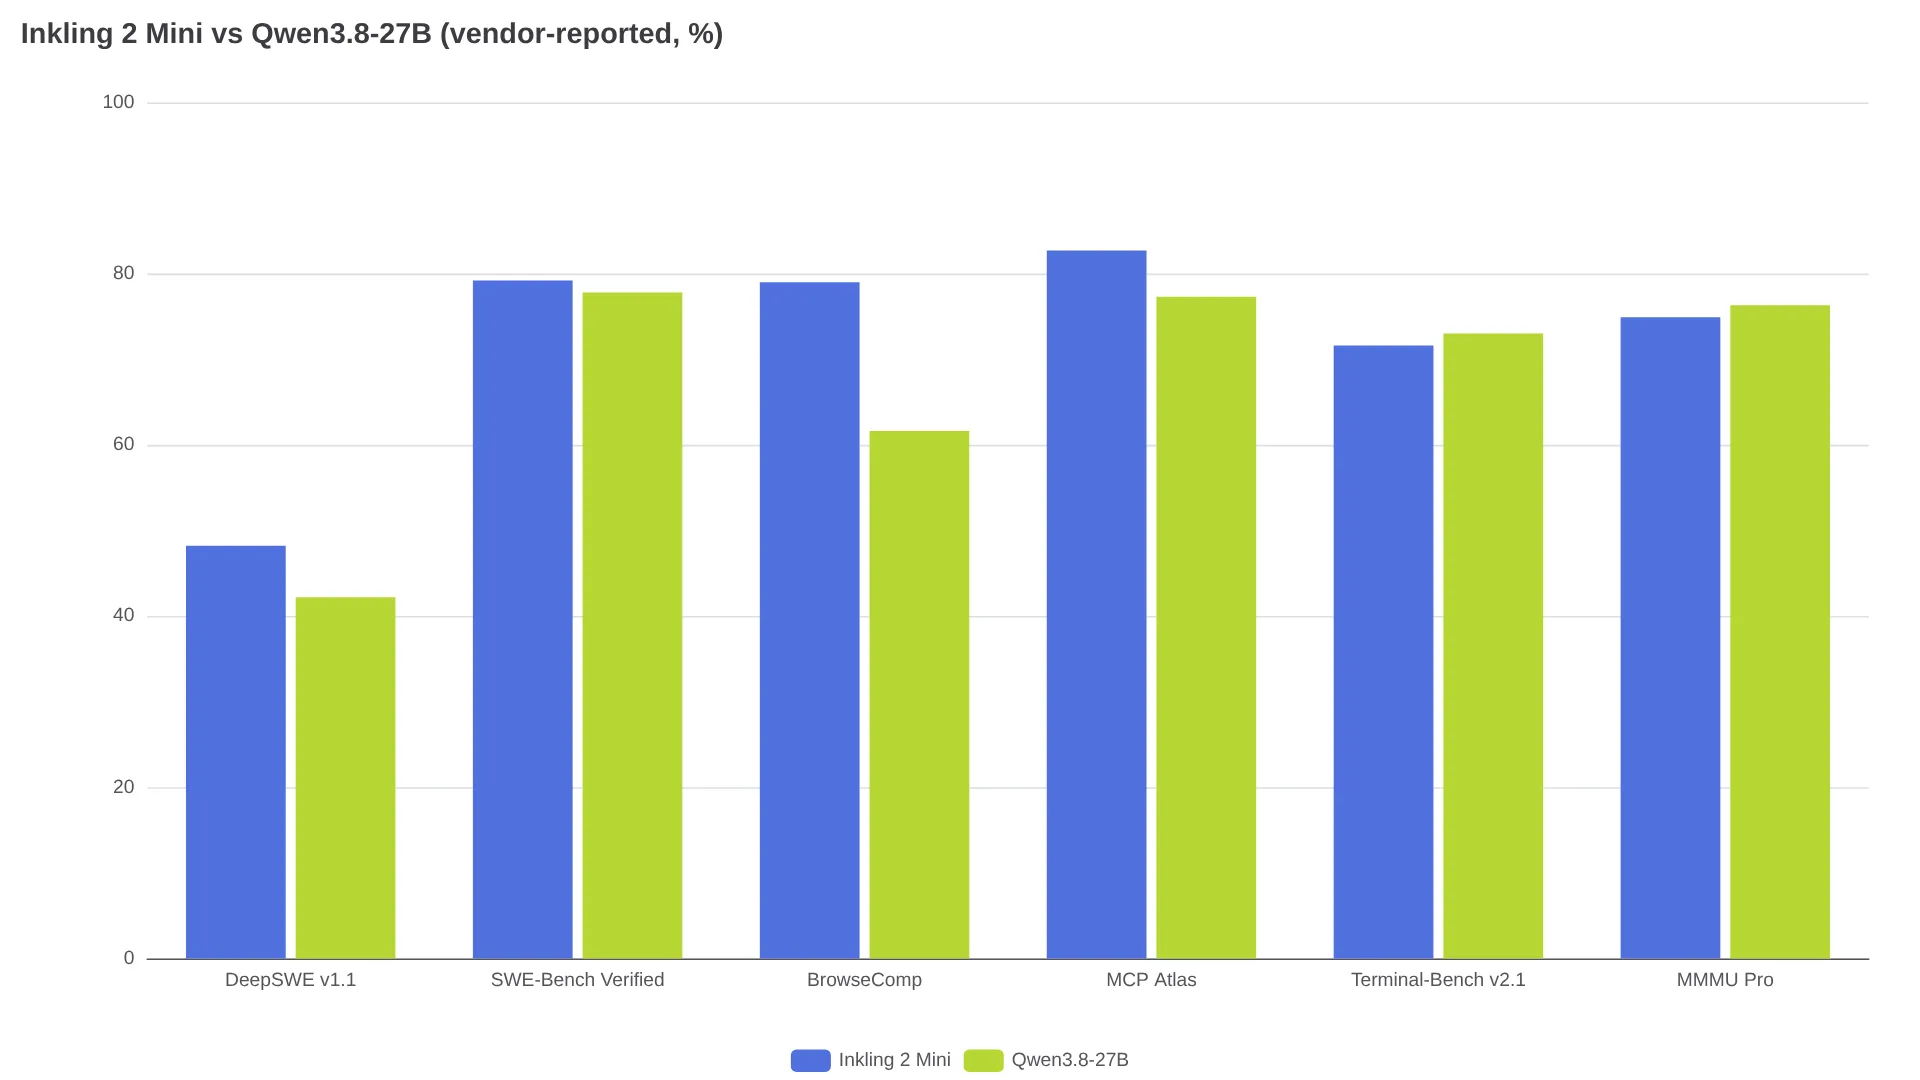
MiniはDeepSWE v1.1で48.2%(Qwen3.8-27Bは42.2%)、SWE-Bench Verifiedで79.2%(77.8%)、BrowseCompで79.0%(61.6%)、MCP Atlasで82.7%(77.3%)とリードしている。Artificial AnalysisのIntelligence Indexでは両モデルとも20.1だが、Miniがインデックスのタスクを終えるまでの時間は9.0分で、Qwenの38.2分を大きく下回った。ARC Prizeでは、最高推論設定でARC-AGI-1が84.5%、ARC-AGI-2が49.3%と報告されている。
一方、同じモデルカードを見ると、Miniが劣る項目もある。HLE-Diamondは15.2%対15.3%、MMMU Proは74.9%対76.3%、Terminal-Bench v2.1は71.6%対73.0%だ。事実性の差はさらに大きく、AA-Omniscienceの非ハルシネーション率は63.4%で、Qwenの71.4%に及ばない。ComplexConstraints(33.4%)とMultiChallenge(50.0%)でもQwenに後れを取っている。
ローカル速度は環境次第で大きく変わる
公式Ollamaの掲載情報とモデルカードが想定しているのは、32GBのMacまたはDGX Sparkだ。ただ、ループ型モデルへの対応がまだ発展途上で、実際の速度にはかなり幅がある。Artificial Analysisでのホスト環境の速度(280 tok/s)は、ノートPCでの速度を予測する指標としては当てにしにくい。
| 環境 | 報告速度 | 出典 |
|---|---|---|
| ホスト型評価(Artificial Analysis) | 280 tok/s | 第三者測定 |
| RTX 4090、パッチ適用済みvLLM + FP8/NVFP4 + drafter | 約190〜220 tok/s | Redditユーザー、パッチ適用後のみ(ベースラインは117) |
| M5 Max MacBook Pro | 約125 tok/s | @alexocheema |
| M1 Max MacBook Pro 64GB、4-bit量子化 | 約20 tok/s | Hacker Newsユーザーgregsadetsky、eeselのローンチレビュー経由 |
| 初期のllama.cppビルド、各種ハードウェア | 約5〜10 tok/s | r/LocalLLMのスレッド |
「5 t/sにすら届かなかった」— u/KURD_1_STAN、r/LocalLLM比較スレッド
この差の大部分は、ランタイムの対応状況と量子化方式で説明できる。現行ビルドは初期ビルドよりループ層をうまく扱えるようになっており、量子化の選択で必要な容量も変わる。Crewmark経由のUnslothガイドによれば、推奨される4-bit構成は約17.6GBに加えて639MBの画像プロジェクターが必要だ。さらに長いコンテキストではKVキャッシュの負荷も増える。
同じレイテンシーで行った決済照合テストでは、Qwenが正解率98.2%、誤マッチ0件だったのに対し、Miniは正解率96.9%、誤マッチ5件だった。
「実際の決済照合ワークロードでInkling 2 MiniとQwen3.8-27Bをテストした……Qwen:正解率98.2%、誤マッチ0件……Inkling:96.9%、誤マッチ5件……この仕事ではQwenを使い続ける」— @exebat3(投稿)
実用上は、まず32Kコンテキストから始め、メモリが厳しければ下げるのが無難だ。品質を判断する前に、使っているランタイムのビルドがループ層に対応しているかも確認したい。
購入ボタンのない価格表
Artificial Analysisのモデルページに掲載されたTinkerの料金は、入力100万トークンあたり$0.15、キャッシュ済み入力は$0.015、出力は$0.50。ファインチューニングは64Kで$0.75、256Kで$1.50となっている。実測のトークン使用量に当てはめると、インデックスのタスク1件あたりMiniは$0.59、Qwen3.8-27Bは$3.53になる。
ただし、この$0.59は見積もりであり、実際に購入できるホスト型の料金ではない。レビュー時点でMiniはサーバーレス推論の一覧に掲載されておらず、TinkerとOpenRouterについての確認結果はeeselのレビューにも記録されている。さらにインデックスの実行では、Miniの出力トークン数は161Mで、中央値の85.7Mを上回った。1トークンあたりの安さも、出力が長くなれば一部が相殺される。自前運用を考えるなら、ハードウェア、電気代、セットアップ費用を、ホスト型のQwenや最先端APIと比較したい。
結果を左右する2つの設定
推論の強度は、なし(0.0)、最小(0.1)、低(0.2)、中(0.7)、高(0.9、デフォルト)、xhigh/max(0.99)から選べる。モデルカードによれば、最小設定でも推論が完全に無効になるわけではない。
強く設定すればよいとは限らない。r/LocalLLMのTerminal-Benchに関する議論では、あるユーザーが13タスクのサブセットを低設定で10/13正解した一方、中設定では何度もタイムアウトしたという。別のテストでは、eeselのレビューが引用するHacker Newsユーザーが、ツールなしで19,200個の思考トークンを消費しても完了できなかった。検索を有効にすると解決策は出たが、フック名を間違えていた。
出力トークン数とエージェントのターン数には上限を設け、ファイルシステムへのアクセスはサンドボックス化し、本番投入前には人間が確認する体制を整えたい。モデルカードも、確認なしで破壊的な操作を実行する可能性や、特にコードのデバッグ時に推論ループから抜けられなくなる問題を警告している。
ダウンロード前に受け入れるべきトレードオフ
Miniは中央のレイヤーを再利用することで、チェックポイントを大型化せずに計算量を増やしている。ラボはこの挙動を研究できる可変ループ型の研究用チェックポイントも公開している(解説)。一方、問題点も具体的だ。デバッグ中にループする、返信の途中で日本語に切り替わったというユーザー報告がある、ツール呼び出しに制限が必要、といった具合だ。ガードレール付きのオフラインコーディングが目的なら試す価値がある。慎重なチャットやワンクリックで使えるAPIが必要なら、もう少し待ったほうがいい。
FAQ
Inkling 2 MiniはノートPCで動きますか?
適切なビルドを使えば動く。Ollamaまたは現行のllama.cppを使い、32GB以上のAppleシリコンMacで実行できる。4-bit(約17.6GBに加えてプロジェクター)がおすすめだ。古いM1 Maxでは約20 tok/s、M5ハードウェアでは100 tok/s以上が目安になる。パッチ未適用のランタイムでは1桁台まで落ちることもある(上の表を参照)。
Inkling 2 MiniはQwen3.8-27Bより優れていますか?
コーディングエージェント用途ならMini、チャット用途ならQwenだ。上のグラフの通り、MiniはDeepSWE、SWE-Bench Verified、BrowseComp、MCP Atlasでリードする。一方、QwenはTerminal-Bench v2.1、MMMU Pro、事実性、制約付き指示で優位に立つ。すべてモデルカード経由のベンダー報告値だ。
なぜアクティブパラメータが3.4Bと5.4Bの両方で表記されるのですか?
3.4Bは保存されているアクティブパラメータ数で、5.4Bは約1.0B分のループを3回通す計算量を加えた数字だ。メモリ容量を見るときは3.4B、計算量を見るときは5.4Bを使えばよい。
Inkling 2 Miniを現在ホスト型APIから呼び出せますか?
レビュー時点では、ファーストパーティのサーバーレスエンドポイントは存在しなかった。eeselの確認によれば、Tinkerにはサンプリングとファインチューニングの料金はあるものの、Miniのサーバーレス提供は掲載されていない。Hugging Faceの重みをローカルで動かすか、ホスト型サービスへの対応を待つ必要がある。
推論ループを止めるにはどうすればよいですか?
まずは低(0.2)の推論強度を試し、出力トークン数とエージェントのターン数に上限を設定する。ツールはサンドボックス化する。いずれもモデルカードで推奨されている対策だ。
関連記事:594Bの兄弟モデルMiniの回答も扱うInkling 2 SmallレビューとAPI料金、エージェント向けモデルの中でMiniの立ち位置を確認できる2026年版・コーディングエージェントに最適なLLM、Miniをローカルで動かす際に必要となるランタイムのllama.cpp v1.0ガイド。