 AIREITER
ファイルを読み、テストを実行し、修正を繰り返すコーディングエージェントでは、1件のIssueを解決するだけで50,000〜200,000トークンを消費します。GPT-5.6 Solの出力料金は100万トークンあたり$30なので、出力トークンだけでも1タスクあたり$1.50〜$6です。一方、DeepSeek V4 Proの出力料金は100万トークンあたり$0.87。コストはおよそ1/34ですが、ClaudeやGPTほどの深さで、複数ステップの信頼性を第三者が検証したベンチマークはまだありません。ここでは、公開コーディングベンチマーク、2026年8月に確認したAPI料金、コンテキスト上限、適したエージェント運用という観点から、6つのモデルを比較します。
コーディングエージェントで検討すべき6モデル
各モデルについて、公式またはリーダーボードに掲載されたベンチマーク結果と、2026年8月時点で確認したAPI価格を並べています。対象モデルそのもののスコアが公開されていない場合は、最も近いバリアントの数値を代替値として明記しました。
1. Claude Opus 5 — 品質を最優先するなら
Claude Opus 5は、公式のSWE-bench Verifiedリーダーボードで強さを見せてきたClaude系列の最新モデルです。前世代のClaude 4.5 Opusは、mini-SWE-agentハーネスで76.8%を記録しています。Opus 5固有のSWE-bench Verifiedスコアはまだ公開されていないものの、その実力帯を推測する参考値にはなります。コンテキストウィンドウは100万トークン、最大出力は128Kトークン。料金は入力が$5/M、出力が$25/Mで、ここで挙げる主流モデルの中では最も高価です。複数ファイルにまたがるリファクタリングで失敗した際の人件費がトークン料金を上回るなら、Opus 5を選ぶ価値があります。反対に、大量の定型編集には向きません。
2. GPT-5.6 Sol — ターミナル操作中心の最有力候補
GPT-5.6 Sol(モデルID:gpt-5.6-sol)は、入力$5/M、出力$30/Mで利用でき、コンテキストウィンドウは105万トークンです。xAIが公開したベンチマーク比較では、GPT-5.6 Sol MaxがTerminal-Bench v3.0で34.6%を記録し、Grok 4.6の26%を上回りました。DeepSWE v1.1でも73%で首位です。いずれもターミナル駆動のエージェントループに特に関係する指標です。代わりに、出力$30/Mは今回のラインアップで最高額となります。OpenAIは、SWE-bench ProでSolが64.6%、中位モデルのTerraが63.4%だったとも報告しています。負荷がそれほど高くないタスクで、より安価なOpenAIモデルを探す場合の参考になるでしょう。
3. Grok 4.6 — 長時間動かすエージェントのコスパ枠
2026年8月12日にリリースされたGrok 4.6は、長時間稼働するエージェントワークフローを想定して設計されています。xAIの発表によると、Artificial Analysis Intelligence IndexではGPT-5.6 Sol Maxと同じ61を記録。CursorBench v3.2では69.9%対67.2%、FrontierCode v1.1では61.3%対60.6%、APEX-Agentsでは57.5%対56.7%と、いずれもSol Maxを上回りました。料金は入力$2/M、出力$6/M。GPT-5.6 Sol Maxに近いベンチマーク性能を、出力コストはおよそ5分の1で利用できます。弱点は純粋なターミナル実行で、Terminal-Bench v3.0は26%と、Sol Maxの34.6%に大きく差を付けられています。ターミナル最優先ではなく、CursorやGrok BuildのようなIDE中心のワークフローなら、Grok 4.6はこのリストで最も費用対効果の高い選択肢です。低レイテンシー版の「fast」は料金が2倍となり、$4/$12です。コンテキストウィンドウは500Kトークンです。
4. DeepSeek V4 Pro — 予算重視の主力モデル
DeepSeek V4 Proは、APIで利用できるフロンティア級モデルの中で最も安価です。料金は入力$0.435/M、出力$0.87/Mで、キャッシュ済み入力は$0.003625/Mまで下がります。100万トークンのコンテキストウィンドウと384Kトークンの最大出力を備え、リポジトリ規模のタスクにも対応できます。ただし、DeepSeek V4 ProをClaudeやGPTと同等のハーネス深度で比較した、公開済みの複数ステップ型エージェントベンチマークはありません。複雑なリファクタリングに本格導入する前に、長いセッションでのツール呼び出しの信頼性を自社環境で確認すべきです。予算が限られるチームや、ルーティング構成の一次処理モデルとしては非常に魅力的です。一方、トークン単価より信頼性が重要な難易度の高い複数ファイルリファクタリングでは、上位モデルへエスカレーションする前提で考えるのがよいでしょう。
5. Gemini 3.1 Pro — 巨大コンテキストでコードベースを読む
GoogleのGemini 3.1 Pro Previewは、プロンプトが200Kトークン未満なら入力$2/M、出力$12/Mです。このしきい値を超えると$4/$18に上がります。最大の特徴はコンテキスト容量で、ここに挙げたモデルでは最大となる200万トークンのコンテキストウィンドウを持ちます。コードベース全体を一度に読み込むような用途に向いています。Gemini 3.1 Proの実力帯を推測する代替値としては、Gemini 3 FlashがTemboによる2026年6月のスナップショットでSWE-bench Verified 75.8%を記録し、Claude 4.5 Opusに次ぐ結果でした。長時間のエージェントループにおけるGeminiのツール呼び出し一貫性は、ClaudeやGPTほどの深さでベンチマークされていません。複数ステップのワークフローへ投入する前に、自分のハーネスで検証してください。
6. Kimi K3 — オープンウェイトで動かす選択肢
Moonshot AIのKimi K3は、同じ2026年6月のスナップショットでSWE-bench Verified 70.8%を記録しました。オープンウェイトモデルの中では、GLM-5の72.8%、MiniMax M2.5の75.8%を下回ります。オープンウェイトであるため、コードをネットワーク外へ出せないチームでもセルフホストできます。MoonshotのホステッドAPIでもK3は提供されていますが、料金はデプロイ構成によって異なります。十分なGPUハードウェアを用意できるローカルエージェント環境なら、K3とOpenCodeのような軽量ハーネスを組み合わせることで、トークン単位のAPI費用なしに実用的なコーディングエージェントを構築できます。
API料金から見る、Issue 1件あたりの推定コスト
トークン単価だけでは判断できません。重要なのは、エージェントループで実際のGitHub Issueを1件解決するまでに、総額でいくらかかるかです。
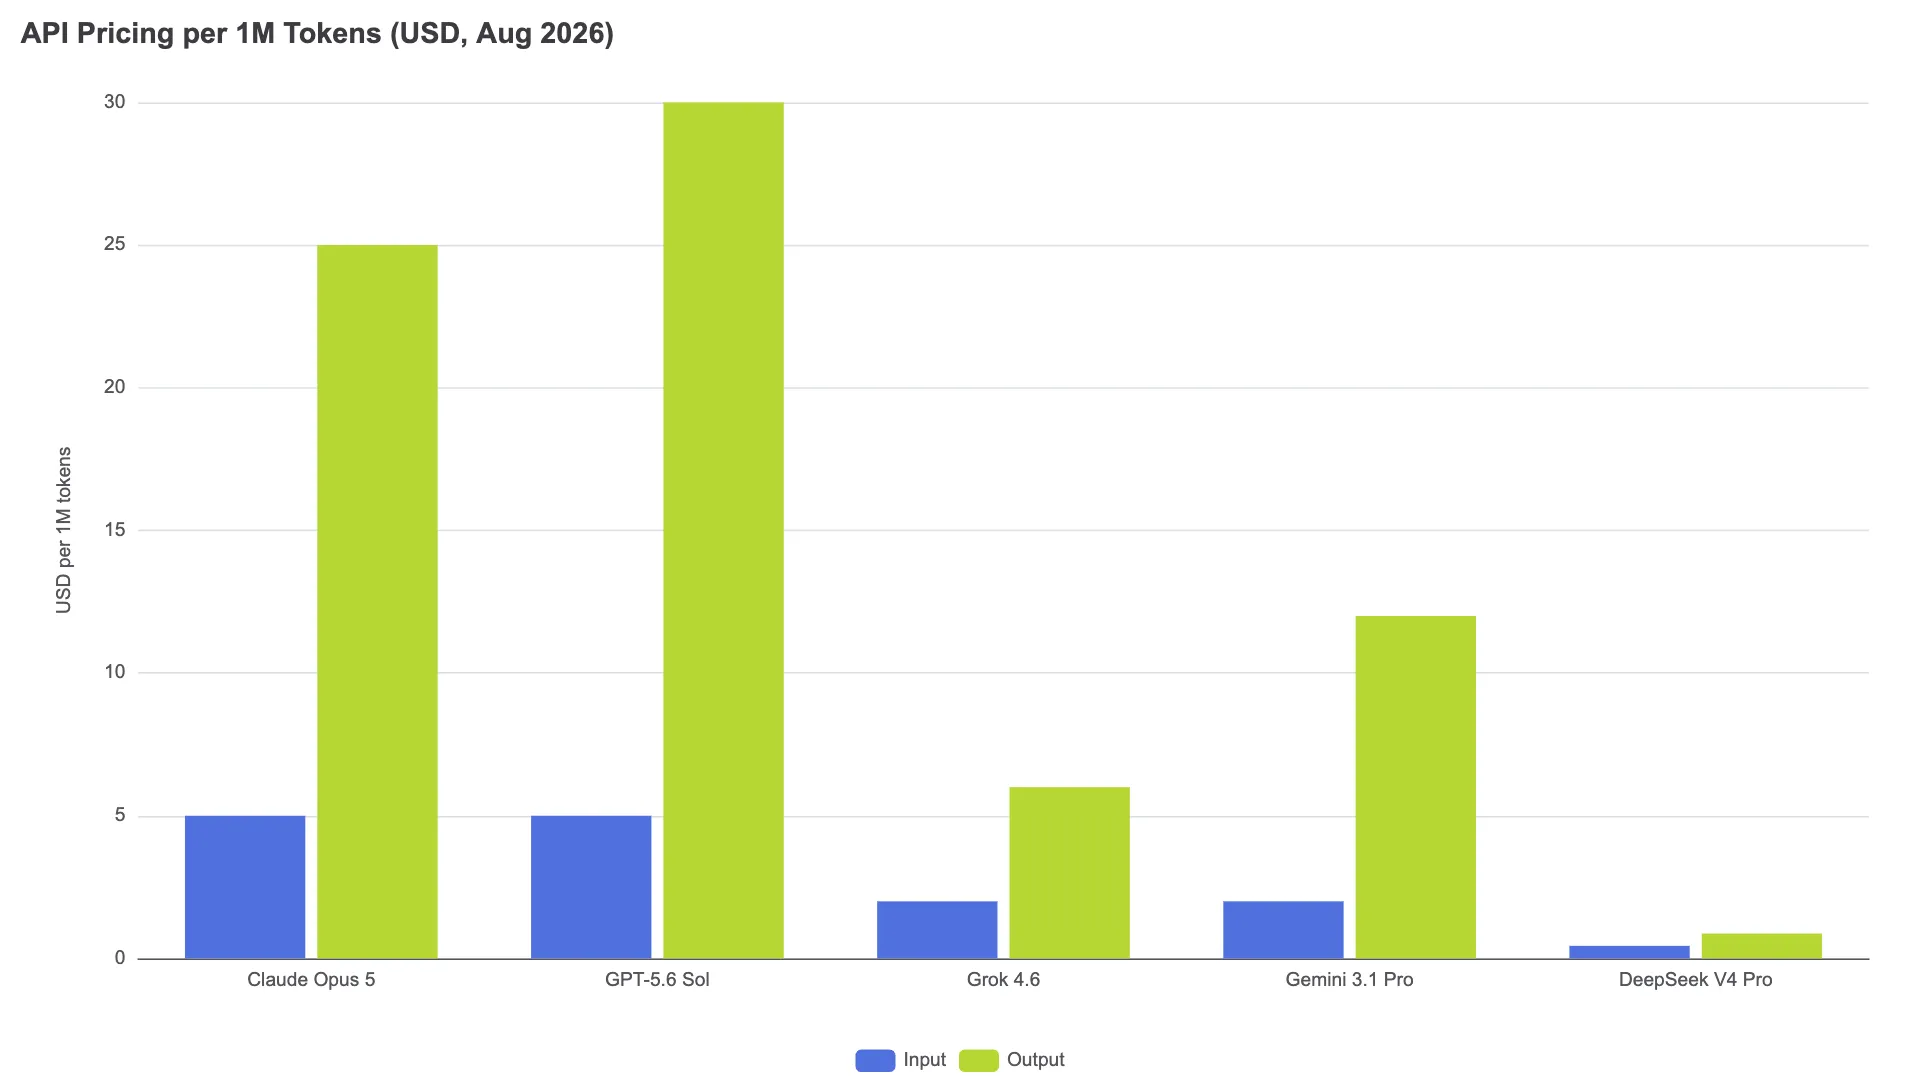
ファイルの読み取り、計画、編集、テスト実行、失敗修正までを含む一般的なエージェントループでは、解決したIssue 1件あたりおよそ50K〜200Kトークンを消費します。出力トークンの比率は全体の30〜50%です。この数値はTemboのエージェントループ分析などに基づく業界推定値であり、実際の消費量はリポジトリの規模、テストスイートの長さ、ハーネスの効率に左右されます。総トークン数125Kの中間値を使い、入力75K・出力50Kとして計算すると、Issue解決1件あたりの費用は次のとおりです。
| モデル | 入力コスト | 出力コスト | タスクあたり合計 |
|---|---|---|---|
| Claude Opus 5 | $0.375 | $1.25 | $1.63 |
| GPT-5.6 Sol | $0.375 | $1.50 | $1.88 |
| Grok 4.6 | $0.15 | $0.30 | $0.45 |
| Gemini 3.1 Pro | $0.15 | $0.60 | $0.75 |
| DeepSeek V4 Pro | $0.033 | $0.044 | $0.077 |
Kimi K3は、MoonshotのホステッドAPIを使うか、自社GPUでセルフホストするかによってコストがまったく変わるため、この表には含めていません。比較できる単一の定価が存在しないためです。Grok 4.6は1タスク$0.45という好位置にあり、GPT-5.6 Sol Maxと同じArtificial Analysis Intelligence Indexスコアを、Solのタスク単価のおよそ4分の1で実現します。
この試算には、リトライ、キャッシュ済みトークンの割引、ツール呼び出しのオーバーヘッド、インフラ費用は含まれていません。リトライや人手による修正が多いモデルは、トークン単価が安くても実運用では高く付きます。そのため、定型作業はDeepSeekやGrokに任せ、難しいリファクタリングだけOpusへエスカレーションするルーティング構成は、単一モデルに固定するより良い結果につながる場合があります。
コーディングエージェントの用途別おすすめモデル
すべてのワークフローに最適な単一モデルはありません。エージェントの仕事ごとに、接続先を選ぶべきです。
高速ループと定型編集。 エラー説明、小規模な関数追加、テストのスタブ作成、ドキュメント更新といった、高頻度かつ失敗コストの低い作業には、Gemini 3.5 Flash(100万トークンあたり$1.50/$9)またはClaude Sonnet 5を使います。
大規模リファクタリングと設計判断。 複数ファイルの変更、モジュール横断の依存関係、判断を誤ると数時間のデバッグにつながるアーキテクチャ設計では、Claude Opus 5が第一候補です。長いセッションでも指示に正確に従い、コンテキストの整合性を維持できる点が主な差別化要因です。
長時間動作する自律エージェント。 Grok 4.6はまさにこの用途を意識して作られています。xAIの発表によれば、自己検証を行いながら持続的に進むエージェント軌跡に焦点を当てて開発されました。1タスク$0.45なら、GPT-5.6 Solの1タスク$1.88が生むようなコスト圧力を抑えつつ、より長く動かせます。ただし、ターミナル作業の比重が高いワークフローでは、Terminal-Benchで34.6%と先行するGPT-5.6 Solのほうが安全な選択です。
低予算運用とセルフホスト。 コスト重視のチームでは、1タスク$0.077のDeepSeek V4 Pro APIが標準的な選択肢です。コードを外部APIへ送信できない組織なら、Kimi K3(SWE-bench Verified 70.8%)やMiniMax M2.5(75.8%)のようなオープンウェイトモデルをセルフホストします。SWE-bench Verifiedでは、オープンウェイト勢とクローズドウェイト首位勢の差は数パーセントポイント以内まで縮まっています。
モデルだけでは決まらない:ハーネスが性能の上限を作る
Claude Code、Codex CLI、Cursor、あるいはOpenCodeのようなオープンソースツールといったエージェントハーネスは、モデル単体では制御できない4つの要素を決めます。コンテキスト管理(いつ圧縮し、何を残すか)、ツール定義とルーティング、エラー回復のパターン、レビュー・承認フローです。Temboの分析が指摘するように、mini-SWE-agentのような統制されたハーネスで得たベンチマークスコアは、別の設定で運用した場合の実際の解決率を反映しないことがあります。だからこそ、モデルとハーネスの改善が混ざったベンダー公表スコアより、ハーネスを固定して比較したベンチマークのほうが、モデル比較には役立ちます。
モデルを入れ替える前に、まずハーネスを監査してください。エージェントがコンテキストを適切に圧縮できているか、ツール定義が整理されているか、無限ループではなく妥当な形でリトライするエラー回復になっているかを確認します。
FAQ
コーディングエージェントで最も安いLLMは?
フロンティア級モデルでは、入力$0.435/M・出力$0.87/MのDeepSeek V4 Proが最も安価です。解決済みエージェントタスク1件あたりの費用は、およそ$0.08です。
自分のリポジトリでコーディングエージェント向けモデルをテストする方法は?
実際のバックログから、バグ修正、機能追加、リファクタリングを混ぜた代表的なIssueを20〜30件選びます。同じタスク群に対し、選定したハーネスで各モデルを実行してください。追跡すべき指標は3つです。解決率(エージェントのパッチがテストに通ったか)、タスクあたりのトークン消費量、完了までの時間です。公開ベンチマークよりも、このリポジトリ固有の評価のほうが実運用の予測には役立ちます。