 AIREITER
まず試すなら、100万入力トークンあたり$0.04のホステッドAPIがもっとも簡単だ。一方、新たに公開されたオープンウェイトのチェックポイントならローカル推論も現実的になる。ただし、3Bモデルと600Mモデルには性能面で明確な開きがある。
Liquid d1の3つの選択肢は、用途ごとに別物
Liquid AIが提供する選択肢は3つある。プロプライエタリなホステッドサービスのd1、オープンウェイト版のd1-3B、そして実験的なオープンウェイト版d1-omni-600Mだ。Liquid AIはホステッドモデルがダウンロード可能な2つのチェックポイントと同一だとは明言していない。ベンチマークやレイテンシの数値は、必ず測定対象となったモデルに紐付けて扱う必要がある。
| 選択肢 | 利用方法と価格 | 入力 | 公開されているコンテキスト長 | 向いている用途 |
|---|---|---|---|---|
ホステッド d1 | Liquid API。100万入力トークンあたり$0.04、出力トークン料金なし | Liquidから直接、テキストと画像 | Vercelでは66Kと記載 | 素早い統合、推論コストをほぼ気にしない運用、モデル運用不要 |
d1-3B | ウェイトをダウンロード。トークン単位のモデル料金なし | テキスト、JSON、画像 | 32,768トークン | ローカルでの最高品質、視覚入力、本番評価 |
d1-omni-600M | 実験的ウェイトをダウンロード。トークン単位のモデル料金なし | テキスト+画像、またはテキスト+音声 | 16,384トークン | 小さなフットプリント、音声コマンド実験、制約のあるエッジデバイス |
3モデルはいずれも、文章を生成するのではなく、型付きの質問に回答する。noulはyesの確率、choiceは名前付き選択肢ごとの確率、scoreは順序付きルーブリック上の確率加重位置を返す。ルーティング、モデレーション、検査、ガードレール、スコアリングに適しており、チャットモデルやコーディングモデルの代替ではない。
結論は明快だ。まずはホステッドd1でパイロットを始め、データをローカルに留める必要がある場合やネットワーク往復を避けてレイテンシを抑えたい場合はd1-3Bを選ぶ。d1-omni-600Mは、音声対応またはフットプリントの小ささが決定的な条件でない限り、実験用途として扱うのがよい。
API料金とローカル運用コストを比べる
Liquid AI d1 APIの料金は100万入力トークンあたり$0.04だ。生成テキストではなく判断結果を返すサービスのため、出力トークン料金はかからない。1億入力トークンのワークロードなら、ゲートウェイ料金を除いて$4。10億入力トークンなら$40となる。
$0.04/Mトークンという価格では、推論コストだけを理由にセルフホスティングを選ぶ場面はほとんどない。ローカル導入を選ぶ理由は、プライバシー、オフライン利用、オンデバイスのレイテンシ、カスタマイズ、または継続的な高稼働率だ。
2つのオープンチェックポイントに、公式のホステッド型トークン単価はない。レビュー時点ではHugging Faceのページに推論プロバイダーも表示されていなかった。したがって、ホステッドd1の料金をd1-3Bやd1-omni-600Mの料金として扱ってはいけない。
ホステッドサービスでは画像も入力として課金される。Liquid AIの規定では32×32ピクセルのパッチごとに1.5トークンとなるため、1024×1024の画像は質問文の前に1,536トークンを消費する。$0.04/Mなら画像部分の料金は約$0.00006144だ。各質問は画像を含む個別のプロンプトとして課金される。
オープンウェイトでも、無制限・無料ではない
両リポジトリはApache 2.0やMITではなく、Liquid AIのlfm1.0ライセンスを採用している。Liquid AIの一般価格条件では、年間企業売上が$10 million未満であればダウンロード可能なモデルを商用利用できるとしている。より大きな組織は、「オープンウェイト」という表現から利用許可を推測せず、現行の商用条件を確認したほうがよい。
ローカル運用の予算には、GPUやデバイスの調達、アイドル時の容量、監視、アップデート、担当者の工数も含める必要がある。ホステッド版の請求額は変動制で小さい一方、ローカルのコストは大半が固定費になる。
品質を取るならd1-3B、サイズを取るならomni
公式のOpen d1発表によると、Decision Index v0.2.1のスコアはd1-3Bが48.57、d1-omni-600Mが15.95だった。Liquid AIは両モデルを公式スコアラーで評価しているが、これらは公式リーダーボードへの提出結果ではない。
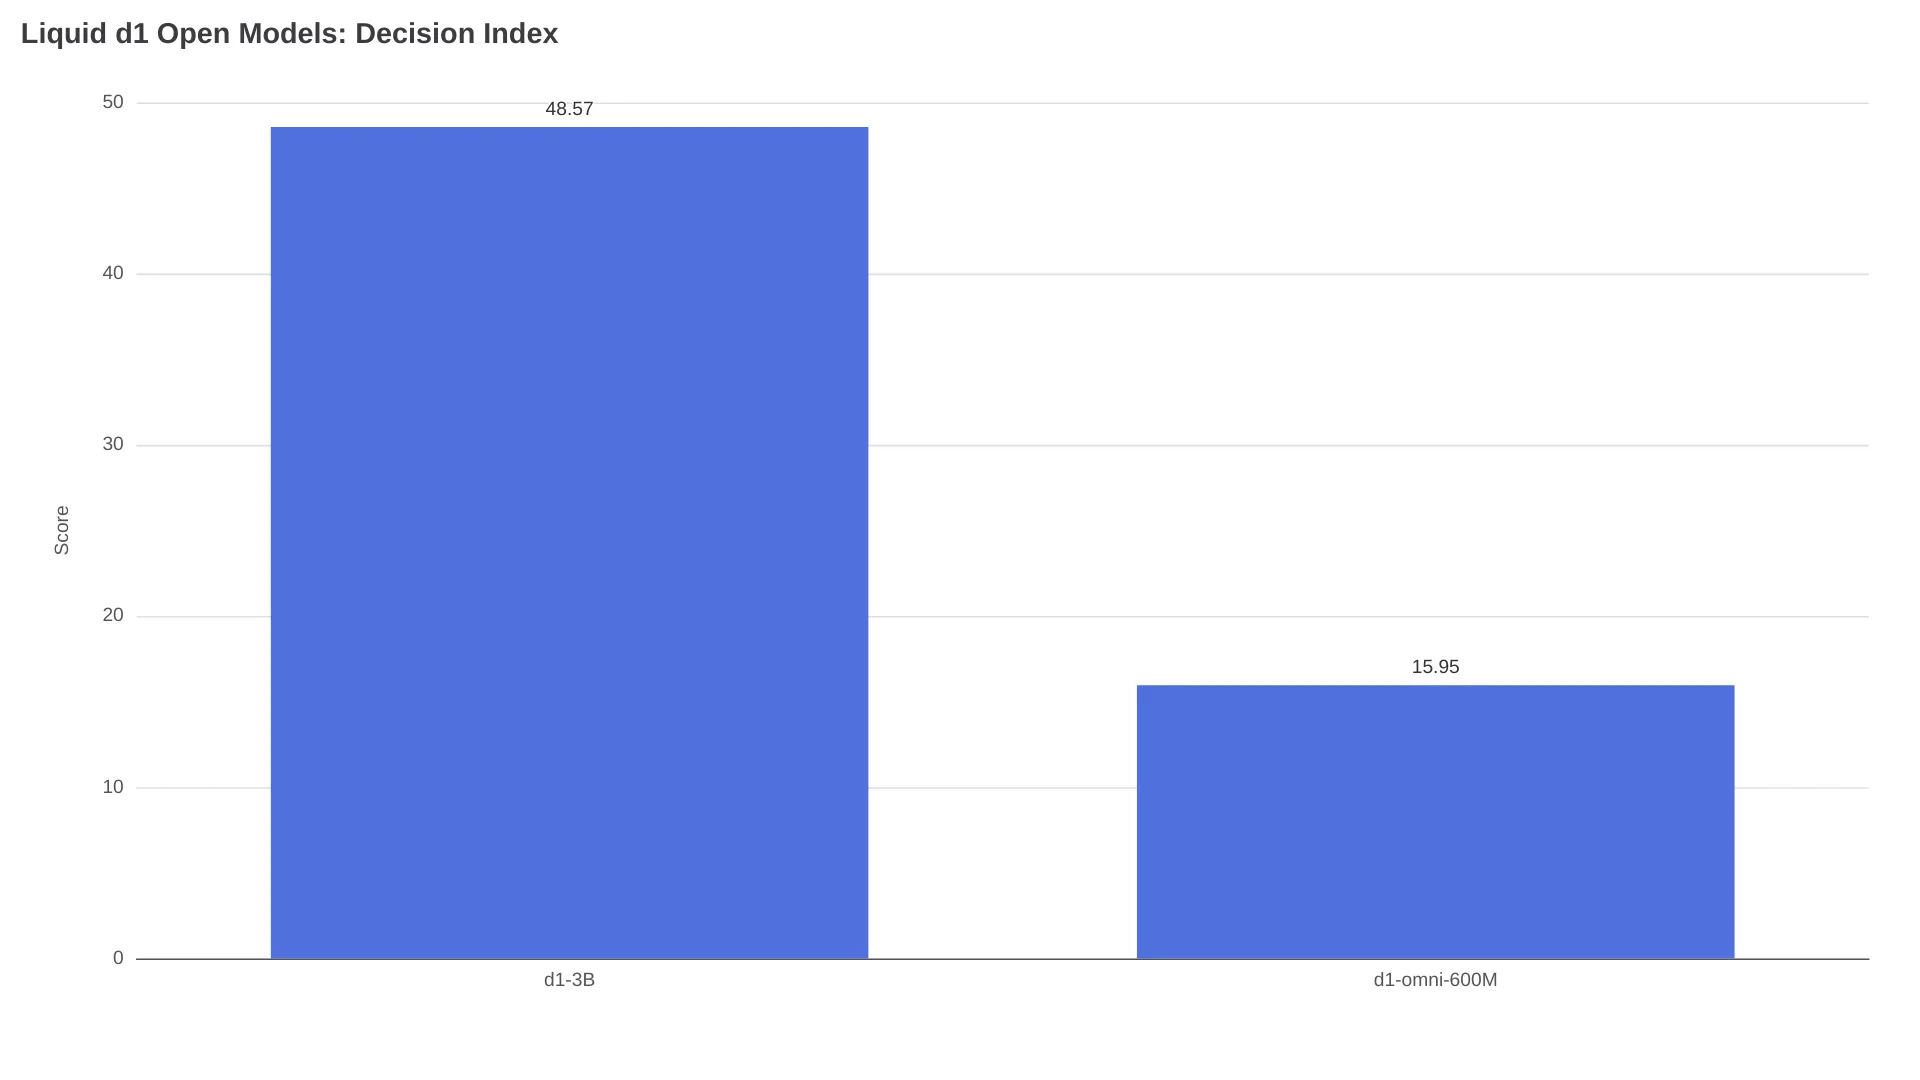
小型モデルが一様に低性能というわけではない。7つの公開テキストベンチマークで、Liquid AIはd1-3Bの平均を82.9、d1-omni-600Mの平均を78.4と報告している。OmniはCivil Commentsで95.8対93.0、PAWS-Xで79.5対76.9と上回り、残る5タスクは3Bがリードした。Decision Indexでの大きな差は、一部の分類タスクで優れていても、600Mチェックポイントが3Bの汎用的な代替になるわけではないことを示している。
| 仕様 | d1-3B | d1-omni-600M |
|---|---|---|
| 詳細なパラメータ数 | 3.12B | 587M |
| フル精度のリポジトリ/ウェイト容量 | リポジトリ6.27 GB、ウェイト6.25 GB | F32モデル、約0.6Bパラメータ |
| コンテキスト長 | 32,768 | モダリティ間で共有する16,384 |
| 画像使用時のテキスト許容量 | モデルのコンテキスト内 | 画像ありの場合、状態と質問テキストは896トークンに制限 |
| 音声 | 非対応 | 16 kHzモノラルのクリップ1本、最長30秒 |
| 画像と音声の同時入力 | 該当なし | 非対応。ValueErrorが発生 |
| 公式速度表 | あり | なし。初期の研究リリース |
d1-omni-600Mのモデルカードでは、モデルはfloat32で学習されたとされている。Float16では、テキスト243行、画像214行、音声416行で最上位の回答が維持された。一方、bfloat16ではテキスト行の0.8%、音声行の1.7%で最上位回答が変わった。dtypeは単なる最適化スイッチではなく、検証すべき変数だ。
ローカル導入は短時間で始められるが、検証は長い
両モデルカードでは、単一ステート向けのsystem_oneと、リクエストをまとめて扱うsystem_one_batchが提供されている。d1-3Bを最短で動かすには、Transformers 5.14以降、PyTorch、TorchVision、Pillow、そしてリポジトリ提供のカスタムコードを使う。
- ドキュメント記載の依存関係をインストールする。
pip install "transformers>=5.14" torch torchvision pillow- リポジトリのリモートコードを有効にしてモデルをロードする。
import torch
from transformers import AutoModel

model_id = "LiquidAI/d1-3B"
device = "cuda" if torch.cuda.is_available() else "cpu"
dtype = torch.bfloat16 if device == "cuda" else torch.float32

model = AutoModel.from_pretrained(
    model_id,
    trust_remote_code=True,
    torch_dtype=dtype,
).to(device)- チャットプロンプトではなく、名前付きの判断を送信する。
questions = {
    "queue": {
        "type": "choice",
        "instructions": "Which team should handle this ticket?",
        "criteria": {
            "billing": "Charges, invoices, and refunds",
            "technical": "Application or website faults",
            "fraud": "Suspected unauthorized use",
        },
    }
}

result = model.system_one(
    "I was charged twice this month; refund one charge.",
    questions,
)
print(result["answers"]["queue"])trust_remote_code=Trueは、リポジトリ内のPythonコードがサービングプロセスで実行されることを意味する。本番では変動するブランチをロードするのではなく、レビュー済みのコミットを固定するべきだ。d1-3Bリポジトリには、llama.cpp、Ollama、LM Studio互換ランタイム向けの量子化版へのリンクもある。ただし、コミュニティ提供の量子化アーティファクトは、公式BF16ウェイトとは別のサプライチェーンおよび精度上の判断になる。
d1-3Bのモデルカードでは、ウォーム状態の1質問あたりの時間をRTX 4090で8 ms、Apple M5 Proで30 ms、Jetson Orin Nanoで50 msと報告している。3.4Kトークンのステートでは、同じデバイスで102 ms、640 ms、1,640 msだった。GPUの数値は20回実行時の中央値であり、4090の8 msという結果にはコンパイル済みCUDAグラフを使用している。新しい入力形状では、コンパイルまたはカーネル選択のオーバーヘッドが発生する。
d1-omni-600Mには公式の速度表がない。ブラウザ移植版では、4つの判断を行うコメント1件あたり約180 msという報告がある。
「まだ他のマシンでは試しておらず、MBP M4 Proだけです。」— Redditのu/FinancialAd1961
この単一デバイスの結果が示すのは、ブラウザで動作可能だという点までだ。ブラウザ、GPU、量子化方式、バッチサイズをまたいだ性能を示すものではない。
APIは簡単に使えるが、モデルの同一性は別問題
直接ホステッドアクセスでは、https://api.liquid.ai/decisions/v1/systemoneでモデルd1を使う。Vercelではliquid/d1として提供され、ページには66Kのコンテキスト長と、同じく$0.04/Mの入力レートが記載されている。Liquidの10月5日の発表によれば、その時点でVercelとOpenRouterはテキスト専用であり、Liquidの直接APIは画像を受け付けていた。
オープンチェックポイントは同じ判断概念を持つローカルPythonメソッドを使用するが、インターフェースが似ているからといって挙動まで同等とは限らない。確率の差によって、自動化のしきい値をまたいでケースの扱いが変わる可能性がある。評価した各分岐では、正確なモデルID、リビジョン、dtype、確率、しきい値を記録しておきたい。
移行は次の4ステップで進めるのがよい。
- 曖昧なケースや高コストな誤りも含め、実際の本番分布からラベル付きデータセットを作る。
- 同一のステート、質問スキーマ、評価基準を各候補に入力する。
- グローバルなベンチマークスコアではなく、偽陽性と偽陰性のコストからしきい値を選ぶ。
- 破壊的な操作、金銭処理、アクセス制御、安全に関わるアクションを許可する前に、候補モデルをシャドー運用する。
Liquid d1はどれを選ぶべきか
大半のチームには、ホステッドAPIを標準の選択肢として勧めたい。小規模なパイロットではトークン単価が低すぎるため、ローカルサービングのプロジェクトを正当化しにくい。また、ドライバー、量子化、ウォームアップ、キャパシティ管理からも解放される。
| 要件 | 選択 | 理由 |
|---|---|---|
| 最短で本番投入したい | ホステッド d1 | マネージドエンドポイントと明示された入力料金 |
| データをデバイスまたはネットワーク外へ出せない | d1-3B | 最も強力なオープンチェックポイントで、ローカル実行が可能 |
| 公開済みのオープンモデルで最高の判断品質が必要 | d1-3B | Decision Indexは48.57で、15.95を上回る |
| 音声コマンドの分類 | d1-omni-600M | ここで唯一音声に対応。上限は30秒 |
| 実験用途で最小のフットプリントが必要 | d1-omni-600M | 587Mパラメータ。ただし公式レイテンシ表はない |
| 自由形式の説明やアクション生成 | どれも該当しない | 判断ステージの後に生成モデルを追加する |
600Mのフットプリントまたは音声経路が不可欠でない限り、omniよりd1-3Bを選ぶべきだ。パラメータ数を5分の1に抑えられる魅力はあるが、Decision Indexで32.62ポイントの差があることや、omniが実験的な位置付けであることは変わらない。
Liquid AI d1 FAQ
Liquid AI d1は無料ですか?
ホステッドd1サービスは、100万入力トークンあたり$0.04で、出力トークン料金はかからない。オープンチェックポイントはトークン料金なしでダウンロードできるが、LFM 1.0の商用条件とローカル計算コストは別途考慮する必要がある。
d1-3Bとd1-omni-600Mは、ホステッドd1 APIと同じモデルですか?
Liquid AIは、どちらのチェックポイントもホステッドd1と同一だとは文書化していない。モデルID、コンテキスト、ベンチマーク、デプロイ経路がそれぞれ異なる関連製品として扱うべきだ。
Liquid d1をOllamaで動かせますか?
d1-3Bのモデルページでは、llama.cpp、Ollama、LM Studio、および互換アプリケーション向けの量子化版にリンクしている。公式Transformers経路を置き換える前に、量子化実装者、ソースリビジョン、判断APIの対応状況、精度を確認したい。
d1-3Bは音声に対応していますか?
いいえ。d1-3Bが受け付けるのはテキスト、JSON、画像だ。d1-omni-600Mはテキスト+画像、またはテキスト+最長30秒の音声クリップ1本を受け付ける。ただし、画像と音声を同じリクエストで送ることはできない。
ローカルのd1にはどれだけVRAMが必要ですか?
Liquidはd1-3B向けに6.25 GBのBF16ウェイトファイルを公開しているが、共通のVRAM要件は示していない。ランタイムのオーバーヘッド、画像エンコーダの状態、コンテキスト長、バッチサイズ、精度、量子化はいずれも合計値を変える。ファイルサイズをピークVRAMと同一視せず、想定構成で計測すべきだ。
どの経路を選ぶ場合でも、影響の大きい判断を自動化する前に、ラベル付きの本番データで確率しきい値を検証してほしい。
関連記事:ホステッド版Liquid AI d1 APIのレビューでは、直接エンドポイント、画像課金、型付きリクエスト契約をより詳しく解説している。