 AIREITER
サポートチケットの振り分けに、長い文章を書く能力は必要ない。必要なのは、適切なキューを選ぶことだ。Liquid AI d1は、まさにその用途に絞った意思決定モデルで、入力トークン100万個あたり$0.04という価格はかなり印象的だ。ただし、ベンダーが示す速度や精度の結果だけでは、自社データに対して信頼できる判定しきい値を設定できるとは限らない。
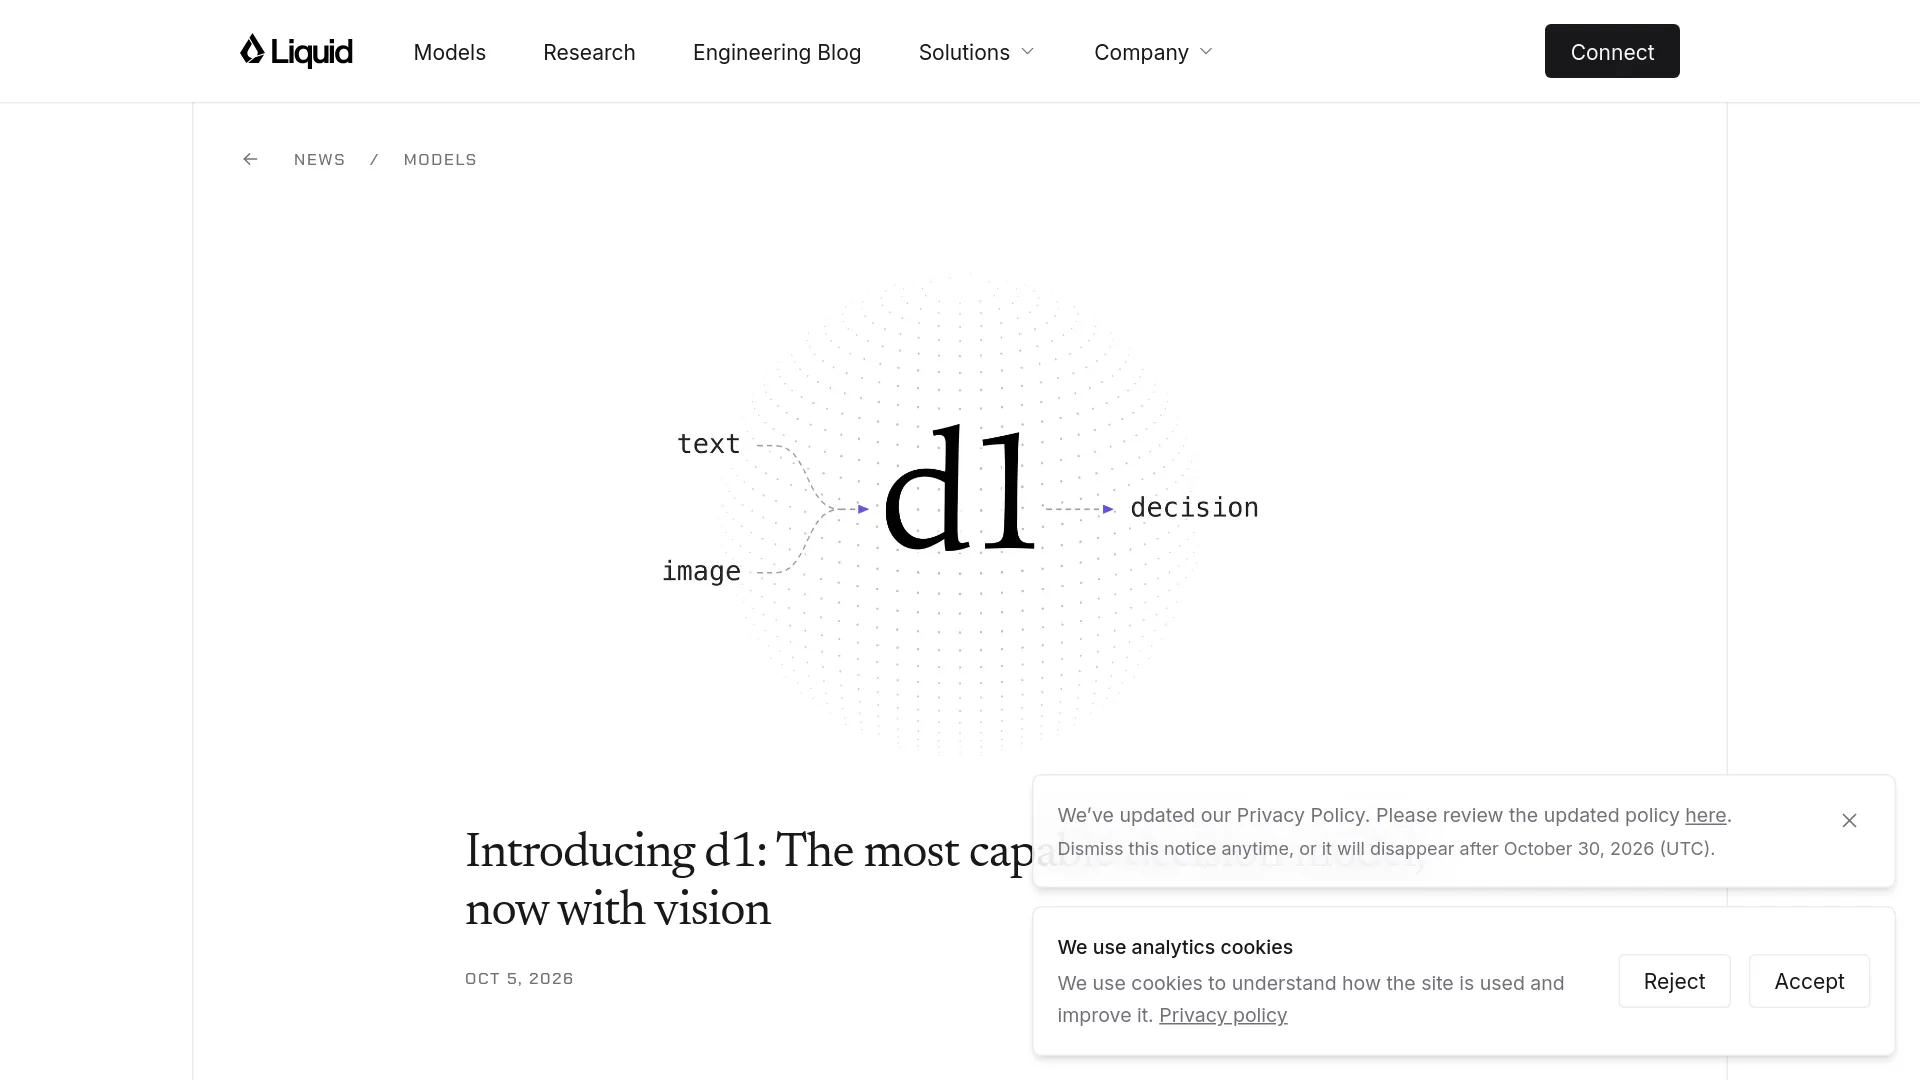
10月5日のd1リリースで何が変わったのか
10月5日のリリースで、Liquid AI d1はテキスト専用の意思決定モデルから、テキスト、画像、またはその両方を扱えるマルチモーダルモデルへと拡張された。Liquid AIの発表によると、モデル名d1で直接APIを利用できるほか、VercelとOpenRouter経由でもテキスト入力を利用できる。ただし、これらのゲートウェイでは画像入力への対応はまだ保留中だ。
10月5日付のLiquid AIの発表では、画像入力への対応に加えて、入力トークン100万個あたり$0.04という料金と、テキストによる判定が通常200〜300ミリ秒で完了することが示されている。
| 項目 | 2026年10月5日時点の状況 |
|---|---|
| 直接利用時のモデルID | d1 |
| 直接利用時のエンドポイント | https://api.liquid.ai/decisions/v1/systemone |
| 入力 | テキスト、画像、またはその両方 |
| 質問タイプ | Noul、Choice、Score |
| テキスト料金 | 入力トークン100万個あたり$0.04 |
| 出力トークン料金 | なし |
| 公称テキストレイテンシ | 約200〜300ミリ秒 |
| VercelとOpenRouter | テキストは利用可能、画像対応は予定 |
| ダウンロード可能なd1の重み | 未発表 |
Liquidがいう意思決定モデルとは、状態を受け取り、型付きの質問を1つ以上評価し、文章ではなく確率を返すシステムだ。つまりd1は、分類、ルーティング、フィルタリング、ランキング、承認ゲートなどに組み込むためのコンポーネントであり、チャットボットやコーディングモデルの代替ではない。
Liquid AI d1の料金は異例だが、読み違えやすい
Liquid AI d1は入力トークンに対して課金し、生成された出力トークンは報告しない。「出力トークンゼロ」は、レスポンスが返らない、あるいは無料という意味ではない。文章を自己回帰的に生成する代わりに、型付きの意思決定結果を返すため、出力トークンとして数える生成がないという意味だ。
公式料金は入力トークン100万個あたり$0.04。1回あたり500トークンが課金されるリクエストを100万回送ると、入力トークンは合計5億個になり、ゲートウェイの上乗せ料金やその他のプラットフォーム料金を除けば、費用はおよそ$20になる。
| ワークロード | 課金対象の入力 | $0.04/Mでのd1直接利用料金 |
|---|---|---|
| 500トークンの短いチケット100万件 | 5億トークン | $20.00 |
| 500トークンの短いチケット1億件 | 500億トークン | $2,000.00 |
| 1024×1024画像100万枚、画像トークンのみ | 15億3600万トークン | $61.44 |
| 1024×1024画像1枚 | 1,536トークン | $0.00006144 |
同じLiquid AIの発表によると、画像は32×32ピクセルのパッチ1枚あたり1.5トークンとして扱われる。したがって1024×1024の画像は、32×32個のパッチに1.5トークンを掛けた1,536入力トークンになる。
もう1つ、料金を見積もるうえで押さえておきたい点がある。Liquidの提供開始時のドキュメントでは、質問1つごとに、質問文と渡した画像を含む独立したプロンプトとして課金されると説明されている。そのため、1枚の大きな画像について5つの質問をすると、1つだけ質問する場合より大幅に高くなる可能性がある。一方で、複数の質問を1回にまとめれば、共通する状態を何度も送り直さずに済む場合もある。
d1でLLMを置き換えられる仕事、置き換えられない仕事
リクエストを送る前に、返してほしい結果の形式を定義できるなら、Liquid AI d1は有力な候補になる。反対に、説明文や生成コンテンツ、コード、複数ステップの推論が必要なら、従来型のLLMのほうが適している。
| タスク | d1との相性 | 理由 |
|---|---|---|
| サポートチケットの振り分け | 非常に良い | Choiceでラベルと確率を返せる |
| スパム・ポリシーフィルタリング | 検証後なら非常に良い | Noulで「はい」の確率を返し、しきい値判定に使える |
| リード、緊急度、リスクのスコアリング | 非常に良い | Scoreで入力を順序付きの評価基準に割り当てられる |
| エージェントのツール実行承認 | 条件付き | 安価な構造化ゲートになるが、誤承認のコストは大きくなり得る |
| 画像による欠陥検査 | 条件付き | 画像には対応するが、プロダクションでの精度は自社テストが必要 |
| 顧客への返信文作成 | 不向き | d1は文章を生成しない |
| 要約やコーディング | 不向き | 生成された回答ではなく、意思決定のためのAPIだから |
| 自由形式の調査 | 不向き | 型付きの質問によって回答の範囲が限定される |
実運用で最も大きなメリットは、単にトークンが安いことではない。型付きの出力を使えば、チャットモデルにJSONを出力させ、列挙値を検証し、壊れたペイロードを修復し、アプリケーション側で捨てる説明文にまで料金を払う必要がなくなる。
ただし、インターフェースが絞られていることは、そのまま最大の制約でもある。Liquid AI d1は、なぜその確率を割り当てたのかを説明できない。また、確信度の高い数値が返ったからといって、新しいドメインでキャリブレーションされた確率だとは限らない。
r/LocalLLaMAでの実ユーザーの議論では、単純な分岐タスクにおいて、1回の推論で使う分類器に対する明確な優位性は見られないという報告があった。これはd1そのものの検証ではなく、より広い意思決定モデル全般に関するコメントだが、比較すべき基準を示している。d1を高価な最先端LLMだけと比べるのではなく、単純な分類器とも比較すべきだ。
Liquid AI d1 APIの契約と使い方
Liquid AI d1 APIでは、共通の状態と、名前付きの質問を1つ以上送信する。NoulはYes/No形式の確率判定、Choiceはラベルの選択、Scoreは順序付きスケールによる評価を担当する。
Liquid AIの提供開始時ドキュメントに示されたエンドポイントとペイロードの形式に沿うと、最小限のリクエストは次のようになる。
import requests

payload = {
    "model": "d1",
    "state": "Customer was charged twice for order A-4471 and requests a refund.",
    "questions": {
        "refund_request": {
            "type": "noul",
            "instructions": "Is the customer requesting a refund?"
        },
        "queue": {
            "type": "choice",
            "instructions": "Which team should handle this ticket?",
            "options": ["billing", "technical", "account", "other"]
        }
    }
}

response = requests.post(
    "https://api.liquid.ai/decisions/v1/systemone",
    headers={"Authorization": "Bearer YOUR_LIQUID_API_KEY"},
    json=payload,
    timeout=30,
)
response.raise_for_status()
print(response.json()["answers"])画像については、Liquid AIの公式発表で、stateとquestionsに加えて、Base64エンコードした画像をimagesフィールドで送る方法が紹介されている。たとえば基板の検査なら、「この基板には欠陥がありますか?」というNoul形式の質問を送り、名前付きの回答から返された確率を読み取れる。
APIで質問タイプが固定されていることは、実装上の制約であると同時に利点でもある。ラベルやスコアの段階を慎重に定義し、otherのような明示的なフォールバックを用意しよう。そして、最も高い確率が返っただけで自動処理を許可してはいけない。ラベル付きサンプルで検証したしきい値を超えた場合に限って、自動化へ進むべきだ。
公開された結果は有望だが、あくまでベンダーによる評価
Liquid AIの10月5日付発表によると、d1は6つのアプリケーションのうち4つでGPT-6.1 Solと同等以上の結果を出し、GPT-6.1 SolおよびClaude Opus 5.5よりも19〜200倍低コストで、テストしたすべてのタスクで高速だった。この結果はパイロット導入を検討する材料にはなるが、発表で使われた方法は、モデルとアプリケーションごとに1回ずつ実行するもので、独立した反復試験ではない。
| 公式発表の結果 | 報告された数値 | 注意点 |
|---|---|---|
| テキスト意思決定のレイテンシ | 200〜300ミリ秒 | ベンダーが報告する通常時の範囲 |
| 画像検査 | 85〜97%の精度 | VisAをベースにしたデモ。カテゴリ別の完全な表は未掲載 |
| コンテキスト圧縮 | 52%のトークンを削減 | 必要な出力は保持されたとLiquidは説明 |
| テトリス | テキストのみで70ライン、画像ありで81ライン | 1つのゲーム設定における画像の効果を示す結果 |
| Wordle | 12問中12問を解答、平均3.8回の推測 | スクリーンショットを読み取るデモ |
| Quick, Draw! | 6枚中5.2枚 | 62語から選択。ランダムな場合の基準値は0.6 |
Liquidの評価方法には、参考になる開示もある。各アプリケーションはモデルごとに1回だけ実行され、最大8件のリクエストが同時実行された。料金はプロンプトキャッシュによる割引を含まない定価で計算されている。また、一部のコードに関する質問とコンテキスト圧縮のセッションは、d1のパイプラインが構築された後に作成された。いっぽうで、独立したキャリブレーション曲線、エラーコスト、レート制限、完全な生データの結果表は公開されていない。
まずは、繰り返し発生する意思決定を1つ選び、ホールドアウトセットにラベルを付ける。そのうえで、d1を現在のルールや分類器と比較し、実際に業務で使うしきい値における偽陽性、偽陰性、レイテンシ、コストを確認しよう。削除、決済、アクセス制御、安全性に関わる判断を自動化する前には、シャドートラフィックでの検証が望ましい。
Liquid AI d1 API FAQ
Liquid AI d1は無料ですか?
10月5日の公式リリースでは、d1の料金は入力トークン100万個あたり$0.04で、出力トークン料金はないとされている。ゲートウェイやサードパーティ製プラットフォームの料金は、直接APIの料金と異なる場合がある。
d1はローカルで実行できますか?
Liquid AIは、現行のd1モデルについてダウンロード可能な重みを発表していない。10月5日の発表では、今後の意思決定モデルでオープンウェイトを予定していると説明されているが、d1自体をローカルで実行できるという意味ではない。
d1のコンテキストウィンドウはどのくらいですか?
Liquidの10月5日付発表では、コンテキストの最大長は示されていない。プロダクション環境では、古いディレクトリエントリを当てにせず、選択したプロバイダーを通じて現在の上限を確認すべきだ。
d1は通常の分類器より優れていますか?
すべてのケースに当てはまる答えを出せるほど、独立した証拠はまだない。ラベルや評価基準が頻繁に変わる場合はd1に魅力があるが、タスクが狭く、ラベル付きデータが豊富で、分類体系が安定しているなら、安価な分類器のほうが適している可能性がある。
導入を判断する基準
高価なLLMの呼び出しが、最終的にラベル、確率、ルート、スコアのいずれかに行き着くなら、Liquid AI d1はパイロット導入を検討する価値がある。入力トークン100万個あたり$0.04という料金、ベンダー公称で200〜300ミリ秒のレイテンシ、型付き出力、そして新たに加わった画像対応によって、試験導入のコストを抑えられる。
| 判断 | この基準で選ぶ |
|---|---|
| d1を選ぶ | 出力が固定されており、不確実性が役に立ち、ポリシーが頻繁に変わる |
| まずd1を試す | エラーに業務上のコストがある、または画像が判断材料になる |
| 単純な分類器を使い続ける | 分類体系が安定しており、ラベル付きデータが豊富にある |
| 汎用LLMを使い続ける | 説明、文章、コード、推論が必要になる |
| 自動化を見送る | ラベル付きホールドアウトセットも、許容できるエラーしきい値も存在しない |
最後まで残る論点はキャリブレーションだ。d1は低コストで判定を下せるが、その確率を根拠に安全にアクションを起こせるかどうかを示せるのは、自社のラベル付きプロダクションデータだけである。