 AIREITER
総パラメーター594B、そのうち1トークンごとに使うのは17B。数字だけを見ると、ほとんど“ただ乗り”のようにも聞こえる。Inkling 2 Smallは入力100万トークンあたり0.30ドルと安価だが、現時点ではTinker限定。コーディング性能でもDeepSeek-V4.1-Flash-1017に首位を譲っており、ローンチ記事から受けるほど万能な選択肢ではない。以下はローンチレポートとTinkerの料金をもとにした評価で、独立したレイテンシーおよび出力品質の検証はまだ行えていない。
Inkling 2 Smallとは何か
Inkling 2 Smallは、Thinking Machines Labが2026年11月5日に発表した第2世代の小型Mixture-of-Expertsモデルだ。総パラメーター数は594B、アクティブパラメーターは17B。入力はテキストと画像に対応し、長期的なエージェントタスク向けに推論の強度も可変になっている(Thinking Machines Lab)。
| 仕様 | Inkling 2 Small |
|---|---|
| アーキテクチャ | Mixture-of-Experts |
| 総パラメーター数/アクティブパラメーター数 | 594B/17B |
| 入力モダリティ | テキスト+画像(音声なし) |
| 推論制御 | 可変推論強度(ベンチマークは0.99/xhighで実施) |
| ビジョンエンコーダー | 292Mパラメーター、20x20パッチ、2x2プーリング |
| 数値形式 | NVIDIA GB300 NVL72上のNVFP4 |
| 学習コンテキスト | コンパクション付き256Kトークン(ベンチマークの軌跡は最大1M) |
| Artificial Analysis Index | 31(発表時点) |
総パラメーター数は594Bに達するが、Tinkerでは小型モデルと同じような価格設定になっている。
今すぐ試す方法:現状はTinker限定、重みは来週公開予定
Inkling 2 Smallを現時点で利用できるのは、Thinking Machines LabのTinkerプラットフォームだけだ。Playground、ファインチューニング、サンプリングに対応している。ダウンロード可能な重みはまだ公開されておらず、外部の安全性テストとレッドチーム検証を条件に、完全なチェックポイントをApache 2.0で来週公開する予定だという(Thinking Machines Lab)。
現状を実際の運用目線で整理すると、ポイントは3つある。
- 発表で案内されている利用経路はTinkerだけ。公式のHugging Face版やGGUF版、サードパーティープロバイダー経由の提供は発表されていない。
- 初期チェックポイントはOpenCode上でFledge-Alphaという名前で公開テストされていた(Thinking Machines Lab)。コミュニティでFledge-Alphaと表示された記録は、このモデルファミリーを指している。
- 自前運用を考えているなら、今は待つべきだ。発表資料にはスループットやTime to First Tokenの数値がなく、公式のVRAM目安や量子化手順も公開されていない。
Tinkerの料金と、比較対象として見るべきモデル
Inkling 2 SmallのTinkerサーバーレス推論料金は、256Kコンテキストで入力100万トークンあたり0.30ドル、キャッシュ済み入力が0.03ドル、出力が1.00ドル。Thinking Machines Labが提供する3つのホスト型モデルの中では、サーバーレスの出力料金とキャッシュ済み入力料金が最も安い(Thinking Machines Lab)。
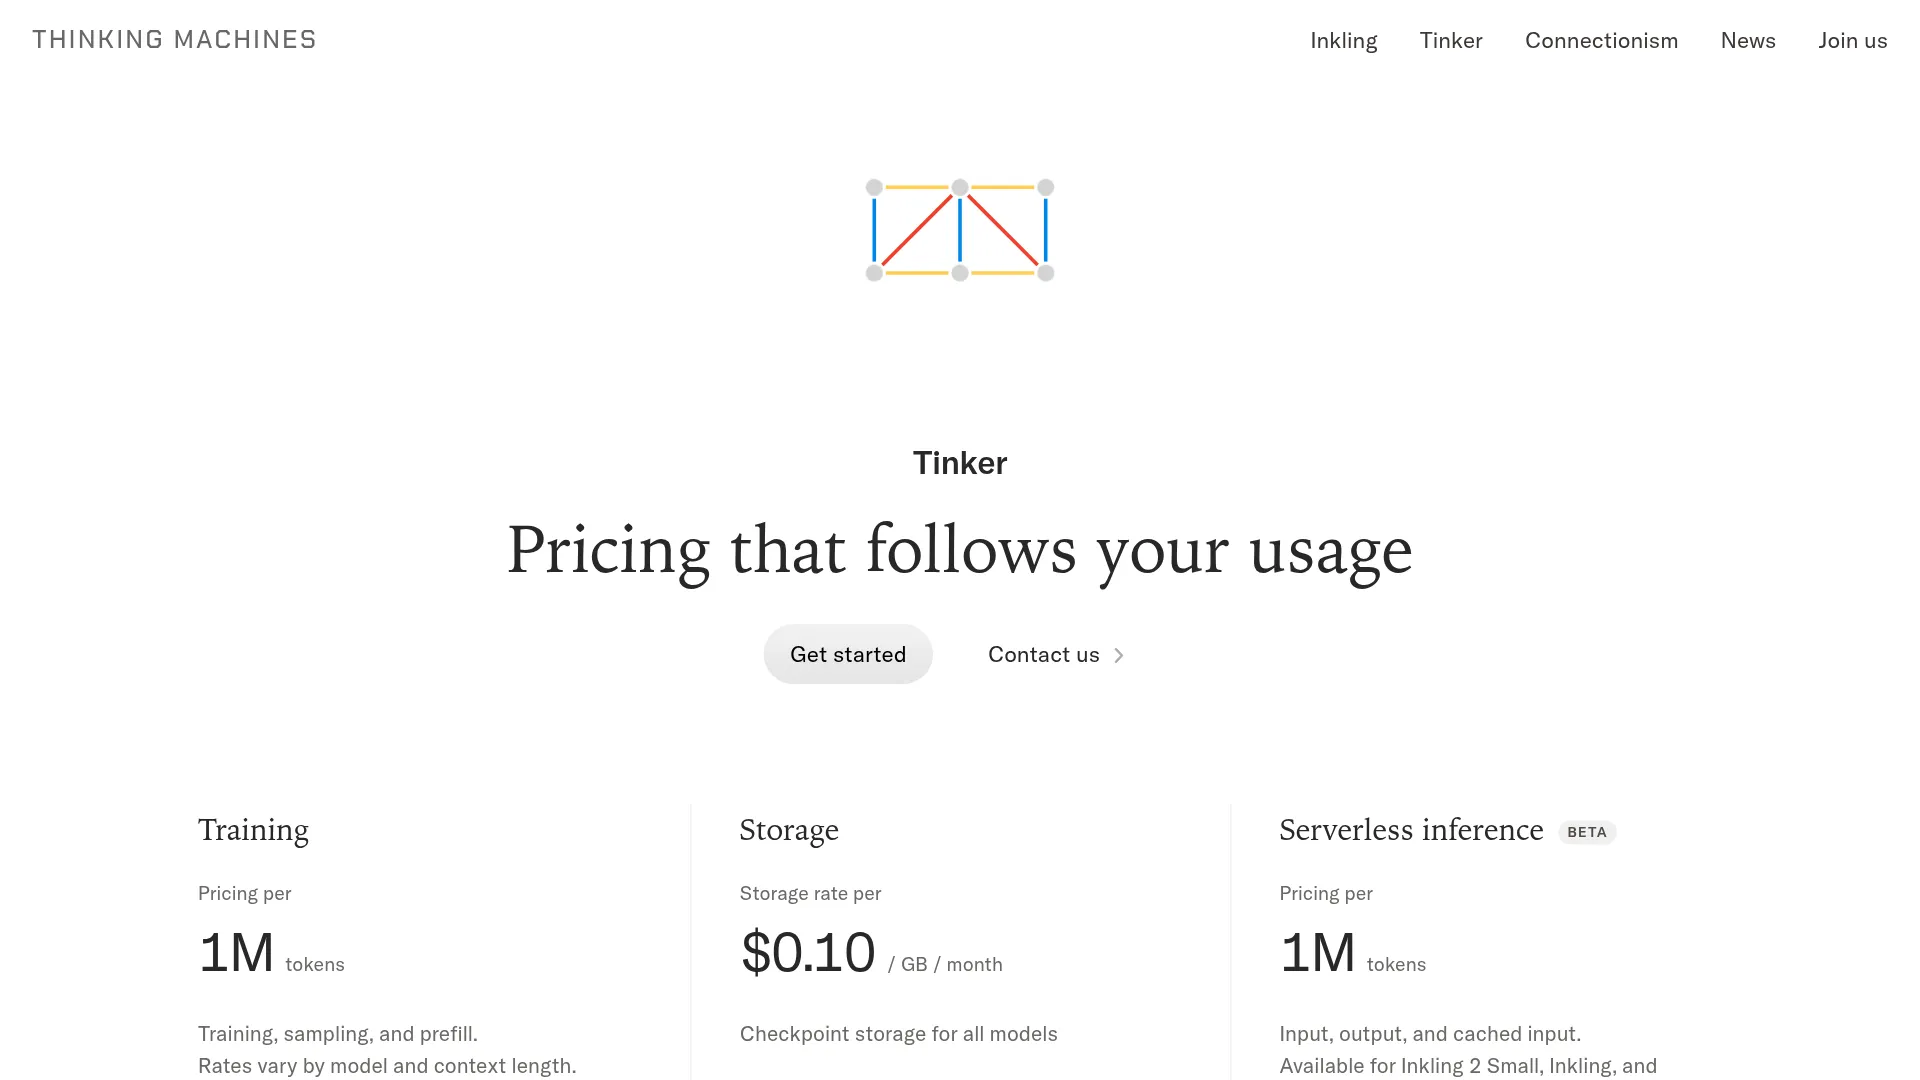
| モデル(サーバーレス、256K) | 入力/100万 | キャッシュ済み/100万 | 出力/100万 |
|---|---|---|---|
| Inkling 2 Small | 0.30ドル | 0.03ドル | 1.00ドル |
| Inkling-Small(第1世代) | 0.30ドル | 0.06ドル | 1.20ドル |
| Inkling(フラッグシップ) | 1.00ドル | 0.17ドル | 4.05ドル |
キャッシュヒット率が80%なら、入力100万トークンの料金は約0.084ドルになる(200K × 0.30ドル+800K × 0.03ドル)。長いコンパクションを伴うロールアウトほど、この料金体系の恩恵を受けやすい。ベンダーによると、この学習方式ではロールアウトトークン数の中央値が43K、p99が1.5Mだった(Thinking Machines Lab)。
ベンチマーク:強い領域と、DeepSeek Flashに負ける領域
以下のスコアはベンダーのレポートカードに基づく。勝った項目だけでなく、敗れた項目も開示されている(Thinking Machines Lab)。
| ベンチマーク | Inkling 2 Small | 表中の最上位モデル |
|---|---|---|
| FrontierCode v2.0 | 25.4% | 28.5% DeepSeek-V4.1-Flash-1017 |
| DeepSWE v1.1 | 72.1% | 77.0% DeepSeek-V4.1-Flash-1017 |
| SWEBench Pro v2 Hard | 86.3% | 88.2% Kimi K3 |
| Vibe Code Bench v1.1 | 81.6% | 87.7% DeepSeek-V4.1-Flash-1017 |
| HLE-Diamond | 28.7% | グループ首位(Kimi K3は26.9%) |
| LongBench v2 | 70.6% | グループ首位(Kimi K3は69.0%) |
| AA-Omniscience(スコア/非ハルシネーション) | 16.1/73.3% | グループ内で非ハルシネーション率が最高 |
| DesignArena Webスナップショット | 1,340(3位) | 1,366 Muse Wonder(首位) |
| JobBench/Vals Legal/Vals Finance | 70.5%/73.9%/61.5% | 表示された各グループで首位 |
| Terminal Bench Science | 5.7% | 12.9% DeepSeek-V4.1-Flash-1017 |
LongBench v2の70.6%は長文コンテキスト対応を裏付ける数字で、HLE-Diamondの28.7%は難度の高い推論性能を示す結果としてグループ首位に立っている。エンタープライズ系では、CoreCraftが71.8%、DAYJOB Financeが14.3%で、JobBenchやValsとともに表示されたグループの首位だった。一方で注意点もある。DiligenceBenchは58.1%でMuse Spark Openの59.0%に届かず、kernel autoresearchは6.02倍で、Claude Opus 5.5の18.80倍を下回る。研究所自身も、冗長さ、構成のばらつき、ツール選択の不完全さ、過剰拒否を課題として認めている。FORTRESSは20.4で、GLM-5.3の3.2を大きく上回る。
Inkling-Smallから何が変わったのか
総パラメーター数は276Bから594Bへと2倍以上に増え、アクティブパラメーターも12Bから17Bになった。ハルシネーション傾向は改善した一方、音声入力はなくなっている。新モデルが受け付けるのはテキストと画像だけで、第1世代は16 kHz WAVにも対応していた(Thinking Machines Lab)。
事実性については、ベンダーの数値を見る限り改善しているように見える。ただし、世代間で使われている指標は同一ではない。第1世代のSimpleQA Verifiedは約20.6%、Omniscienceスコアはマイナスだった(eesel AI)。Inkling 2 Smallは非ハルシネーション率73.3%でグループ首位に立つが、研究所は依然として冗長さと過剰拒否への注意を促している(Thinking Machines Lab)。
第1世代のセルフホスト報告は、v2の性能を示す証拠ではなく、あくまで参考情報として見るべきだ。
「Unsloth Studioで、Q4K_XLにして試してみた。多言語の会話ではかなりうまく動いている」— 第1世代Inkling-Smallのリリーススレッドに投稿されたu/VotZeFukのコメント(Reddit)
第1世代で報告された2-bit時の89 GBという最小構成は、コミュニティによるUnslothビルドのものだった(eesel AI)。総パラメーター数594Bのv2については、重みとレシピが公開されるまで必要要件は分からない。
エージェントにInkling 2 Smallを使うべきか
ルーティングの判断は、ベンチマークの総合順位ではなく、ワークロードの形で決まる。
| ワークロード | Inkling 2 Smallを使うか | 理由 |
|---|---|---|
| 視覚的なフィードバックを伴う長期コーディングエージェント | Tinkerで試す | コンパクションを含む学習と、視覚的な反復ループがこの用途に合う |
| 検索を使うエンタープライズ調査、金融、法務文書の作成 | まず試す | ベンダーの表ではJobBench、Vals Legal/Finance、DAYJOB Financeで首位。実際の文書で検証したい |
| 要約系タスクのファインチューニング | 試す(ベンダーのテストのみ) | ベンダーの200ステップテストでは75ステップで第1世代の最終品質に到達した(Thinking Machines Lab) |
| エラー率の低さを最優先するSWE-bench系コーディング | 使わない。DeepSeek-V4.1-Flash-1017 | DeepSWEは72.1%対77.0%、FrontierCodeは25.4%対28.5% |
| 検索やガードレールなしの事実ベースQ&A | まだ使わない | Omniscience総合スコアは最上位の競合に及ばない。RAGと信頼度ベースのルーティングを併用したい |
| 複数プロバイダーへのフェイルオーバーが必要 | 待つ | Tinkerという単一ベンダー経由のみで、サードパーティー経路は発表されていない |
アラインメントスコアは従来モデルから改善している(内部の不正行動指標は14.9、従来は66.8から75.2。低いほど良い)。それでもGPT-6.1 Solの0.8には及ばない(Thinking Machines Lab)。
Inkling 2 Small FAQ
Inkling 2 Smallはオープンウェイトですか?
いいえ。2026年11月5日時点ではTinker上のクローズドウェイトモデルだ。安全性テストを経て、Apache 2.0の重みを来週公開する予定になっている。
Inkling-Smallとの違いは?
594B/17B対276B/12Bで、音声入力には非対応。非ハルシネーション率は73.3%、出力料金は100万トークンあたり1.00ドル対1.20ドルだ。
API料金は100万トークンあたりいくらですか?
Tinkerのサーバーレス環境では、256Kコンテキスト時に入力が0.30ドル、キャッシュ済み入力が0.03ドル、出力が1.00ドル。
ローカルで実行できますか?
まだできない。重み、レシピ、VRAMの目安はいずれも公開されていない。
関連記事:DeepSeek-V4.1-Flash-1017のコーディングレビュー、Kimi K3.1 ProのAPI料金