 AIREITER
長いコーディング作業やエージェント処理を低コストで回したいなら、MoonshotのKimi K3.1 Proは有力な候補だ。100万トークンのコンテキストを備え、API料金は入力100万トークンあたり$2、出力は$10。以下で紹介するリリース週の利用例では、$39のサブスクリプションより従量課金APIのほうが大幅に安かった。
Kimi K3.1 Proはどんなモデルか
Kimi K3.1 Proは、Moonshot AIが2026年10月23日に公開したK3.1シリーズ初のモデル。Kimi K3をポストトレーニングで発展させた後継にあたり、Moonshotは3TクラスのMixture-of-Expertsモデルと位置付けている。長時間にわたるコーディング、3D・CADツールのワークフロー、金融文書の分析、複数ステップのエージェント処理を主な用途としている。
コンテキストウィンドウは1,048,576トークン。入力100万トークンに加えて出力100万トークンを使えるという意味ではなく、入力・推論トークン・出力の合計で共有する上限だ。Moonshotの製品経由ではテキスト、画像、動画を入力できる。一方、APIが返すのはテキスト、コード、ツール呼び出しであり、視覚的な成果物はBlender、ゲームエンジン、PDFツールなど外部ソフトウェアが生成する。推論は常時有効で、reasoning_effortはlow、high、maxから選べる。デフォルトはmaxだ。
Moonshotは11月4日までに重みを公開すると約束していた。しかし、TheQueryによる10月24日の確認時点では、ダウンロード可能なチェックポイントも最終ライセンスも確認できていなかった。ArtificialWatchもライセンスを不明としている。チェックポイントとライセンスが公開されるまでは、ホスト型APIを前提に考えるのが無難だ。
料金体系:StandardとHighspeedの違い
Kimi API platformにおける通常版Kimi K3.1 Proの料金は、キャッシュされていない入力が100万トークンあたり$2、出力が$10だ。Kimi K3.1 Pro Highspeedは従量課金トークンが2倍となり、入力$4・出力$20。ただしキャッシュ済み入力の読み出しは、どちらも$0.20で変わらない。ArtificialWatchとAI/ML APIの料金表にも、同じく$2/$10と$4/$20の区分が掲載されている。
| 操作(100万トークンあたり) | Kimi K3.1 Pro | Kimi K3.1 Pro Highspeed |
|---|---|---|
| キャッシュなし入力 | $2.00 | $4.00 |
| 出力(推論を含む) | $10.00 | $20.00 |
| キャッシュ済み入力の読み出し | $0.20 | $0.20 |
| キャッシュ書き込み、有効期間5分 | $2.00 | $4.00 |
| キャッシュ書き込み、有効期間1時間 | $4.00 | $8.00 |
表示価格以上に重要な請求ルールが3つある。1つ目は、コンテキスト長による単価差がなく、標準のキャッシュ有効期間は5分であること。同じプロンプトの先頭部分をこの時間内に再利用すれば、入力100万トークンあたり$2.00ではなく$0.20になる。2つ目は、推論トークンも出力単価で請求される点だ。長いエージェント実行でmaxを使うと、推論コストが請求額の大半を占めることがある。3つ目は、API料金がKimiメンバーシップやKimi Codeサブスクリプションとは別であること。TheQueryがBatch APIガイドを確認したところ、K3.1 Proは掲載されていなかったため、バッチ割引が使えるとは考えないほうがよい。
トークン数を固定した例なら、料金は安い。キャッシュなし入力100,000トークンは$0.20、出力10,000トークンは$0.10で、キャッシュ書き込み、ツール、リトライ、税金を除けば合計$0.30だ。
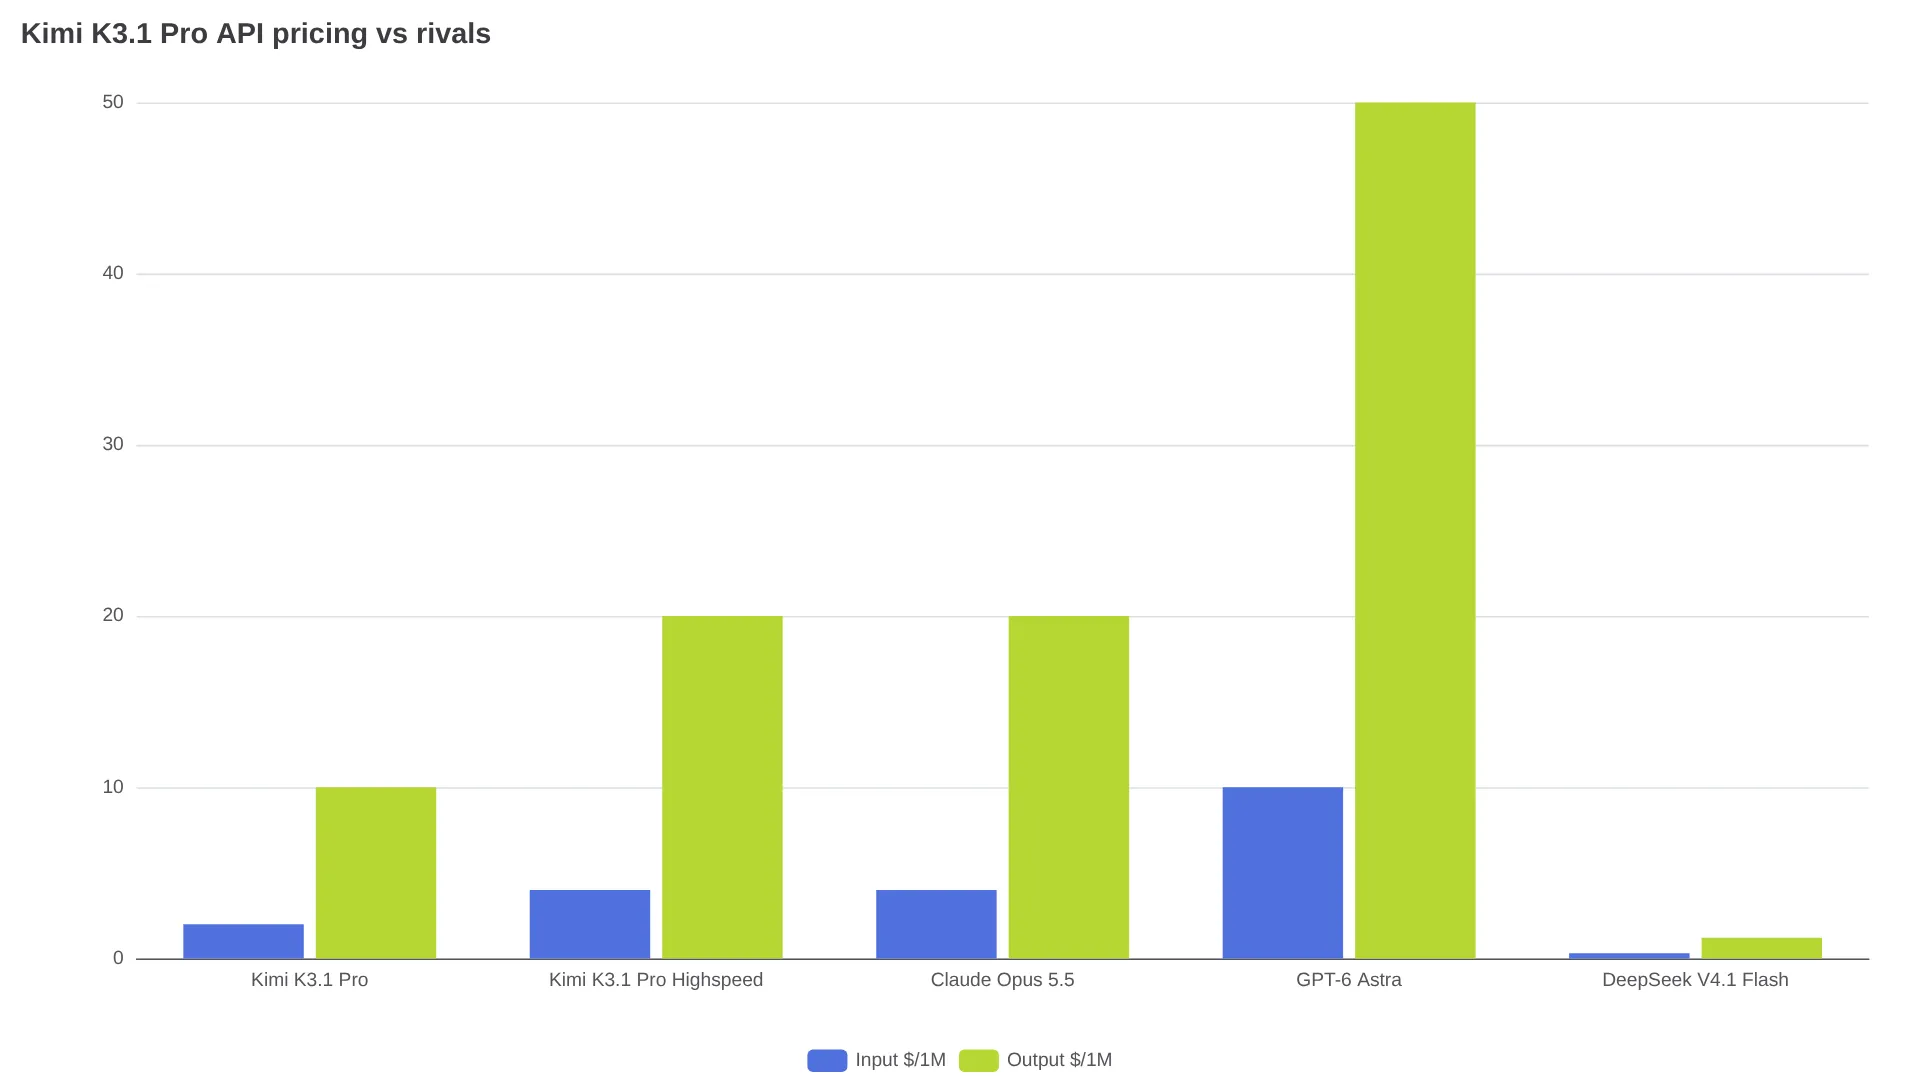
競合と比べると、通常版K3.1 ProはKimi K3の料金($3/$15)より33%安く、Claude Opus 5.5($4/$20)の半額、GPT-6 Astra($10/$50)の5分の1だ。これはArtificialWatchの比較による。AI/ML APIの料金表によれば、DeepSeek V4.1 Flashは$0.30/$1.20で、ここで挙げた全モデルを下回る。ただし次節のベンチマークでは、そのスコアに大きな差がある。HighspeedはOpus 5.5と完全に同額なので、主張されている2〜3倍の高速化によって、レイテンシがボトルネックのタスクをトークン単価2倍分以上に短縮できる場合にだけ意味がある。
$39サブスクは枯渇しやすく、APIはなぜ違うのか
リリース当日の時点でAPI料金は妥当に見えたが、サブスクリプションはそうではなかった。複数の有料ユーザーが、5時間クォータが1〜2回のプロンプトで尽きた、あるいは1件のコーディング作業で月間クォータを消費したと報告している。
"Kimi K3.1 Pro is the best open model in the world right now. No contest. But it's practically unusable on its own subscription. I was on the $39 plan. I built the ship test... it ate 11.6% of my monthly quota. That means I can build something like this about 8 times a month... Worst subscription out there... The bottleneck isn't quality. It's compute." — @Da7_Tech、ユーザー報告によるクォータ消費量
"absolutely disgusting and shameful usage limits on Kimi K3.1 Pro. My 5-hour limit was DONE after exactly 1 min into the prompt, and nothing was built!" — @MiaAI_lab、$39プラン契約者
あるユーザーは、4回のプロンプトでサブスクリプションに$400を支払った一方、同じ作業ならAPIで$29と見積もった。また別のユーザーは、アニメーション作成を1件実行しただけで5時間クォータの大半を消費したと報告している。開発者にとって結論は明快だ。K3.1 Proの評価は、同じ推論をはるかに厳しく制限するサブスクリプションではなく、Moonshot、OpenRouter、Vercel AI Gatewayなどの従量課金APIで行うべきだ。リトライやツール利用を除けば、入力100k・出力10kは$0.30で済む。
ベンチマークを読む際の注意点
以下の主要スコアは、特記がない限りMoonshot公表値だ。最大推論強度、temperature 1.0、top-p 0.95で実行されている。AI/ML APIの記録によれば、競合モデルのスコアは異なるハーネスで取得されている。KimiはKimi Code、他社モデルはClaude Code、OfficeQAのGPT-6 AstraはCodexを使用している。そのため、小さな差は設定依存として扱うべきだ。
| 評価 | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek V4.1 Flash 1017 |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 65.7% | 66.4% | 58.2% | 42.3% |
| SWE-Marathon v1.1 | 51.7% | 46.3% | 42.5% | 40.0% |
| Agents' Last Exam v1.1 | 43.2% | 42.6% | 32.8% | 37.7% |
| OfficeQA Pro v2 | 64.4% | 62.2% | 54.4% | 40.4% |
| BenchCAD with tools | 92.7% | 96.2% | 95.9% | 81.6% |
Kimiは5項目中3項目で首位となった。Terminal-Benchでは0.7ポイント差で遅れるが、TheQueryの指摘によると、この差はAnthropicがOpusについて報告した2.6ポイントの標準誤差より小さい。BenchCADの92.7%は、1,000ケースのオープンモデルサブセットにおけるボクセル重複率だ。また、AI/ML APIの方法論に関する注記では、Claudeの数値は統一条件での再実行ではなくシステムカードからの引用とされている。
事実性については、Moonshotの社内Kimi Hallu Benchで、K3.1 Proの主張単位のエラー率は標準セットで5.4%、GPT-6 Astraは4.2%だった。ツールありのHardセットではK3.1 Proが8.3%、Astraが5.5%。これはAI/ML APIのHallu表による。K3のHardレート23.4%からは相対で65%減少しているが、両方の区分でAstraが依然として上回る。1つの誤った記述でも成果物が使えなくなる用途では、Astraも候補に残しておきたい。いずれも日常的なエラー確率ではなく、敵対的条件下のストレステストだ。
リリース時点で利用できた独立系のデータポイントは、Artificial Analysisによるものだった。同社はK3.1 ProをIntelligence Indexで55点、総合4位と評価し、Claude Opus 5.5、Sonnet 5.5、Muse Wonder Fullに次ぐ位置に置いた。ベンダー自身の測定だけに頼らず、「最前線に近い性能を半額で」という主張を裏付ける順位といえる。
余計なコストをかけずにAPIを呼ぶ方法
Kimi K3.1 ProはOpenAI互換なので、移行時に必要なのはベースURLとモデルIDの変更だけだ。TheQueryのエンドポイント確認とAI/ML APIのセットアップガイドによると、公式ベースURLはhttps://api.moonshot.ai/v1、モデルIDはkimi-k3.1-proとkimi-k3.1-pro-highspeed。サードパーティーゲートウェイでは、Requestyのmoonshot/kimi-k3.1-proや、Vercelのmoonshotai/kimi-k3.1-proのように名前空間付きIDを使う。
クイックスタートはtemperature 1.0とtop-p 0.95を固定し、調整せず省略することを推奨している。これはTheQueryのAPI挙動に関する注記にも記載されている。コストはreasoning_effortで制御しよう。まず検証にはlowを使い、タスクが失敗したらhighへ上げ、最終実行だけでデフォルトのmaxを使う。max_completion_tokensを8,192トークンに設定しても、内部推論が同じ予算を消費するため、画面に返る回答はずっと短くなる場合がある。内部推論も100万トークンあたり$10で課金される。
AI/ML APIのツール利用・トークン管理ガイドに基づくコスト管理チェックリスト:
- ツール実行の各ステップ間では、ストリーミング時の
reasoning_contentを含め、assistantメッセージ全体を保持する。次の呼び出しの前にツール結果を返す。 - 5分間のキャッシュウィンドウ内でプロンプトの先頭部分を再利用し、繰り返し入力の料金を100万トークンあたり$0.20まで下げる。
- トークン単価ではなく、受け入れ可能な結果1件あたりのコストを測定する。
- トークン単価が安くても、2回リトライするモデルは安くない。
from openai import OpenAI
client = OpenAI(
    base_url="https://api.moonshot.ai/v1",
    api_key="YOUR_KIMI_KEY",
)
resp = client.chat.completions.create(
    model="kimi-k3.1-pro",
    messages=[{"role": "user", "content": "Refactor this module with tests"}],
    extra_body={"reasoning_effort": "low"},
    max_completion_tokens=8192,
)
print(resp.choices[0].message.content)TheQueryのAPI挙動チェックによれば、$1のチャージで利用可能になるが、階層別のレート制限が適用される。また、エンタープライズアクセスは管理者が有効化するまでデフォルトで無効だ。プライバシー面では、OpperによるMoonshotルートの監査で、コンテンツが保持され、顧客データはデフォルトでトレーニングに使用されると報告されている。このルートにはゼロデータ保持の選択肢もない。契約上の保護措置なしに、機密情報や規制対象データを送るべきではない。
結局どれを選ぶべきか:価格に織り込むべきトレードオフ
| 必要なもの | 選択肢 | 理由 |
|---|---|---|
| 最安のフロンティア級コーディング実行 | Kimi K3.1 Pro API | Opusの半額でSWE-Marathon首位、共有100万トークンのコンテキスト |
| 最小のレイテンシ | Kimi K3.1 Pro Highspeed | 公称2〜3倍の高速化。ただしトークン単価は正確に2倍 |
| 事実誤りの少なさ | GPT-6 Astra | 標準Halluで5.4%に対し4.2%、価格は5倍 |
| 最安トークン、性能は控えめ | DeepSeek V4.1 Flash | $0.30/$1.20だが、掲載した5ベンチマーク中4項目で最下位 |
| セルフホスティング | 待つ | 重みは11月4日までに公開予定、ライセンスは不明 |
Moonshotが11月4日までに寛容なライセンスで完全な重みを公開すれば、セルフホスティングによってクォータとAPIの損得勘定は変わる可能性がある。長文コンテキストに強いコーディングモデルを比較する開発者は、導入を決める前に2026年のコーディングエージェント向けベストLLMも確認しておきたい。
Kimi K3.1 Pro API FAQ
Kimi K3.1 Pro APIの料金はいくら?
通常版Kimi K3.1 Proは、キャッシュなし入力が100万トークンあたり$2、出力が$10。キャッシュ済み入力の読み出しは100万トークンあたり$0.20だ。Highspeedは入力・出力・キャッシュ書き込みの料金が2倍になる一方、キャッシュ読み出しは同じく$0.20に据え置かれる。
K3.1 ProとHighspeedの違いは?
Highspeedは、同等の知能を入力・出力料金2倍($2/$10に対して$4/$20)で、配信速度2〜3倍とアピールしている。Vercelのライブプロバイダー表でもHighspeedは低レイテンシ・高スループットとされているが、Moonshotによる高速化の主張には、タスク完了時間を比較する独立検証がない。
APIのモデルIDは?
公式Kimi APIではkimi-k3.1-proとkimi-k3.1-pro-highspeedを使う。サードパーティーゲートウェイでは、moonshot/kimi-k3.1-proのような名前空間付きIDを使用する。既存のK3統合では、明示的にIDを切り替える必要がある。
API利用料はKimiメンバーシップに含まれる?
含まれない。API料金はKimiメンバーシップおよびKimi Codeサブスクリプションとは別だ。リリース週のユーザー報告では、同じ作業に対してサブスクリプションのクォータは従量課金トークンよりはるかに制限が厳しかった。
推論をオフにできる?
できない。Kimi K3.1 Proは常に推論を行う。low、high、maxは検討量を減らす設定にすぎず、デフォルトはmaxだ。短い非推論リクエストには別モデルを使うべきだ。
APIはOpenAI互換?
はい。OpenAI SDKクライアントの接続先をhttps://api.moonshot.ai/v1(またはゲートウェイのベースURL)に変更し、モデルIDを設定してstream=Trueでストリーミングすればよい。クイックスタートではtemperature 1.0とtop-p 0.95が固定されている。代わりにreasoning_effortとmax_completion_tokensを調整する。