 AIREITER
MiniMax M3.1 Flashのopen weightsは、2026年10月23日に公開された。注目点は「428Bモデルを誰でもダウンロードできる」ことだが、実運用では単一GPUで気軽に動かせるモデルではない。MiniMaxAI/MiniMax-M3.1-Flashには48分割、合計約252 GBのチェックポイントが置かれており、ダウンロード承認は不要。ただしMiniMax Community Licenseでは、商用利用に表示義務と一度きりの通知が求められ、年間売上が$20Mを超える場合は事前承認も必要になる。
252 GBのMiniMax M3.1 Flashは、誰に向くのか
MiniMax M3.1 Flashは、総パラメータ数が約428B、トークンごとの活性化パラメータが約23BのネイティブマルチモーダルMoEモデルだ。テキスト、画像、動画を入力に受け取り、テキストを出力する。コンテキスト長は最大1,000,000トークン。MiniMax Sparse Attentionを全面採用し、DSparkの投機的デコーディング用draft headも同梱されている。重みはHugging FaceおよびModelScopeのミラーから取得可能だが、「Flash」は小型という意味ではなく、推論コスト面での位置付けを示す名称だ。また、open weightsはオープンソースと同義ではない。
| 項目 | 確認できた内容 |
|---|---|
| 総パラメータ数 / 活性化パラメータ数 | 総数約428B、1トークン当たり約23B |
| コンテキストウィンドウ | 最大1,000,000トークン |
| 入力 / 出力 | テキスト・画像・動画を入力、テキストを出力 |
| チェックポイント容量 | 約252 GB、48個のsafetensorsシャード + DSpark draft head |
| 量子化 | MXFP8構成、ルーティングされるMoEパスではNVFP4 |
| 推論設定 | Temperature 1.0、top-p 0.95、reasoning_effortはlow / medium / high / xhigh / max |
| サービング用レシピ | SGLang、vLLM、TokenSpeed、マルチチップ向けFlagOS |
| API料金 | 100万トークン当たり、入力$0.15 / 出力$0.60 / キャッシュ$0.015 |
| 実測タスクコスト | エージェントタスク当たり約$0.22(TPS Report経由のArtificial Analysis) |
| ライセンス | MiniMax Community License、商用利用には条件あり |
マルチGPU基盤をすでに持つチームや、現状のAPI請求額を$0.15/$0.60の料金体系で下げられるエージェントワークロードには適している。一方、ノートPCや単体のコンシューマーGPU環境には向かない。必要な帰属表示を製品に載せられない商用サービスも対象外だ。結論としては、まずAPIを使い、利用量またはデータ管理要件がハードウェア投資を正当化する段階でセルフホストを検討するのがよい。
公式weightsの入手先と確認ポイント
公式チェックポイントはHugging FaceのMiniMaxAI/MiniMax-M3.1-Flashにある。MiniMaxの10月23日の告知投稿からも、Hugging FaceとModelScopeのダウンロード先へ誘導されている。alfw.aiによるweights公開の分析では、承認ゲートなしで約252 GBを配布し、48個のweight shardに加えてDSpark draft head、tokenizer、設定ファイルを含むと報告している。
hf download MiniMaxAI/MiniMax-M3.1-Flash --local-dir MiniMax-M3.1-Flash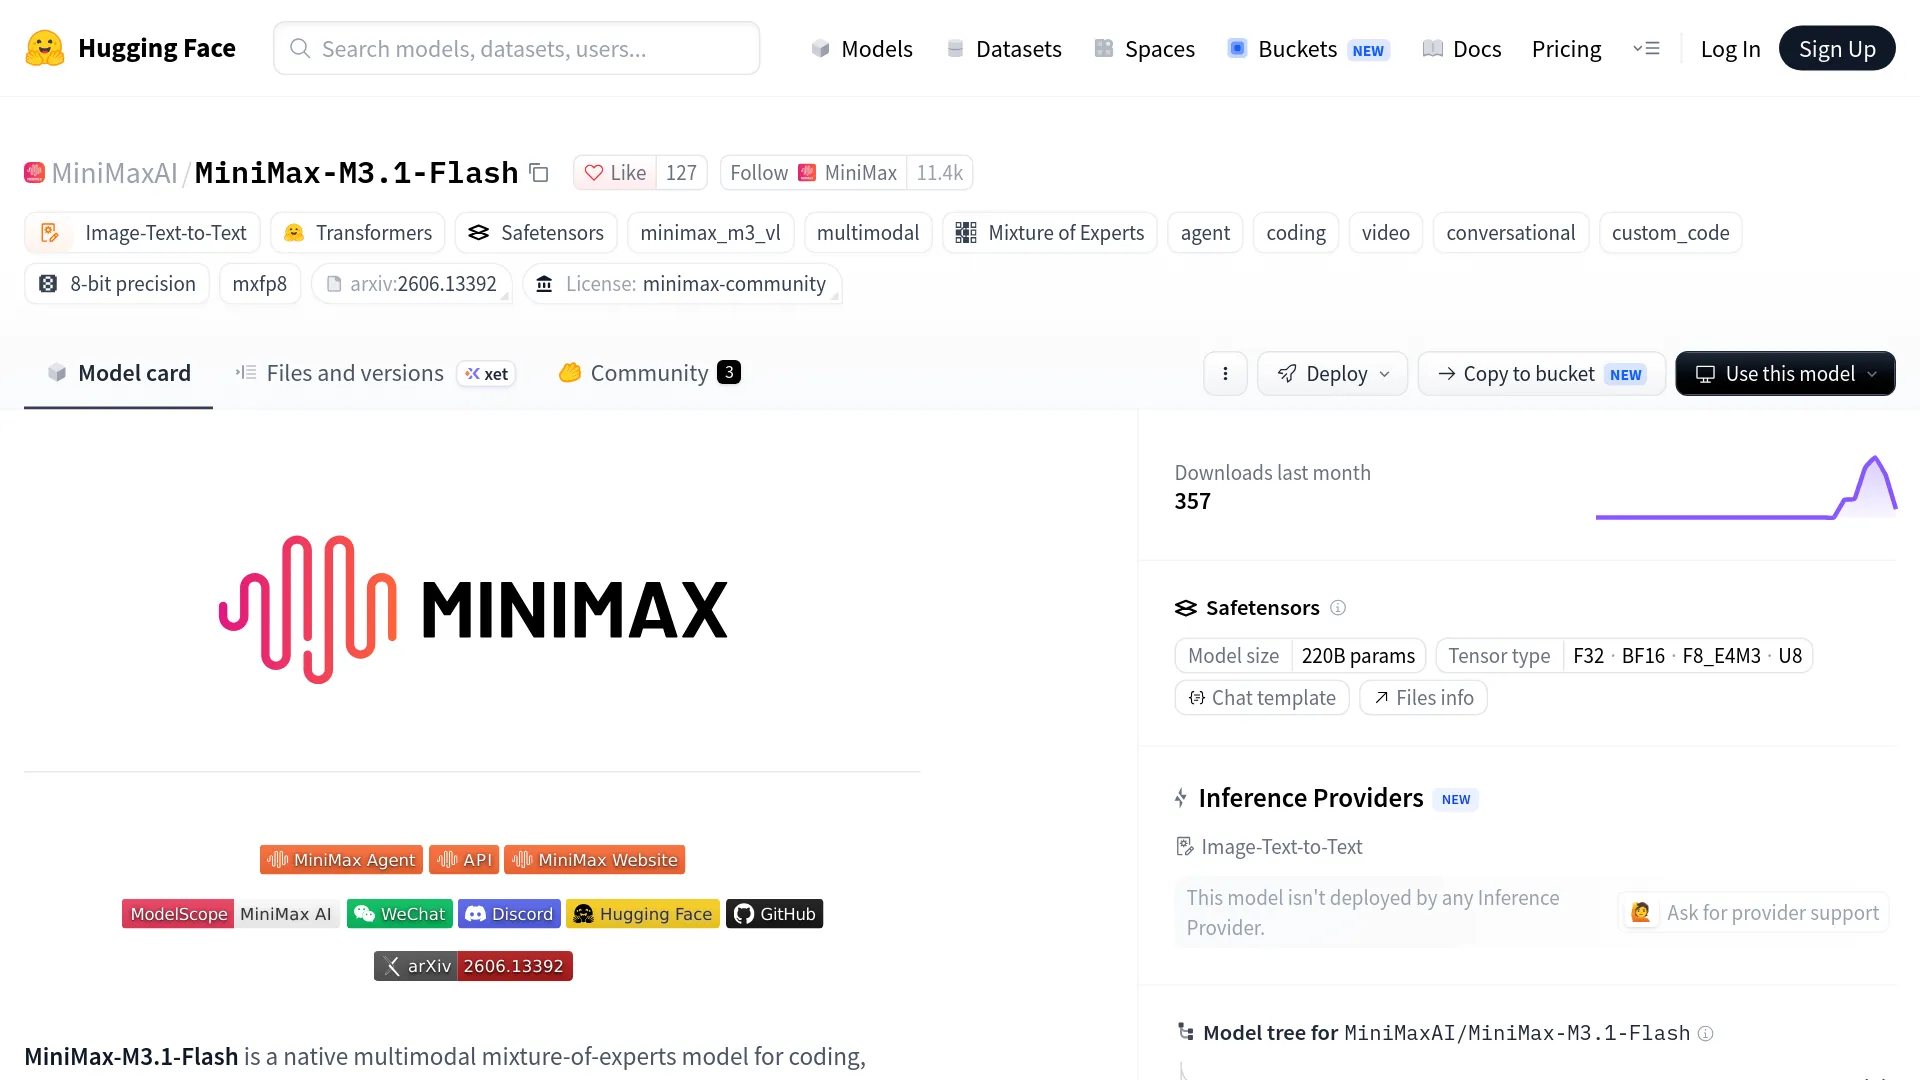
ハードウェア予算を組む前に、リポジトリページで3点を確認したい。まず、部分的なミラーではなく48個すべてのシャードとdraft headがファイル一覧に揃っているか。次に、ライセンス欄がMITやApacheではなくminimax-communityになっているか。集約サイトに残る古いプレリリース表記は当てにしないこと。さらにモデルカードにもある通り、公開スコアは公式weightsに対するものだ。第三者による量子化版では挙動が異なる可能性があるため、今週出回っているEXL3版や再パッケージ版は、ベースコミットを明記していない限り未検証として扱うべきだ。
セルフホスト前に確認したいハードウェア要件
「1トークン当たり23Bしか活性化しない」からといって、428Bモデルが小さくなるわけではない。ローカル実行の可否を論じる際、ここを取り違えがちだ。活性化パラメータ数はトークン当たりの推論コストを左右する。一方、保存・メモリ保持すべき容量を決めるのは総パラメータ数だ。4280億パラメータをBF16で保持すると、2バイト換算でweightsだけでも約856 GBになる。一般的な4-bit表現でも約214 GBだ。実際の約252 GBのリポジトリ容量には、学習済みの量子化レイアウトに加え、tokenizer、設定、draft headのファイルも含まれる。ランタイムバッファやKV cacheは別途必要になる。
「MiniMax-M3.1-Flash open weights are now LIVE 🔥🔥 428B params, 23B active.」 — @MiaAI_lab。約252 GBのダウンロード容量と、TensorFoldレシピおよびEXL3量子化の取り組みに言及
チーム用途でも必要なハードウェア水準は高い。@perry_weijieは、個人マシンでの実行は基本的に難しく、余剰GPUを持つチームなら自前構築が現実的だと指摘している。公開初日の実測例として確認できたのは、@majewskizbyによるTP4・4x DGX Spark構成だ。NVFP4/MXFP8パスとTriton sparse attentionを用い、262Kコンテキストで通常テキストのデコードは約39.7 tok/s、構造化出力では62.2 tok/sと報告された。ベンダー資料ではなく初日の実測値ではあるが、それでも高性能な4ノードを連携させる前提である。
手間が少ない順に、現実的な導入ルートを並べると次の通り。
- SGLang:モデルカードからリンクされたcookbookを利用する。Dockerパターンとして、
--shm-size 32g、ポート30000、HFキャッシュのマウントも案内されている。 - vLLM:モデルカードのリンク先レシピを利用する。カードの例ではポート8000で
vllm serveを実行する。 - TokenSpeed:効率重視のパス向けに用意されたリンク先レシピを利用する。
- FlagOS:マルチチップ環境向け。
すでに注意すべき落とし穴もある。reasoning effortのデフォルトはmaximumで、lowからmaxの制御を変更しなければ、料金とレイテンシが膨らむ。minimax-m31flash.orgの独立系セットアップノートでは、長文コンテキスト用のモデルサフィックス間違い、環境変数による設定ファイルの上書き、Codexの最低バージョンが古いこと、廃止済みpreviewモデル名といった、エージェント統合で典型的な問題も挙げている。Transformers、KTransformers、unsloth、ATOMとの統合はモデルカード上で進行中とされていたため、導入計画に組み込む前に対応状況を確認したい。alfw.aiは10社のチップメーカーと6つのクラウドへの対応予定を列挙しているが、実際に料金を払うプロバイダーのカタログにモデルが載るまでは、互換性発表として受け止めるべきだ。
APIとセルフホスト、コストで選ぶなら
トークン単価だけで比較すると、エージェント用途では判断を誤る。実際にはreasoning tokenとキャッシュ挙動の影響が大きい。MiniMaxの固定API料金は、100万トークン当たり入力$0.15、出力$0.60、キャッシュ済み入力$0.015。minimax-m31flash.orgによれば、512K入力トークンを超えると料金が2倍になるMiniMax M3とは異なり、長文コンテキストでの段階的な値上げはない。Artificial Analysisは同一スイートで、M3.1 Flashのタスク当たりコストを約$0.22、DeepSeek V4.1 Flash 1017を約$0.26と測定した。出力トークン数はそれぞれ189Mと224Mで、単純な値下げではなくreasoning効率の差により、タスクコストでおよそ15%の優位性が出た形だ。
| 選択肢 | 向く用途 | 注意点 |
|---|---|---|
MiniMax API(api.minimax.io、minimax-m31flash.orgによればAnthropic/OpenAI互換) | コーディングエージェント、変動負荷、ハードウェアなしでの1Mコンテキスト処理 | reasoning effortのデフォルトはmax。実際の請求額はキャッシュとサービスティア設定で決まる |
| M Planサブスクリプション(minimax-m31flash.orgによるGo / Explore / Buildティア) | MiniMax Code内での予測可能なコーディング支援利用 | 通常の月間トークン枠ではなくウィンドウ単位の制限。予算化前にドル建て価格を確認する |
| セルフホスト(SGLang / vLLM / TokenSpeed、マルチチップはFlagOS) | 継続的に高い利用量、データ管理要件、ファインチューニングのベースモデル | 252 GBのダウンロード、長文コンテキストでのマルチGPUメモリとKV cache、検証済みの最小構成は未提示 |
ダウンロードを始める前に、自分のワークロードで計算したい。月間の入力・出力トークン構成に$0.15/$0.60を掛け、実際のキャッシュヒット率を反映させる。そのうえで、予約GPU費用とエンジニアリング工数を比較する。継続的な高負荷に達しない限り、多くのケースではAPIの方が有利になりやすい。月間API費用が償却後のクラスタコストを超える場合、あるいはweightsを自組織の境界内に置く必要がある場合には、セルフホストが有力になる。
ベンチマークは測定主体を分けて読む
| ベンチマーク | M3.1 Flash | 掲載表内の最上位競合 | 出典 |
|---|---|---|---|
| Automation-Bench v1.0.6 | 62.8 | 60.5 DeepSeek V4.1 Flash-1017 | MiniMaxカード(ベンダー) |
| BankerToolBench | 76.2 | 76.2 Opus 5(同点) | MiniMaxカード(ベンダー) |
| LOCA-Bench 256K | 60.3 | 60.0 GPT-5.6 Sol | MiniMaxカード(ベンダー) |
| OSWorld 2.0 | 61.7 | 70.6 Opus 5 | MiniMaxカード(ベンダー) |
| CyberGym | 82.2 | 84.5 GLM-5.3 | MiniMaxカード(ベンダー) |
| DeepSWE v1.1 | 73.7 | 77.0 DeepSeek V4.1 Flash-1017 | MiniMaxカード(ベンダー) |
| Vals Index | 53.78%(26モデル中16位) | MiMo V2.6 Flash 54.83%(公開時点) | Vals AI(独立評価) |
| Intelligence Index | 42 | 45 DeepSeek V4.1 Flash 1017 | TPS Report経由のArtificial Analysis(独立評価) |
| LMArena WebDev | 1587.48 | ランキング対象モデル群 | VectorWire(10件中、独立検証済みは唯一) |
MiniMaxのモデルカードは、各ベンチマークのハーネスも明記している。たとえばBankerToolBenchはOpenCode 1.17.18上でMiniMax-M2.7をjudgeとして使用し、CyberGymはClaude Code 2.1.263、1Mコンテキストで実行した。この透明性は多くのローンチ投稿より優れているが、スコア自体はベンダー報告であることに変わりはない。独立評価の見方はより慎重だ。Vals AIは、M3からVibe Code Benchで26.37ポイント伸びたとする一方、長期タスクの弱さも指摘している。同社ハーネスでTerminal-Benchは25.25%、HLAB-Valsは7.50%だった。Artificial Analysisはomniscience accuracy 56%という強さとともに、そのベンチマークで93%のhallucination rateも報告した。VectorWireは、能力を順位付けするには証拠が薄すぎると評価している。このhallucination rateは、検索結果の利用、コンプライアンス、顧客向け回答では検証レイヤーを加えるべき警告と捉えたい。
商用利用を左右するMiniMax Community License
weightsをダウンロードできても、MiniMax Community Licenseは無制限のオープンソースライセンスではない。ライセンスの付与は非商用利用を軸としており、商用利用には条件が付く。製品またはサービスに「Built with MiniMax M3.1-Flash」を目立つ形で表示すること、MiniMaxへ一度きりの通知を送ること、年間売上が$20Mを超える場合はMiniMaxの事前書面承認を得ることが必要だ。商用利用の定義は広く、有料ホスティング、モデルAPI、ファインチューン、改変した派生物も対象に含まれる。軍事利用と、害のある虚偽または誤解を招く情報を意図的に生成する用途は禁止されている。alfw.aiのライセンス分析では、このモデルのライセンスには地域制限がないとされる。ただしMiniMaxのFAQではなく第三者分析に基づく解釈なので、出荷前に法務へ確認したい。分類としては、オープンソースではなくopen weightsだ。
FAQ
MiniMax M3.1 Flashのweightsは本当にダウンロードできる?
できる。MiniMaxAI/MiniMax-M3.1-Flashは2026年10月23日にHugging Faceへ公開され、約252 GBのファイルを承認ゲートなしで取得できる。ModelScopeにもミラーがある。
公式のHugging Faceリポジトリは?
MiniMaxAI/MiniMax-M3.1-Flash。48個のsafetensorsシャード、DSpark draft head、tokenizer、設定ファイルを含み、ライセンスタグはminimax-communityだ。ダウンロードにはhf download MiniMaxAI/MiniMax-M3.1-Flash --local-dir MiniMax-M3.1-Flashを使う。
M3.1 Flashを商用利用できる?
条件付きで可能。「Built with MiniMax M3.1-Flash」を表示し、一度きりの通知を送付する。年間売上が$20Mを超える場合は事前の書面承認も必要だ。ファインチューンやホスト型APIも商用利用に含まれる。
コンシューマーGPUやApple Siliconで動かせる?
ここで挙げた情報には、単体のコンシューマーGPUまたはApple Siliconで検証済みのデプロイ例はない。フルチェックポイントは約252 GBであり、BF16換算ではweightsだけで約856 GBになるため、一般的なGPUメモリ構成では実行できない。マルチGPUサーバーまたはクラウドプロバイダーを想定すべきで、ここで引用した公開初日の実測は4x DGX Sparkを使っている。
vLLM、SGLang、TokenSpeedに対応している?
対応している。モデルカードから公式レシピへリンクされており、推奨ルートはSGLangとvLLM、3番目のレシピがTokenSpeedだ。マルチチップのデプロイはFlagOSがカバーする。Transformers系の統合は公開時点では進行中だった。
DeepSeek V4.1 Flashと比べてどう?
AAスイートではタスク単価が低く、約$0.22対約$0.26だった。また、その時点の比較ではHLEとomniscience accuracyで優位だった。一方、総合Intelligence Indexは42対45で下回り、DeepSWEも1017ビルドに対して73.7対77.0だった。低コストなエージェントコーディング用途ではタスクバッチで試す価値があるが、総合指標とDeepSWEを重視するならDeepSeekも自分のタスクで検証すべきだ。次の一手は、デフォルトmaxのreasoning effortを自分の設定へ変更したうえで、有料APIのタスクバッチを1回実行すること。その結果を見て、weightsのダウンロードに進む価値があるか判断したい。