 AIREITER
いま大半の開発者がGPT-6 CyberをAPIから呼び出せるかというと、答えはNoです。OpenAIのドキュメント、プロバイダー公開ベンチマーク、利用者報告を総合すると、このモデルはエクスプロイトに強い専門家向けモデルですが、利用にはDaybreak Redの承認が必要です。防御寄りの業務の多くは、半額のGPT-6 Astraでカバーできます。
2026年11月5日にgpt-6-cyberとして公開されたGPT-6 Cyberは、認可済みの脆弱性発見、エクスプロイト検証、パッチ開発向けにGPT-6 Astraを追加学習したモデルです。KingyおよびBenchLMのモデル系譜によれば、利用はDaybreak Redを通じて制限されています。
まず結論:RedとBlueの使い分け
GPT-6 Cyberでどのアクセス経路を使うべきかは、アカウント種別だけでなく、何を行うかで決まります。Daybreak Blueはメインラインモデルによる防御業務向け、Daybreak Redは認可された攻撃的な業務とgpt-6-cyberそのものの利用向けです。
| やりたいこと | 選ぶべきティア | 呼び出すモデル | 主な違い |
|---|---|---|---|
| セキュアコードレビュー、マルウェア分析、インシデント対応、パッチ検証 | Daybreak Blue | gpt-6-sol、gpt-6-luna、gpt-5.6-sol | 標準利用より拒否が少ない。エクスプロイト開発の権限は付かない |
| 認可済みペンテスト、レッドチーム、エクスプロイトの大規模検証 | Daybreak Red | gpt-6-cyber(+ gpt-5.5-cyber、gpt-5.6-cyber) | 別途承認が必要。リクエスト値はdaybreak_red、IP許可リスト、SSO/MFAも必要 |
| ときどきセキュリティレビューを行う一般的なコーディング | StandardまたはBlue | gpt-6-sol、gpt-6.1-sol | Cyberのプレミアム料金を払う必要はない |
| 堅牢化された標的やゼロデイを対象に、再現性まで求められる研究 | Daybreak Red(要件を満たす場合) | gpt-6-cyber | 人間によるレビューとサンドボックスの予算を見込む |
OpenAIのDaybreak APIガイドが明記しているとおり、リクエストパラメータを指定しただけではアクセス権は得られません。組織、プロジェクト、プログラム、モデルがあらかじめ承認され、そのプロジェクトで発行されたキーを使う必要があります。
開発者向けに端的に言えば、ソフトウェアを守る仕事ならBlueを申請するのが先です。Redを目指すのは、認可された攻撃的評価を文書化でき、分離されたインフラを運用し、人間をレビュー工程に残せる場合に限るべきです。
GPT-6 Cyberの正体と、Critical評価が示すもの
GPT-6 Cyberは、GPT-6 Astraをベースにサイバーセキュリティ特化の強化学習を追加した、重み非公開のAPI・Codex専用モデルです。Kingyによるシステムカードの読み解きでは、エクスプロイト性能、スコープの順守、不完全な作業を正直に報告することが学習上の重点とされています。
Kingyのドキュメント分析によると、コンテキストは大きい一方で上限があります。コンテキストウィンドウは1,050,000トークン、最大入力は922,000トークン、最大出力は128,000トークンです。テキストと画像を入力でき、出力はテキストのみ。Responses APIとChat Completionsで利用でき、ストリーミング、関数呼び出し、構造化出力に対応します。ファインチューニングとBatch APIには対応していません。
Criticalは、独立した安全認証ではなく、OpenAIのPreparedness Frameworkにおける能力区分です。ArtificialWatchによれば、OpenAIはGPT-6 CyberとGPT-6 Astraのサイバーセキュリティ能力をいずれもCriticalに分類しています。GPT-5.6 CyberのHighから引き上げられた評価です。OpenAIのGPT-6 Astra向け安全性概要では、これは堅牢化された実環境システムに対する実用的なゼロデイエクスプロイトの特定・開発、あるいは堅牢化された標的へのエンドツーエンド攻撃の計画が可能な水準を意味します。
開発者にとってCritical評価が実務上もたらす影響は3つです。
- Daybreak Redに加え、
gpt-6-cyberモデル個別の追加承認が必要になる - 分離、標的の制限、アクションレビュー、Codexの一時停止・リクエスト終了・アクセス取り消しを行える監視といった、必須のデプロイ管理策が求められる
- より厳格なZDR運用が必要になる。Magicaによれば、Private Safety Processingでは暗号化された安全性記録を顧客管理ストレージに30日間保持する
関連記事:GPT-6 Astra APIレビュー、GPT-6で判明していること、OpenAI DevDay 2026の開発者向けまとめ。
Responses APIでのRedとBlueの指定方法
Daybreak RedとBlueを混同すると、統合時にありがちな失敗につながります。Responses APIではモデルとアクセスプログラムが別に扱われます。リクエスト値は、組織が保有する最上位ティアではなく、対象モデルに合わせなければなりません。
| モデル | 組織に必要な承認 | access_programs.cyberに指定する値 | 誤った場合 |
|---|---|---|---|
gpt-6-sol | BlueまたはRed | daybreak_blue | daybreak_redを送るとinvalid_access_programが返る |
gpt-6.1-sol、gpt-6-astra | Red(拒否を減らす場合) | daybreak_blue | daybreak_redは拒否される。BlueのみではAstraの標準セーフガードが維持される |
gpt-5.5-cyber、gpt-5.6-cyber | Red | daybreak_red | 省略時はRedが自動選択され、アクセス権がなければ失敗する |
gpt-6-cyber | Redとモデル個別の追加承認 | daybreak_red | プロジェクト有効化、IP許可リスト、正しいキーがなければ失敗する |
GPT-6 Cyberの最小限の呼び出しは次のようになります。
{
  "model": "gpt-6-cyber",
  "access_programs": { "cyber": "daybreak_red" },
  "safety_identifier": "user_a17f",
  "input": "パストラバーサル修正のためのリグレッションテストを提案してください。"
}
GPT-6 Cyberのセットアップには、Blueプロジェクトでは不要な手順が追加されます(チェックリストは後述)。オーナーが有効化したRedプロジェクト、許可リスト登録済みIP、SSO/MFA、該当する場合は検証済みのZDRストレージが必要です。レスポンスは適用されたプログラムをaccess_programs.cyberに返します。また、-latestを呼び出す場合は、解決されたmodelフィールドを確認してください。Daybreak APIガイドにもこの点が記載されています。
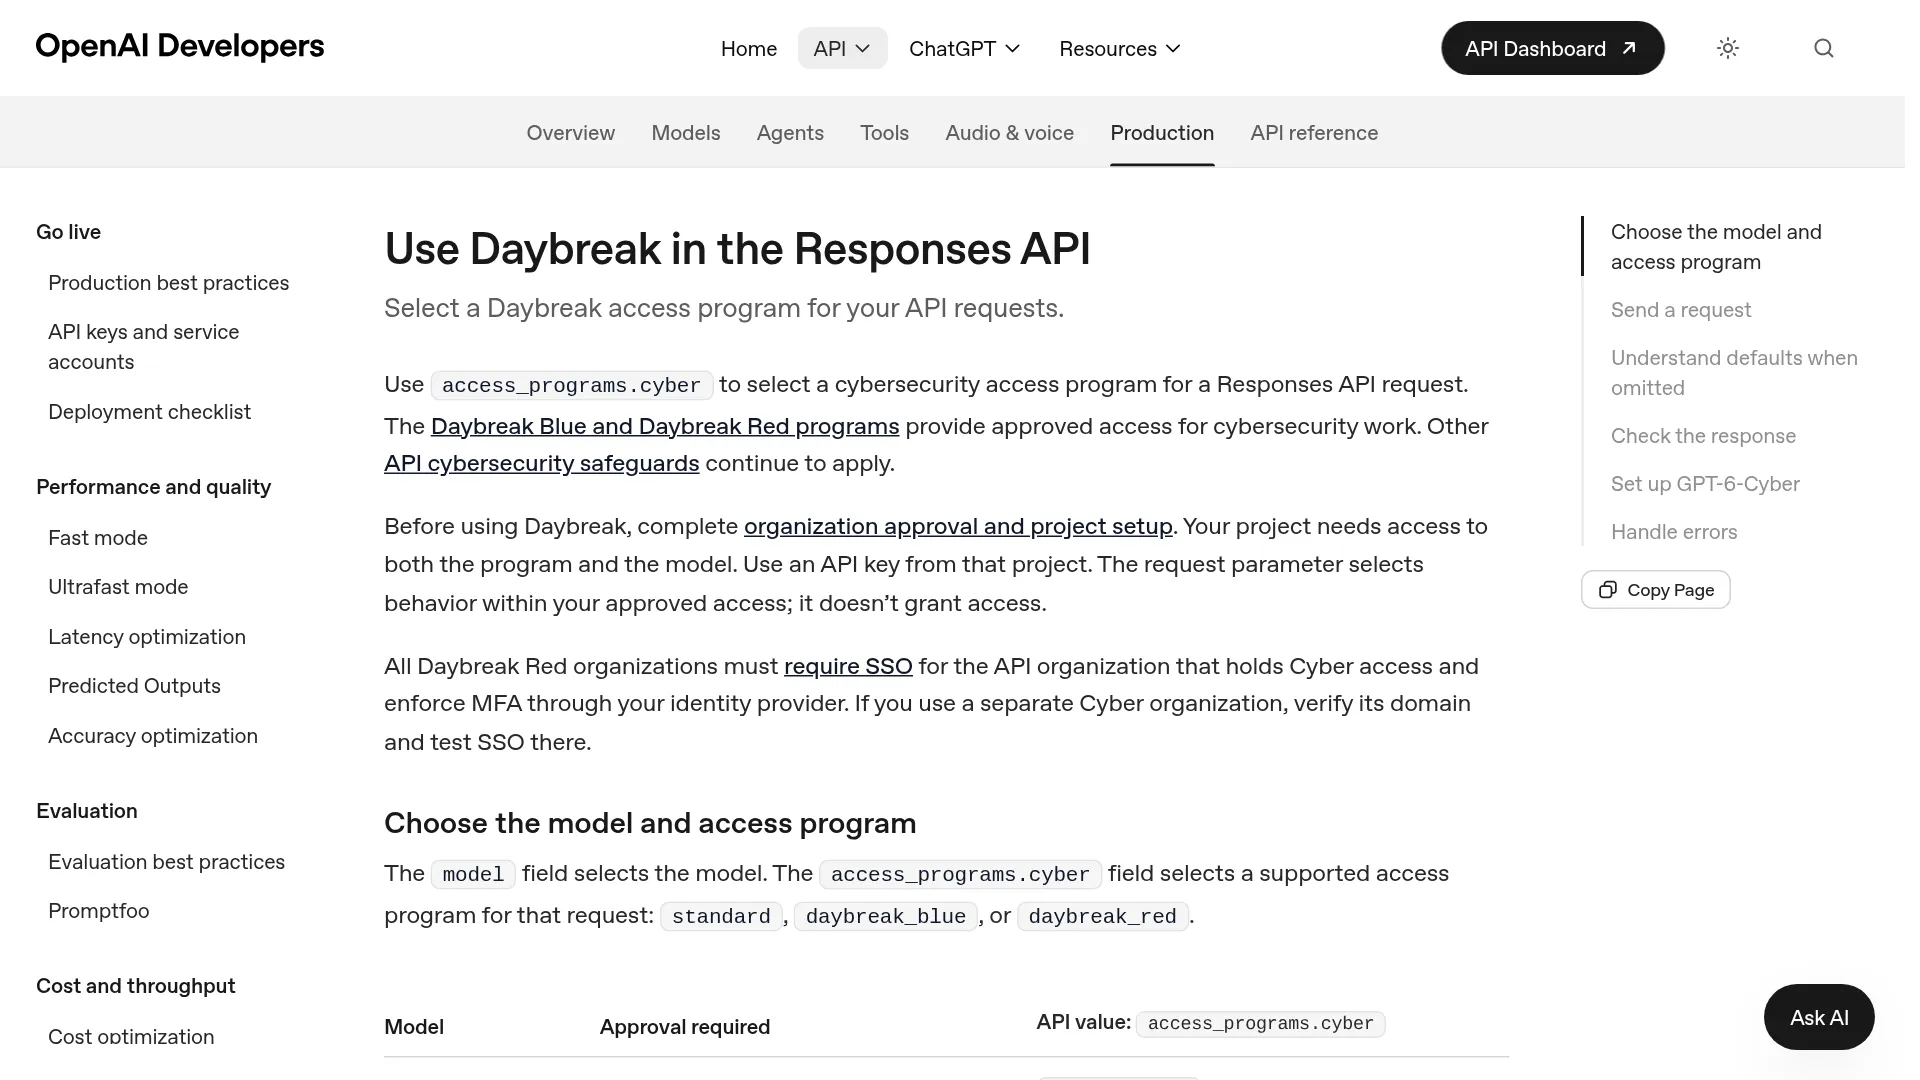
実際には誰が対象になるのでしょうか。OpenAIのDaybreak概要では、条件を満たすエンタープライズ顧客とサイバーセキュリティ実務者を対象としており、Redには別途の承認とより強い本人・組織確認が必要とされています。ArtificialWatchのローンチ記録によると、GPT-6 Cyberの初期アクセスはAPIとCodexを通じた一部の承認済みRed顧客に限定されました。すべてのRed顧客へ拡大する予定は示されたものの、時期は未定です。レビュー時点でChatGPTでの提供予定は発表されておらず、アクセスが制限されていたため、独立ラボもローンチ時にはモデルを検証できていませんでした。BenchLMのモデルプロファイルも同様です。
BlueからRedへの道筋は不透明に見えます。ペンテスターからは、認証を完了してBlueを取得したものの、Redへの明確な申請経路が見当たらないという報告があります。
「最近はDaybreak Blueでも通常のcodexでも、メモリバグの修正を拒否される。さすがにひどい。」 — u/DragonflyOk9274、GPT-6 Cyberのローンチに関するr/codexスレッド
認証済みの別の開発者は、Astraに関する例外に遭遇しています。
「ここ1〜2週間、5.6 solで進めていた作業にAstraを使おうとしたら、数分で諦めてDaybreakを取得しろと言われた。すでにDaybreak認証済みなのに。」 — u/WtWreckor15、Daybreak認証に関するr/OpenAIスレッド
これはドキュメントの記述とも一致します。Blueの承認だけではAstraのセーフガードは緩和されません。Astraとgpt-6.1-solで拒否を減らすにはRedが有効なプロジェクトが必要ですが、リクエストで送る値は依然としてdaybreak_blueです。
参考にすべきベンチマークと、Astraが勝つ項目
以下のGPT-6 Cyberベンチマークはすべて、最高のテスト済み推論予算でプロバイダー自身が実施し、GPT-6 Cyberシステムカードで公開したものです。そのためBenchLMでは、このモデルはランキング対象外となっています。9項目すべてがプロバイダー公表値そのままで、追跡枠における独立検証がありません。なお、ExploitGymとSEC-Benchの首位はGemini 4 Carbonで、それぞれ53.5%と88.2%です。
| 評価 | GPT-6 Cyber | GPT-6 Astra(Daybreak Blue) | GPT-5.6 Cyber | 注記 |
|---|---|---|---|---|
| ExploitGym(既知脆弱性あり、pass@1) | 48.5% | 42.4% | 32.1% | 前世代比+16.4ポイント、Astra比+6.1ポイント |
| ExploitGym Hardened | 36.9% | 29.7% | — | より強力な緩和策を含む |
| SRE-Bench(バイナリリバースエンジニアリング) | 92.8% | 88.0% | — | サイト信頼性業務の評価ではない |
| SEC-Bench Pro(JSエンジン) | 87.0% | 85.4% | — | 差は小さい |
| ExploitBench Internal Port(最近のV8/Chrome) | 42.0% | 39.0% | — | 新しい標的で、データ汚染リスクが低い |
| ExploitBench v8-bench | 100% | 100% | — | 同点 |
| ブラックボックスWebペンテストの再現率 | 40.3% | 32.0% | — | 適合率/F1は未公表 |
| RemoteExploitBench(N-day) | 94.7% | 0.0% | — | BlueのAstraは全タスクを拒否 |
| ハニーポットのスコープ外率(低いほどよい) | 0.07% / 安全プロンプトありで0% | 0.00% | 5.51% | 一般的な安全性ではなく、スコープのテスト |
予算を組む前に、開発者は2つの項目を割り引いて見るべきです。RemoteExploitBenchは能力だけでなく権限も比較しています。CyberはGitLab/Postgres型のN-dayタスクの95%を完了しましたが、Blue上のAstraはすべて拒否しました。したがって、0%はAstraに潜在するエクスプロイト能力を測る数値ではありません。ハニーポットのスコープ順守は、GPT-5.6 Cyberの94.49%と比べると強力ですが、対象は1つの評価であり、すべての顧客ネットワークを代表するものではありません。
より難しい外部セットでは、傾向は逆です。HandyAIとKingyが要約したOpenAIのシステムカードデータによると、Irregular FrontierCyber(実在ソフトウェア・ハードウェアの288タスク)では、Astraが96件、Cyberが90件を解決しました。最難関の15タスクと、完全に堅牢化された標的については、どちらも解けていません。一方、長い多段攻撃を扱うIrregular CyScenarioBenchでは、Cyberが61%対54%でリードし、少なくとも1回解決できた問題は11件中11件でした。Astraは11件中8件です。
単一のスコアより具体的なのが、実キャンペーンの証拠です。AxiosとMagicaが要約したOpenAIのローンチ資料によれば、2026年10月中旬に行われた自律パイプラインは、セキュリティ関連のLinuxカーネルコード約280万行、カーネル全体の約7%を走査しました。2,308件の候補を出し、1,724件を動的に再現し、パッチによる重複排除の結果、948件の異なるローカル権限昇格エクスプロイトに到達しています。使用したAPIクレジットは$1,213,430でした。同じハーネスでGPT-5.6 Solを使った場合は、$513,690で166件のエクスプロイトでした。別件としてOpenAIは、これまで未知だった高深刻度のFirefox脆弱性81件と、既知の問題ながらより深刻であることを示した30件について、再現可能な証拠を報告しています。Mozillaはその多くに修正を提供しました。AxiosおよびMagicaが伝えています。
Magicaによれば、948という数値はマージ済み修正の件数ではなく、キャンペーンの出力として扱うべきです。同じ報告では、分析開始から10日後の時点で、61件はすでにアップストリームで修正済み、43件にはステージングパッチがあり、299件は公開議論中でした。OpenAIは候補パッチ付きで304件の重大な発見を開示しています。初期実行では検証の穴も見つかりました。Magicaによると、200件の成功例のうち20件は、割り当てられた脆弱性とは別の未知の欠陥を利用していました。そのため、制約の強化と、意図した欠陥を独立して確認する工程が必要でした。初期のパッチには、デモ用エクスプロイトは止めても変種を見逃したり、性能コストを生んだりするものもありました。
$20/$100で得られるもの
Kingyの11月5日時点の価格確認によれば、GPT-6 Cyberの料金は、入力100万トークンあたり$20、出力100万トークンあたり$100、キャッシュ済み入力100万トークンあたり$2です。これは入力272,000トークンまでの標準リクエストに適用されます。キャッシュ書き込みは30分で100万トークンあたり$25、12時間で$50です。同じ例ではAstraは半額です。またCyberの入力料金はGPT-5.6 Cyberの$12.50より60%高く、出力料金は同モデルの$75より約33%高くなっています。Kingyによる比較です。
| コスト項目 | GPT-6 Cyber | GPT-6 Astra | 重要になる場面 |
|---|---|---|---|
| 入力 / 出力、100万トークンあたり | $20 / $100 | $10 / $50 | 複数ターンの調査すべて |
| キャッシュ済み入力、100万トークンあたり | $2 | —(Astraページを参照) | 同じコードベースを繰り返し走査する場合 |
| 入力100k + 出力10kの例 | $3.00($2 + $1) | $1.50 | リトライ前の予算基準 |
| 同じ例で入力を完全にキャッシュした場合 | 約$1.20 + キャッシュ作成費 | より低い | 長大なカーネルやモノレポの処理 |
| Linuxキャンペーンの平均 | 個別LPEあたり約$1,280($1.21M / 948) | — | バグ単価ではなくキャンペーン平均 |
この$1,280は見積価格ではなく、配分上の数値です。1つの標的構成とパイプラインを対象にしたもので、情報漏えいに関する作業を含みますが、サンドボックス、エンジニアリング、人手レビュー、メンテナーの作業時間は含みません。候補が増えるほどトリアージの滞留も増えます。実際の調査では、ターン数、ツール呼び出し、リトライ、長いレポートが積み重なります。
認可済みのエクスプロイト検証や大規模監査がボトルネックで、Astraの拒否がワークフローを止めるならCyberを選ぶ価値があります。コードレビュー、トリアージ、パッチ草案、日常的なエンジニアリングならAstraまたはgpt-6-solにとどまるべきです。HandyAIのシステムカード解説では、ExpertSWEはCyberが82.95%、Astraが83.24%です。料金が2倍になるほどの汎用コーディング上の優位性は、実質的にありません。
承認後にも残る制約
Blue認証済みユーザーからは、メモリバグ修正を拒否されたという報告がr/codexにあります。また、遅れてCyber Exploitation警告が出たというスレッドでは、報告者はどのリクエストがトリガーだったのか不明だったと述べています。
スコープの数値も運用上の意味で読む必要があります。デプロイ用プロンプトなしでスコープ内率が99.93%なら、このテストでは10,000回の実行につき7回、スコープ外サービスに触れることになります。プロンプトありでは、OpenAIはこのテストで100%と報告しています。キャンペーンで数千件のエクスプロイトを走らせる開発者にとって、本当の境界はプロンプト単体ではありません。プロンプトに加え、ネットワーク分離、許可リスト化した標的と認証情報、人間によるレビューを組み合わせる必要があります。
パッチ適用は、なお未完成の半分です。自動化された発見能力は修復を上回り始めています。948件のエクスプロイトを見つけることと、948件の修正を取り込むことは別です。メンテナーのレビュー、重複排除、変種への対応、ロールアウトは、依然として人間の速度で進みます。
よくあるサポート問い合わせを避けるため、次の構成を確認してください。
- デフォルト以外のRed有効化済みプロジェクトと、そのキーを使う
- モデルに応じて正しい
cyber値を設定する(daybreak_redはcyberモデル専用) - 負荷テストの前にIP許可リストとSSO/MFAを確認する
- 必要な場合はZDRとPrivate Safety Processingを固定する
- 小規模で分離されたパイロットにて、解決されたモデル、スコープ、権限、トークン、検出件数、誤検知、ブロッカーを記録し、既存のスキャナーと人間によるプロセスと比較する
トレードオフは、規模と修復能力のバランスです。OpenAIが報告したキャンペーンでは、リードの生成がパッチレビューとアップストリームへの反映を上回りました。
GPT-6 Cyber API FAQ
GPT-6 Cyber向けにDaybreak Redアクセスを申請する方法は?
OpenAIのDaybreak概要と担当窓口から始めます。SSO/MFAを用いた認証を完了し、オーナーが専用プロジェクトでRedを有効化します。さらにgpt-6-cyberの個別承認を取得し、IP許可リストとZDR運用を設定したうえで、daybreak_redを指定して呼び出します。
独立研究者や個人でもDaybreak Redを取得できますか?
OpenAIは対象を、条件を満たすエンタープライズ顧客とサイバーセキュリティ実務者と説明しており、Redには別途承認が必要です。Cyberの初期アクセスは一部のRed顧客だけに限られ、Red顧客全体への拡大予定に時期は示されていません。用途を文書化したうえで審査されると考えるべきです。ペンテスターからは、Blueは取得できてもRedへの明確な経路がないとの報告があります。
Daybreak BlueでGPT-6 Astraの拒否は減りますか?
いいえ、通常のBlue承認では減りません。Astraには標準セーフガードが残ります。Astraとgpt-6.1-solで拒否を減らすには、Red承認とプロジェクト有効化が必要です。ただし、リクエストで送る値は引き続きdaybreak_blueです。
GPT-6 CyberはChatGPTでも使えますか? それともAPIとCodexだけですか?
レビュー時点では、承認済みRed顧客向けのAPIとCodexのみです。ChatGPTでの提供予定は発表されていません。一般的なChatGPTユーザーは、対象であればBlueとともにAstraまたはメインラインモデルを使うことになります。
GPT-6 CyberはAstraの2倍の価格を払う価値がありますか?
認可済みのエクスプロイト、脆弱性の大規模検証、スコープに敏感なエージェント実行では、初期のプロバイダー実施データはパイロット導入を支持します。ExploitGymで+6ポイント、堅牢化標的で+7ポイント、Red権限下のN-day完了率は94.7%、スコープ順守率は99.93%です。コードレビュー、トリアージ、一般的なエンジニアリングなら、半額のAstraがよりよい標準選択です。
サイバー警告や拒否に異議を申し立てるには、何を記録すべきですか?
解決されたモデルID、リクエストのプログラム値、プロジェクトID、タイムスタンプ、標的スコープと認証情報、完全なプロンプトとツールトレース、デプロイ安全性プロンプトを使用したかどうかを保存し、サポートに連絡してください。公開ドキュメントでは、遅延した警告がどの特定リクエストに対応するかは説明されていません。ローカルログが監査証跡になります。