長いコンテキストを扱うエージェントで、誤答率の低さを重視するなら、ここではNeonのhighが最も有力な選択肢です。AstraとSolはタスク単価でなお安価です。本稿は、公式仕様、リーダーボード、第三者テストを発売日に突き合わせたまとめであり、Neonを私自身が実行したレビューではありません。
エージェント向けの高速版Carbon。ただしトレードオフもある
Googleと9to5Googleによると、Gemini 4 NeonはHydrogenとCarbonの間に位置するGemini 4の中位モデルとして、2026年11月18日にgemini-4-neonの名称でリリースされました。Googleは、Carbonよりもタスク単価を抑えつつ、エンドツーエンドの完了速度が速いと説明しています。DeepMindスタッフも、Carbonより安く速いモデルだと述べています(@_mohansolo)。xhighでArtificial Analysis Indexは61点・3位、さらに4,200件超のセッションを集計したAgent Arenaでは1336点・2位です。確認したローンチ資料には、同じボード上でのOpus 5.5およびFable 5.2のスコアは掲載されていません。そのため以下の比較では、インデックス順位と同一タスクのテストを併用します。
料金・コンテキスト長・利用できる場所
Googleによれば、Neonの料金は100万トークンあたり入力$3、出力$15、キャッシュ済み入力$0.15です。コンテキスト長は1,048,576トークン、1回の応答は最大65,536トークンです。Thinkingレベルはlow/medium/high(デフォルト)/xhighで、出力トークンとして課金されます。上位レベルでは推論トークンが増え、料金も上がる場合があります。デフォルトがhighである点は、DataCampのレベル別解説とSpringPromptのAPIメモにも記載されています。
eeselのAPI確認では、無料枠なしの有料限定です。提供先はGoogleと9to5Googleによると、AI Studioの有料API、Gemini for business、Antigravity(Pro/Ultra)、Geminiアプリ(Pro/Ultra、Argonを置き換え)、Android Studioです。加えてCursorでも利用でき、CursorによればCursorBenchではデフォルトのeffortで63.7%、Hydrogenは57.3%でした。
| モデル | 100万トークンあたりの入力/出力 | デフォルトのThinking |
|---|---|---|
| Gemini 4 Neon | $3 / $15、キャッシュ済みは$0.15 | high |
| Gemini 4 Hydrogen | $1.50 / $7.50 | high |
| Gemini 4 Carbon | 11月30日まで$2 / $10、その後は$4 / $20 | medium |
| Claude Opus 5.5 | $4 / $20、テストはmax設定 | maxでテスト |
| GPT-6.2 Sol | $2 / $10、テストはmax設定 | maxでテスト |
競合の料金と最適設定の表記は、eeselの比較表をもとにしています。12月1日以降、Neonはトークン単価でCarbonより25%安くなります。詳細はNeonの料金を参照してください。
Thinkingレベルを固定したいならAPI、管理されたクオータを使いたいならアプリまたはAntigravityが向いています。クオータに関する報告はあくまで逸話的な計画材料です。ユーザー報告では、1チャットあたりProクオータのおよそ1〜3%、10分間・3サブエージェントの実行ではおよそ5%とされています。
Opus 5.5・Fable 5.2・Solとベンチマーク比較
スコアはGoogleによるベンダー報告を、eeselおよびDataCampがまとめたものです。
| テスト | Neon | 競合 | 読みどころ |
|---|---|---|---|
| Vals Index | 70.9%、2位 | Fable 約71.3% | 最上位に肉薄 |
| AutomationBench | 56.3%、1位 | Opus 42.5%、Sol 41.3% | エージェントで首位 |
| GraphWalks 256K–1M | 95.2% | Opus 66.8%、Sol 80.1% | 長文コンテキストで優位。Argonで過剰要約されたという報告もあるため(thread)、まず最長のファイルで再現テストを |
| Terminal-Bench 4.1 | 65.2% | Opus 65.8% | ほぼ同等、Opusが+0.6 |
| FrontierCode 2.0 | 46.2% | Opus 47.3% | Opusが+1.1 |
| CursorBench 4.1 | 63.7–65.4% | Opus 58.1% | デフォルトeffortではNeonが優位 |
タスク単価で見ると、トークン単価だけで見た印象は変わります。出典はeesel経由のArtificial Analysisです。
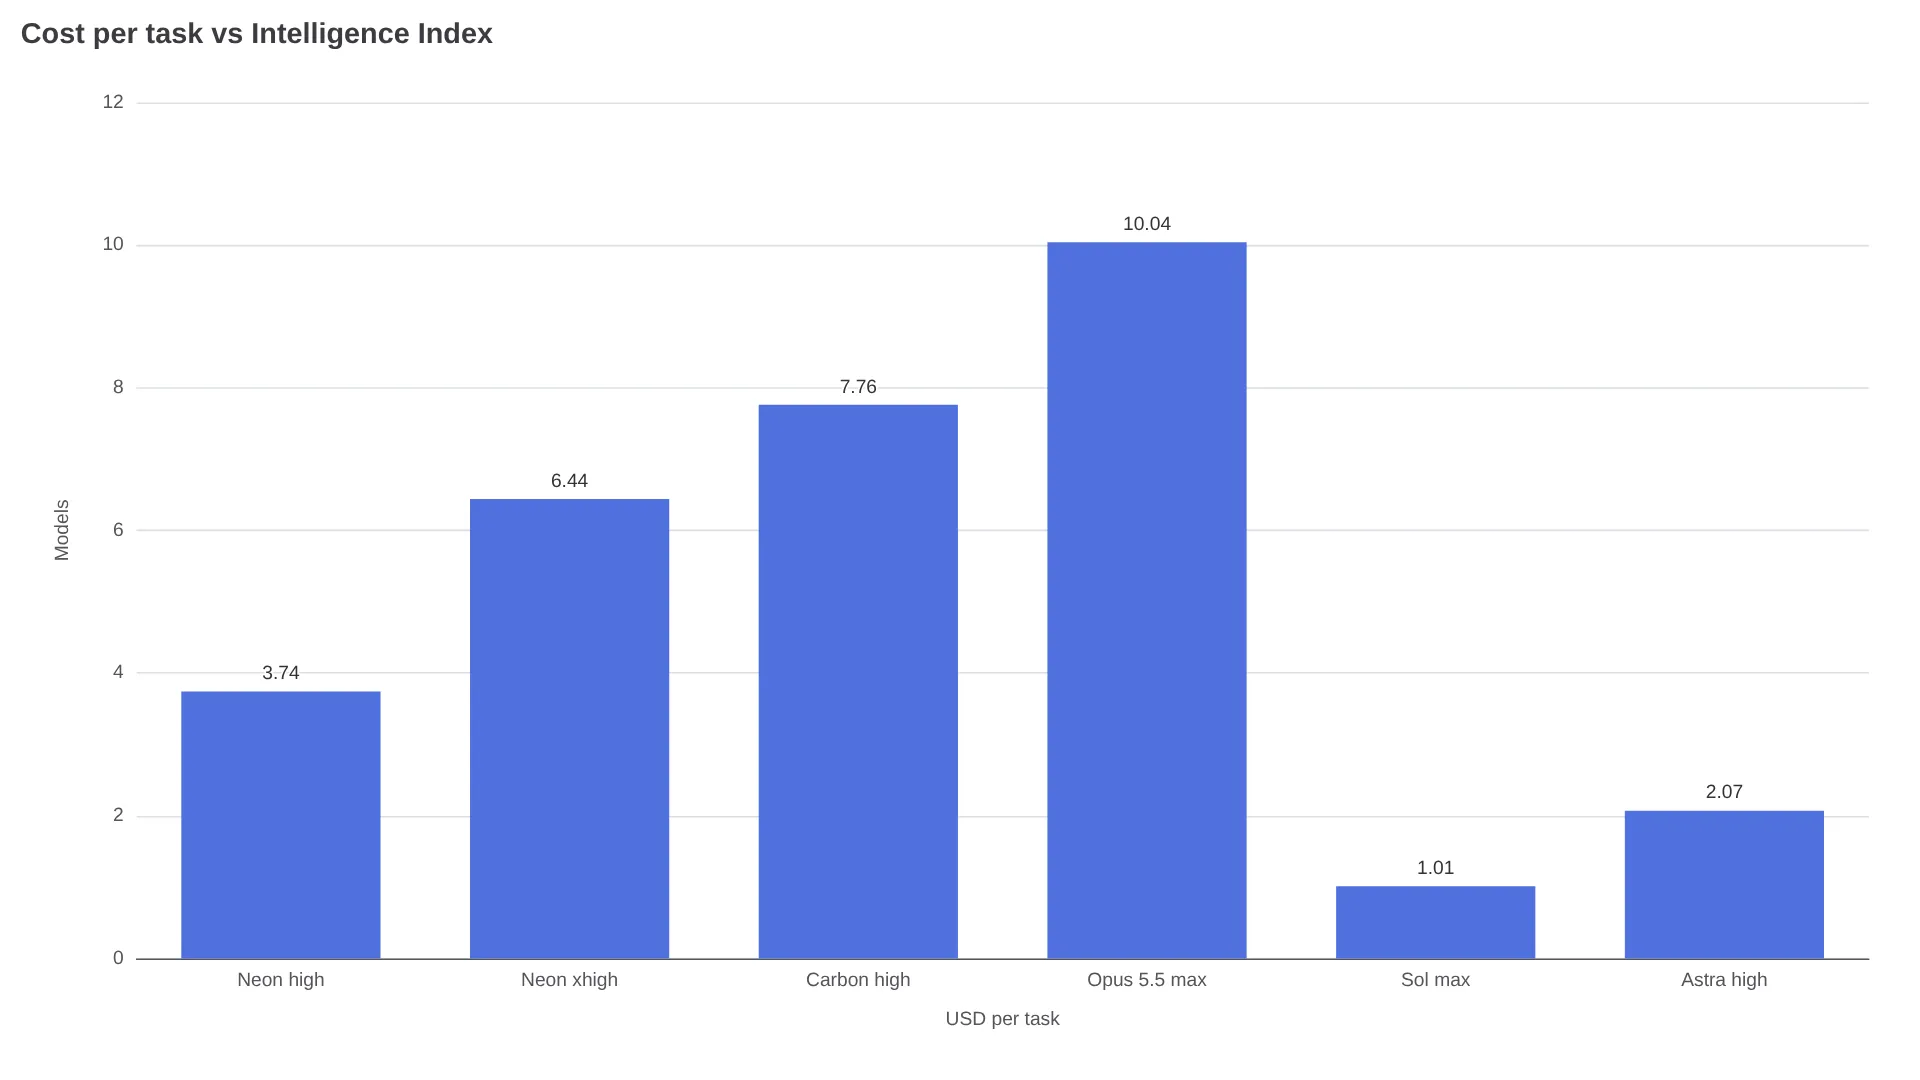
Neon highは59.6で、$3.74・14.8分。Carbon highは60.0で、$7.76・37.2分。Opusのmaxは59.1で$10.04、Astra highは60.1で$2.07、Solのmaxは57.3で$1.01です。Neon xhighは61.4に達し、$6.44・21.5分かかります。1.8ポイントの差に$2.70と6.7分を払う価値がある場合を除き、highでの実行を勧めます。
NeonとFable 5.2:初期報告では役割分担が有力
プロバイダー提供ハーネスのSWE-sweep(Antigravity harness)では、Neon 39.0%、Opus 10.1%、Sol 8.3%でした。共有mini-SWEハーネスでは、Neon 12.8%、Sol 11.6%、Opus 3.6%です。いずれもDataCampの数値で、見出しになるほど大きな差のかなりの部分は、純粋なモデル差ではなくハーネスに由来します。
「私はFable 5.2をオーケストレーター兼開発に、Neonをコーディングエージェントとして使っています。これまで動かした中で最高のスタックです。」 — u/1969Stingray(thread)
逸話ベースでは、オーケストレーションはFable、実装はNeonという組み合わせを支持する声があります。自分のリポジトリで検証してください。AA-Omniscienceでは、Neonの「回答を控えるべき場面で誤答する」割合は14%で、Opusの50%、Solの55%、AstraとFableの58%を下回ります。一方で正答カバレッジは59〜60%にとどまり、Astraは66%、Fableは77%です。出典はeeselです。
実地テスト:チェス、商品リスト、実在バグ105件
| テスト | 結果 | 留意点 |
|---|---|---|
チェスページ、mediumで3回実行(DataCamp) | Neonは3/3で$0.83〜$1.06。Carbonは1/3、2回は65K上限に到達。16局で違法手はゼロ | 1タスクのみ。Carbonもbackground modeなら完走する可能性が高い |
| CatalogBenchのファクト確認(SpringPrompt) | 公開可能な品質は78.6%で3回、35モデル中1位。パッケージから仕様を読み取る | Salesは32.1%、decksは24位、予算内ではsurveysが22位 |
| 再現したバグ105件(@PawelHuryn) | Neon xhighは63、Astraは62.7、Fableは58、Carbonは57.3 | テスターは1人 |
SpringPromptはOpenRouterのmediumを使っており、Google APIのデフォルトはhighです。そのため冗長さには差が出ます。AI Studioでの単発的な情報漏えい報告もあります(thread)。チャット用途では、eeselの計測によるとNeon xhighは最初のトークンまで56.5秒かかります。対話的な応答にはmediumまたはHydrogenを選ぶのが無難です。
ワークロード別の選び方
| ワークロード | 選択 | 理由 |
|---|---|---|
| 難しいエージェント、長文ドキュメント、リファクタリング | Neon high | 59.6で$3.74、Agent Arenaで2位、チェスは3/3 |
| 最も長い期間にわたる開発 | Googleのファミリー内での位置付けに従いCarbon | Googleは最難関プロジェクト向けにCarbonを残している。ただし本稿には同一タスクでの検証はない |
| オーケストレーション+コーディング | Fableをリード、Neonをコーダーに | 上記の逸話的なハイブリッド構成。まず検証を |
| タスク料金を最優先 | Sol maxは$1.01、Astra highは$2.07でスコアはより高い | どちらもAA-Omniscienceでの誤答率は高かった |
| 対話型チャット | HydrogenまたはNeon medium | xhighの初回トークン遅延はチャットには大きすぎる |
| 規制対象の用途 | ドキュメントがそろうまで保留 | 完全な安全性レポートは11月19日時点で未公開。必要な文書に照らしてのみ承認すること |
半日で自分の環境に合うか確かめる
同じプロンプト、同じファイル、同じThinking予算で、Neon high、現在のデフォルト、安価な代替案1つを走らせてください。成功率、コスト、所要時間、誤答を記録します。自分のキューに対しては、その1回の比較がどのリーダーボードより有益です。Opus側の計算は、Opus 5.5 review、Fable 5.2 reviewを参照してください。