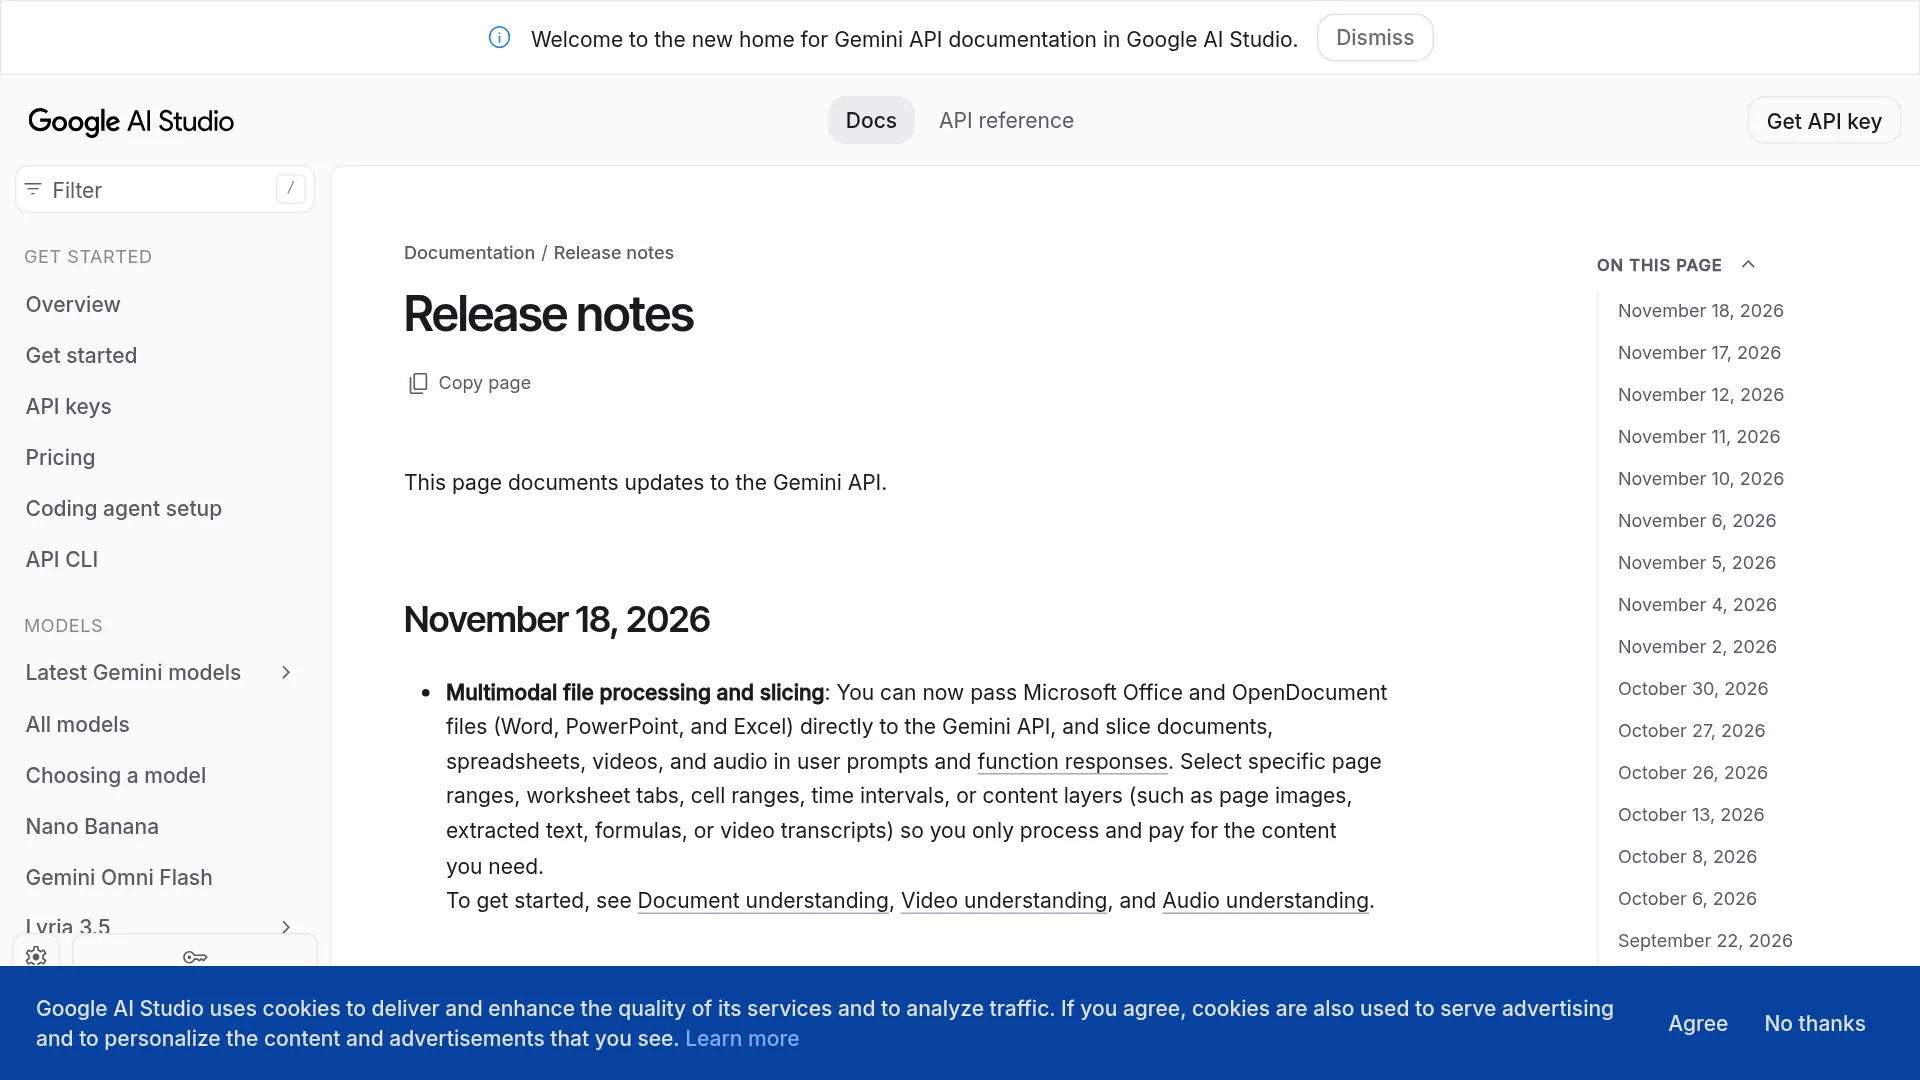
Gemini APIに送るたび、ExcelブックをCSVへ変換していませんか。もう、その前処理は必須ではありません。2026年11月18日以降、Gemini APIはWord、Excel、PowerPointをそのまま受け付け、Googleの説明では指定した範囲だけを「処理し、その分だけ支払う」ことができます(Google AI Studioの変更履歴)。
ただし、コストを抑えるには範囲指定が必要です。明示的なセレクターを付けなければ、ファイル全体が処理される可能性があります。@zg0820もこの点を指摘しています。
これまでのExcel処理が扱いづらかった理由
従来のドキュメントでは、XLSXの先頭ワークシートだけをCSVとして読み込む仕様でした。そのため、シートの並べ替えやブックの分割が必要になるケースがありました。
「ドキュメントには今も、XLSXは先頭シートだけをCSVとして読み込むと書かれている」 — @aitrackerbot
2026年11月18日の変更では、この回避策に代わり、OfficeおよびOpenDocument形式を直接入力できるようになりました。さらに、プロンプトや関数レスポンスで処理範囲も指定できます(DocsWatchの分析)。
2026年11月18日のアップデートで変わったこと
今回の変更は、PPT、ODP、ODSへの対応が広がった11月5日の拡張に、次の2点を加えるものです。
- OfficeとOpenDocumentを直接入力。 Word、PowerPoint、ExcelをPDFやテキストに変換せず、そのまま送信できます。
- コンテンツのスライシング。 ページ範囲、ワークシート、A1形式のセル範囲、時間区間、ページ画像・抽出テキスト・数式・トランスクリプトといったコンテンツレイヤーを指定できます。
スライシングはプロンプトだけでなく、FunctionResponseのパートでも利用できます。ツールからブック全体ではなく、必要なシート範囲だけを返す構成も可能です(AI Indexの概要)。
送信できるファイルと対応モデル
2026年11月18日(UTC)に更新されたFirebaseの入力要件ページでは、Office対応モデルをGemini 4.xモデルとしています(Firebase AI Logicドキュメント)。
| ファミリー | 拡張子 | MIMEタイプ |
|---|---|---|
| Word | .doc、.docx、.dotx | application/msword、application/vnd.openxmlformats-officedocument.wordprocessingml.document、application/vnd.openxmlformats-officedocument.wordprocessingml.template |
| PowerPoint | .ppt、.pptx | application/vnd.ms-powerpoint、application/vnd.openxmlformats-officedocument.presentationml.presentation |
| Excel | .xls、.xlsx | application/vnd.ms-excel、application/vnd.openxmlformats-officedocument.spreadsheetml.sheet |
| OpenDocument | .odt、.odp、.ods | application/vnd.oasis.opendocument.text、application/vnd.oasis.opendocument.presentation、application/vnd.oasis.opendocument.spreadsheet |
| 基本対応 | .pdf、.txt | application/pdf、text/plain |
公式の制限は次のとおりです。スライシングを使っても上限は変わりません。
- 1ファイルあたり50 MB、1ファイルあたり1,000ページ、1リクエストあたり3,000ドキュメントファイル。
- インラインのBase64データは、リクエスト全体で20 MBまで。 これを超えるファイルにはCloud StorageのURLが必要です。
なお、未確認情報は分けて扱います。ある変更履歴の読者は、Officeファイルには約2,000ページまたはスライドという固有の上限があると報告しています(@lawson_ste3476)。Googleはこの上限を文書化していないため、これを前提に設計しないでください。
WordとPowerPoint:ページ範囲とレイヤーを指定
DocumentMetadataは、公開されているv1beta/v1alphaのDiscoveryドキュメントでは確認されていますが、安定版のv1にはありません(ORIENSのスキーマレポート)。
startPage:開始ページ。1始まりで、指定ページを含みます。endPage:終了ページ。1始まりで、指定ページを含みます。contentLayers:PAGE_IMAGE(レンダリング画像。メタデータはあるもののレイヤーが空の場合の既定値として報告)またはPAGE_TEXT(抽出テキスト)。
レイアウト、スライド、スキャンページを確認するならPAGE_IMAGE、契約書のように検索可能なテキストを扱うならPAGE_TEXTを選びます。Firebaseの説明では、基盤となるモデル上でPDFは画像として扱われ、1ページが1画像として数えられます。また、縦横どちらも384px以下の画像は258トークンとして課金されます(Firebase AI Logicドキュメント)。
Excel:シート、セル範囲、3種類のレイヤー
Discoveryスキーマによると、SpreadsheetMetadataはinline_dataまたはfile_dataで渡すファイルパートに付与します。対象は入力のPartまたはFunctionResponsePartです(ORIENSのスキーマレポート)。
sheetIndex:ブック内の順番を1始まりで指定します。Discoveryのv1betaテキストでは省略時に全シート、PythonとJavaScript SDKの説明では先頭シートとされています。毎回明示するのが安全です。visibleCells:A1:G35のようなA1形式の範囲です。省略すると、選択したシートの使用範囲が対象になります。contentLayers:DATA(値、結合、書式)、FORMULAS(数式と計算結果)、VISUAL(レンダリング画像)。報告されている既定値は[DATA, FORMULAS]です。
監査ではDATAとFORMULASを使い、レイアウトや結合セルの状態も必要ならVISUALを追加します。単一セルの検索なら、visibleCellsを必要最小限の範囲に絞りましょう。
必要な範囲だけ送る:Python RESTの例
以下のフィールド名はDiscoveryリビジョン20261116に対応しています。この形式はベータ版で、安定版のv1にはないため、本番導入前にインストール済みSDKの仕様を確認してください。
import os
from google import genai
import requests

client = genai.Client()  # reads GEMINI_API_KEY
workbook = client.files.upload(
    file="q3_revenue.xlsx",
    config={"mime_type": "application/vnd.openxmlformats-officedocument.spreadsheetml.sheet"},
)

api_key = os.environ["GEMINI_API_KEY"]
url = f"https://generativelanguage.googleapis.com/v1beta/models/gemini-4-hydrogen:generateContent?key={api_key}"
payload = {
    "contents": [{
        "parts": [
            {
                "fileData": {
                    "fileUri": workbook.uri,
                    "mimeType": "application/vnd.openxmlformats-officedocument.spreadsheetml.sheet",
                },
                "spreadsheetMetadata": {
                    "sheetIndex": 2,
                    "visibleCells": "A1:G35",
                    "contentLayers": ["DATA", "FORMULAS"],
                },
            },
            {"text": "Summarize revenue variance in this range using computed values."},
        ]
    }]
}
r = requests.post(url, json=payload, timeout=120)
r.raise_for_status()
print(r.json()["candidates"][0]["content"]["parts"][0]["text"])Wordの場合は、.docxのMIMEタイプとともに"documentMetadata": {"startPage": 12, "endPage": 18, "contentLayers": ["PAGE_TEXT"]}を指定します。PowerPointも同じdocumentMetadata形式を使い、MIMEタイプを.pptx用に変更してスライドのページ番号を指定します。
料金計算:スライシングで本当に安くなる条件
変更履歴やFirebaseの料金メモには、スライシング専用のSKUは記載されていません。節約できる金額は、標準料金で不要な入力トークンを削減した分です。変更履歴では、gemini-4-hydrogenの入力料金を100万トークンあたり1.50ドルとしています。
200ページのレポートで、必要なのが12〜18ページだけだと仮定して計算します。なお、テキスト1ページあたり800トークンという数値は、この例のための仮定であり、公式レートではありません。
- 変更前:200ページを画像として処理。1ページ画像あたり最低258トークンなので、入力は51,600トークン。料金は51,600 / 1,000,000 x 1.50ドル = 0.0774ドル。
- 変更後:7ページを抽出テキストとして処理。1ページ800トークンと仮定すると、入力は5,600トークン。料金は5,600 / 1,000,000 x 1.50ドル = 0.0084ドル。
- 節約額:このリクエストでは、出力トークンを除く入力分で約89%。実際には自分のページ密度で置き換えてください。
自分のブックでも範囲の大きさをベンチマークしましょう。細かく分割した多数のリクエストは、適切にまとめた1つの範囲指定より合計コストが高くなることがあります(@zg0820)。
本番運用に定着させる検証・移行チェックリスト
アップロードが成功したからといって、解析まで成功したとは限りません。パイプラインごとに次を確認してください。
- 解析結果を検証する。 行数、シート名、ページ数などをモデルに返させ、元データと照合します。
- セレクターをすべて指定する。
sheetIndex、visibleCellsまたはページ範囲、contentLayersを明示します。 - 質問に合うレイヤーを選ぶ。 グラフやレイアウトには
VISUALまたはPAGE_IMAGE、監査にはDATAとFORMULAS、検索にはPAGE_TEXTを使います。 - 範囲外の挙動をステージングで試す。 無効なページや範囲に対して、エラーになるのか、範囲内に補正されるのか、何も返さないのかはスキーマに定義されていません。
- アップロード上限を守る。 60 MBのファイルは50 MB制限により失敗します。インラインデータが20 MBを超える場合はCloud StorageのURLを使います。
- この順番で移行する。 Excelの分割処理は
sheetIndexとvisibleCellsへ、レポートの画像化処理はPAGE_TEXT付きのページ範囲指定へ(レイアウト用途だけPAGE_IMAGEを使用)、ファイル全体を返すツールは範囲指定した関数レスポンスへ移行します。
今回参照した資料では、非表示行、結合セル、グラフ、埋め込み画像、パスワード保護されたファイル、マクロ有効ファイル、破損ファイルの扱いは説明されていません。上記のスライシング告知やFirebaseの入力要件ページだけで判断せず、自分のテンプレートで確認してください。
FAQ
関数レスポンスの中身もスライスできますか?
できます。ツールからファイルURIとSpreadsheetMetadataまたはDocumentMetadataを返せば、モデルには必要な抜粋だけを見せられます。エージェント型のドキュメント処理と相性のよい構成です。
スライシングに対応しているAPIバージョンは?
Discoveryリビジョン20261116のv1betaとv1alphaでは確認されていますが、安定版のv1にはありません。本番導入前にバージョンを固定し、対象モデルでテストしてください。
Geminiがアップロードしたファイルを見られないと言うのはなぜですか?
まず、上の表と制限に照らしてMIMEタイプとファイルサイズを確認し、セレクターを明示してください。そのうえで、シート名やページ数をモデルに復唱させれば、解析できているかを確認できます。
関連記事:Office処理パイプラインのモデル選びには、Gemini 4 Carbon vs Hydrogen APIガイドも参考になります。