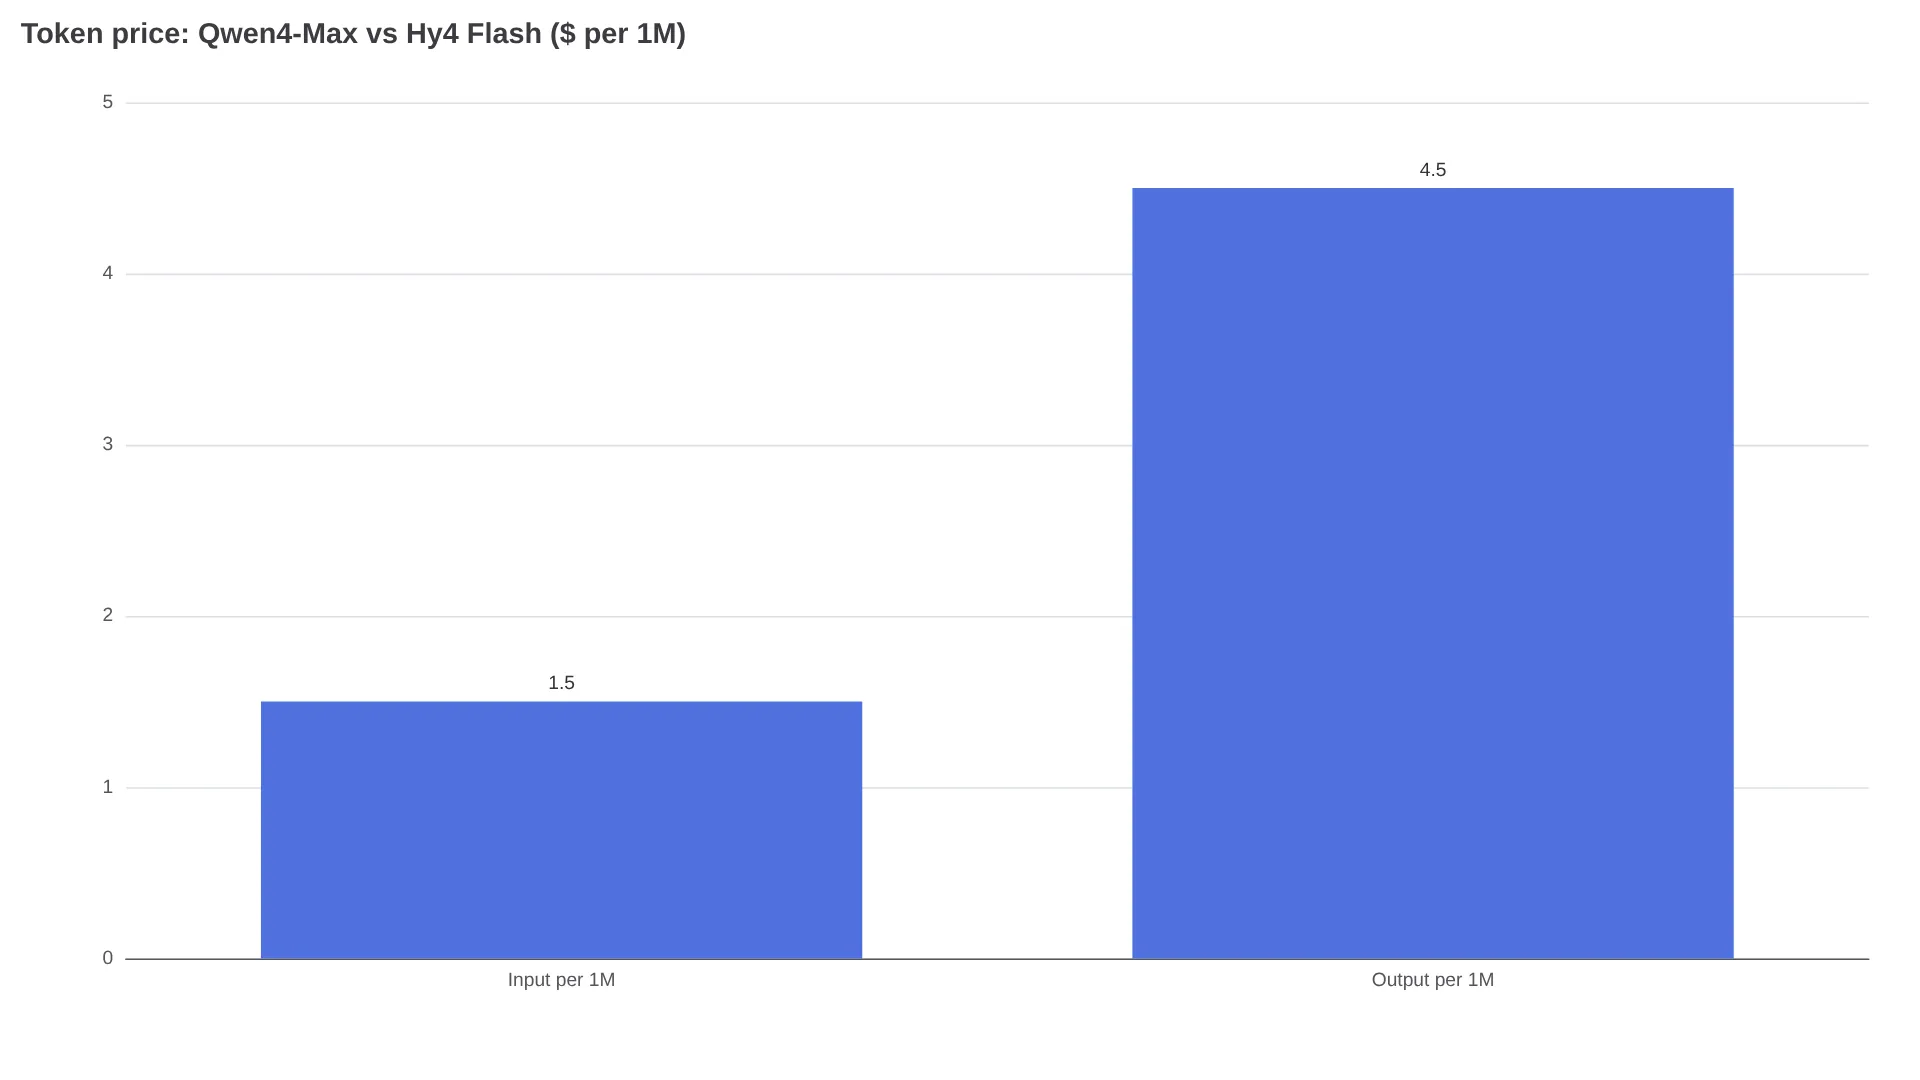
難度の高いコーディングやワークフローのベンチマークではQwen4-MaxがHy4 Flashを上回る一方、1回あたりの実行コストはHy4 Flashが圧倒的に安い。QwenCloudのQwen4-Maxは100万トークンあたり入力$1.50/出力$4.50、TencentのHy4 Flashは入力$0.070/出力$0.281で、差は入力で約21倍、出力で16倍になる。ただし、エージェントの請求額を左右するのは表示価格だけではない。推論トークン数、リトライ回数、キャッシュの再利用まで含めて考える必要がある。本稿では、両モデルの1Mコンテキスト、2.4T対224Bのバックボーン、ベンダーが示すタスク単価を並べ、ワークロードごとの使い分けを整理する。
まずは料金表で比較
| 項目 | Qwen4-Max(Singapore / Intl) | Hy4 Flash(TokenHub Intl) |
|---|---|---|
| 入力 100万トークンあたり | $1.50 | $0.070 |
| 出力 100万トークンあたり(推論を含む) | $4.50 | $0.281 |
| キャッシュ入力の読み取り 100万トークンあたり | $0.075 | $0.003 |
| 明示的なキャッシュ作成 100万トークンあたり | $1.875(5分) / $3.00(1時間) | 個別の開示なし |
| 入力0.5M + 出力0.5M | $3.00 | 約$0.176 |
| モデルID | qwen4-max(QwenCloud経由) | Hy4 Flash(Tencent経由) |
差がはっきりするのが、入力60,000トークン、出力4,000トークンのエージェント型コーディングセッションだ。Qwen4-Maxは入力$0.09、出力$0.018で、1回あたり約$0.108。Hy4 Flashは入力$0.0042、出力$0.0011、合計約$0.0053で、リトライを考慮しない1回あたりでは約20倍安い。入力をすべてキャッシュから読み出せる場合、同じ6万トークンの入力コストは出力前でQwen4-Maxが$0.0045、Hy4 Flashが$0.00018になる。QwenCloudでは推論も出力として課金される。Hy4 Flashの出力単価は100万トークンあたり$0.281なので、出力を短くできれば請求トークンもそのまま減る。
バックボーンの違いが料金にどう効くか
Qwen4-Maxは総パラメータ数2.4T、1トークンあたりのアクティブパラメータ数71BのMoEモデル(Offloop、DataCamp)。一方、Hy4 Flashは総パラメータ数224B、アクティブパラメータ数12BのLatentMoEモデルで、4ビット推論と150トークン/秒超をうたっている(Tencent)。請求額に直結するのは、実際にどれだけ出力したかだ。テストではQwen4-Maxの出力トークン数が127Mに達し、比較対象の中央値78.6Mを上回った(DataCamp)。対してHy4 Flashは、ポストトレーニングによって平均出力長を50%削減している(Tencent)。
実際に適用される料金
QwenCloud Singaporeの料金は、入力$1.50、出力$4.50、キャッシュ読み取り$0.075。最大入力トークン数は、思考なしで991,808、思考ありで983,616、出力は思考なしで131,072、思考を含む合計で262,144となっている(QwenCloud)。その他のデプロイ先(Virginia、Frankfurt、Tokyo、Hong Kong)では、$1.413 / $4.24 / $0.071と記載されている(地域別料金表はOffloop経由)。
Singaporeの新規従量課金アカウントには、条件付きで100万トークンの無料枠が案内されている(Xenospectrum経由)。qwen4-max-previewのToken Planルートは2026年11月25日に終了予定で、本番バックエンドを対象にしたことはない(移行ノート)。
Hy4 Flashの料金は、入力$0.070、出力$0.281、キャッシュ読み取り$0.003。フラッグシップのHy4は入力$0.834、出力$2.501、キャッシュ読み取り$0.042となっている(Tencent)。2026年11月30日まではTokenHubが半額で、実質的な入力単価は約$0.035だった(Tencent)。提供状況はOpenRouterで確認できる。詳細はHy4 Flashの料金解説を参照してほしい。
実際の請求額を決める3つの倍率
1つ目は、推論が出力枠を共有し、出力として課金されることだ。Qwen4-Maxのデフォルトはhighで、思考用の予算は131,072トークン。代替としてxhighとlowがある。Simon WillisonがOpenRouter経由で行ったSVGテストをOffloopがまとめており、同じプロンプトでもhighは6,362トークン、xhighは26,295トークンを使った。課金対象トークンは4.1倍になる。思考モードでmax_completion_tokensを10,000に設定すると、推論と回答を合わせた合計が10,000トークンになる。
2つ目は、冗長な出力とリトライが積み重なることだ。Offloop経由のAlibaba集計値では、ベンチマーク1タスクあたりのQwen4-Maxの出力はおよそ105,000トークン。Qwen3.8-Maxの171,000トークンに対して39%削減されているものの、比較対象の中央値を大きく上回る。サンドボックス環境のRedditベンチマーク(56タスクを各2回、合計112回実行。スレッド)では、Qwen4-Max Previewの成功が64回、DeepSeek V4.1 Flashが61回だった。一方でタイムアウトは16対4、1タスクあたりの所要時間は約13分対7分。タイムアウトをリトライすれば、別の課金リクエストが発生する。
「Qwenの16回のタイムアウトが、64対61という結果にかなり影響している」 — u/the_crooked_badger、r/DeepSeekスレッド
3つ目は、長いコンテキストを扱うエージェントほどキャッシュ再利用の恩恵を受けることだ。Qwen4-Maxのキャッシュ読み取り$0.075は通常の入力料金より95%安い。r/Qwen_AIのスレッドでは、あるコメント投稿者がキャッシュ済み112M、未キャッシュ14Mの入力を報告している。Hy4 Flashのキャッシュ読み取りは$0.003とさらに25分の1だが、推論ループが増えれば、キャッシュ差額の影響は相対的に小さくなる。@MarcosRGjrの言葉を借りれば、「トークン単価を気にするな。エージェントはタスク単位で課金される」(投稿)。
ベンダーのタスク単価と外部検証の結果
以下はベンダーの主張と外部ベンチマークを並べたもので、検証済みの完全な同条件比較ではない。
| 主張 | 数値 | 根拠 |
|---|---|---|
| Alibaba Work360、Qwen4-Max対Qwen3.8-Max(ベンダー内部、DataCamp経由) | 試行タスク1件あたり$1.67対$4.43 | 721項目のスイート、highでトークン約35%減 |
| AA行を含むAlibabaチャート、Qwen4-Max対Qwen3.8-Max(ベンダー集計、Offloop経由) | ベンチマーク1タスクあたり$3.27対$10.02 | xhigh、出力トークン105K対171K |
| Tencent WorkIndex、Hy4 Flash対フル版Hy4(ベンダー内部、Tencentおよび解説経由) | タスク1件あたり¥0.2対¥5.7 | 8セットのオフィス業務スイート |
| Tencentのブラインドテスト、Hy4 Flash対Claude Haiku 5.5(ベンダー実施、Tencent経由) | ¥0.26、2.79/4対¥4.73、2.81/4 | 85ユーザー、259タスク、所要時間6.7対6.8分 |
Work360のスコアはQwen4-Maxが52.69、Qwen3.8-Maxが47.74。Intelligence Indexは34から43に上がったが、Kimi K3.1 Proの46、Opus 5.5の59には届かない(Offloop、LLM Leaderboard)。
ベンダーのチャートで紹介された外部結果は、これらの主張を検討する材料になる。LLM Leaderboardのガイドに掲載されたVals関連のテストでは、Qwen4-Maxはテスト1回あたり$9.33で63.20%、GPT-6.1 Solは$3.61で63.94%だった。Terminal-Bench 4.0では、Tencentのチャート上でQwen4-Maxが48.5%、Hy4 Flashが19.2%(フル版Hy4は44.4%)。ProgramBenchでは31.5対16.0(Offloop)。AutomationBench-AAはQwen4-Maxが72.5%(DataCamp)、Hy4 Flashの自動化は52.2(Tokenstrom)となっている。
成功1件あたりの期待コストは、1回の試行コストを成功確率で割れば求められる。あくまで例として計算すると、Qwen4-Maxは$0.108 / 0.485 ≈ $0.22、Hy4 Flashは$0.0053 / 0.192 ≈ $0.028で、約8倍の差になる。ただし、ベンチマークの成功率は本番環境でのリトライ率ではない。このトークン量で比較する限り、Qwen4-Maxが金額だけで逆転するには、成功確率が約20倍高いか、ツール利用、レイテンシ、修正作業のコストを同等に削減できる必要がある。
ワークロードで振り分け、30タスクの再実行で確認する
| エージェントのタイプ | 推奨デフォルト | 理由 |
|---|---|---|
| 難度が高く、長い工程を伴うコーディングやターミナル作業 | high設定のQwen4-Max | 成功率が高い(48.5対19.2、31.5対16.0)ため、失敗や修正のコストが大きい場合は割高な料金を正当化できる |
| スライド、文書、表計算の修正、コンピュータ操作など大量のオフィス処理 | Hy4 Flash | WorkIndexは¥0.2対¥5.7。Claude Haiku 5.5と同等の評価(2.79対2.81)を約18分の1のコストで実現 |
| キャッシュを使うパイプラインやバッチ抽出 | デフォルトはHy4 Flash。再実行で品質差による節約が確認できるならQwen4-Max | キャッシュ読み取り$0.003対$0.075に加え、自分の文書で発生する修正コストを比較する |
導入を決める前に、手元のタスクから30件を選び、両モデルで再実行したい。成功時の推論および出力トークン数、ツール呼び出し、タイムアウト、修正回数、中央値の所要時間を、料金と一緒に記録して比較しよう。
FAQ
Qwen4 Max APIは100万トークンあたりいくらですか?
QwenCloud Singaporeでは、入力$1.50、出力$4.50、キャッシュ読み取り$0.075。その他の地域は$1.413 / $4.24 / $0.071。Hy4 Flashは入力$0.070、出力$0.281、キャッシュ読み取り$0.003です。
推論トークンや思考トークンは出力として課金されますか?
Qwen4-Maxでは、思考分も共有の262,144トークン枠の中で、$4.50の出力料金として課金されます。Hy4 Flashの出力料金は$0.281なので、出力を短くすれば課金トークンも減ります。
見出しの1Mではなく、実際に使えるコンテキスト上限はどれくらいですか?
QwenCloudの仕様では、入力トークン数は思考なしで991,808、思考ありで983,616。出力は思考なしで131,072、思考を含む合計で262,144です。TencentはHy4 Flashについて1Mコンテキストを掲げています。運用時は安全マージンを残しておきたい。
完了したエージェントタスク単位では、Qwen4-MaxとHy4 Flashのどちらが安いですか?
1回の試行ではHy4 Flashが約20倍安い。Tencentは、タスク単位でフル版Hy4の5分の1、ピーク料金時のDeepSeek-V4.1-Flash-1017の8分の1のコストだとしている(Tencent)。上の例の計算では、成功1件あたりでも約8倍安い。ただし、失敗や修正が少なく、その差がトークン料金を上回る場合はQwen4-Maxが有利になる可能性がある。