Qwen4 Max APIが、Token Plan限定のプレビューから従量課金で利用できる正式版に移行した。料金は入力が100万トークンあたり1.50ドル、出力が4.50ドルで、コンテキストウィンドウは100万トークン。これから組み込むならqwen4-maxを使おう。qwen4-max-previewは2026年11月25日に提供終了となる。
Qwen4-Max APIの要点:2026年11月16日から正式提供
AlibabaはQwen4-Maxを2026年11月16日に一般提供(GA)へ移行した。Alibaba Cloud Model StudioでのモデルIDはqwen4-max。11月11日に始まったToken Plan限定のプレビューに続く正式版だ。@Alibaba_Qwenの発表によれば、ネイティブな画像対応と100万トークンのコンテキストウィンドウを備えた新しいMoEアーキテクチャを採用し、APIはQwenCloudで利用できる。海外から利用する場合のQwenCloudドキュメントはModel Studioの内容に対応しているため、地域に合ったModel Studioのエンドポイントを選べばよい(QwenCloudのドキュメント)。
| 項目 | Qwen4-Max(qwen4-max) |
|---|---|
| ステータス | 2026年11月16日からGA。プレビュー版qwen4-max-previewは2026年11月11日から11月25日まで提供後、終了 |
| 入力/出力 | 100万トークンあたり1.50ドル/4.50ドル(シンガポールの国際リージョン) |
| キャッシュ読み取り | 100万トークンあたり0.075ドル |
| その他のリージョン | 米国(バージニア)、フランクフルト、東京、香港では100万トークンあたり1.413ドル/4.24ドル |
| コンテキスト | 100万トークン。最大入力は991Kトークン |
| 最大出力 | 思考処理なしで131,072トークン、思考処理と回答の合計で262,144トークン |
| 入力形式 | テキスト、画像、動画 |
| API形式 | OpenAI互換およびAnthropic互換。ツール呼び出し、構造化JSON出力、ウェブ検索、キャッシュ、バッチ、ファインチューニングに対応 |
| リージョン | シンガポール、米国(バージニア)、フランクフルト、東京、香港、北京。バッチジョブは北京のみ |
| トライアル | 新規のシンガポールアカウントには、90日間有効な100万無料トークンを付与 |
上記の料金と制限は、2026年11月16日時点でAlibaba Cloud Model Studioのドキュメントに記載されている内容に基づく(料金表、QwenCloudのドキュメント)。たとえば、シンガポールで入力100Kトークン、出力10Kトークンを使った場合は、約0.15ドル+0.045ドル=0.195ドルになる。
Qwen3.8-Maxから実際に変わったポイント
Qwenの発表では、Artificial Analysisの数値を引用し、Qwen4-MaxのIntelligence Indexを43と評価している。Qwen3.8-Max(xhigh)を9ポイント上回り、Kimi K3.1 Proには3ポイント及ばない数値だ。タスクあたりの平均コストは3.27ドルで、Qwen3.8-Maxのおよそ3分の1。出力トークン数も39%少ないとされている。
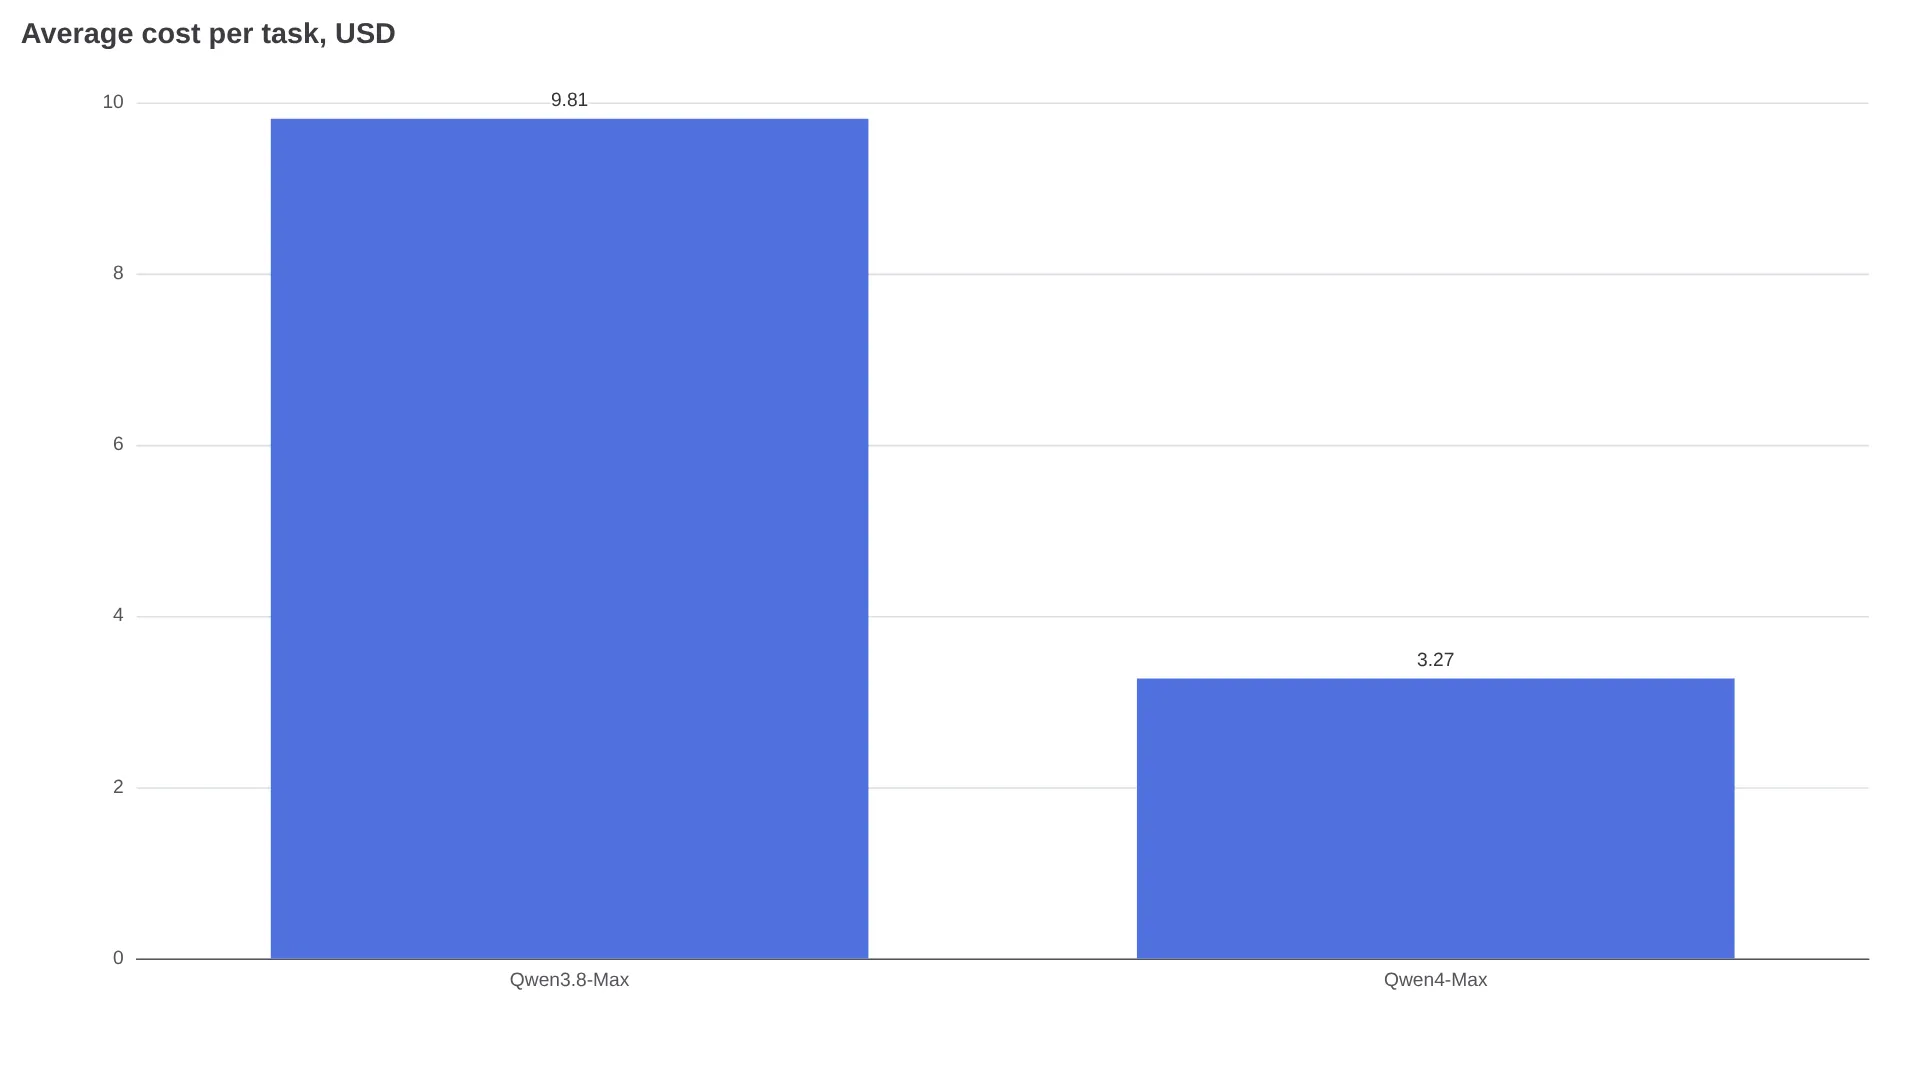
コスト削減の要因は2つある。ひとつは上の表に示したトークン単価、もうひとつはタスクごとの使用トークン数だ。Qwenの内部評価では、後者が最大で約50%減っている。キャッシュを再利用する100万トークン規模の処理では、さらに差が出やすい。暗黙的なキャッシュ読み取りは100万トークンあたり0.075ドルで、Qwen3.8-Maxのキャッシュ料金より70%安いと説明されている。
内部構成は、ネイティブ画像対応のMoEバックボーン。総パラメーター数は2.4T、アクティブパラメーターは71B、N-gram埋め込みは328Bとなっている。QwenのブログはArtificial Analysisのスコアを引用しているものの、AI First LookとAICoderによると、11月16日時点ではベンチマークの詳細表と公開AAリーダーボードへの掲載はまだ確認できなかった。
前モデルについては、こちらも参照してほしい:Qwen3.8-Max APIの料金、Qwen3.8-MaxとKimi K3の比較。
請求額に直結する仕様と制限
「100万トークン」という数字だけを見ていると見落としやすい制限が3つある。
コンテキスト上限と実際の入力上限は別。コンテキストウィンドウは100万トークンだが、QwenCloudの最大入力は991Kトークンと記載されている。余裕を残して設計し、検索やRAGなど中間位置の文脈を使う処理では、途中部分の想起性能もテストしておきたい。
思考処理と回答で出力枠を共有する。思考処理を使わない場合の最大出力は131,072トークン。思考処理を有効にすると、思考トークンと回答を合わせて262,144トークンの枠を分け合うため、推論が重いほど回答に使える余地が減る。XenoSpectrumのプレビュー仕様まとめによれば、プレビュー版では思考処理と回答を合わせて393,216トークンだった。プレビュー時の制限を本番環境にそのままハードコードしないよう注意したい。
思考処理のデフォルトも変わった。思考処理はデフォルトで有効。GA版の初期値はhighで、lowとxhighも選択できる。一方、AI First Lookの仕様表によれば、プレビュー版の初期値はxhighだった。レイテンシーが気になる場合は、まずreasoning_effortをlowに下げるとよい。
マルチモーダル入力はテキスト、画像、動画に対応する。XenoSpectrumのプレビュー仕様まとめによると、プレビュー版の動画送信上限は1回あたり2時間、2GB、64本だった。ただし、これは送信上限であって、内容を確実に理解できる長さを保証するものではない。長時間動画の想起性能は、自分のファイルで確認したほうがいい。
コストを抑えるなら、構造化JSON出力で冗長な回答を制限し、長いコンテキストはキャッシュ読み取りで再利用するのが基本だ。シンガポールではキャッシュ読み取りが100万トークンあたり0.075ドルになる。さらにAICoderのローンチノートには、対応環境で5分間有効な明示的キャッシュの作成料金として、100万トークンあたり1.875ドルも記載されている。
OpenAI SDKからqwen4-maxを呼び出す
Model Studioは、Alibaba Cloudのモデルドキュメントによれば、OpenAIのChat Completions、Responses、Anthropic Messages APIの形式に対応している。従量課金のバックエンドにはqwen4-maxを指定する。qwen4-max-previewはToken Plan専用だ。
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("QWEN_API_KEY"),
    # Singapore/international endpoint:
    base_url="https://dashscope-intl.aliyuncs.com/compatible-mode/v1",
    # China/Beijing endpoint: https://dashscope.aliyuncs.com/compatible-mode/v1
)

resp = client.chat.completions.create(
    model="qwen4-max",
    messages=[
        {"role": "user", "content": "Summarize this release in 3 bullets."}
    ],
    extra_body={"reasoning_effort": "high"},
)
print(resp.choices[0].message.content)
APIキーとエンドポイントは、同じModel Studioリージョンのものを組み合わせること。response_format={"type": "json_object"}、または対応環境ではJSON Schemaを指定し、大きな構造化出力は必ず検証したい。
従量課金、Token Plan、チャットアプリ:どれを選ぶべきか
| 利用方法 | 向いている用途 | 主な制約 |
|---|---|---|
Model Studioの従量課金(qwen4-max) | アプリ、バックエンド、バッチ処理 | トークン単位の課金。リージョンのエンドポイントとAPIキーを確認する必要がある |
Token Plan(qwen4-max-preview) | Claude Code、Cline、Cursor、OpenCodeでの対話型コーディング | 対話利用のみ。本番自動化、バッチスクリプト、バックエンドへの組み込みは不可。シンガポールリージョンのみ。2026年11月25日24:00(UTC+8)に終了 |
| Qwen Chat、QwenWork、QwenStudio、Qoder | プロンプトの試行、ドキュメント作業、APIキーを設定せずにエージェント型IDEを試す用途 | 利用可能状況とクレジットのレートはアプリ内に表示。APIの契約ではない |
Token Planは、対話型開発向けの月間クレジット枠だ。ApidogのToken Plan解説によると、個人向けプランはLiteがイベント価格3ドル/通常価格8ドルで20,000クレジット、Proがイベント価格43ドル/通常価格51ドルで200,000クレジット。キーはsb-sp-で始まる。キーの共有、バックグラウンドジョブの実行、提供中のバックエンドへのキー埋め込みは規約違反になる。プロンプトを試すだけなら、ApidogとXenoSpectrumは、Qwen Chat、QwenWork、QwenStudio、Qoderを評価用の選択肢として挙げている。利用可否はアカウントによって異なり、アプリ内に表示される。
2026年11月25日までに移行しておきたい。
qwen4-max-previewからqwen4-maxへモデル名を変更する。- Token PlanのベースURLとキーから、Model Studioの従量課金用キーとリージョン別エンドポイントへ切り替える。
- 思考処理のデフォルトを再テストする(
xhighからhighへ変更)。 - 出力枠を再計測する(プレビュー版の共有393K上限と、GA版の131K/262K上限の違い)。
初期ユーザーの評価:ゼロからの構築は速いが、エージェント性能にはばらつき
AI First Lookがまとめた少数サンプルのテストでは、1回のプロンプトだけで動作するビルドが報告されている。たとえば、非公開テスト20件中20件に約2.5分で合格したケースがあり、Qwen3.8-Maxの17分より速かった。ただし同じまとめでは、ゲームのテストでQwen4-Maxがより早く完了した一方、総合評価は2位にとどまった例も紹介されている。
コード生成をしようとすると、こうした失敗が何度も起きる。
— @bijanbowen、投稿(2026年11月16日の実ユーザーによる初期印象。コード生成エラーが繰り返し発生する画面のスクリーンショット)
中国語圏の初期テスターによるまとめ(@weconomypistis)では、価格とタスク単位のコストが最大のメリットと評価された。一方で、ターミナル操作やエージェント操作はKimiより一歩遅く、応答も遅かったという。
FAQ
Qwen4-Maxはオープンウェイトですか?
いいえ。AI First Lookのトラッカーによれば、11月16日時点でQwen4-Maxはホスト型でのみ提供され、ウェイトは公開されていない。Qwen4-Maxの発表では、より小型のQwen4モデルについては将来的にオープンウェイト化すると説明されているが、時期、サイズ、ライセンスはまだ明らかになっていない。