 AIREITER
100万トークン級のコンテキストを備え、標準で最大限の推論を行う中国発MoEフラッグシップが、わずか3週間差で登場した。性能帯は近いものの、料金体系はまったく異なる。Kimi K3はコーディングで一歩リードする一方、出力100万トークンあたり$15。対するQwen 3.8 Maxは$6で、出力単価はKimi K3の40%に収まる。チャート読解やコンピュータ操作でもQwenが強く、2026年8月3日にGAとなった新しい選択肢だ。ただし、両モデルとも初期設定で最大推論を使うため、Kimi K3の高い出力料金はリクエストごとに積み上がる。なお、Qwenのオープンウェイト公開は8月11日ごろの見込みだ。
スペックは近いが、選ぶ基準ははっきりしている
Qwen 3.8 MaxとKimi K3はいずれも総パラメータ数が兆単位のMoEモデルで、100万トークン級コンテキストとネイティブの画像対応を備える。2026年半ば、3週間以内の間隔でリリースされたため、スペック表だけを見ると同じクラスに見えやすい。実際に判断すべきなのは、コーディング品質の上積みにどこまで出力コストを払えるか、そして今すぐオープンウェイトや強力なマルチモーダル性能が必要かどうかだ。
| 仕様 | Qwen 3.8 Max | Kimi K3 |
|---|---|---|
| 総パラメータ数 | 2.4T | 2.8T |
| トークンごとのアクティブパラメータ | ~95B | 104B |
| アーキテクチャ | MoE(約4%がアクティブ) | MoE(896エキスパート中16) |
| コンテキストウィンドウ | ~1M(最大入力991K) | 1,048,576 |
| Vision | 対応(テキスト+画像入力) | 対応(ネイティブ) |
| デフォルトの推論設定 | xhigh、thinking有効 | max effort、reasoning有効 |
| オープンウェイト | 未公開(~8月11日見込み) | 公開済み(HF、7月27日、1.56TB MXFP4) |
| APIの状況 | GA、2026年8月3日 | GA |
出典:yottalabsの直接比較、AIReiter経由のAlibaba QwenCloud、Moonshotのplatform.kimi.ai。2026年8月6日確認。
API料金と想定ワークロードでのコスト差
両社ともトークン単価を公開しているが、パラメータ数から想像するような差ではない。差が大きいのは、推論モデルで支出の大半を占めがちな出力トークンだ。Kimi K3の出力料金は100万トークンあたり$15で、Qwen 3.8 Maxの$6を大きく上回る。しかも両モデルはデフォルトで思考過程を出力するため、この料金は最終回答だけでなく推論トレースにも適用される。
| 100万トークンあたりの料金 | Qwen 3.8 Max | Kimi K3 |
|---|---|---|
| 入力(キャッシュミス) | $2.00 | $3.00 |
| 入力(キャッシュヒット) | $0.25 | $0.30 |
| 出力(thinkingを含む) | $6.00 | $15.00 |
| コンテキスト | ~1M | 1,048,576 |
出典:Alibaba QwenCloudのモデルページ(2026年8月2日更新)およびMoonshotのplatform.kimi.ai/docs/pricing/chat-k3。2026年8月6日確認。
入力2,000万トークン、キャッシュヒット率60%、出力500万トークンという一般的なコーディングワークロードで試算すると、Kimi K3は約$103となる(入力$27.60+出力$75)。Qwen 3.8 Maxは約$49(入力$19+出力$30)だ。約2倍の差のほとんどは出力料金に起因する。キャッシュにより入力コストの差は縮まるが、出力料金の差は縮まらない。両モデルが標準で最大推論を使う以上、出力の比重は大きい。
利用方法には非対称性がある。Qwen 3.8 Maxは2026年8月3日にAlibaba APIで一般提供を開始したが、ウェイトはまだ公開されていない。モデルページでもOpen Source: Noとされており、Hugging FaceとModelScopeへの公開は8月11日の週を予定している(Qwen 3.8 Max料金ページ経由のAlibaba情報)。オープンな選択肢はKimi K3だ。Moonshotは7月27日に1.56 TBのMXFP4チェックポイントを公開しており、APIもすでに利用できる。
Kimi K3はAIReiterのKimi K3 API endpointからも、Moonshot公式料金そのまま、マークアップなしで利用できる。単一請求でK3と他モデルを並行テストしたい場合に便利だ。Qwen 3.8 Maxはまだ同サービスに統合されていない。
エージェント型コーディングならKimi K3
複数ステップを要するコーディング、たとえばエージェントループ、リポジトリのリファクタリング、ツール呼び出しや行き詰まりからの復帰が必要なSWE系タスクでは、Kimi K3を選ぶべきだ。公開されているエージェント系ベンチマークでは一貫してQwen 3.8 Maxを上回っており、実際のエンジニアリングに近いタスクほど差が広がる。
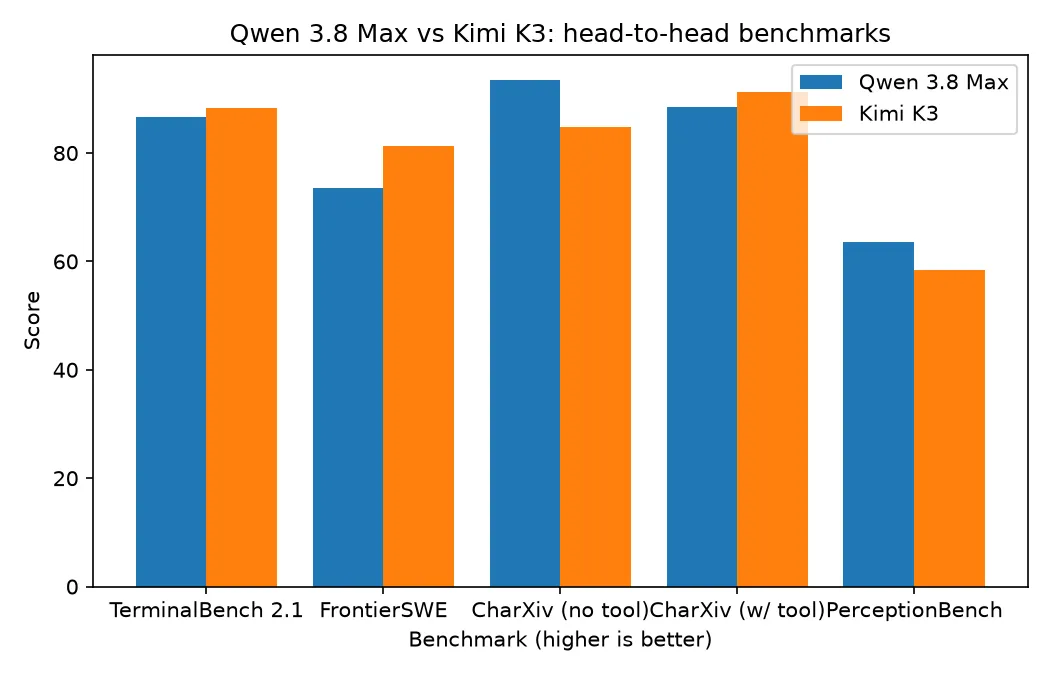
| ベンチマーク | Qwen 3.8 Max | Kimi K3 |
|---|---|---|
| FrontierSWE | 73.5 | 81.2 |
| TerminalBench 2.1 | 86.6 | 88.3 |
| CharXiv(ツールあり) | 88.4 | 91.3 |
出典:yottalabsの直接比較。2026年8月6日確認。
コミュニティの評価も数値とおおむね一致している。ただし、この比較を決定づけるコスト面への指摘もある。
「K3は神レベル。Qwen 3.8もかなり近い。ただ、サブスクリプションやAPIのコストは、どちらのモデルについても正当化しにくい……」 — r/Qwen_AI
「この課題ではK3がQwen 3.8を大差で圧倒した。ランディングページの生成速度はQwenがKimiの3倍だった。」 — Xの@filicroval
Kimi K3は純粋な知能スコアでも上で、Artificial Analysis Intelligence Indexは57だ。ただし速度は遅く、出力速度はおよそ毎秒39トークン、最初のトークンが出るまで3.1秒かかる(Artificial Analysis)。レイテンシーとコストを受け入れる代わりに、品質とオープン性を取るモデルといえる。
マルチモーダル性能とコストではQwen 3.8 Max
チャートやスクリーンショットの読解、ブラウザ操作、コンピュータ操作が中心のワークロードならQwen 3.8 Maxが向く。また、コーディングベンチマークの数ポイント差より出力コストを重視する場合にも有力だ。文書・知覚系ベンチマークでKimi K3を上回り、コンピュータ操作ベンチマークの一つでは検証済みのSOTAを記録している。出力単価はKimi K3の40%だ。
| ベンチマーク | Qwen 3.8 Max | Kimi K3 |
|---|---|---|
| CharXiv(ツールなし) | 93.5 | 84.8 |
| PerceptionBench | 63.5 | 58.5 |
| OSWorld-Verified | 86.1%(SOTA) | 公開スコアなし |
出典:yottalabsの直接比較。2026年8月6日確認。
Qwen 3.8 Maxの弱点は、Kimi K3が最も強く、フロンティアのクローズドモデルに迫る領域にある。SWE-bench Proのスコアは67.7で、Claude Fable 5の80を大きく下回る(Alibaba公開表、ベンダー実施)。最も難しいソフトウェアエンジニアリング評価向けのモデルではない。執筆時点でAPIの一般提供開始からも3日しか経っておらず(GAは2026年8月3日)、ウェイトも依然として非公開だ。今すぐセルフホストする必要があるなら、待つかKimi K3を選ぶことになる。
用途別:どちらを選ぶべきか
どちらが絶対的に優れているかより、何に呼び出すかで選択は変わる。以下に代表的なワークロードと、確認済みの根拠をまとめた。
| ワークロード | 選択 | 理由 |
|---|---|---|
| エージェントループ、リポジトリのリファクタリング、SWEタスク(コスト制約なし) | Kimi K3 | FrontierSWEは81.2対73.5、TerminalBenchは88.3対86.6 |
| 文書・チャート解析、ブラウザまたはコンピュータ操作、コスト重視 | Qwen 3.8 Max | CharXiv 93.5、OSWorld 86.1% SOTA、出力は$6対$15 |
| 今日中にセルフホストしたい | Kimi K3 | ウェイトは7月27日からHFで公開済み。Qwenは8月11日ごろ |
FAQ
コーディングではQwen 3.8 MaxよりKimi K3のほうが優秀?
はい。重要なエージェント型コーディングベンチマークではKimi K3がリードしている。FrontierSWEは81.2対73.5、TerminalBench 2.1は88.3対86.6であり、複数ステップのエンジニアリングタスクではKimi K3のほうが強力だ。
Qwen 3.8 MaxとKimi K3では、どちらが安い?
Qwen 3.8 Maxだ。出力100万トークンあたり$6で、Kimi K3の$15を下回る。入力も$2対$3で、キャッシュヒット時の料金は近い。一般的なコーディングワークロードではおよそ2倍の差になる。
最大推論でエージェント型コーディングをする場合、安いのはどちら?
この場合もQwen 3.8 Maxだ。両モデルは最大推論時の推論トークンを出力として課金するため、Kimi K3が優位なコーディング用途ほど、$15/Mという料金差が広がる。
両モデルとも100万トークンのコンテキストに対応している?
はい。Qwen 3.8 Maxはおよそ991Kの入力トークンを受け付ける(thinking有効時はこれより少ない)。Kimi K3は1,048,576トークンに対応する。どちらも名目上は100万トークン級のコンテキストウィンドウだ。
ウェイトは公開されている?
Kimi K3は公開済みだ。Moonshotは2026年7月27日に1.56 TBのMXFP4チェックポイントをリリースした。Qwen 3.8 Maxはまだ公開されておらず、Alibabaはクローズドとして扱っている。Hugging FaceとModelScopeでの公開は8月11日の週が予定されている。
関連記事
- Kimi K3 model page:Kimi K3を単体で詳しく解説
- Qwen 3.8 Max API pricing:Qwen 3.8 Maxの料金と技術仕様を詳しく解説
- Qwen3.8-27B:セルフホスト向けの小型オープンウェイト版Qwen 3.8
- Kimi K2.7 Code vs GLM 5.2:同じコーディングモデル群における関連比較