 AIREITER
17GBのモデルをダウンロードできることと、快適なローカルエージェントとして使えることは別の話だ。Apache-2.0で公開されたQwen3.8-27Bは有力なオープンウェイトモデルだが、標準の超高推論設定では、量子化・コンテキスト予算・サービング環境がマシンに合っていないと、簡単な処理でも待ち時間が長くなり得る。
Qwen3.8-27Bをローカル運用する価値はあるか
GPUメモリまたはユニファイドメモリをおおむね24GB確保でき、データをローカルで扱いたく、高速なホステッドAPIより多少遅い対話応答を許容できる開発者なら、Qwen3.8-27Bをローカルで動かす価値はある。採用理由は単一のベンチマークスコアではない。画像・動画入力、262,144トークンのネイティブコンテキスト、調整可能な推論機能を備えた、デプロイ可能なサイズのApache-2.0密モデルである点が大きい。Qwen公式モデルカードによれば、リリース日は2026年8月14日だ。
ただし、あらゆるAPIモデルを自動的に置き換える存在と考えるべきではない。公式結果はベンダー報告値であり、強引な量子化は品質と速度の両方を変える。また、標準のxhigh推論は、多くのローカル対話タスクにとって最初から選ぶには重すぎる設定だ。
ベンチマークより先にVRAM予算を決める
Qwen3.8-27Bは密モデルなので、生成するトークンごとにモデル全体が動作する。重みファイルの容量だけでは見えないが、メモリ帯域、KVキャッシュ、量子化、要求するコンテキスト長が決定的に効く。Qwenのモデルカードには262Kのネイティブコンテキストが記載されている一方、実際のローカルセッションでは、使えるメモリと速度を維持するため、はるかに小さい値に設定できる。Qwenのサービング例には最大262,144トークンが示されているが、これは対応上限であって、すべてのコンシューマー向けマシンでの推奨初期値ではない。
| 利用可能メモリ | 現実的な出発点 | 想定される使い勝手 | 推奨 |
|---|---|---|---|
| 12GB | 強めのQ3級量子化とCPU/RAMオフロード | 短いコンテキストに限られ、レイテンシー面で大きな妥協が必要 | ローカル実験が目的でなければ、より小さいモデルを選ぶ |
| 16GB | 強めのQ3、または慎重に選んだQ4系量子化 | 短時間で監督可能なタスクには使えるが、コンテキストと速度は制約される | エージェントワークフローに組み込む前に検証する |
| 24GB | Q4級量子化 | コーディング、ツール利用、控えめなコンテキストにおける実用的な入口 | 大半のローカルQwen3.8-27B利用者に最も合う |
| 32GB以上 | 高品質な量子化、またはコンテキスト用の余裕を確保 | KVキャッシュや長時間セッションでの妥協が減る | 継続的なエージェント作業にはこの帯を選びたい |
これはベンダーが示す最低要件ではなく、運用上の推奨だ。独立したユーザー報告では、12GBのRTX 3060でもローカルビルドを動かしてツール呼び出しを扱えたという声がある一方、そのVRAMで密モデルのエージェントを動かしても性能が厳しいという指摘もある。この食い違いこそ、「ロードできる」と「十分に使える」を同一視すべきでない理由だ。実ユーザーの議論はr/LLMで確認できる。
24GBカードは快適な4ビット運用の下限であって、長大なコンテキストまで快適に扱える保証ではない。デプロイメント観点の分析では、4ビット時の総メモリ使用量を17〜19GBと見積もる一方、長いエージェントセッションではKVキャッシュが急速に増大すると警告している。Neotericのローカルデプロイ分析は、公式ハードウェア仕様ではなく、導入計画の参考情報として読むのがよい。
標準設定のままだと使いにくく感じる理由
Qwen3.8-27Bは、標準でthinkingを有効にしている。公式モデルカードでは、xhigh、medium、lowを含むreasoning_effortが用意され、非推論リクエスト向けにenable_thinking=Falseも指定できる。さらにpreserve_thinkingもデフォルトで有効だ。Qwenのベストプラクティスでは、推論強度を下げてもタスク全体の完了時間が常に短くなるとは限らないと注意している。それでも、単純な作業に高い設定を初期値として使うコストは大きい。
Simon Willisonによるローカルテストは、その差を分かりやすく示している。LM StudioでQ4_K_Mビルドを実行したところ、標準設定で最初のSVGタスクは22,276推論トークンを使い、21分かかったという。推論を無効にすると結果は異なったが、137秒で完了した。彼の計測環境は普遍的なベンチマークではないものの、設定次第で起こり得る問題を具体的に示している。テスト全文とトランスクリプトを参照してほしい。
「重い量子化のため、3.6 35bと同程度か、少し遅い程度だと思っていた。ところが実際には、どの場面でもそれを圧倒していた。」 u/AltruisticList6000, r/LocalLLaMA、16GB RTX 4060 TiでのQ3実験についての報告。
この好意的な結果がトレードオフをなくすわけではない。別の実ユーザー報告では、32Kコンテキストの制限と、途中から不安定になったエージェントセッションが述べられている。また、ローカルでのプログラミング作業には明確で原子的な指示がよいという意見もある。ワークフローに関する議論はこちら。
Qwen3.8-27Bの公式仕様
Qwen3.8-27BはMoEではなく、密なネイティブ視覚言語モデルだ。公式モデルカードには、テキスト・画像・動画入力、64レイヤー、5,120の隠れ次元、262,144ネイティブコンテキストトークン、Apache-2.0ライセンスが記載されている。YaRNベースで最大1Mトークンまで拡張できることも示されているが、static YaRNは短文性能を損なう可能性があると明記されている。公式仕様とコンテキストに関するガイドは、第三者のリリース要約より優先すべき情報源だ。
公式リポジトリではTransformers、vLLM、SGLang、TokenSpeedに加え、llama.cpp、Ollama、LM Studioといった量子化済みローカル実行パスも挙げられている。このモデルはHybrid Gated DeltaNetとGated Attentionの構成を使うため、ランナーの対応状況は重要だ。モデル不具合を疑う前に、ランナーを更新したい。Qwenのクイックスタートリポジトリには、OpenAI互換サービングの例もある。
公開ベンチマークから分かること、分からないこと
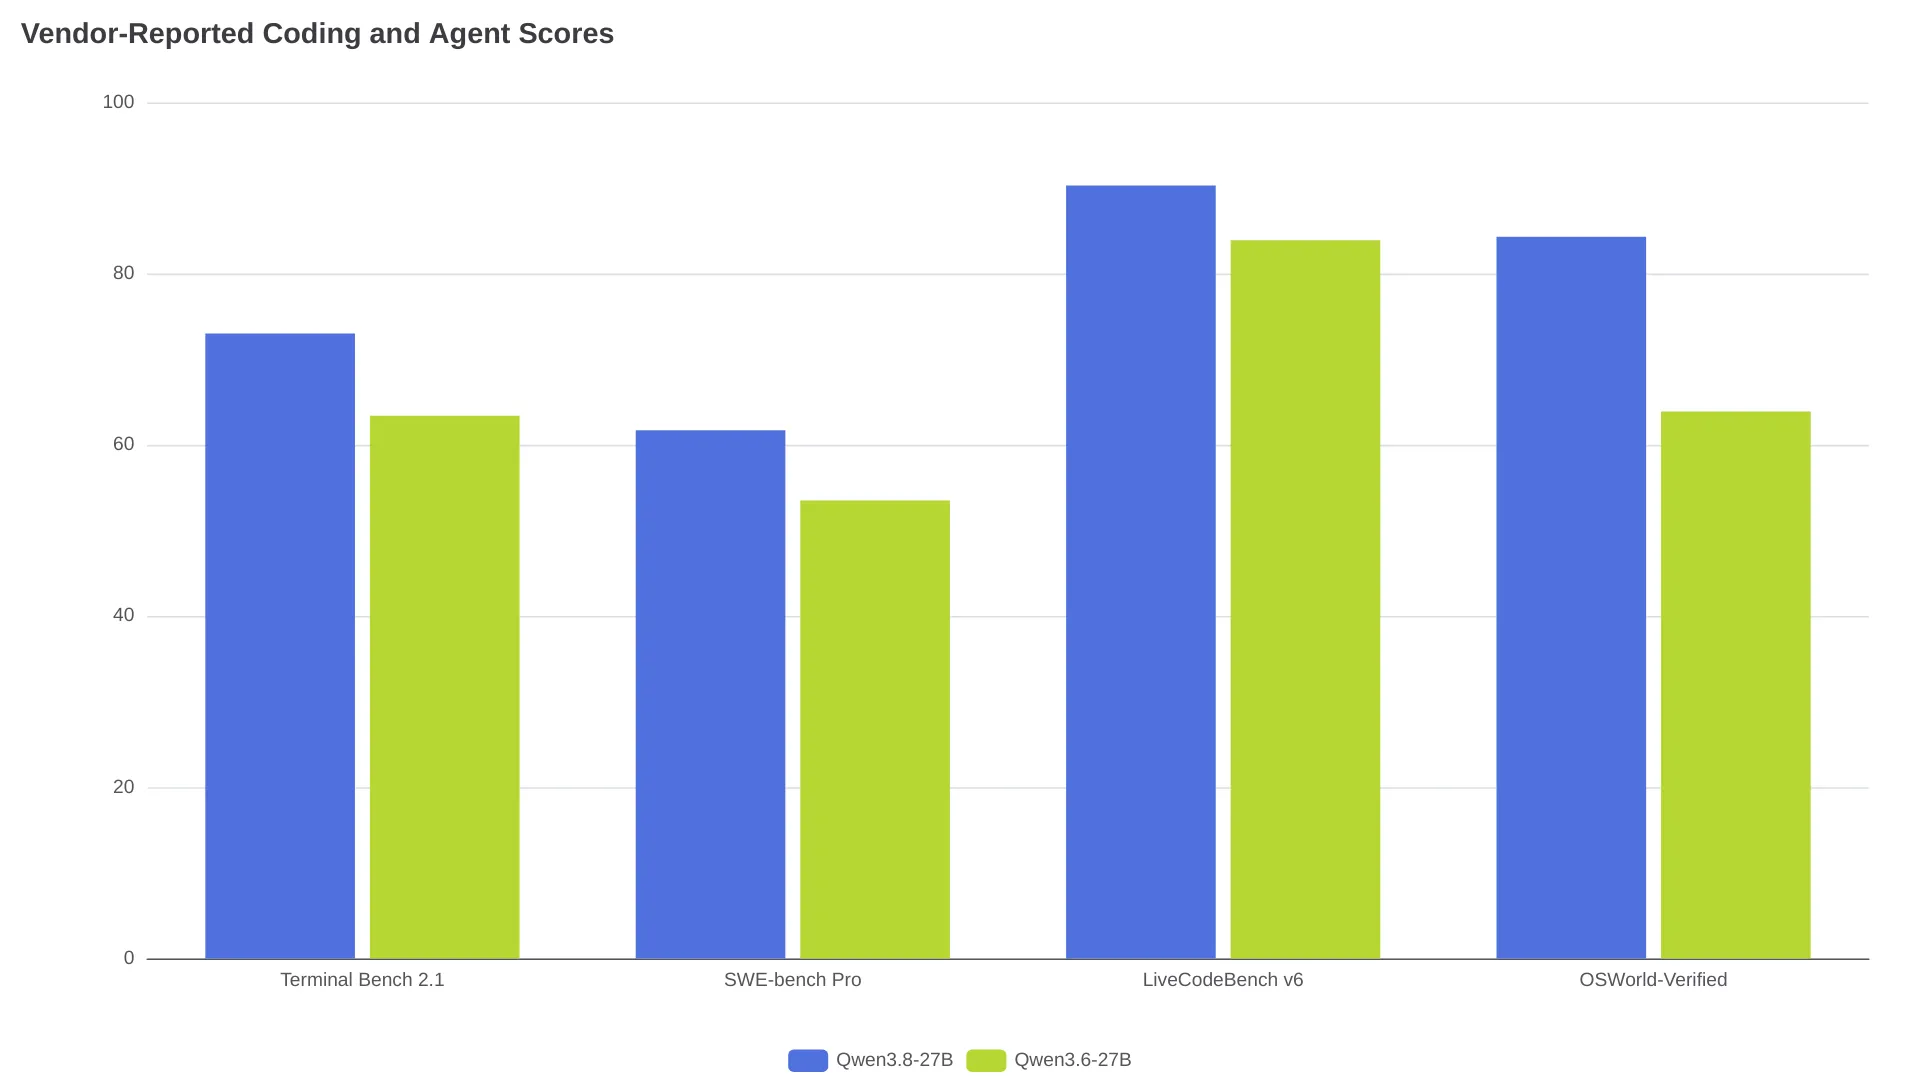
Qwenは、コーディングおよびコンピュータ操作の評価において、Qwen3.6-27Bから有意な改善を報告している。以下のチャートにある4つのスコアは、公式モデルカード掲載のベンダー報告値であり、独立再現された結果ではない。
| 公式ベンチマーク | Qwen3.8-27B | Qwen3.6-27B | 読み取れること |
|---|---|---|---|
| Terminal Bench 2.1 | 73.0 | 63.4 | ターミナルでのエージェント型コーディング指標 |
| SWE-bench Pro | 61.7 | 53.5 | リポジトリのIssue解決能力の指標 |
| LiveCodeBench v6 | 90.3 | 83.9 | コーディング評価の指標 |
| OSWorld-Verified | 84.3 | 63.9 | コンピュータ操作能力の指標 |
モデルカードには比較の全容と評価方法が掲載されている。SWE-bench ProおよびDeepSWE 1.1について、QwenはClaude Codeハーネスを使い、temperature=1.0、top_p=0.95、256Kコンテキストで評価したとしている。QwenSWEBenchなどの社内ベンチマークも含まれる。モデル比較の前に評価方法を確認しておきたい。これらの数値が裏付けるのは「Qwen3.6-27Bから大きく向上した公式アップグレード」であって、「最先端APIを万能に置き換えることが実証された」という結論ではない。
最初のローカル構成はこう始める
初回のローカルデプロイでは、最大限の推論より予測可能な動作を優先したい。新しいランナーを使い、24GB級ハードウェアではQ4級量子化から始め、コンテキスト上限を意図的に控えめに設定する。長時間の自律ループを許可する前に、短いエージェントタスクで挙動を確認しよう。
- vLLMまたはSGLangのような対応エンジンで、OpenAI互換サーバーを立ち上げる。Qwenは
Qwen/Qwen3.8-27B、--reasoning-parser qwen3、--tool-call-parser qwen3_coderを使う例を公開している。公式コマンドはリポジトリに掲載されている。 - 日常的な分類、抽出、軽いコーディング修正では、
enable_thinking=Falseを設定する。Qwenが非推論時に推奨するサンプリング値は、temperature=0.7、top_p=0.80、presence_penalty=1.5だ。公式API例を参照。 - 推論負荷の高いデバッグでは、まず
lowまたはmediumを試し、xhighの前に、実タスクで総完了時間とツール呼び出しの品質を比べる。 - タスクがそれぞれ独立しているなら、preserved thinkingを無効にする。複数ターンの推論コンテキストに価値があり、KVキャッシュへの追加負荷を許容できる場合だけ保持する。
- 無人運用の前に、ツール呼び出し、出力スキーマへの準拠、コンテキストのロールオーバーをテストする。1プロンプトで良いコードを書けるモデルでも、長時間エージェントループでは失敗し得る。
Qwen3.8-27Bを選ばないほうがよいケース
12GB以下が厳格な上限である場合、ローカル制御より応答レイテンシーを重視する場合、あるいは厳密な形式準拠のままエージェントを無人実行しなければならない場合、Qwen3.8-27Bは最初の選択肢として適していない。制約のある環境でも動かせる可能性はあるが、それは信頼できる対話スループットや、リポジトリ作業に十分なコンテキストを提供できることとは別だ。
独立テストでは、出力が長くなりがちで、テールレイテンシーが高く、厳密な指示への追従も完全ではない傾向が報告されている。ある構造化評価では49テスト中4件のタイムアウトと、同ワークステーション構成における143.32秒のP95応答時間が記録された。これらは他環境へ持ち込める性能保証ではないが、ローカル27Bモデルをレビュー不要の自動化コンポーネントとして扱わないための重要な警告になる。CrucibleMarkのテストレポートには構成と制約が記載されている。
Qwen3.8-27B FAQ
Qwen3.8-27Bは正式リリース済み?
はい。Qwenの公式リポジトリでは、Hugging Face HubおよびModelScopeでのQwen3.8-27Bリリース日を2026年8月14日としている。一次情報はQwenのリリースタイムラインだ。
Qwen3.8-27Bは16GB GPUで動く?
強い量子化と短いコンテキストを前提にすれば動作させられるが、制約の多いデプロイになる。実ユーザー報告には16GB RTX 4060 Tiでの有望なQ3結果がある一方、低VRAMでの密モデルエージェント利用には、速度と品質で大きな妥協があるとの警告もある。LocalLLaMAの議論を参照。
Qwen3.8-27Bのコンテキストウィンドウは1Mトークン?
ネイティブコンテキストは262,144トークンだ。モデルカードではYaRN/RoPEスケーリングによって1Mコンテキストへ拡張できるとされる一方、static YaRNは短文性能を低下させる可能性があると注意している。公式コンテキストドキュメントを確認してほしい。
Qwen3.8-27Bのthinkingを無効にするには?
Qwenのモデルカードにある例のように、APIリクエストでenable_thinking=Falseを設定する。推論が必要なタスクでは、最初からxhighが適切だと考えず、lowまたはmediumから始めるとよい。公式の非推論サンプルを参照。
Qwen3.6-27Bの利用者はアップグレードすべき?
現在のハードウェアで同じデプロイメントクラスをすでに動かせており、コーディング、コンピュータ操作、マルチモーダル面の改善がワークロードに効くなら、アップグレードする価値がある。現行スタックが安定していて、新しいランナー、量子化、推論挙動を実際のワークフローでまだ検証していないなら、Qwen3.6-27Bを維持する判断も妥当だ。
変えられない制約から選ぶ
| 制約 | 次に取るべき行動 |
|---|---|
| ローカルでデータを扱いたく、24GBを確保できる | Qwen3.8-27BをQ4で動かし、まずはlowまたはthinkingなしで始める |
| 12GB〜16GBしかない | 監督下の短いタスク向けにQ3系ビルドを試すか、より小さいモデルを選ぶ |
| 長時間のリポジトリエージェントセッション | 32GB以上の余裕を確保し、採用前にKVキャッシュの挙動を検証する |
| 高速な対話応答が必要 | ホステッドAPIまたはより小さいローカルモデルを使う |
| 厳密な形式での無人出力・公開が必要 | 検証レイヤーと人によるレビューを残し、モデルの準拠だけに依存しない |
Qwen3.8-27Bは、ローカルにデプロイ可能な27Bモデルで試せることの幅を広げた。ただし、システム面の作業が不要になったわけではない。ハードウェアに合う量子化を選び、推論を意図して制御し、ダウンロード容量ではなく代表的なワークフローで評価することが重要だ。