100万トークンあたりの料金は、Astraが入力$8・出力$40、Solが入力$2・出力$10。単価だけ見ればAstraは4倍だ。ただし実際の請求額は、それほど単純ではない。下のFrontierCodeのタスク単価では、通常のコーディングはSolが約5分の1のコストでこなしている($1.29対$5.97)。一方、Astraは専門性の高いテストでおよそ4〜10ポイント上回るケースがあり、一発で成功して再試行を減らせるなら、その差に意味が出てくる。
OpenAIの料金体系と利用できる場所
OpenAIは、最難関のプロジェクト向けにAstra、日常的な作業向けにSolを位置付けている(発表記事)。ChatGPT/Codexのプラン利用量とAPI利用料は、別々に管理すべきだ。プランの利用量がAPI呼び出しの料金に充てられることはなく、API呼び出しでプランの上限が減ることもない。両モデルのコンテキストウィンドウは1,050,000トークンで、1リクエストあたり入力は最大922,000トークン、出力は最大128,000トークン。入力はテキストと画像、出力はテキストに対応する。Responses APIおよびChat Completions APIで使うモデルIDは、gpt-6.2-astraとgpt-6.2-solだ。
標準API料金は、100万トークンあたり次のとおり。
| モデル | 入力 | キャッシュ済み入力 | キャッシュ書き込み(30分) | 出力 |
|---|---|---|---|---|
| GPT-6.2 Astra | $8.00 | $0.40 | $10.00 | $40.00 |
| GPT-6.2 Sol | $2.00 | $0.10 | $2.50 | $10.00 |
| GPT-6 Astra(前世代) | $10.00 | $1.00 | $12.50 | $50.00 |
| GPT-6.1 Sol(前世代) | $2.00 | $0.10 | $2.50 | $10.00 |
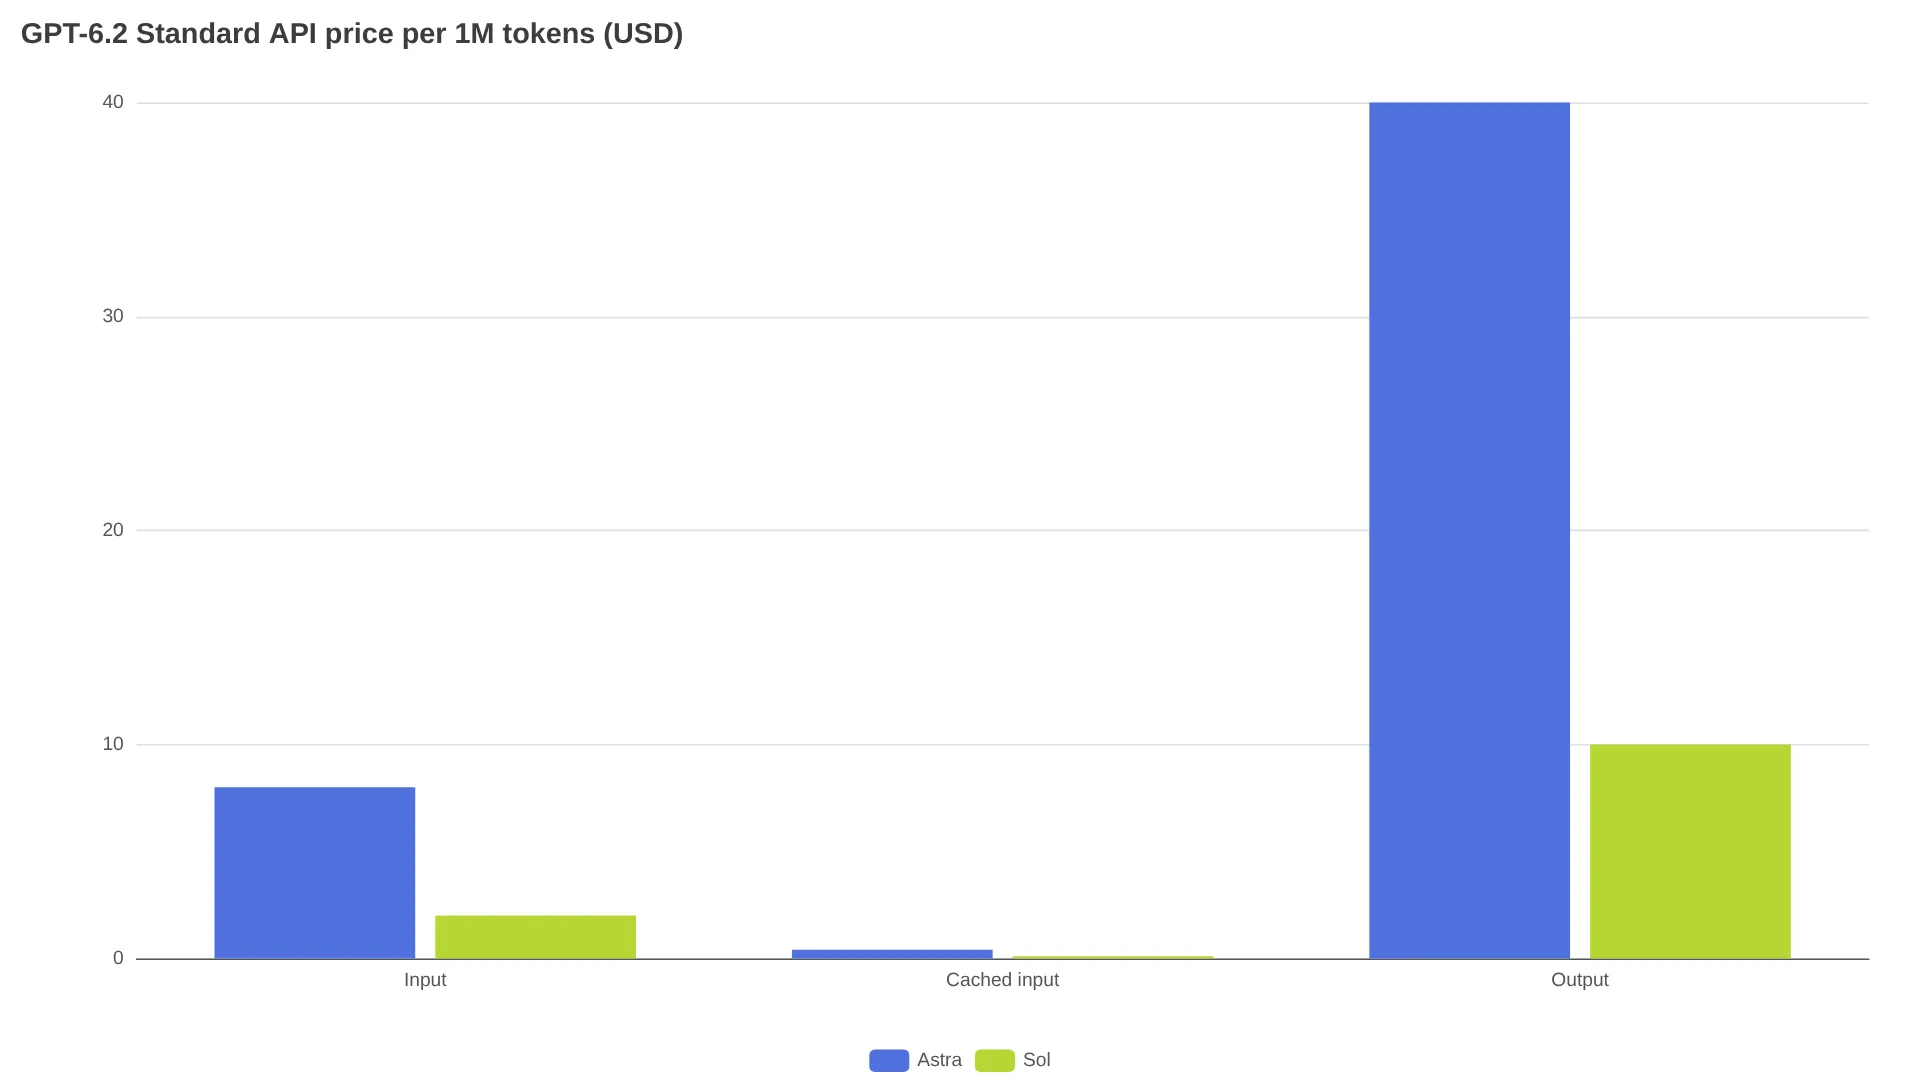
AstraはGPT-6 Astraと比べ、入力・出力が20%安く、キャッシュ済み入力は60%安い。Solの料金はGPT-6.1 Solから据え置きとなっている。2026年11月17日の提供開始時点で、両モデルはAPIで一般提供されている。BatchはStandardから50%割引、バックグラウンド処理のウィンドウは30〜40%割引だ(GenAI Briefの料金階層解説)。
料金を大きく左右する3つの要素
1. キャッシュへの書き込みは無料ではない。 キャッシュ読み取りの料金は入力料金の5%で、Astraは$0.40、Solは$0.10となる。GenAI Briefの料金表によると、30分TTLでのキャッシュ書き込みは入力料金の1.25倍、つまりAstraは$10.00、Solは$2.50。12時間保持では2.5倍になる。たとえばキャッシュミス後に108,000トークンの履歴を書き直すと、出力分を除いてもAstraは108,000 × $10/M = $1.08、Solは108,000 × $2.50/M = $0.27が請求される。
2. 入力272,000トークンを超えると、リクエスト全体が値上がりする。 入力が272Kトークンを超えると、入力料金は2倍になる(Astraは$8から$16、Solは$2から$4)。出力料金も1.5倍に上がる(Astraは$40から$60、Solは$10から$15)。GenAI Briefの料金テストでは、20Kトークンの履歴を追加してこの境界をまたいだ結果、Astraの1ターンは$0.344から$0.624へ上昇した。入力は7%増えただけで、料金は81%増えている。272Kに達する前に履歴を要約または切り詰めたい。ただし、これでキャッシュされたプレフィックスが変わるなら、キャッシュミスのコストも見込む必要がある。
3. 処理速度のティアは全料金に乗算される。 FastはStandardの2倍。Ultrafastは2027年2月28日まで3倍、2027年3月1日からは6倍となる。Ultrafastは米国リージョンのみで、Standard/Fast/Batchは米国とEUに対応する(GenAI BriefのティアルールおよびOpenAIの処理ティア文書)。3倍時のAstra出力料金は$120/M、6倍時は$240/Mだ。
トークン単価ではなく、タスク完了単価で比べる
同じトークン数なら、Astraの料金はSolの4倍になる。Astraが有利になるのは、消費トークンを減らせる、試行回数を減らせる、あるいは高額な人手修正を避けられる場合に限られる。直接のAPI支出で損益分岐を超えるには、同じトークン規模でAstraの1回がSolの4回超を置き換えるか、重み付きトークン数を約75%削減する必要がある。
報告されているタスク単価をまとめた。ベンチマーク、推論設定、コスト算出法はそれぞれ異なるため、傾向を見るための参考値とし、自社のリプレイでも確認したい。
| 出典/ワークロード | Astra | Sol | 読み取れること |
|---|---|---|---|
| Artificial Analysis Intelligence Index、max effort | 62、$4.00/タスク、10.4分(GPT-6 Astra:57、$6.24) | 57、$1.01/タスク、7.9分 | SolはGPT-6 Astraと同じ57点を、$6.24のタスクコストのおよそ6分の1で達成 |
| DataCamp経由のFrontierCode 2.0、max effort | 44.2%、$5.97/タスク | 43.8%、$1.29/タスク | 差は0.4ポイントで、タスクコストは約5倍。このコーディング評価ではAstraは割に合う水準に届かない |
| DataCamp経由のHarvey LAB-AA/SecureSWE/Terminal-Bench-Science | 15.0%/65.7%/77.1% | 11.1%/55.6%/68.0% | ここではAstraとの差が大きい。法務、セキュアコード、科学用途ではAstraを試す価値がある |
| DataCamp経由のBenchCAD 2.1 Core | 82.5% | 73.1% | 約9ポイントのCAD差は、CAD作業でAstraを検証する根拠になる |
| DataCampのスライド再構築、単発テスト | $0.22、出力4,968トークン | $0.07、フォントサイズは正確 | このテンプレート型タスクでは見た目の品質差はなく、コストではSolが勝った |
| DataCampによるOpenAI数値の要約、Agents' Last Exam、Sol High対旧Astra Max | — | Sol Highは72.0%、$0.69/タスク。GPT-6 Astra Maxは73.1%、$8.99 | この設定では約1ポイント低い代わりに、コストは約13分の1 |
計算例で確認しよう。Solが1回$0.10、3回中2回成功するなら、合格結果1件あたりのコストは$0.15になる。この条件では、Astraが1回$0.40であれば、成功率だけでは逆転できない。逆にSolが5回に1回しか成功しないなら、合格結果1件あたり$0.50。一方でAstraが初回で成功すれば$0.40となり、Astraが有利になる。OpenAIは、GDPval v2でAstraの出力トークン数が22%少なかったと報告しているが、ベンダーの主張は方向性を示すものとして扱うべきだ。
通常のコーディングと大量処理するエージェントは、まずSolから始める。法務、CAD、長時間の科学系実行ではAstraを試す。そして再試行と修正も含めたtotal spend / accepted tasksが低くなる場合にのみ、Astraへルーティングすればよい。
プレフィックスを安定させないと、履歴の作り直しに課金される
会話の途中で指示、ツール、スキーマ、過去の出力を変更すると、キャッシュが無効になり、GPT-6.2が再度推論を始める可能性がある。
プレフィックスキャッシュを維持するには(GenAI Briefの統合メモ、OpenAIモデル文書)、次を守りたい。
- 最初のメッセージを書き換える代わりに、新しいdeveloperメッセージまたは
configuration_updateを追加する。 - スレッド途中でツール一覧を差し替えるのではなく、
additional_toolsでツールを追加するか、tool_choice/allowed_toolsで利用を制御する。 - 最初の送信前に、古いツール出力を短くし、画像サイズを縮小する。
- 本番トラフィックを切り替える前に、Prompt Cache DiagnosticsとResponsesの
input_transformations(prefix_mismatch)で原因を確認する。
AstraとSolへ移行する際のチェックリスト
EpiFiveの移行ガイドとGenAI Briefの統合ルールを、OpenAIのモデル比較と照合すると、確認項目は次のとおりだ。
modelをgpt-6.2-astraまたはgpt-6.2-solへ変更する。- まずは
reasoning.effort: medium(Responses)またはreasoning_effort: medium(Chat Completions)で始める。noneは拒否される。短いレイテンシーが必要な呼び出しにはlowを使う。 - リクエストから
temperature、top_p、logprobs/top_logprobsを削除する。ツール呼び出しはResponses APIへ移す。 - GPT-5.5以前から移行する場合は、
prompt_cache_retentionをprompt_cache_options.ttl: "30m"へ置き換え、キャッシュ書き込みの支出を予算化する。 - Zero Data Retentionでは、
storeはfalseとして扱われる。暗号化された推論アイテムを含め、過去の出力アイテムを順序どおりに再送する。 - 各モデルで短いタスクを30件リプレイし、合格率、再試行回数、出力トークン、合格結果あたりのコストを確認する。加えて、プレフィックスを固定した長時間エージェントセッションと、プレフィックスを1回編集したセッションを各1件実行し、キャッシュヒット率と総タスクコストを比べる。