 AIREITER
入力は100万トークンあたり$8、出力は$40。Anthropicの新しいフラッグシップは一見わかりやすい料金設定ですが、実際のタスク単価は推論量によって$2.48から$44.70まで大きく変わります。Claude Fable 5.2では、どの推論レベルに振り分けるかが、そのまま請求額を決めます。
Claude Fable 5.2 API料金:モデルID、キャッシュ、Batch、Fastモード
公式料金は、100万トークンあたり入力$8.00、出力$40.00、キャッシュ読み込み$0.20、5分間のキャッシュ書き込み$10.00、1時間のキャッシュ書き込み$16.00です。モデルIDはclaude-fable-5-2(Claude Platform Docs)、Bedrockではbedrock/claude_platform/claude-fable-5-2(LiteLLM)。コンテキスト長は1Mトークン、最大出力は128K、キャッシュ可能なプロンプトの最小長は512トークンです。Batchでは通常料金が半額になり、入力$4.00/出力$20.00。最大2.5倍の速度をうたうFastモードでは、入力$16.00/出力$80.00と2倍になります。基本的な計算は「入力×$8+出力×$40」で、キャッシュヒット分は$0.20で計算し、Batch利用時はそこから半額です。
| 項目 | Fable 5.2 | Fable 5.1 | Opus 5.5 |
|---|---|---|---|
| 入力/1M | $8.00 | $10.00 | $4.00 |
| 出力/1M | $40.00 | $50.00 | $20.00 |
| キャッシュ読み込み/1M | $0.20 | $0.25 | $0.20 |
| キャッシュ書き込み 5分/1M | $10.00 | $12.50 | $5.00 |
| キャッシュ書き込み 1時間/1M | $16.00 | $20.00 | $8.00 |
| Batch 入力/出力 | $4.00 / $20.00 | $5.00 / $25.00 | $2.00 / $10.00 |
| Fast 入力/出力 | $16.00 / $80.00 | n/a | $8.00 / $40.00 |
| コンテキスト/最大出力 | 1M / 128K | 1M / 128K | 1M / 128K |
同じ条件で比べると、入力10M+出力1Mの費用はFable 5.1が$150、Fable 5.2の標準モードが$120(Fastでは$240)、Opus 5.5が$60です。キャッシュはプレフィックスをおよそ2回再利用すれば元が取れます。書き込みは入力料金の1.25倍ですが、読み込みは入力料金の2.5%に抑えられるためです。ある中規模ワークロードの試算では、入力20M、出力5M、キャッシュ率80%の条件で、費用が$360から$235に下がり、$125の節約になっています。
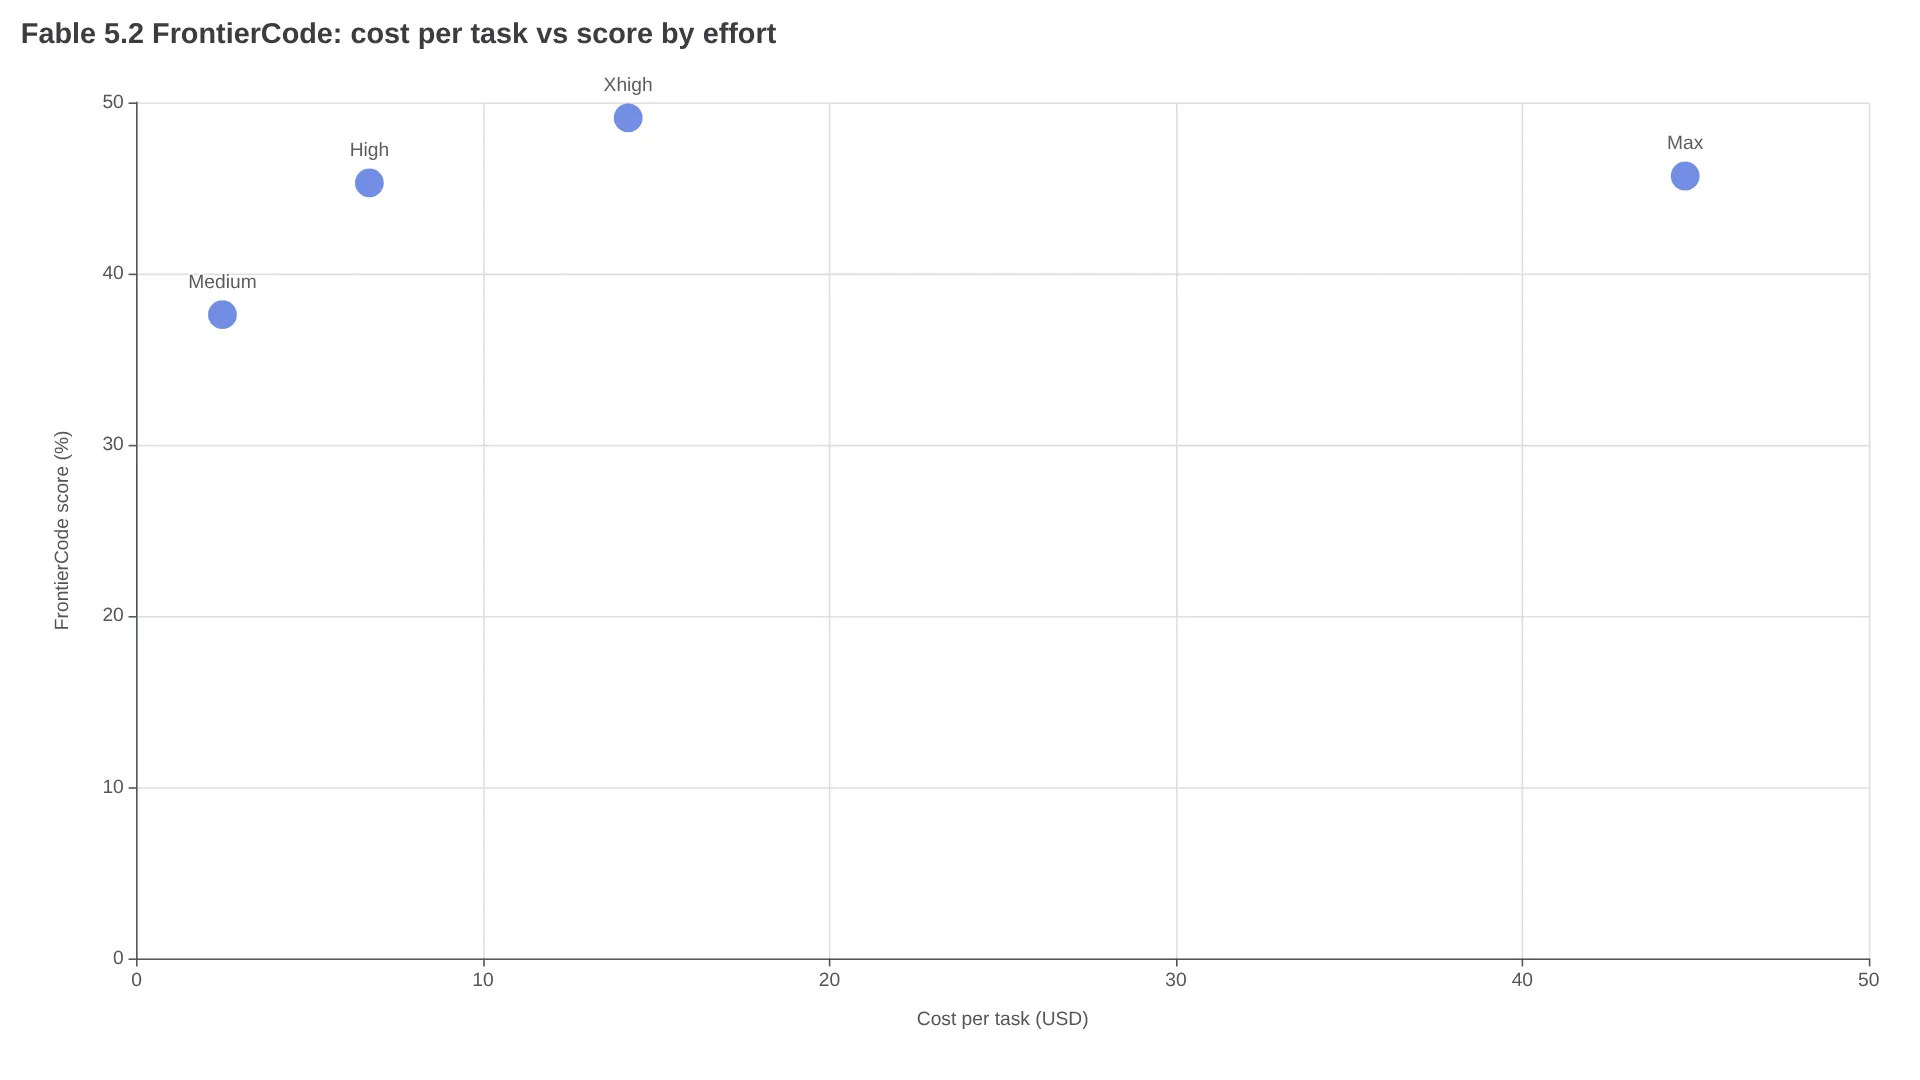
推論量でここまで変わる:同じモデルでもタスク単価は$2.48~$44.70
CognitionのFrontierCode 2.0に関する独立報道によると、132件のマージ可能なパッチタスクで、Fable 5.2の1タスクあたりの費用と正答率は、Mediumが$2.48・37.6%、Highが$6.72・45.3%、Xhighが$14.19・49.1%、Maxが$44.70・45.7%でした。同報道では、ClaudeアプリとCodeのデフォルトはMediumです。MaxはXhighの3.15倍の費用がかかる一方、スコアは下回っています。このテストセットに限れば、常時Maxへ振り分けるのは予算の無駄になりかねません。
| 指標 | Fable 5.2 | 競合 | 読み取れること |
|---|---|---|---|
| FrontierCode、同額の費用 | High 45.3%/$6.72 | GPT-6 Astra Max 42.8%/$6.68 | 同程度の費用でFableが2.5ポイント上 |
| FrontierCode最高値 | Xhigh 49.1%/$14.19 | Opus 5.5 Max 45.5%/$12.82 | Fableは最高スコアだが費用も高い |
| 世代間の伸び | 49.1% Xhigh | Fable 5.1 Xhigh 32.4%/$8.68 | タスク費用63%増で16.7ポイント向上 |
同じ報道の比較では、Fable 5.2のMediumはFable 5.1のXhighを5.2ポイント上回りながら、タスク費用はおよそ71%安くなっています($2.48対$8.68)。エージェントの実コストを動かすのは料金表だけではありません。テスト、再読み込み、リトライ、委譲によって、支出は20%の定価値下げ以上に変動します。難しいタスクはまずHighを標準にし、品質ゲートを通過したものだけXhighへ引き上げるのが現実的です。Maxは、自分のワークロードでベンチマーク上の効果を確認できた場合に限るべきでしょう。
Fable 5.2とOpus 5.5、タスク単価で使い分ける
公式発表に記載されたAnthropicのローンチ方針では、コーディングやナレッジワークの大半にはOpus 5.5を推奨し、Fable 5.2は特に難しいタスク、安価なモデルのアドバイザー、あるいは高速なモデルへ仕事を振り分けるオーケストレーターとして位置づけています。Fableは入力$8/出力$40、Opusは入力$4/出力$20なので、日常的な処理をFableに任せると、不要な性能にそのまま2倍の料金を払うことになります。
| ワークロード | 選ぶモデル | 費用の考え方 |
|---|---|---|
| 移行で詰まった、直らないバグ、難しい設計 | Fable 5.2 High | タスク費用$6.72で、同程度のスコアを出すOpus Maxの$12.82の半額 |
| 最高スコアを優先し、予算は二の次 | Fable 5.2 Xhigh | $14.19で49.1% |
| 日常的なコード、ドキュメント、下書き | Opus 5.5 | トークン単価が半分で、ベンダー推奨の標準モデル |
| 同じシステムプロンプトを繰り返し使う | Fable High+キャッシュ | 最小512トークン。5分と1時間の書き込み料金を使い分ける |
| レイテンシーが重要なセッション | Fast($16/$80)とHighを比較 | スループット向上が費用に見合う場合だけ2倍を払う |
| オフラインでの一括処理 | Batch API | 50%削減:Fableは$4/$20、Opusは$2/$10 |
クォータ消費とリセット:サブスクリプションだけでは見えない部分(ユーザー報告)
ローンチ週に寄せられたクォータに関する情報は、文書化されたAPIポリシーではなくユーザー報告です。Claude CodeとProのユーザーからは、5時間単位および週単位の上限を急速に消費するという報告がある一方、Fableのリセットで戻るのが5時間枠なのか、週次のFable枠なのか、一般的な容量なのかは不明確です。Anthropicの発表では、ローンチプロモーション期間中のFableリセット回数は、サブスクリプション履歴に応じて1~3回と説明されています。
「10分ほどで週次分の20%を使い切った」 — u/travisrd、r/claude「Fable 5.2. is INSANE」
「5時間の上限を猛烈な勢いで食い潰している!」 — u/myairblaster、r/ClaudeAI「Fable 5.2」
「Opus 5.5が見逃したバグを多数、しかも重大なものもいくつか見つけた」 — u/TheMagicalOppai、r/ClaudeAI「Fable 5.2」
バグを集中的に探すような作業では、従量課金のAPIキーが向いています。サブスクリプションは5時間単位の上限に縛られますが、APIならHigh推論のタスクごとに費用が発生し、FrontierCodeの例では1タスク約$6.72です。チームの作業をFableへ振る前に、アプリ内でリセット対象を確認しておきましょう。5時間メーターと週次メーターも分けて追跡するのが安全です。
FableとMythos:同じ重みでも適用されるゲートが違う
公式発表によると、Fable 5.2とMythos 5.2は同じ重みを共有し、安全策が異なります。Fableは一般提供モデルで、5.1と比べて誤った拒否が55%少なくなっています。Mythosは、Cyber and Life Sciences Verification Programsで審査を受けた組織を対象に、サイバー分野と生物学分野のブロックを解除します。トークン料金はFableと同じ入力$8/出力$40です。
Fableは2026年11月9日から、有料Claudeプラン、Claude Code、Claude Platform API、AWS、Google Cloud、Microsoft Azureで利用できます。5.1より最大30%高速な生成も実現しています。
より安価な標準モデルを検討しているチームは、入力$2/出力$10の選択肢を紹介するClaude Sonnet 5.5 APIのレビューと料金解説も参照してください。