 AIREITER
クラウド料金を一切払わず、Mac mini上で38.5秒の音声を2.81秒で生成する。ZyphraのZONOS3-Miniにまつわる、いま最も目を引く主張だ。2026年11月9日に公開されたこのテキスト読み上げモデルは、総パラメーター数こそ8億だが、MoE構成によって1ステップあたり実際に動くのは約1億に抑えられている。ただし、初期テスターが繰り返し指摘しているように、デモは高性能な環境で英語を使ったものだ。実際にどこまで近い結果が出るかは、入力テキスト、言語、GPUに左右される。
ZONOS3-Miniの正体と、利用できる5つの方法
ZONOS3-Miniは、Zyphraが開発したゼロショット音声クローン対応のTTSモデルだ。短い参照音声とテキストを渡せば、その話者の声で読み上げる。27種類の標準ボイスから選び、年齢、アクセント、声質を調整することも可能だ。重みはApache 2.0、実行コードはMITライセンスで、ローカル利用や商用利用に対応する。もちろん、クローンする声は自分が所有しているか、利用許可を得たものに限られる。
内部構造は、64エキスパートとtop-2ルーティングを採用したスパースMoEだ。11層のうち、Gated DeltaNetとグローバルアテンションを3:1で組み合わせている。さらに、ZONOS2で使われていた86HzのDACに代わり、毎秒15フレームで動作する新しいZyphra Audio Codec 1(ZAC-1)を採用。Zyphraによれば、この変更によって音声トークン数は毎秒774から150に減り、同条件のデータではDACよりワードエラー率が約10分の1になるという。
主な仕様は、出力44.1kHz、最大10分の生成、参照音声はraw cloneで最大60秒、embedding cloneで最大120秒。学習にはNVIDIA H100を112基、2.5日間使用している。
実行方法は次の5つだ。
- インストール不要のブラウザーWebGPUプレイグラウンド
- CPU、CUDA、Metal、Vulkanに対応するネイティブC++/ggml
- Apple MLXサーバー
- NVIDIAサーバー上のSGLangまたはvLLM
- Zyphraのホスト型API。
zyphra/zonos3-miniを使い、OpenAI互換の/v1/audio/speechエンドポイントから利用する
ベンダー公称値では、Pixel 9のブラウザーで音声が出始めるまで570ms未満、M3 MacBook Airでは150ms未満。SGLangを使ったH100 1基では中央値57~80ms、ピーク時のスループットは毎秒最大457オーディオ秒としている。ただし、スマートフォンとノートPCの数値はベストケースと考えたほうがいい。Zyphra自身のローンチスレッドでは、同じデバイスについてより控えめな「800ms未満」「450ms未満」という数字も示されている。サービスで性能を約束する前に、実際のハードウェアで測定したい。
ローンチ資料には、まだ2つの気になる空白がある。技術記事は総パラメーター数を8億と記載する一方、モデルページでは886Mとなっている。また、アップロードした参照音声について、ウォーターマーク、悪用対策、データ保持の扱いはどちらにも説明がない。
まずはインストールせず、ブラウザーで試す
ブラウザー版のプレイグラウンドは、サーバーを介さず、インストールも不要。WebGPUを使って手元のGPUで推論する。見落としがちなのは初回アクセスだ。ある初期テスターによれば、生成を始める前にモデルとコーデック合わせて約920MBを取得し、その後はブラウザーにキャッシュされる。
まずは無料の動作確認環境として使うのがいい。音声クローンとスパン単位の制御を試し、対象にする中で最も性能の低いデバイスでもレイテンシーを測っておこう。WebGPUの挙動は、ブラウザー、ドライバー、GPUによって変わる。
「小さなモデルがブラウザーで動いたからといって、毎回『クラウドTTSは終わった』と騒がないこと! ブラウザーやドライバー間のWebGPU互換性には落とし穴が多い。英語のデモがきれいに動いたからといって、本番のテキストでも通用するとは限らない!」 — @GKev1n、デモだけを根拠にホスト型TTSを置き換えることに注意を促す実ユーザー
古いスマートフォン、内蔵グラフィックス、Chromium系以外のブラウザーを使うユーザーがいるなら、テストなしにPixel 9の数値を当てはめてはいけない。
できること:文字起こし不要のクローンと、単語単位の演技指示
- ゼロショット音声クローン:文字起こしなしで最大60秒の参照音声に対応。自然さを優先するraw-clipモードと、後から再利用・調整できる話者埋め込みを使い分けられる。
- 声のデザイン:年齢、男性的・女性的な印象、アメリカ英語・イギリス英語・オーストラリア英語のアクセントを指定できる。soft、raspy、bright、deepといった声質も組み合わせられる。
- 話し方の制御:速度、感情、声の張り、活気、覚醒度、ささやき声を、単語スパン単位で調整できる。たとえば「I didn't say」だけをささやき、文の残りはニュートラルにするといった指定が可能だ。
- 生成後の編集:VoiceCraft風のモデルで、声や設定を維持したまま生成後の単語を変更できる。名前を1つ読み間違えただけで、音声全体を作り直す必要はない。
ただし、Zyphra自身も注意書きを添えている。感情や話し方の値はあくまで目標であり、結果を保証するものではない。速度を変えると音量やピッチも変わることがあり、活気の調整ではピッチや長さが変化する場合もある。
公開ハードウェアテスト:速度、VRAM、Windowsでの2つの罠
| 構成 | 実測結果 | 出典 |
|---|---|---|
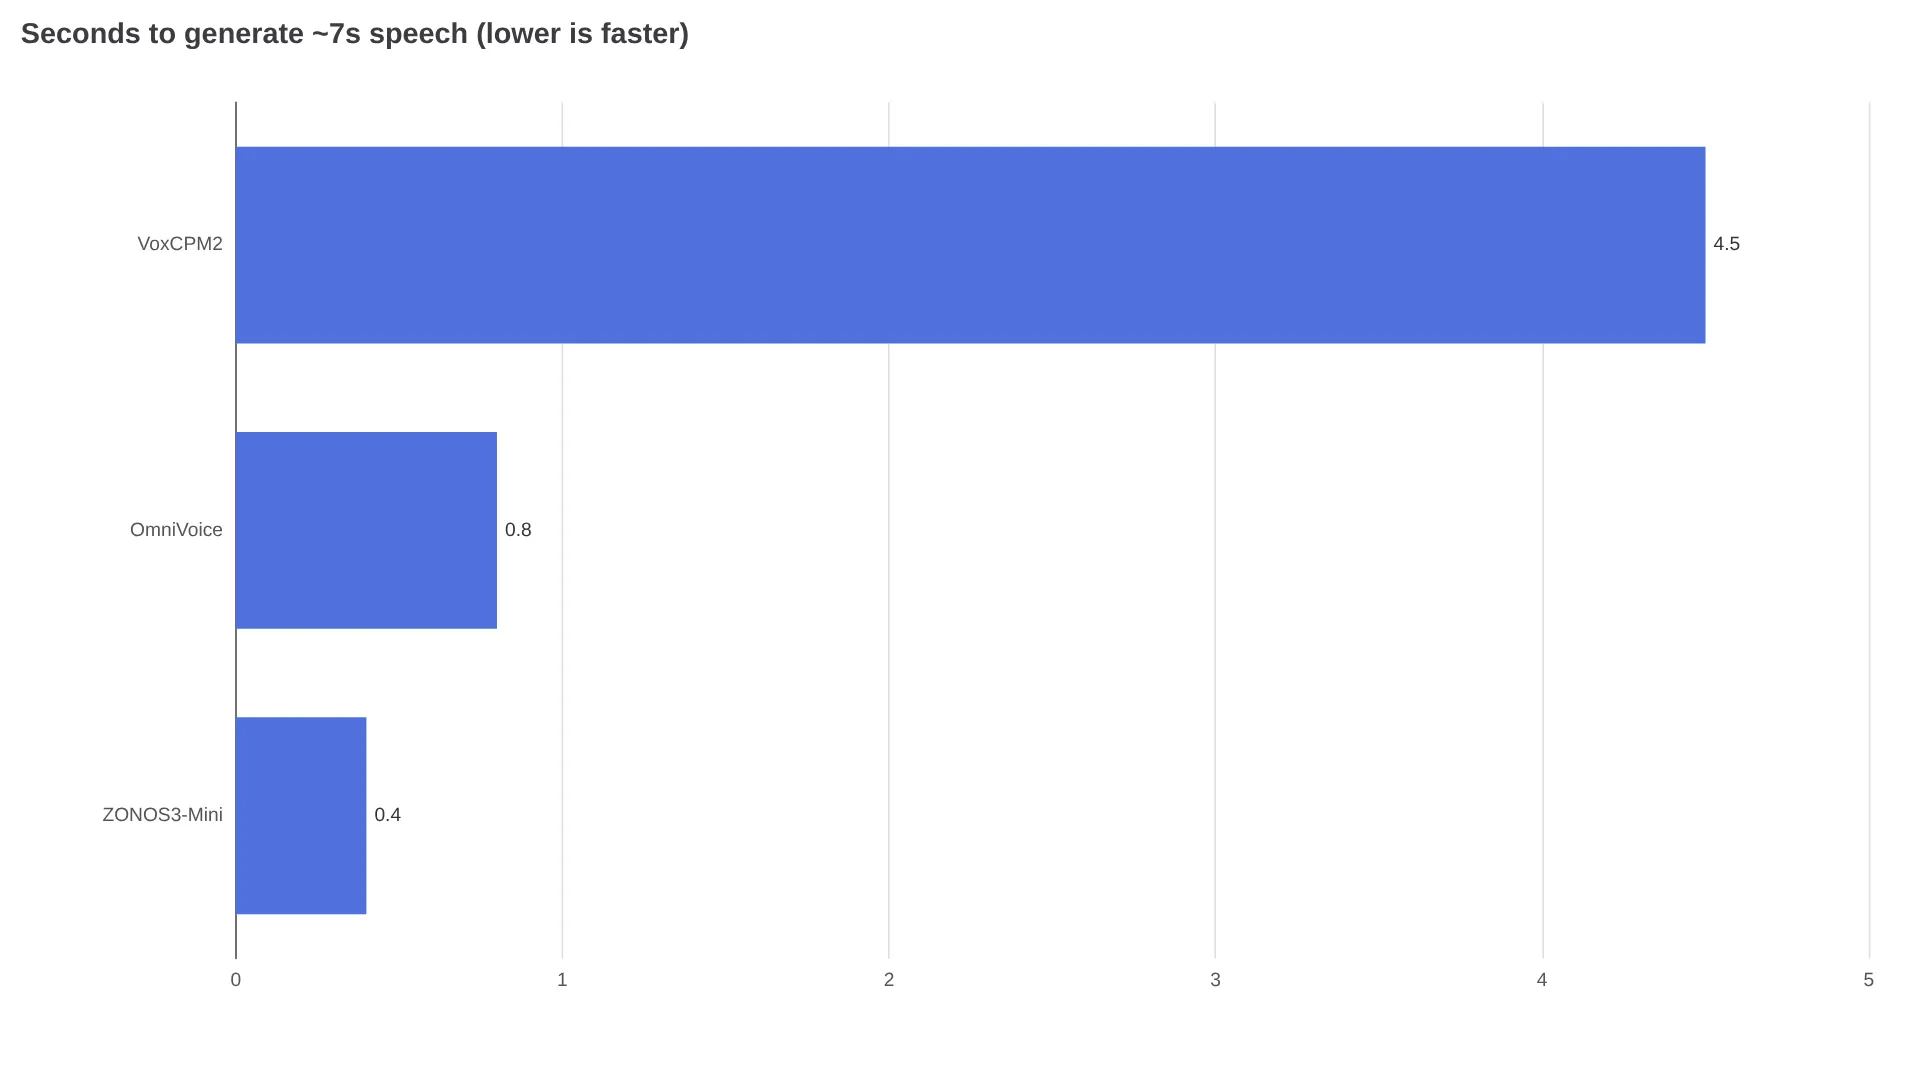
| RTX 5080、量子化ggml(バックボーン0.66GB+デコーダー0.45GB) | 約7.1秒の日本語音声を0.40秒で生成。VRAM総使用量2.4GB、リアルタイム係数0.056、リアルタイムの約18倍 | VRAM16ベンチマーク |
| 同じ環境:31秒の文章、CPUのみで7.2秒のクリップ | GPUでは2.5GB使用時に1.50秒。CPUは計算に1.45秒、起動から完了までは2.38秒 | VRAM16ベンチマーク |
| 64GB M5 Pro Mac mini、MLXサーバー | 38.5秒の音声を2.81秒で生成。音声開始まで75~100ms。初回クローン時のピークは約16GB | @pratikg |
GPUの結果は、同じベンチマークにおける以前のOmniVoiceの測定値より約2倍速く、VoxCPM2の0.63倍という結果を大きく上回る。
フルサイズの2.2GBデコーダーを使うと、使用量は4.2GBまで増えた。テスターが確認できる範囲では、音質面で明確な違いはなかった。Whisper large-v3による文字起こしは、意図した日本語と英語のテキストに一致した。ただし、これは聞き取りやすさを示す結果であって、自然さや参照音声との類似度を証明するものではない。
現時点で最も速いローカル実測は、64GBのM5 Pro Mac miniでMLXサーバーを使ったApple Silicon環境から報告されている。
「ベンチマーク結果:リアルタイムの最大13.7倍で動作する。64GB M5 Pro Mac mini上で、MLXサーバーを使って完全ローカル実行した場合の数値だ。標準ボイスでは音声開始まで約75~100ms。38.5秒の音声クリップを2.81秒で生成した。11~13秒の音声クリップから新しい声をクローンし、その声で約1.3秒後には発話できた。……WERは0~4%。メモリ使用量は数GBで、最初の音声クローン時だけピーク約16GBだった」 — @pratikg、データセットと測定メモを公開している実ユーザー
この結果には重要な但し書きがある。初回のクローン処理ではメモリ使用量が約16GBまで跳ね上がる一方、キャッシュ済みのクローンは標準ボイスと同じように高速に動く。多数の話者をバッチ処理するなら、定常時ではなくこのピークを基準にメモリを見積もるべきだ。
Windowsのソースビルドでは、VRAM16のテスターがパッチとともに2つの問題を報告している。Microsoftのコンパイラーは、GCCとClangでは通る、headというメンバーを持つ構造体を拒否した。そのため、付属の名前変更パッチを適用したうえで、zonos3-cli、zonos3-server、spk-encoder-cliだけをビルドする必要がある。もう1つは、日本語版WindowsのCLIがテキストをUTF-8ではなくCP932で渡してしまい、音声が文字化けする問題だ。GetCommandLineW経由でコマンドラインを読み直せば解消する。zonos3-serverへのJSONリクエストはもともとUTF-8のはずだが、検証はされていない。
実用面では、C:\zonos3のように、空白やASCII以外の文字を含まないパスを使うといい。Visual Studio 2022のC++ツール、Git、FFmpegをインストールし、CUDA環境をまっさらな状態から構築する場合は約5分を見込む。デフォルトの重み約1.2GBに加え、ローカルCUDAが約2GB必要になる(インストールメモ)。
ホスト型APIの料金計算:UTF-8の100万バイトあたり$10とは
ホスト型APIは、https://api.zyphracloud.com/api/v1/audio/speechにあるOpenAI互換の音声エンドポイントだ。モデルにzyphra/zonos3-miniを指定し、ZYPHRA_API_KEYをBearerトークンとして呼び出す。以下の例は、クラウドAPIと同じリクエスト形式でローカルのSGLang-Omniサーバー(SGLang cookbook)を起動するものだ。形式が共通しているため、まずlocalhostでプロトタイプを作り、準備ができたらベースURLをZyphra Cloudに差し替えられる。
sgl-omni serve --model-path Zyphra/ZONOS3-Mini --port 8000

curl -X POST http://localhost:8000/v1/audio/speech \
  -H "Content-Type: application/json" \
  -d '{"input": "Hello from ZONOS3-Mini!"}' \
  --output output.wav
料金は文字数でも音声分数でもなく、バイト数で決まる。UTF-8の100万バイトあたり$10.00で、同時実行は1リクエスト、1日あたり100生成、入力文字数は無制限。クローン上限は前述の60秒/120秒だ。英語を1文字あたりおおむね1バイト、1分の発話を800~900文字と仮定すると、$10で約1,100~1,250分、1分あたり1セント未満になる。一方、CJKテキストでは1文字あたり約3バイトかかるため、文字単位では約3倍のコストだ。中国語、日本語、韓国語で1分あたりの金額を知りたいなら、自分の入力で計算してほしい。
ローカル推論やブラウザー推論は、ハードウェアを用意した後の限界費用がほぼゼロ。ホスト型プランは試作や一時的な大量処理には向くが、同時実行1リクエスト、1日100生成という制限があるため、本番規模にはそのまま持ち込めない。大きなスループットが必要なチームは、$10という数字を単純に外挿せず、SGLangまたはvLLMの自前運用と比較すべきだ。
ElevenLabs、Fish、Qwenとの比較と「1位」バッジの見方
Zyphraのページでは、Fish Audio、Qwen、Cartesia、ElevenLabs、OmniVoiceとZONOS3-Miniを、3種類の台本で比較している。ドラマチックな予告編風の独白、長い「straight to jail」系のコミカルな文章、会話調のポッドキャスト風台本だ。レイテンシーとスループットを並べたパレートチャートもある。サンプル音声は自分で聴いて判断したい。ページには再生機能が用意されているが、明確な勝者の文章、競合モデルのバージョン、乱数シード、設定を揃えたという説明はない。
数値ランキングも同じように距離を置いて見る必要がある。ZyphraのZTTS2-Evalは、35のクリーンな言語と20の実環境言語を対象に、指標・データセット・言語の組み合わせ420項目を評価する。そのCapability Indexでは、オープンモデルの中でZONOS3-MiniがFish S2 ProやMOSS TTS v1.5を抑えて1位になっている。ただし、これはZyphraが設計した新しいテストで、自社モデルを評価した結果だ。手法自体は公開されているが、この記事の公開時点で独立した再現結果は見つからなかった。クローズドモデルとの比較も音声サンプルのみで、共通スコアはない。
Zyphraは言語別スコアや、独立した試聴評価での勝利を示していない。そのため、中国語の声調、日本語のピッチアクセント、多音字、長文での感情表現はまだ未検証だ。導入を決める前に、自分の用途でテストしてほしい。現時点での妥当な評価は、ZONOS3-Miniが効率と展開の柔軟性では先行している一方、音質面での優位性は証明されていない、というものだ。
いま乗り換えを検討すべきチーム
| チーム | 判断 | 理由 |
|---|---|---|
| オフライン、オンデバイス、またはプライバシー重視(ゲーム、リーダー、キオスク) | 今すぐ試す | Apache 2.0、デフォルトダウンロード1.2GB、VRAM 2.4GB、CPUでも動作、分単位の従量課金なし |
| 多数の声を必要とするオーディオブック/NPCパイプライン | パイロット導入 | 単語単位の制御と生成後編集で再生成のコストを抑えられる。ただし話者ごとのクローン類似度は確認が必要 |
| 英語以外、とくに中国語の本番環境 | 自社評価を待つ | ベンダーによる言語別スコアがない。多音字と声調を試すまでは、WERや韻律に関する主張は英語寄りの結果にとどまる |
| 高い同時実行数が必要なホスト型TTS | 自前運用または現状維持 | クラウド層は同時実行1リクエスト、1日100生成に制限される。本番で現実的なのはSGLang/vLLM |
| ウォーターマークや監査証跡が必要なチーム | 保留 | リリース資料には参照音声のウォーターマークや保持ポリシーの説明がない |
試す順番は、ブラウザーのプレイグラウンド、最も性能の低い対象デバイスでのローカルビルド、最後にホスト型APIがおすすめだ。ハードウェアがVRAM 2.4GBとWebGPUの条件を満たし、対象言語がブラインド試聴を通過した場合だけ乗り換えればいい。そうでなければ、いま使っているクローズドAPIを維持し、独立した多言語ベンチマークが出てから再検討しよう。
FAQ
ZONOS3-MiniにはどれくらいのVRAMが必要ですか?
テストされたRTX 5080環境では、合計約2.4~2.5GB。フルデコーダー使用時は4.2GB、Macで初回クローンを行う際のピークは約16GBだった。
ブラウザーやCPUでも動作しますか?
動作する。WebGPUでは初回アクセス時に約920MBをダウンロードする。公開されている1件のテストでは、CPUのみの合成も起動時間込みでリアルタイムの約3分の1で完了した。
音声クローンの品質はどの程度ですか?
文字起こしなしで最大60秒の参照音声からゼロショットでクローンできる。独立テストではWER 0~4%が報告されたが、話者ごとの類似度は自分で試聴して確認する必要がある。
商用利用できますか?
重みはApache 2.0、コードはMITライセンス。ただし、クローンする声については権利または本人の同意が必要だ。
APIのエンドポイントと料金は?
OpenAI互換のPOST https://api.zyphracloud.com/api/v1/audio/speechに、モデルzyphra/zonos3-miniを指定する。料金はUTF-8の100万バイトあたり$10(同時実行1リクエスト、1日100生成)。
関連記事:Best Text-to-Speech API、Best Voice Cloning API 2026、Kokoro 82M TTS Local Guide