 AIREITER
Claude Sonnet 5.5は、入力100万トークンあたり$2という料金と、Terminal-Bench 4.0で公表された70.6%というスコアを両立しています。ただし、エージェントを高いeffortレベルで動かすと、実際に受け入れ可能な変更1件あたりのコストは大きく跳ね上がります。本番向けのコーディングモデルを選ぶなら、まずはSonnet 5.5を標準ルートとして試すのが妥当です。ただし、Opus 5.5からの無条件な置き換えと考えるべきではありません。
本番導入の結論:まずはSonnet 5.5を標準のコーディングルートに
範囲の明確なバグ修正やリファクタリング、テスト生成、ツールを使うリポジトリ作業では、最初にClaude Sonnet 5.5をパイロット導入しましょう。Anthropicが公表したTerminal-Bench 4.0の結果は70.6%。同じ比較では、Claude Opus 5.5が66.4%、Claude Sonnet 5が10.3%でした。
ただし、運用上のガードレールは必要です。effortレベルと出力上限は明示的に設定してください。独立したコスト分析によると、Sonnet 5.5は見かけ上の料金が低いにもかかわらず、最大effortではベンチマークのタスク1件あたりの費用がOpus 5.5を上回ることがあります。
Claude Sonnet 5.5でAPIチームが確認すべき変更点
Claude Sonnet 5.5はSeptember 28, 2026にリリースされました。公式モデルドキュメントには、モデルID claude-sonnet-5-5、100万トークンのコンテキストウィンドウ、標準で128,000トークンの最大出力、adaptive thinking、そしてAPIのデフォルトeffortレベルがhighであることが記載されています。
| 本番運用上の項目 | Claude Sonnet 5.5 |
|---|---|
| リリース日 | September 28, 2026 |
| モデルID | claude-sonnet-5-5 |
| コンテキストウィンドウ | 1M tokens |
| 標準の最大出力 | 128K tokens |
| Batchの最大出力 | 300K tokens(ドキュメント記載のベータヘッダー使用時) |
| APIのデフォルトeffort | high |
Anthropicのドキュメントでは、September 28, 2027より前にこのモデルを廃止しないとしています。これはライフサイクル上の最低保証であり、最終的な廃止日を約束するものではありません。
コーディング費用に直結するAPIのデフォルト設定
adaptive thinkingはデフォルトで有効です。Sonnet 5から移行する場合、事前に行われる思考処理を無効にしたいケースではbetween_toolsを試してください。公式ドキュメントによると、強制的なツール使用はエラーを返すようになり、デフォルト以外のtemperature、top_p、top_kの値を指定するとHTTP 400エラーになります。
ツール呼び出しの間に生成されたテキストは、thinkingブロックとして返されることがあります。中間メッセージをすべて通常のテキストブロックとして扱うストリーミングクライアントでは、移行後に応答が止まったように見える可能性があります。Sonnet 5.5を既存のコーディングエージェントに組み込む前に、パーサーを更新しておきましょう。
Terminal-Benchの性能:標準ルートに採用できる水準
ここで特に注目すべきコーディングエージェント向けベンチマークが、複数ステップのコマンドライン作業を評価するTerminal-Bench 4.0です。Anthropicが報告した結果では、Sonnet 5.5が70.6%、Opus 5.5が66.4%、Sonnet 5が10.3%でした。
| モデル | Terminal-Bench 4.0 | GDPval-AA Elo | CursorBench 4.0 |
|---|---|---|---|
| Claude Sonnet 5.5 | 70.6% | 1844 | 55.5% |
| Claude Opus 5.5 | 66.4% | 1846 | 57.8% |
| Claude Sonnet 5 | 10.3% | 1449 | 34.1% |
上の数値はDataCampのベンチマークまとめに掲載されたもので、評価結果の出典はAnthropicのローンチ資料とされています。ターミナル上のコーディング比較ではSonnet 5.5が優位ですが、CursorBenchや、より広い推論・知識労働系の評価ではOpus 5.5が上回っています。
導入前の検証では、差分だけを見るのでは不十分です。テストの合否、ツール呼び出し回数、受け入れ可能な変更の割合を使って、実際のリポジトリの再現タスクを評価してください。
実際のワークロードで見るClaude Sonnet 5.5 APIの料金
Anthropicの料金表自体はシンプルです。しかし、コーディングエージェントでは、画面上で見えるプロンプト以外にも料金が発生します。thinkingトークンは出力として課金され、ターンをまたいで同じリポジトリのコンテキストを繰り返し送ると、キャッシュ読み取りが積み上がります。
| API項目 | Claude Sonnet 5.5の料金 |
|---|---|
| 入力 | 1Mトークンあたり$2 |
| 出力(thinkingを含む) | 1Mトークンあたり$10 |
| 5分間のキャッシュ書き込み | 1Mトークンあたり$2.50 |
| 1時間のキャッシュ書き込み | 1Mトークンあたり$4 |
| キャッシュ読み取り | 1Mトークンあたり$0.20 |
| Batch入力 | 50%割引、1Mあたり$1相当 |
| Batch出力 | 50%割引、1Mあたり$5相当 |
公式ドキュメントでは、キャッシュ可能なプロンプトの最小サイズを512トークンとし、Sonnet 5.5がadaptive thinkingを採用していることを説明しています。また、eeselによる独立した料金分析によると、Sonnet 5.5はSonnet 5と同じトークナイザーを使います。モデルを移行しただけでトークン数が自動的に減るわけではありません。
入力4,000トークン、出力700トークンのリクエストなら、その他の料金を除いて約$0.015です。内訳は入力$0.008、出力$0.007となります。入力3,000トークン、出力2,000トークンを毎ターン新たに使い、20ターンかかるコーディングエージェントの場合、キャッシュ読み取りや書き込み、ツール、リトライを除いて、入力で約$0.12、出力で$0.40を消費します。いずれもワークロードの一例であり、タスクごとの普遍的な料金ではありません。
料金を左右するのはeffort設定
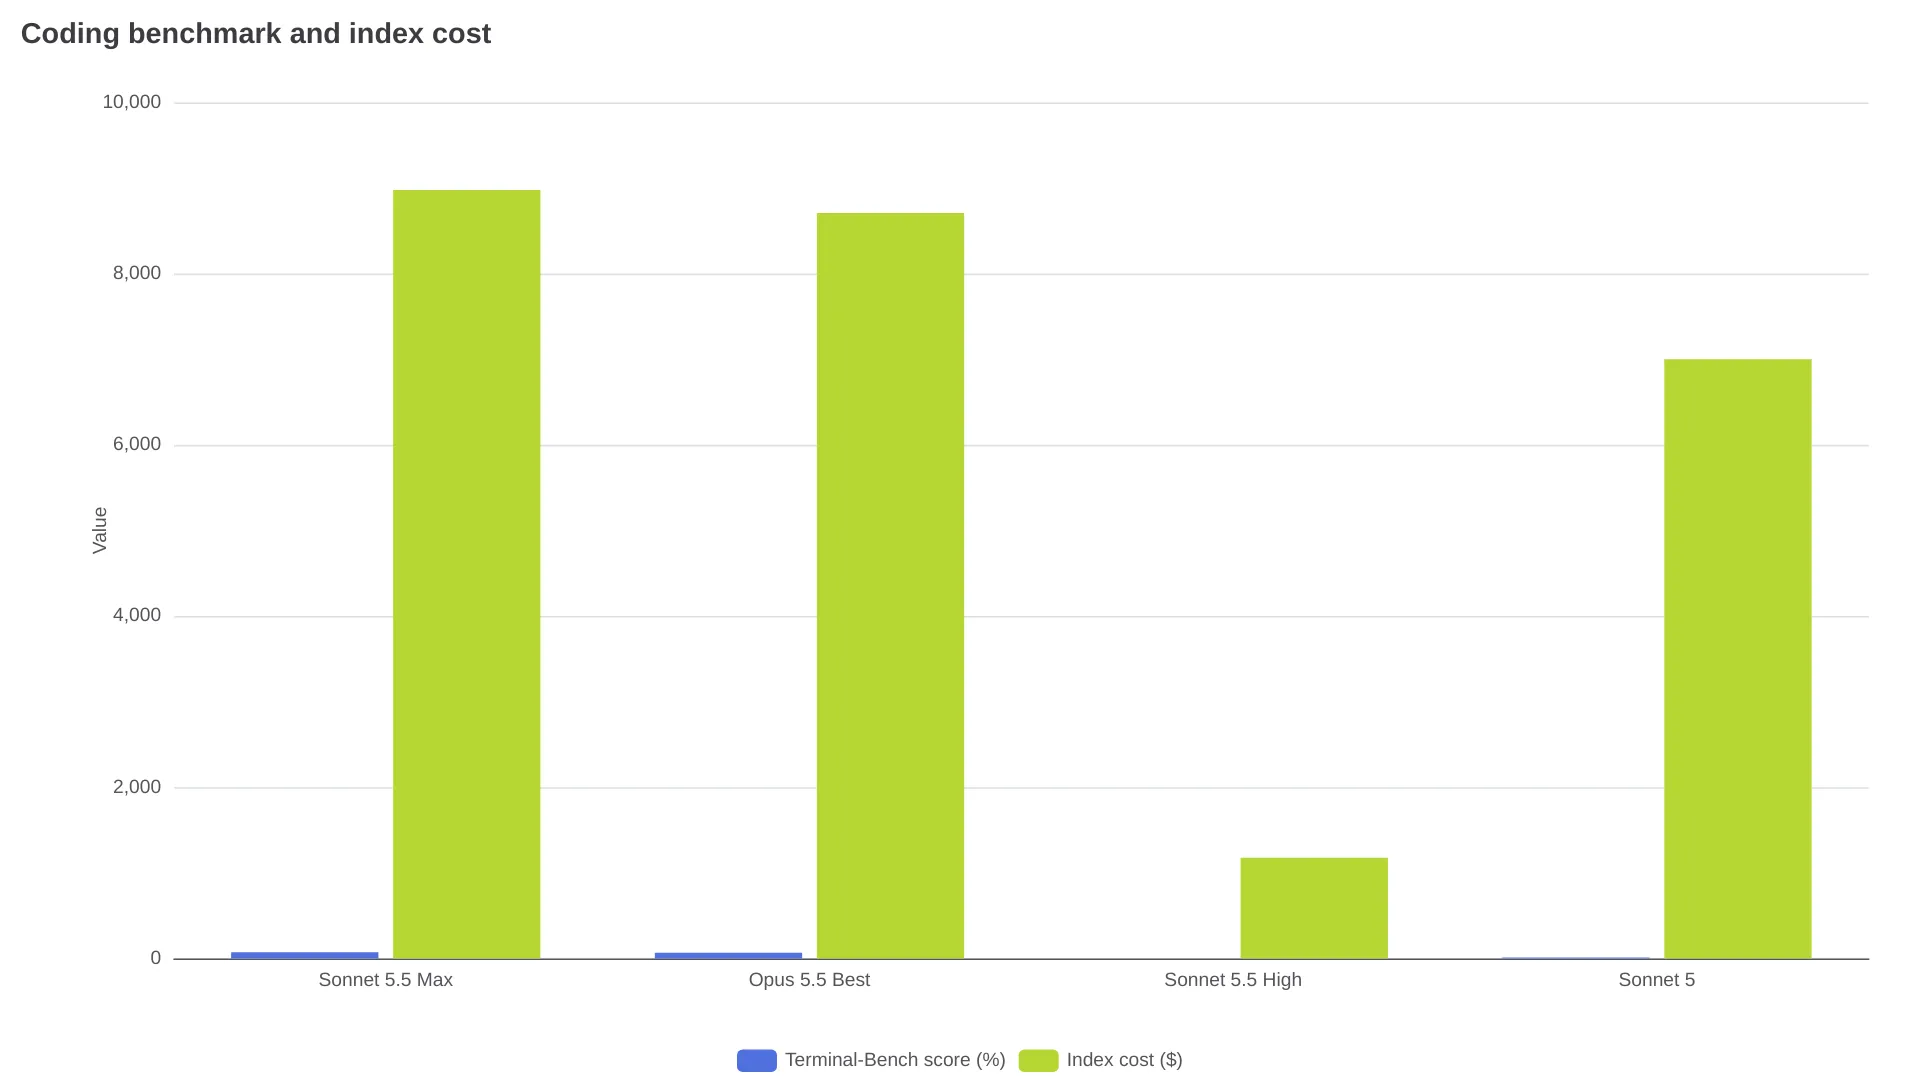
TokenCostのeffort分析では、Artificial Analysis Intelligence Indexの測定結果をもとに、Sonnet 5.5について次の数値を報告しています。
| Effort | スコア | インデックス全体のコスト |
|---|---|---|
| Low | 35.8 | $544 |
| Medium | 40.7 | $701 |
| High | 46.7 | $1,176 |
| Xhigh | 51.9 | $2,738 |
| Max | 56.0 | $8,977 |
特に注意したいのがMaxです。同じ分析では、Opus 5.5のMaxは57.6で$8,708、Xhighは56.0で$4,057でした。そのテストでSonnet 5.5のMaxが1タスクあたりに使った出力トークンは、およそ193,000です。
まずはMediumまたはHighから始め、出力トークン数に上限を設けましょう。失敗したタスクやリスクの高いタスクだけを、より高価なルートに振り分けるのが基本です。以前のSonnet 5で使っていたMax設定を、コストと品質の評価をやり直さずにSonnet 5.5へ引き継ぐのは避けてください。
本番向けコーディングモデルへの移行チェックリスト
- グローバルなエイリアス変更は避け、ステージング環境では
claude-sonnet-5-5を固定して指定する。 - 実際のリポジトリから、代表的なバグ修正、リファクタリング、テスト、複数ファイルの変更を再現する。
- effortを明示的に設定し、出力トークン数、キャッシュ読み取り、ツール呼び出し回数、経過時間、変更受け入れ率を記録する。
- 必要に応じて
thinking: disabledを、サポートされているbetween_toolsの挙動に置き換える。 - ツールの強制使用を前提にした処理を取り除き、新しいツール選択の挙動をテストする。
- ツール呼び出しの間に返る
thinkingブロックを扱えるよう、ストリーミング処理を更新する。 - デフォルト以外のサンプリングパラメーターを再確認する。公式ドキュメントでは、デフォルト以外の
temperature、top_p、top_kに対して400エラーが記載されている。 - 出力が暴走した場合やツールループを繰り返した場合に備え、利用額の上限と中断条件を設定する。
- リクエスト単位のコストではなく、受け入れ可能な変更1件あたりのコストで比較する。
- トラフィックの一部だけに段階的に展開する。合意した許容範囲内で既存モデルと同等の変更受け入れ率を維持しつつ、変更1件あたりのコストを下げられる場合に限ってSonnetの利用範囲を広げる。
Anthropicの従業員である@cjav_devは、thinking: {"type":"disabled"}を使ったリクエストが400エラーを返すようになり、代わりにbetween_toolsへ移行すべきだと報告しています(Xへの投稿)。
Sonnet 5.5、Opus 5.5、低価格モデルの使い分け
| ワークロード | 最初に試すモデル | 理由 |
|---|---|---|
| 範囲の明確なバグ修正とリファクタリング | Medium/HighのSonnet 5.5 | ターミナル系スコアが高く、トークン単価も低い |
| 大量のコード分類や単純な編集 | Low/MediumのSonnet 5.5、または低価格モデル | 不要な推論に料金を払わずに済む |
| 長時間動作するリポジトリエージェント | キャッシュと厳格な予算設定を組み合わせたSonnet 5.5 | 実際の請求額はキャッシュとターン数で決まる |
| 曖昧なアーキテクチャ設計や最終レビュー | Opus 5.5 | 最安の料金表よりも、幅広い判断力が重要になる |
| オフラインで行う緊急性の低いコード分析 | Sonnet 5.5 Batch API | 入力と出力が50%割引になる |
| Max effortのターミナル実験 | 社内ベンチマーク実施後のSonnet 5.5 | Terminal-Benchは強みだが、Maxでは高額になる可能性がある |
要件が明確で測定しやすいタスクにはSonnetを使い、判断が難しいアーキテクチャ作業はOpusへエスカレーションしましょう。
Claude Sonnet 5.5 APIに関するFAQ
Claude Sonnet 5.5 APIの料金はいくらですか?
標準料金は、入力が100万トークンあたり$2、出力が100万トークンあたり$10です。キャッシュ読み取りは100万トークンあたり$0.20、キャッシュ書き込みは5分間で$2.50、1時間で$4です。Batch APIでは入力と出力が50%割引になります。
コーディングではSonnet 5.5のほうがOpus 5.5より優れていますか?
公表されているTerminal-Bench 4.0の比較では、Sonnet 5.5が70.6%、Opus 5.5が66.4%で、Sonnet 5.5が上回っています。一方、ほかの複数の評価ではOpusが優位です。コーディングの結果だけで全用途の順位を決めるのではなく、タスクの種類に応じて振り分けてください。
Sonnet 5.5のモデルIDは何ですか?
Claude APIではclaude-sonnet-5-5を指定します。プロバイダーごとの識別子はAnthropicのモデルドキュメントに記載されています。
Sonnet 5.5は100万トークンのコンテキストウィンドウに対応していますか?
はい。Anthropicは100万トークンのコンテキストウィンドウと、標準で128,000トークンの最大出力を案内しています。Message Batches APIのベータ版では、ドキュメントに記載されたベータヘッダーを使うことで、300,000トークンの出力に対応できます。
Sonnet 5からの移行で何が変わりましたか?
adaptive thinkingとレスポンスブロックの挙動が変わり、強制的なツール使用ではエラーが発生する可能性があります。また、デフォルト以外のサンプリングパラメーターは400エラーを返すことがあり、thinking: disabledはサポートされている挙動に置き換える必要があります。本番展開前に、エージェントとストリーミングのテストをやり直してください。
Medium/High effortで1週間の再現タスクによるパイロットを実施し、変更を1件受け入れるまでのコストを測定しましょう。失敗したケースはOpusへエスカレーションします。