Gemini APIのTool Retrievalを使うと、エージェントが数百個のツール名を持っていても、実際に必要なツールのパラメータスキーマだけを読み込めます。ただし、検索のたびにモデルの処理が1回増える点には注意が必要です。毎ターン検索するような構成では、トークンを節約するどころかコストが上がることもあります。
この機能は、Googleの発表によると2026年11月19日にプレビューとして公開され、現時点ではInteractions APIでのみ利用できます。追加されたのは、tool_searchツールと、defer_loading: trueフラグです。遅延対象のツールは名前と説明だけを公開し、パラメータJSONはコンテキストに入れません。専用料金はなく、通常の入力・キャッシュ済み入力・出力の料金が適用されます。
200個のツールは、呼び出す前から164,000トークンを消費していた
プロンプトのコストを左右するのはツールの個数だけではなく、スキーマの大きさです。ツールカタログが大きくなると、実際の処理よりスキーマのほうがプロンプトを圧迫します。
Googleのドキュメントをもとにした独立した技術分析では、その差を示す例として、200個のツールライブラリでリクエストごとに使うツールが数個だけの場合、遅延なしでは約164,000入力トークン、Tool Retrievalを使うと約23,650トークンという数字が紹介されています。これはベンチマークではなく、同分析による概算です。ポイントは、実際には使わないスキーマのためにトークンを払い続けずに済むことです。
もうひとつの問題は選択精度です。似たようなスキーマが大量にコンテキストへ入ると、モデルが誤ったツールを選ぶ余地も増えます。GoogleはTool Retrievalについて、トークン量だけでなくツール選択の精度にも役立つと説明しています。ただし、精度について具体的な数値は公開されていません。ここは自分のタスクで検証すべき仮説として扱いましょう。
GeminiのTool Retrievalの仕組み:tool_searchとdefer_loading
設定は大きく2つです。{"type": "tool_search"}のtool_searchエントリを追加し、遅延させる各ツールに"defer_loading": trueを指定します。完全なリクエスト形式はドキュメント分析に掲載されています。モデルは遅延対象のツールについても、名前と説明は確認できます。defer_loadingの解説によると、short_descriptionを指定した場合はその内容が使われ、指定しなければ完全な説明文の最初の文がモデルに渡されます。
サーバー側の処理は、1回のリクエスト内で完結します。
- モデルが
tool_search_callを出力します。たとえばissue_refundを要求します。 - APIが完全なスキーマを含む
tool_search_resultを返します。 - モデルが実際の
function_callを出力します。Googleの返金例では、モデルgemini-4-hydrogenがorder_id: "A-1042"とamount: 40を使います。 - アプリ側で処理を実行し、
function_resultを返します。
interaction.stepsの内容はすべてログに残しておきましょう。誤ったツールが読み込まれたときは、まずトレースを確認し、名前や説明が曖昧ではないかを調べます。
サーバー側とクライアント側の違い:1リクエストで済むか、往復が増えるか
| モード | 検索する主体 | 用意するインデックス | 追加の往復 | 向いているケース |
|---|---|---|---|---|
| サーバー側(デフォルト) | Gemini | 不要。「構築・ホストするインデックスはありません」 | なし。同じリクエスト内で完結 | 大規模で、ほぼ固定のライブラリ。MCPサーバー全体 |
クライアント側("execution": "client") | アプリケーション | 自前のレジストリまたは埋め込みインデックス | 検索ごとに1回 | ユーザー単位の権限、非公開レジストリ、会話途中で追加されるツール |
サーバー側の検索ではホスト型インデックスを用意する必要がなく、同じレスポンス内で処理が完了します。ドキュメント分析によると、mcp_serverツールにdefer_loading: trueを指定すると、そのサーバーが公開するすべてのツールが遅延対象になります。
クライアント側では、"execution": "client"を付けたtool_searchを使います。例ではsearch_toolsという名前にし、必須のquery文字列を持たせています。アプリは検索結果をfunction_resultで返し、その後previous_interaction_idを指定したclient.interactions.createを続けて呼び出します。同じ分析によると、1リクエストにつきtool_searchは1回だけで、2つのモードを混在させることはできません。
ユーザーごとに認可が異なる場合や、会話の途中で連携機能が追加される場合は、クライアント側を選びます。引用した分析によると、共有カタログに対するサーバー側検索だけでは、ユーザー単位の権限フィルタリングは自動的に適用されません。また、会話の途中でツールを登場させる機能に対応しているのもクライアント側です。最初からすべてのツールを宣言しておく必要はありません。
Gemini Tool Retrievalの料金計算:まず26トークン、さらに完全な処理が1回
Googleの発表によると、Tool Retrievalに専用料金はありません。「Tool Retrieval has no separate charge.」それでも、トークン収支の分析で指摘されているように、計測対象となるコストは4つあります。
tool_searchによって、すべてのリクエストに少量の固定入力トークンが加わります。- 引用した分析では、遅延対象となる名前と説明の1行あたり、およそ26トークンと見積もっています。
- サーバー側の検索では、現在のコンテキストを使ってモデルの処理がもう1回実行されます。同分析によると、
total_tool_use_tokensとして、キャッシュヒット分を差し引いたプロンプトの入力量に近いトークンが課金されます。 - 読み込まれたスキーマは会話の残りの期間も入力として課金され、あとから読み込みを解除することはできません。
| ワークロード(引用した分析による概算) | Retrievalなし | Retrievalあり | 判定 |
|---|---|---|---|
| ツール200個。タスクごとに使うのは数個 | 約164,000トークン | 約23,650トークン | 節約になる |
| ツール10個、コンテキスト30,000、ほぼ毎ターン検索 | 約68,000トークン | 約92,830トークン | 割高になる |
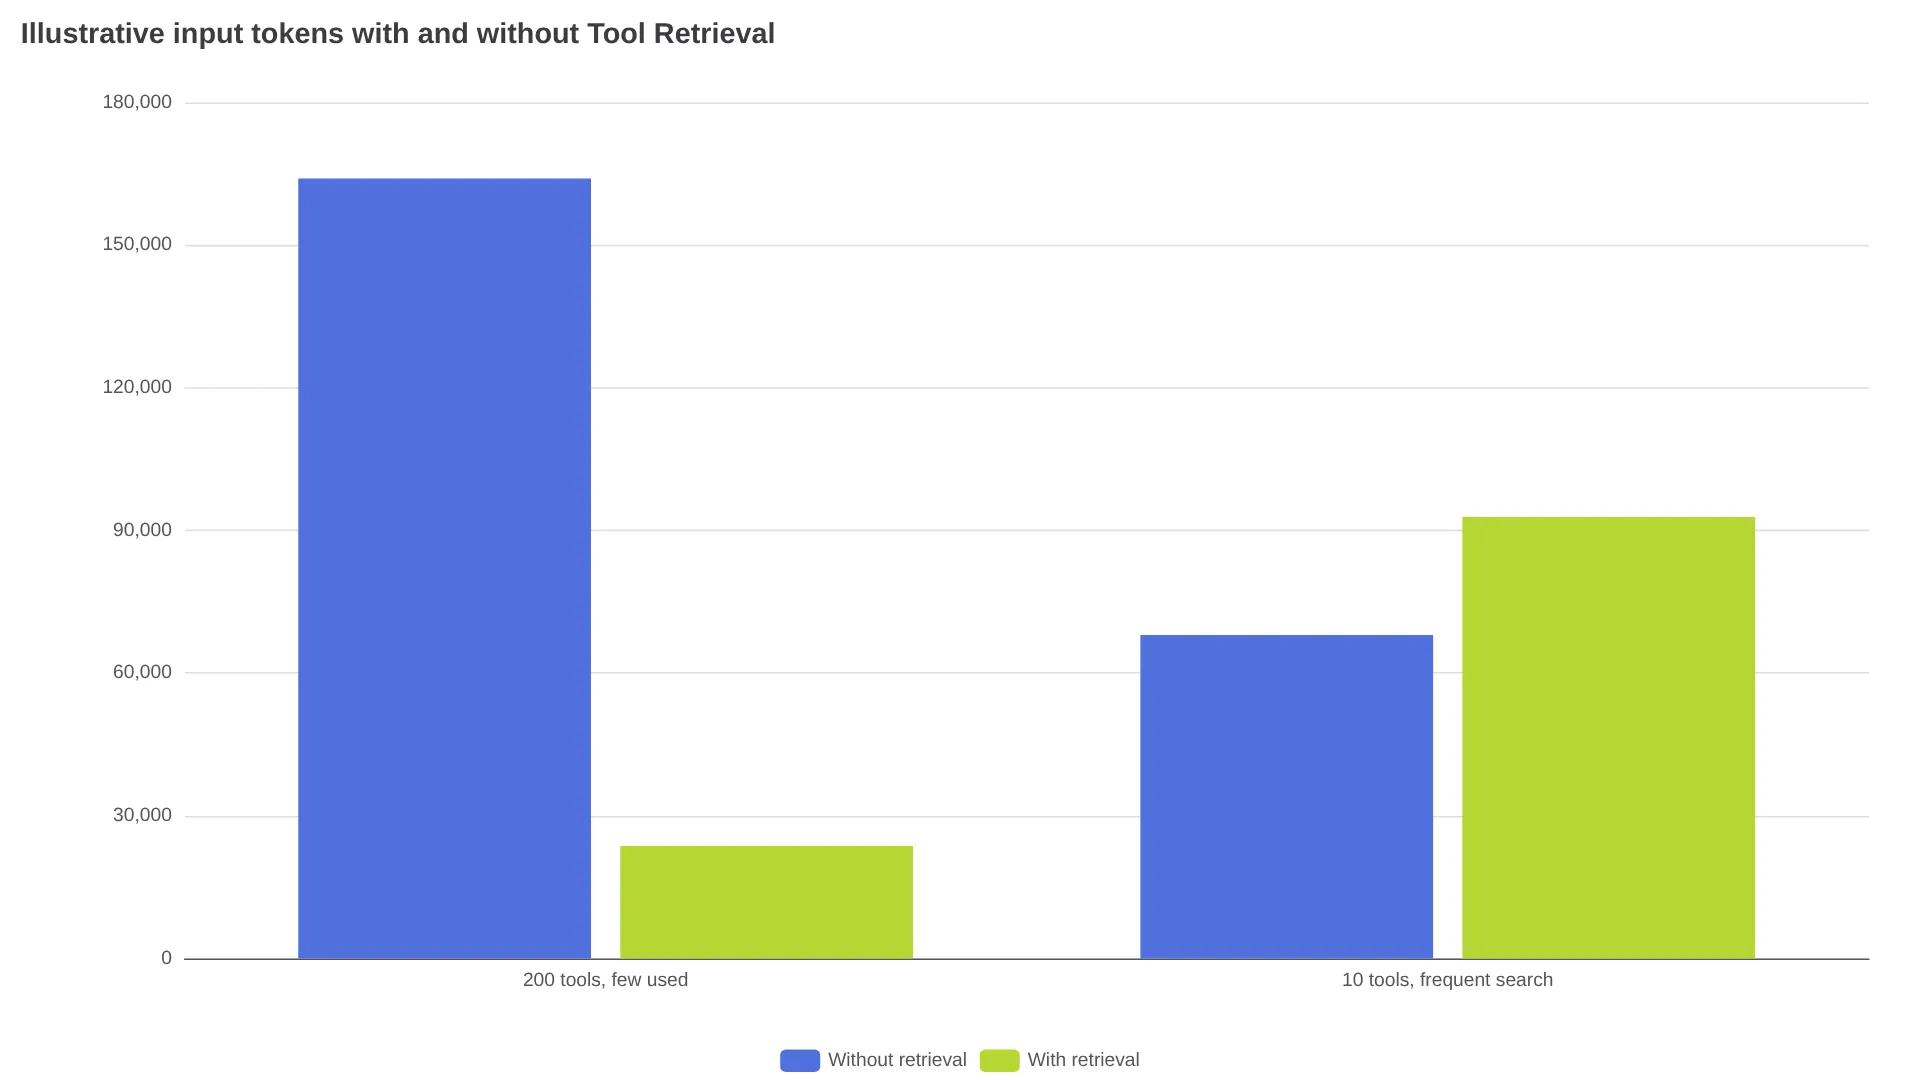
同じ発表でGoogleが示している指針は、「自分のトラフィックで測定すること」です。
「サーバー側モードでは、サーバー側の検索を行うたびに、現在のコンテキストを使ったモデルの処理がもう1回発生します。そのため、規模の大きなライブラリで、各タスクが使うツールが数個だけなら有効です。一方、小規模なライブラリでも、会話が長く、検索を頻繁に行うとコストが上がる可能性があります」 — @tekroch
遅延によってキャッシュされるプレフィックスが安定する場合もありますが、プロンプトがキャッシュ対象のサイズしきい値を下回る可能性もあります。引用した分析に従い、入力トークンと同時にキャッシュヒット率も追跡してください。
遅延させるツール、常時読み込むツールの見分け方
ツール数が少ない場合は、まず静的読み込みをベンチマークしましょう。判断材料として重要なのは、ツール数の一律のしきい値ではなく、検索頻度とスキーマのサイズです。大規模なカタログで、タスクごとに使うツールが1〜3個なら、サーバー側で使用頻度の低いツール群を遅延させ、頻繁に使うツールは遅延させずに残します。ユーザー単位のツールや会話中に追加されるツールには、検索1回につき往復が1回増えることを見込んだうえでクライアント側を使います。
引用した実装メモでは、次の3つをあらかじめ回避すべき失敗パターンとして挙げています。
- システム指示や別のツールの出力で名前が指定されるツールは遅延させないでください。モデルが検索せずに呼び出し、次のターンで失敗する可能性があります。
- 遅延対象の関数にも、リクエスト内の完全な
parametersが必要です。名前と説明だけでは、空の、呼び出せないスキーマが返ることがあります。 - ステートレスなアプリでは、
tool_search_call、tool_search_result、シグネチャ、完全なtools配列を毎ターン変更せずに送り返します。
検索結果を左右するのは説明の質です。モデルはスキーマを見る前に、名前と説明から候補を選びます。「日付範囲で顧客の請求書を検索する」なら見つけやすい一方、「Invoice helper」では他のツールと衝突します。遅延はセキュリティ境界ではありません。セキュリティ分析によると、遅延させたMCPの名前と説明はプロンプト入力として見えたままで、読み込まれたツールは付与済みの権限で実行されます。
プレビュー版では、まだできないこと
現時点ではプレビュー版で、対応するのはInteractions APIとv1betaのサーフェスだけです。generateContentには対応していません。ドキュメント分析によると、非対応モデルでdefer_loadingを使うとHTTP 400が返ります。
対応モデルの範囲も、見出しから受ける印象より狭いのが現状です。発表ではGemini 3.6以降、すべてのGemini 4モデルを含むとされています。一方、引用した分析によると、現在のライブドキュメントに掲載されているのはgemini-4-hydrogen、gemini-4-argon、gemini-3.8-flash、gemini-3.6-flashです。同じ系列の別モデルも動くと決めつけず、利用前にドキュメントで確認してください。GAの日程は発表されていません。Anthropicは2025年11月に同じdefer_loadingの考え方をベータ版として提供していますが、ローンチ時の報道によると、Google側の差分はサーバー側のMCP遅延とクライアント側モードです。
| ツールライブラリの構成 | 選ぶモード | 最初にすること |
|---|---|---|
| 小規模で安定 | 静的読み込み | 複雑化する前にスキーマのトークン量を測る |
| ツール50〜200個。タスクごとに使うのは数個 | サーバー側で遅延 | 使用頻度の低いツールを遅延させ、よく使うツールは読み込む |
| ユーザー単位または会話途中で追加されるツール | クライアント側検索 | 権限を考慮した検索を構築する |
| 毎ターンすべてのツールを使う | 静的読み込み | 検索のオーバーヘッドが節約分を上回る可能性が高い |
まずは使用頻度の低いツール群の一部だけで導入し、同一タスクを使って、遅延あり・なしの入力トークン、total_tool_use_tokens、レイテンシ、タスク成功率を比較しましょう。
FAQ
Tool RetrievalはgenerateContentで使えますか?
使えません。v1betaのInteractions APIのみ対応しています。
どのモデルが対応していますか?
Gemini 3.6以降、Gemini 4を含むモデルとして発表されています。ただし、引用した分析によると、現在のドキュメントではgemini-4-hydrogenやgemini-3.6-flashなどに範囲が絞られています。利用するモデルが対応しているか、正確なモデル名でドキュメントを確認してください。
料金が上がることはありますか?
あります。引用した概算では、検索をほぼ毎ターン実行する10個のツールのワークロードで、約68,000トークンから約92,830トークンに増えています。