Google a lancé deux modèles Gemini 4 à trois jours d’intervalle : Carbon le 10 novembre 2026, puis Hydrogen le 12 novembre. Résumer cela par « Carbon est intelligent, Hydrogen est rapide » est tentant, mais peut coûter cher. Sur un benchmark vidéo avec ancrage visuel, Hydrogen, pourtant 25 % moins cher au token, a généré une facture de 35,35 $, contre 27,94 $ pour Carbon, car il a produit 2,6 fois plus de tokens de sortie.
Les deux modèles sont disponibles dans Gemini API et AI Studio sous les identifiants gemini-4-carbon et gemini-4-hydrogen. Ils partagent une fenêtre de contexte unifiée de 1 048 576 tokens, acceptent texte, images, audio, vidéo et PDF, et répondent en texte (comparatif OpenRouter en direct). Carbon est le modèle de raisonnement de pointe pour les problèmes au long cours ; Hydrogen en est une déclinaison distillée, optimisée pour la vitesse et l’exécution quotidienne. Dans ses annonces de lancement de Carbon et de Hydrogen, Google présente d’ailleurs Hydrogen comme le modèle d’exécution d’un plan conçu par Carbon.
Quand le modèle moins cher au token coûte plus cher
Le test public de bout en bout cité ici est le benchmark de questions-réponses vidéo ancrées d’Agnify : identifier l’objet demandé par une question, l’encadrer dans des images clés, puis le suivre dans la vidéo. Il couvre 300 questions, 1,9 heure de vidéo et les mêmes 7,6 M de tokens d’entrée par modèle. Sur cette charge vidéo, le résultat remet sérieusement en cause les calculs limités au prix par token.
| Modèle | HOTA | Bon objet | Coût de l’exécution | Coût / heure de vidéo |
|---|---|---|---|---|
| GPT-6.1 Terra | 0.6169 | 94.3% | — | 8,19 $ |
| Gemini 4 Carbon | 0.6016 | 94.3% | 27,94 $ | 14,60 $, 29,20 $ à partir du 1er décembre |
| Gemini 4 Hydrogen | 0.6006 | 95.1% | 35,35 $ | ~18,50 $ fixe |
| Claude Opus 5.5 | 0.5944 | 92.7% | — | 43 $ |
Carbon et Hydrogen ne sont séparés que de 0,001 point HOTA, avec des intervalles de confiance qui se chevauchent. C’est une égalité statistique, tout comme face à Terra, Sol et Opus 5.5 dans le même échantillon. Mais Hydrogen a généré 3,19 M de tokens de sortie, contre 1,23 M pour Carbon. À l’étape 3, les médianes sont de 387 contre 47 tokens pour les encadrés d’objets uniques. Dans un cas portant sur une lettre en mousse, Hydrogen a dépensé 62 138 tokens, encadré la mauvaise lettre et obtenu 0,36 ; Carbon a utilisé 80 tokens pour un score de 0,70. Le rapport complet d’Agnify estime qu’en ramenant la verbosité de Hydrogen à celle de Carbon à l’étape 3, le coût de l’exécution tomberait à environ 24 $.
La règle formulée dans le guide de Vercel sur les charges de travail s’applique telle quelle : des tarifs identiques au token ne garantissent pas un coût identique par tâche. Mesurez le coût d’une tâche validée, tentatives comprises, et non le coût par million de tokens.
Ce que Google a réellement livré
Le guide de Vercel présente Argon comme le point de départ généraliste pour la synthèse et le travail de connaissance (Vercel). Par rapport à cette référence, Carbon est la voie d’escalade pour le débogage complexe et la science ouverte ; Hydrogen est le choix pour les tâches courantes, bornées et à gros volume. Retrouvez le détail sur Argon dans nos guides Carbon vs Argon et Hydrogen vs Argon.
L’architecture intéressante, c’est donc le duo. Le mode Orchestrator d’Antigravity laisse Carbon planifier en lecture seule, puis confie les modifications de fichiers et l’exécution des tests à Hydrogen, avant de rendre la main à Carbon en cas de blocage. Ce fonctionnement est décrit dans l’analyse du routage eve de Vercel et l’aperçu de Hydrogen par DataCamp. Cette combinaison affiche une réduction de quota de 24 % et une exécution 19 % plus rapide, pour un taux de réussite Terminal-Bench proche de Carbon : on paie le modèle de pointe une fois pour le plan, puis le modèle rapide pour le volume.
Les deux modèles ont des poids fermés (OnlySOTA), acceptent des entrées multimodales, renvoient du texte et prennent en charge le raisonnement (OpenRouter). Carbon propose les niveaux de réflexion low, medium et high, avec medium par défaut. Hydrogen ajoute xhigh et utilise high par défaut. Des niveaux portant le même nom ne correspondent pas au même volume de calcul d’un modèle à l’autre : enregistrez donc toujours le modèle et le niveau utilisés dans vos tests.
Après le 1er décembre, les tarifs changent la donne
Le tarif mis en avant pour Carbon est promotionnel. Celui de Hydrogen est fixe, une différence qui pèsera davantage dans les décisions d’achat que bien des benchmarks.
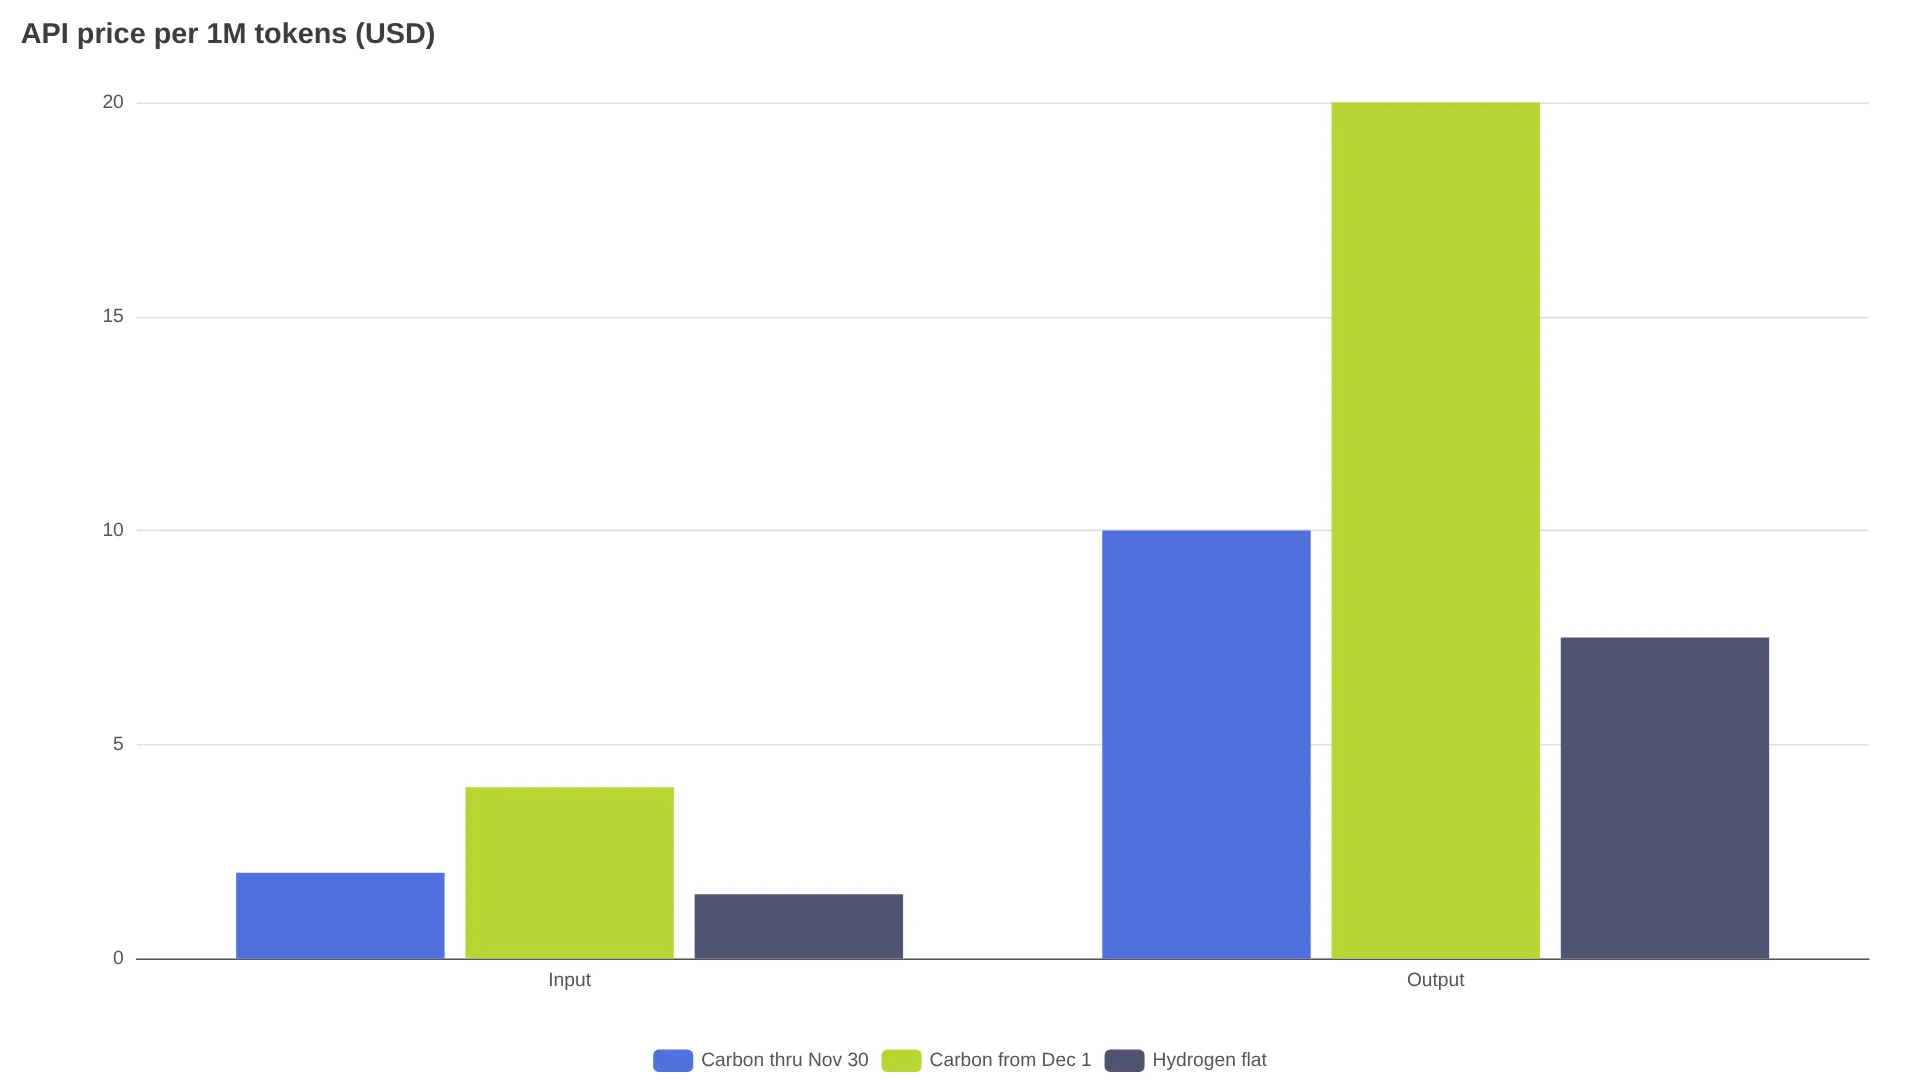
| Niveau | Carbon jusqu’au 30 novembre | Carbon à partir du 1er décembre | Hydrogen |
|---|---|---|---|
| Entrée / 1 M | 2,00 $ | 4,00 $ | 1,50 $ |
| Sortie / 1 M | 10,00 $ | 20,00 $ | 7,50 $ |
| Entrée mise en cache / 1 M | 0,10 $ | 0,20 $ | 0,075 $ |
| Batch entrée + sortie | 1,00 $ / 5,00 $ | 2,00 $ / 10,00 $ | selon le fournisseur |
| Prioritaire entrée + sortie | 3,60 $ / 18,00 $ | 7,20 $ / 36,00 $ | selon le fournisseur |
Tarifs : prix de lancement de Google via les notes de LiteLLM publiées le jour J et les tableaux tarifaires Cloud ; tarifs fixes de Hydrogen via DataCamp et la documentation AI Studio. Le prix des tokens de sortie inclut les tokens de réflexion : le raisonnement plus profond de Carbon est donc facturé deux fois, d’abord par les tokens consommés, puis par le doublement de prix de décembre.
Jusqu’en novembre, l’exécution vidéo de Carbon coûtait 9 % de moins que celle d’Argon, malgré des tarifs identiques au token, car Carbon en consommait moins. À partir de décembre, Hydrogen devient moins cher pour toute charge de travail dont la verbosité est comparable. Avec un ratio de 3:1 entre entrée et sortie (OnlySOTA), Hydrogen revient à 3,00 $/M, contre 4,00 $/M pour Carbon en novembre et 8,00 $/M à partir de décembre. Pour appeler les deux modèles derrière une même clé, la page API Gemini 4 Carbon permet de router vers l’un ou l’autre.
La vitesse et le niveau de réflexion façonnent l’expérience agent
Selon les médianes en direct du comparatif OpenRouter, Carbon affiche une latence p50 de 11,32 s à 57 tokens/s, contre 1,68 s et 144 tokens/s pour Hydrogen. Hydrogen répond donc environ 6,7 fois plus vite et offre 2,5 fois plus de débit, deux avantages déterminants pour la sensation de réactivité d’un agent interactif.
| Niveau Hydrogen | Coût par tâche | Intelligence Index | Usage |
|---|---|---|---|
low | ~0,29 $ | 27 | Tâches simples à très fort volume |
medium | ~0,80 $ | 41 | Travail courant où la vitesse compte |
high (par défaut) | ~1,87 $ | 51 | La plupart des usages de code et d’agents |
xhigh | ~3,16 $ | 54 | Seulement pour les problèmes complexes à plusieurs étapes |
Estimations d’Artificial Analysis, rapportées par DataCamp. Passer de high à xhigh coûte 69 % de plus par tâche pour seulement 3 points d’indice supplémentaires, avec le risque de trop réfléchir à des requêtes simples.
Quelques particularités d’API à prendre en compte dans le code (DataCamp) :
thinking_budgetetMINIMALrenvoient une erreur HTTP 400 ; utilisez plutôtthinking_leveltemperatureest ignoré- La sortie synchrone est limitée à 65 536 tokens ; Carbon est plafonné plus bas, à 32 768 selon le test d’Agnify
- Hydrogen est en disponibilité générale à court terme, avec un préavis de retrait d’au moins 45 jours
Les benchmarks départagent les usages, pas les trophées
| Source | Carbon | Hydrogen | Comparateur |
|---|---|---|---|
| Intelligence Index (OnlySOTA) | 60.0, n° 2/57 | 53.9, n° 7/57 | — |
| Arena Agent | 0.164, n° 3/65 | 0.149, n° 5/65 | — |
| Terminal-Bench 4.0 (OnlySOTA) | 64.5%, n° 3/59 | 56.4%, n° 12/59 | Sonnet 5.5 64% (AA indépendant) |
| Arena Code | 1768, n° 4/157 | 1704, n° 11/157 | — |
| Arena Text | 1526, n° 1/421 | 1490, n° 15/421 | — |
| Agents' Last Exam (DataCamp) | 77.4% | 71.6% | Argon 69.0% |
| Hallucinations AA-Omniscience | — | 8% | 5x moins d’affirmations inventées que Flash 3.8 (Google via DataCamp) |
OnlySOTA agrège des classements tiers au lieu d’exécuter ses propres tests (OnlySOTA). Le tableau ajusté de Google pour Terminal-Bench 4.1, relayé par DataCamp, donne Hydrogen à 57,0 %, contre 18,2 % pour Flash et 63,9 % pour Sonnet. En clair : Hydrogen est compétitif en programmation agentique, mais ce n’est pas le meilleur choix pour des workflows intensifs dans le terminal.
L’accès reste aujourd’hui le principal frein
Les identifiants de modèle sont stables : gemini-4-carbon et gemini-4-hydrogen. Hydrogen est documenté pour tous les niveaux API, y compris un niveau gratuit limité par débit (DataCamp, documentation AI Studio). Carbon nécessite une API payante et un accès Ultra (annonce de lancement de Carbon). Dans les faits, le déploiement a été irrégulier : Hydrogen apparaît, disparaît ou remplace automatiquement Flash selon l’application et le compte (fil de lancement r/GeminiAI). Consultez notre suivi des prix et du statut de lancement de Hydrogen pour les détails.
Les retours sur les quotas doivent être intégrés au coût de toute migration :
« Hier, les limites étaient plus généreuses. J’ai un abonnement Pro. Aujourd’hui, les prompts — par exemple écrire un chapitre d’environ 6 000 à 7 000 mots — consomment chacun autour de 4 à 5 %. Hier, quand Hydrogen est apparu, trois chapitres représentaient environ 2 % du quota de 5 h. La limite de 5 h est une blague. » — u/Neat_Reaction9164, r/GeminiAI
« J’ai codé avec lui et Sonnet aujourd’hui : Hydrogen a clairement assuré et s’est révélé étonnamment efficace, tandis que Sonnet a donné des résultats mitigés et atteint ses limites d’utilisation… Il est encore trop tôt pour juger. » — u/mmmtv, r/GeminiAI
Testez avec le chemin exact que vous comptez déployer — AI Studio, Antigravity, Cursor ou API — car le niveau d’accès, l’intégration et le niveau de réflexion peuvent modifier sensiblement le quota effectif. En cas de routage automatique, incluez l’appel de décision dans la latence et le coût : le modèle eve de Vercel utilise google/gemini-decision-1 à chaque tour, avec Argon comme solution de repli.
Quel modèle choisir selon votre charge de travail ?
Trois profils couvrent la majorité des usages API :
- Déployez Hydrogen pour le volume quotidien. Modifications de code courantes avec diffs vérifiables, extraction dans des formats stabilisés, questions-réponses sur une source unique, triage à haut volume. Fixez
high, effectuez des tests de non-régression avecmediumet réservezxhighaux cas à plusieurs étapes qui en ont démontrablement besoin. - Faites remonter les 10 % les plus difficiles vers Carbon. Explications concurrentes, analyse de cause racine lorsqu’un correctif peut masquer le symptôme, expériences contradictoires nécessitant un test discriminant, ensembles documentaires où des amendements remplacent des propositions. Acceptez alors la latence et le tarif de décembre.
- Associez les deux. Carbon planifie en lecture seule, Hydrogen exécute les modifications et les tests, puis Carbon reprend la main en cas de blocage. Cette configuration affiche une réduction de quota de 24 % et une exécution 19 % plus rapide.
Le compromis qui reste à surveiller est le risque de verbosité. Dans la sonde d’Agnify, le niveau high par défaut de Hydrogen a produit de 89 à 201 tokens de réflexion, là où le niveau par défaut de Carbon en produisait de 51 à 64. Utilisez des plafonds de sortie et mesurez les tokens générés sur vos propres prompts. Pour l’instant, budgétez Hydrogen selon les tokens émis, pas selon les tokens affichés au tarif.
FAQ
Carbon est-il meilleur que Hydrogen pour le raisonnement ?
Oui. Il obtient 60.0 contre 53.9 à l’Index, 64.5% contre 56.4% à Terminal-Bench 4.0, et la 1re place contre la 15e dans Arena Text ; les deux font toutefois jeu égal en questions-réponses vidéo, avec 0.6016 contre 0.6006 HOTA.
Lequel est le moins cher ?
Hydrogen : 1,50 $/7,50 $ par million de tokens, à tarif fixe. Carbon : 2 $/10 $ jusqu’au 30 novembre, puis 4 $/20 $ à partir du 1er décembre.
Lequel est le plus rapide ?
Hydrogen : 1,68 s contre 11,32 s de latence médiane, et 144 contre 57 tokens/s en débit.
Ont-ils la même fenêtre de contexte ?
Oui, 1 048 576 tokens unifiés pour les deux.
Carbon peut-il planifier pendant que Hydrogen exécute ?
Oui, via Antigravity Orchestrator ou un routage à chaque tour avec gemini-decision-1.
Quel niveau de réflexion utiliser ?
medium pour Carbon, high pour Hydrogen ; ne gardez xhigh que si le taux d’acceptation augmente de façon mesurable.