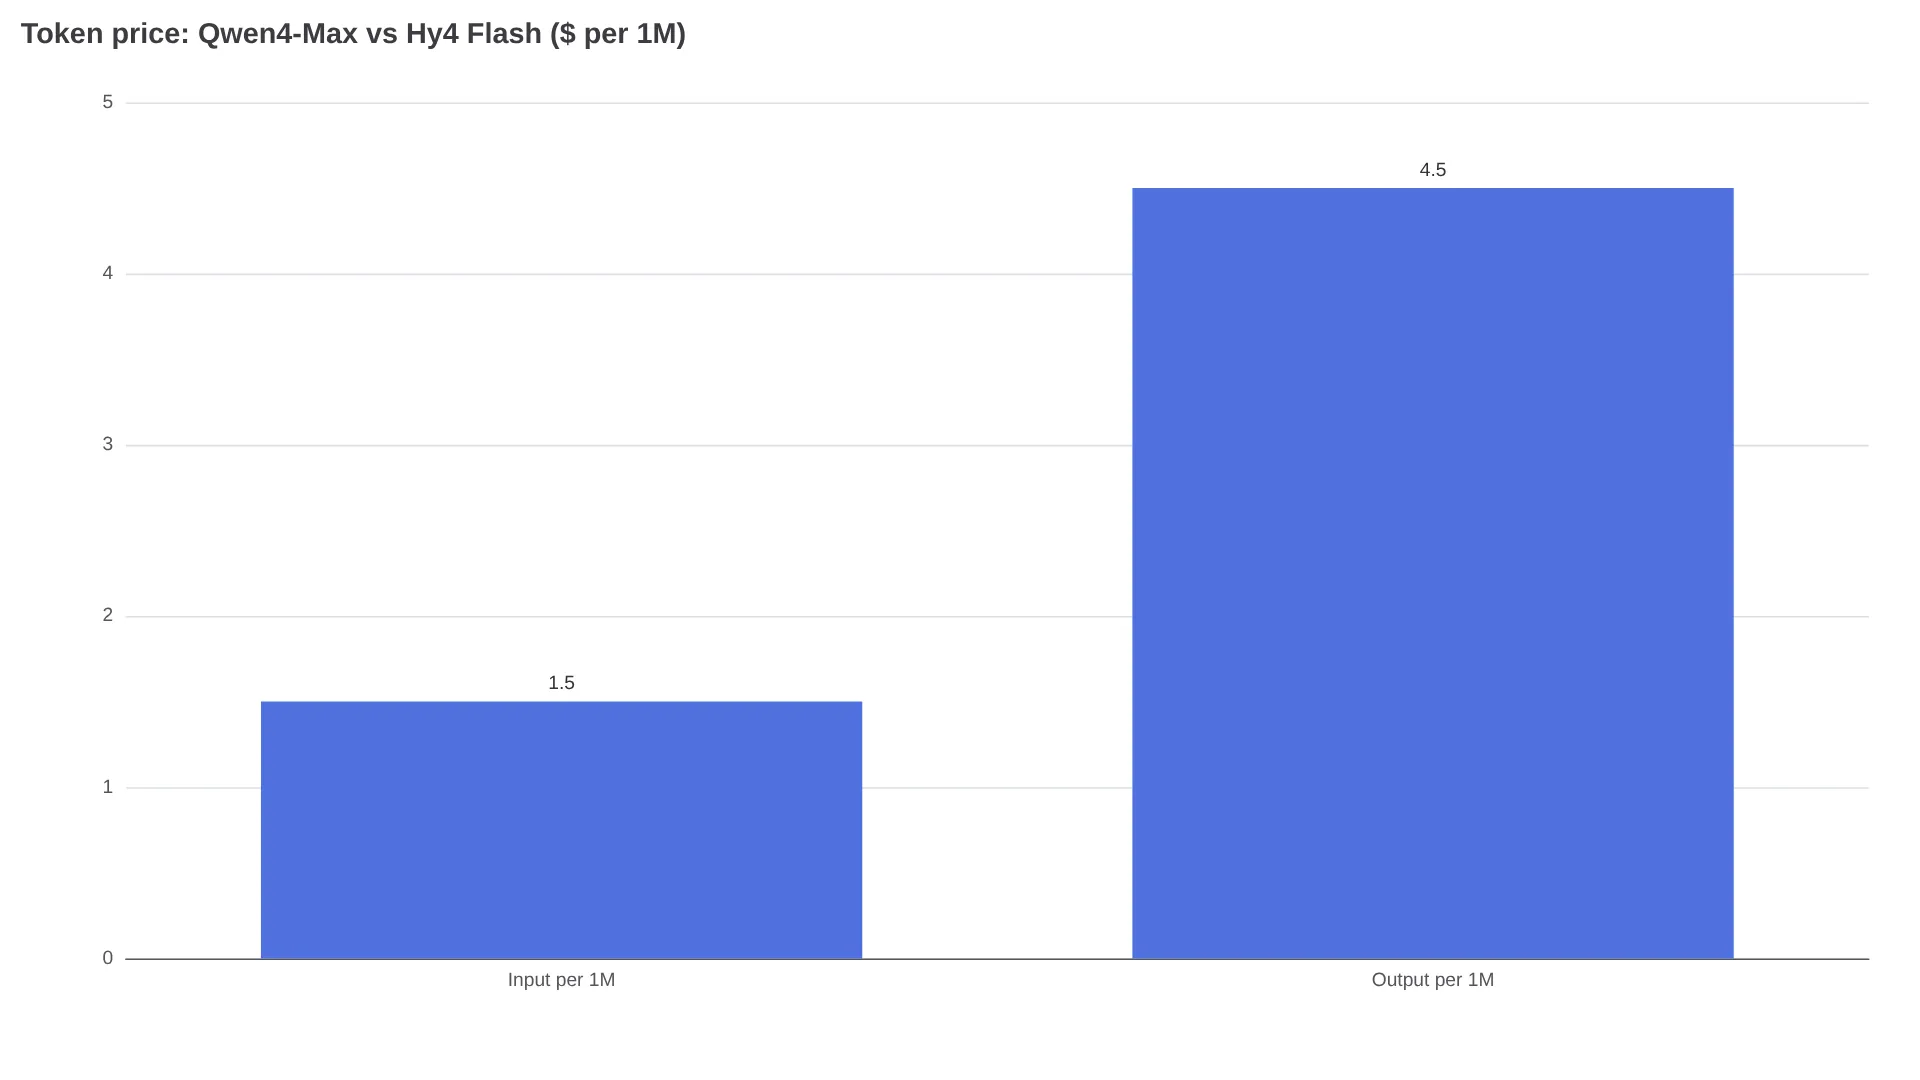
Pour le code complexe et les workflows exigeants, Qwen4-Max obtient de meilleurs résultats dans les benchmarks cités, tandis que Hy4 Flash reste nettement moins cher à chaque tentative. QwenCloud facture Qwen4-Max 1,50 $/4,50 $ par million de tokens, contre 0,070 $/0,281 $ pour Hy4 Flash chez Tencent — soit environ 21 fois plus cher en entrée et 16 fois en sortie. Pour un agent, la facture réelle dépend surtout des tokens de raisonnement, des relances et de la réutilisation du cache, pas du tarif affiché. Cette revue des prix de l’API Qwen4 Max compare le contexte de 1M tokens, les architectures de 2,4T et 224B paramètres ainsi que les coûts par tâche annoncés par les fournisseurs, avant de proposer un routage selon les usages.
Les tarifs affichés, réunis dans un tableau
| Élément | Qwen4-Max (Singapour / international) | Hy4 Flash (TokenHub international) |
|---|---|---|
| Entrée par million | 1,50 $ | 0,070 $ |
| Sortie par million (raisonnement inclus) | 4,50 $ | 0,281 $ |
| Lecture d’entrée en cache par million | 0,075 $ | 0,003 $ |
| Création explicite du cache par million | 1,875 $ (5 min) / 3,00 $ (1 h) | Non communiqué séparément |
| Mix 0,5M en entrée + 0,5M en sortie | 3,00 $ | ~0,176 $ |
| ID du modèle | qwen4-max via QwenCloud | Hy4 Flash via Tencent |
Une session de codage agentique avec 60 000 tokens d’entrée et 4 000 tokens de sortie permet de mesurer concrètement l’écart. Avec Qwen4-Max, l’entrée coûte 0,09 $ et la sortie 0,018 $, soit environ 0,108 $ par tentative. Avec Hy4 Flash, il faut compter 0,0042 $ et 0,0011 $, soit environ 0,0053 $ par tentative : près de 20 fois moins cher, avant les relances. Avec une entrée entièrement mise en cache, les mêmes 60 000 tokens coûtent 0,0045 $ sur Qwen4-Max et 0,00018 $ sur Hy4 Flash, toujours hors sortie. QwenCloud facture le raisonnement comme de la sortie ; chez Hy4 Flash, la sortie est facturée 0,281 $ par million, donc réduire la longueur des réponses diminue directement le nombre de tokens facturés.
Ce que les architectures changent pour la facture
Qwen4-Max est un modèle MoE de 2,4T paramètres, dont 71B sont actifs pour chaque token (Offloop, DataCamp). Hy4 Flash repose sur une architecture LatentMoE de 224B paramètres, avec 12B actifs, une inférence en 4 bits et un débit annoncé de plus de 150 tokens par seconde (Tencent). Pour le coût, le chiffre déterminant reste toutefois le volume de sortie mesuré : dans les tests, Qwen4-Max a atteint 127M tokens de sortie, contre une médiane de 78,6M chez ses concurrents (DataCamp). De son côté, le post-entraînement de Hy4 Flash aurait réduit de 50 % la longueur moyenne des sorties (Tencent).
Le tarif réellement appliqué dépend du déploiement
À Singapour, QwenCloud facture 1,50 $ l’entrée, 4,50 $ la sortie et 0,075 $ la lecture en cache. La limite maximale est de 991 808 tokens d’entrée sans réflexion et de 983 616 avec réflexion, avec 131 072 tokens de sortie sans réflexion et 262 144 tokens combinés (QwenCloud). D’autres déploiements — Virginie, Francfort, Tokyo et Hong Kong — affichent 1,413 $ / 4,24 $ / 0,071 $ (tableau régional via Offloop).
Les nouveaux comptes pay-as-you-go de Singapour bénéficient, selon l’offre affichée, d’une enveloppe gratuite d’un million de tokens (sous conditions, via Xenospectrum). La route Token Plan qwen4-max-preview sera retirée le 25 novembre 2026 et n’a jamais couvert les backends de production (notes de migration).
Hy4 Flash affiche 0,070 $ / 0,281 $ / 0,003 $ pour le modèle Flash, contre 0,834 $ / 2,501 $ / 0,042 $ pour le modèle amiral Hy4 complet (Tencent). Jusqu’au 30 novembre 2026, TokenHub proposait un tarif divisé par deux, soit environ 0,035 $ effectivement payés en entrée (Tencent). Vérifiez la disponibilité sur OpenRouter. Pour le détail, consultez la page consacrée aux tarifs de Hy4 Flash.
Les trois multiplicateurs qui font varier la facture
Premier facteur : le raisonnement est inclus dans le budget de sortie et facturé comme tel. Qwen4-Max utilise par défaut le niveau high, avec un budget de réflexion de 131 072 tokens ; xhigh et low sont les deux autres options. Dans le test SVG de Simon Willison via OpenRouter, résumé par Offloop, la même requête a consommé 6 362 tokens en high, contre 26 295 en xhigh : 4,1 fois plus de tokens facturables. En mode réflexion, définir max_completion_tokens à 10 000 signifie donc 10 000 tokens au total pour le raisonnement et la réponse.
Deuxième facteur : la longueur des réponses et les relances se cumulent. Selon les chiffres compilés par Alibaba et relayés par Offloop, Qwen4-Max génère environ 105 000 tokens de sortie par tâche de benchmark, contre 171 000 pour Qwen3.8-Max. Cela représente une baisse de 39 %, mais reste bien au-dessus de la médiane des concurrents. Un benchmark Reddit en environnement sandbox — 56 tâches, deux tentatives par tâche, soit 112 tentatives au total (discussion) — a enregistré 64 réussites pour Qwen4-Max Preview contre 61 pour DeepSeek V4.1 Flash, avec 16 timeouts contre 4 et environ 13 minutes par tâche contre 7. Chaque nouvelle tentative après un timeout génère une requête facturable.
« les 16 timeouts de Qwen expliquent une bonne partie de l’écart entre 64 et 61. » — u/the_crooked_badger, discussion r/DeepSeek
Troisième facteur : la réutilisation du cache est particulièrement intéressante pour les agents exploitant de longs contextes. La lecture en cache de Qwen4-Max, à 0,075 $, coûte 95 % de moins que l’entrée normale. Dans la discussion r/Qwen_AI, un commentateur a rapporté 112M tokens en cache contre 14M hors cache. Avec Hy4 Flash, la lecture en cache est encore 25 fois moins chère, à 0,003 $, mais cet avantage pèse moins lorsque les boucles de raisonnement supplémentaires dominent la facture. Comme le résume @MarcosRGjr : « Ignorez le prix par token. Les agents sont facturés à la tâche » (publication).
Coût par tâche annoncé par les fournisseurs : ce que montrent aussi les tests externes
Il s’agit de comparer les annonces des fournisseurs à des indicateurs externes, pas d’un face-à-face vérifié.
| Annonce | Chiffre | Base de calcul |
|---|---|---|
| Alibaba Work360, Qwen4-Max contre Qwen3.8-Max (données internes au fournisseur, via DataCamp) | 1,67 $ contre 4,43 $ par tâche tentée | Suite de 721 champs, environ 35 % de tokens en moins en high |
| Graphique Alibaba incluant les lignes AA, Qwen4-Max contre Qwen3.8-Max (données compilées par le fournisseur, via Offloop) | 3,27 $ contre 10,02 $ par tâche de benchmark | xhigh, 105K contre 171K tokens de sortie |
| Tencent WorkIndex, Hy4 Flash contre Hy4 complet (données internes au fournisseur, via Tencent et cette analyse) | 0,2 ¥ contre 5,7 ¥ par tâche | Suite bureautique de 8 ensembles |
| Test en aveugle de Tencent, Hy4 Flash contre Claude Haiku 5.5 (test réalisé par le fournisseur, via Tencent) | 0,26 ¥, 2,79/4 contre 4,73 ¥, 2,81/4 | 85 utilisateurs, 259 tâches, 6,7 contre 6,8 min |
Dans Work360, Qwen4-Max obtient un score de 52,69, contre 47,74 pour Qwen3.8-Max. L’Intelligence Index passe de 34 à 43, mais reste derrière Kimi K3.1 Pro à 46 et Opus 5.5 à 59 (Offloop, LLM Leaderboard).
Les résultats externes reproduits dans les graphiques des fournisseurs permettent de remettre ces annonces en perspective. Des tests affiliés à Vals, relayés par le guide du LLM Leaderboard, mesurent Qwen4-Max à 63,20 % pour 9,33 $ par test, contre 63,94 % pour GPT-6.1 Sol à 3,61 $. Sur Terminal-Bench 4.0, Qwen4-Max atteint 48,5 % et Hy4 Flash 19,2 % dans le graphique de Tencent (44,4 % pour Hy4 complet). ProgramBench affiche 31,5 contre 16,0 (Offloop). AutomationBench-AA donne 72,5 % à Qwen4-Max (DataCamp), contre 52,2 pour l’automatisation avec Hy4 Flash (Tokenstrom).
Le coût attendu par réussite correspond au coût d’une tentative divisé par la probabilité de réussite. À titre illustratif uniquement : 0,108 $ / 0,485 ≈ 0,22 $ pour Qwen4-Max contre 0,0053 $ / 0,192 ≈ 0,028 $ pour Hy4 Flash, soit un écart d’environ 8 fois. Les taux des benchmarks ne représentent pas les taux de relance en production. Avec ces volumes de tokens, Qwen4-Max doit afficher une probabilité de réussite environ 20 fois supérieure — ou compenser par les outils, la latence et la réduction des réparations — pour l’emporter sur le seul critère financier.
Choisissez le modèle selon la charge, puis validez avec 30 tâches réelles
| Profil de l’agent | Choix par défaut recommandé | Pourquoi |
|---|---|---|
| Codage complexe, tâches longues et travail dans le terminal | Qwen4-Max en high | Un meilleur taux de réussite (48,5 contre 19,2, 31,5 contre 16,0) peut justifier le surcoût lorsque les échecs ou les corrections coûtent cher |
| Boucles bureautiques à fort volume : présentations, documents, correction de feuilles de calcul et usage d’ordinateur | Hy4 Flash | 0,2 ¥ contre 5,7 ¥ dans WorkIndex, avec une parité avec Claude Haiku 5.5 (2,79 contre 2,81) pour un coût environ dix-huit fois inférieur |
| Chaînes avec cache et extraction par lots | Hy4 Flash par défaut ; Qwen4-Max lorsque la rejouabilité confirme les gains de qualité | Comparez les lectures en cache à 0,003 $ contre 0,075 $, en ajoutant le coût des corrections sur vos propres documents |
Avant de vous décider, rejouez 30 de vos tâches avec les deux modèles. Mesurez, pour chaque réussite, les tokens de raisonnement et de sortie, puis consignez les appels d’outils, les timeouts, les corrections et le temps médian, en plus du coût.
FAQ
Combien coûte l’API Qwen4 Max par million de tokens ?
QwenCloud Singapour facture 1,50 $ en entrée, 4,50 $ en sortie et 0,075 $ pour les lectures en cache. Les autres régions affichent 1,413 $ / 4,24 $ / 0,071 $. Hy4 Flash facture 0,070 $ en entrée, 0,281 $ en sortie et 0,003 $ en cache.
Les tokens de raisonnement ou de réflexion sont-ils facturés comme de la sortie ?
Qwen4-Max facture la réflexion à 4,50 $, dans une enveloppe partagée de 262 144 tokens. Les sorties de Hy4 Flash sont facturées 0,281 $, donc des réponses plus courtes réduisent le nombre de tokens facturés.
Quelle est la limite de contexte réellement exploitable, et pas seulement le chiffre de 1M ?
QwenCloud documente 991 808 tokens d’entrée sans réflexion et 983 616 avec réflexion, ainsi que 131 072 tokens de sortie sans réflexion et 262 144 tokens combinés. Tencent annonce un contexte de 1M pour Hy4 Flash. Prévoyez une marge de sécurité.
Entre Qwen4-Max et Hy4 Flash, lequel coûte le moins cher par tâche agentique terminée ?
À chaque tentative, Hy4 Flash coûte environ 20 fois moins cher. Tencent annonce un coût par tâche égal à un vingtième de celui du Hy4 complet et à un huitième de celui de DeepSeek-V4.1-Flash-1017 au tarif maximal (Tencent). Dans le calcul illustratif présenté plus haut, il reste environ 8 fois moins cher par réussite attendue. Qwen4-Max peut toutefois devenir plus rentable si la réduction des échecs et des corrections compense le prix supérieur des tokens.