L’API Qwen4 Max n’est plus réservée à un aperçu via Token Plan : elle est désormais accessible en paiement à l’usage, à 1,50 $ pour l’entrée et 4,50 $ pour la sortie par million de tokens, avec une fenêtre de contexte de 1M de tokens. Vous pouvez utiliser qwen4-max dès maintenant, car qwen4-max-preview sera retiré le 25 novembre 2026.
API Qwen4-Max : l’essentiel, disponible depuis le 16 novembre 2026
Alibaba a rendu Qwen4-Max généralement disponible le 16 novembre 2026 sur Alibaba Cloud Model Studio, sous l’identifiant qwen4-max, après un aperçu initial réservé au Token Plan lancé le 11 novembre. L’annonce publiée par @Alibaba_Qwen présente une nouvelle architecture MoE dotée de capacités natives en vision et d’un contexte de 1M de tokens. L’API est accessible sur QwenCloud. Pour l’accès international, la documentation QwenCloud reprend celle de Model Studio : utilisez l’endpoint Model Studio correspondant à votre région (documentation QwenCloud).
| Élément | Qwen4-Max (qwen4-max) |
|---|---|
| Statut | Disponibilité générale depuis le 16 novembre 2026 ; aperçu qwen4-max-preview du 11 au 25 novembre 2026, puis retrait |
| Entrée / sortie | 1,50 $ / 4,50 $ par million de tokens (Singapour, accès international) |
| Lecture du cache | 0,075 $ par million de tokens |
| Autres régions | 1,413 $ / 4,24 $ par million de tokens aux États-Unis (Virginie), à Francfort, Tokyo et Hong Kong |
| Contexte | 1M de tokens ; entrée maximale annoncée de 991K tokens |
| Sortie maximale | 131 072 tokens sans raisonnement ; 262 144 tokens pour le raisonnement et la réponse |
| Types d’entrée | Texte, images, vidéo |
| Style d’API | Compatible OpenAI et Anthropic ; appels d’outils, sortie JSON structurée, recherche web, mise en cache, traitement par lots et fine-tuning |
| Régions | Singapour, États-Unis (Virginie), Francfort, Tokyo, Hong Kong et Pékin ; traitements par lots disponibles uniquement à Pékin |
| Essai | Les nouveaux comptes de Singapour bénéficient de 1M de tokens gratuits pendant 90 jours |
Les tarifs et limites ci-dessus proviennent de la documentation Alibaba Cloud Model Studio consultée le 16 novembre 2026 (tarifs et documentation QwenCloud). Exemple : 100K tokens en entrée et 10K en sortie coûtent environ 0,15 $ + 0,045 $, soit 0,195 $.
Ce qui change réellement par rapport à Qwen3.8-Max
L’annonce de Qwen, qui cite les chiffres d’Artificial Analysis, attribue à Qwen4-Max un Intelligence Index de 43 : c’est 9 points de plus que Qwen3.8-Max (xhigh), mais 3 points de moins que Kimi K3.1 Pro. Son coût moyen atteint 3,27 $ par tâche, soit environ un tiers de celui de Qwen3.8-Max, avec 39 % de tokens générés en moins.
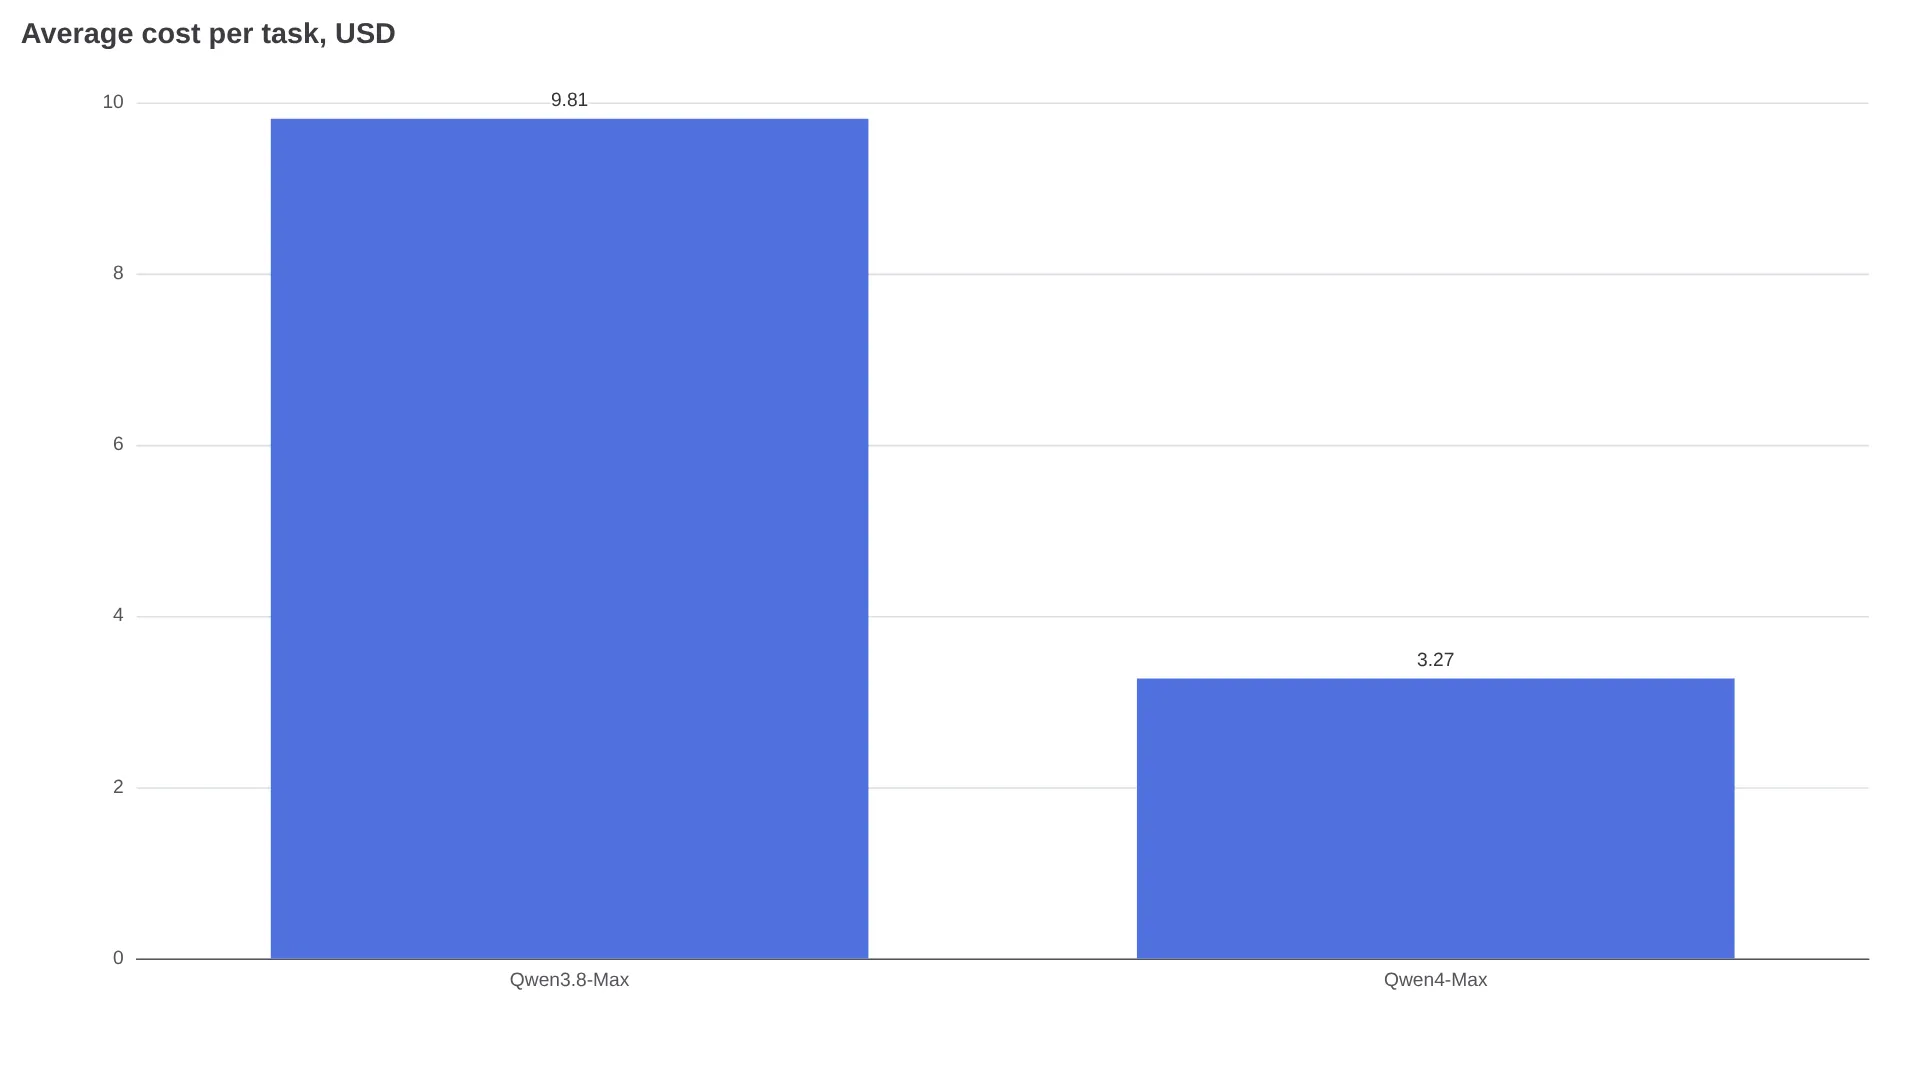
Les économies se cumulent sur deux fronts : le tarif par token présenté dans le tableau ci-dessus et le nombre réduit de tokens nécessaires par tâche, jusqu’à environ 50 % de moins dans l’évaluation interne de Qwen. Les traitements exploitant un contexte de 1M de tokens avec réutilisation du cache sont les plus avantageux, puisque les lectures implicites du cache coûtent 0,075 $ par million de tokens, un tarif annoncé comme 70 % inférieur à celui du cache de Qwen3.8-Max.
Sur le plan technique, Qwen4-Max repose sur une architecture MoE à vision native, avec 2,4 T de paramètres au total, 71 Md actifs et 328 Md pour les embeddings N-gram. Même si le billet de Qwen cite les scores d’Artificial Analysis, AI First Look et AICoder signalent que les tableaux complets de benchmarks et les classements publics d’AA n’étaient pas encore disponibles le 16 novembre.
À lire aussi sur le modèle précédent : tarifs de l’API Qwen3.8-Max et Qwen3.8-Max contre Kimi K3.
Les caractéristiques et limites qui pèseront sur la facture
Au-delà de la promesse d’un contexte de 1M, trois limites méritent une attention particulière.
Contexte total et entrée réellement utilisable. La fenêtre atteint 1M de tokens, mais QwenCloud indique une entrée maximale de 991K tokens. Prévoyez donc une marge de sécurité et testez la capacité à retrouver des informations au milieu du contexte pour les usages intensifs en retrieval.
La sortie et le raisonnement se partagent le même budget. Sans raisonnement, la sortie maximale est de 131 072 tokens. Lorsque le raisonnement est activé, le raisonnement et la réponse se partagent un plafond de 262 144 tokens : une réflexion particulièrement longue réduit donc l’espace disponible pour la réponse. D’après le récapitulatif des caractéristiques de l’aperçu publié par XenoSpectrum, la version preview autorisait 393 216 tokens partagés entre raisonnement et réponse. Ne reprenez donc pas ces anciennes limites en dur dans un environnement de production.
Les réglages de raisonnement ont changé. Le raisonnement est activé par défaut. La version GA utilise high par défaut, avec également low et xhigh disponibles ; la version preview employait xhigh par défaut, selon le tableau des caractéristiques d’AI First Look. Si la latence devient trop élevée, commencez par réduire reasoning_effort à low.
Les entrées multimodales prennent en charge le texte, les images et la vidéo. Lors de l’aperçu, les limites de soumission vidéo étaient de 2 heures, 2 Go et 64 vidéos par requête, selon le récapitulatif de XenoSpectrum — il s’agit de limites d’envoi, pas d’une garantie de compréhension. Testez la restitution sur des vidéos longues avec vos propres fichiers.
Pour maîtriser les coûts, demandez une sortie JSON structurée afin d’éviter les réponses inutilement longues et réutilisez les contextes volumineux via les lectures du cache (0,075 $ par million de tokens à Singapour). Les notes de lancement d’AICoder mentionnent également la création explicite d’un cache de cinq minutes à 1,875 $ par million de tokens lorsque cette fonction est prise en charge.
Appeler qwen4-max avec le SDK OpenAI
Model Studio prend en charge les formats OpenAI Chat Completions, Responses et Anthropic Messages API, selon la documentation des modèles d’Alibaba Cloud. Utilisez qwen4-max avec les backends en paiement à l’usage ; qwen4-max-preview reste réservé au Token Plan.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("QWEN_API_KEY"),
    # Singapore/international endpoint:
    base_url="https://dashscope-intl.aliyuncs.com/compatible-mode/v1",
    # China/Beijing endpoint: https://dashscope.aliyuncs.com/compatible-mode/v1
)

resp = client.chat.completions.create(
    model="qwen4-max",
    messages=[
        {"role": "user", "content": "Summarize this release in 3 bullets."}
    ],
    extra_body={"reasoning_effort": "high"},
)
print(resp.choices[0].message.content)
La clé et l’endpoint doivent correspondre à la même région Model Studio. Vous pouvez demander response_format={"type": "json_object"} ou un schéma JSON lorsque cette option est disponible, puis validez les sorties structurées volumineuses.
Paiement à l’usage, Token Plan ou applications de chat : quelle option choisir ?
| Option | Idéale pour | Contrainte principale |
|---|---|---|
Model Studio en paiement à l’usage (qwen4-max) | Applications, backends et traitements par lots | Facturation au token ; vérifiez la région de l’endpoint et la clé |
Token Plan (qwen4-max-preview) | Développement interactif dans Claude Code, Cline, Cursor et OpenCode | Usage interactif uniquement ; pas d’automatisation de production, de scripts par lots ni d’intégration dans un backend ; région de Singapour uniquement ; prend fin le 25 novembre 2026 à 24:00 UTC+8 |
| Qwen Chat, QwenWork, QwenStudio et Qoder | Tester des prompts, travailler sur des documents ou utiliser un IDE agentique sans gérer de clés | Disponibilité et taux de crédits affichés dans l’application ; ne constitue pas un contrat d’API |
Le Token Plan correspond à un crédit mensuel destiné au développement interactif. Le décryptage du Token Plan par Apidog indique des formules individuelles allant de Lite à 3 $ en tarif événementiel / 8 $ au tarif catalogue, avec 20 000 crédits, jusqu’à Pro à 43 $ en tarif événementiel / 51 $ au tarif catalogue, avec 200 000 crédits. Les clés commencent par sb-sp-. Partager une clé, lancer des tâches en arrière-plan ou intégrer la clé dans un backend distribué constitue une violation des conditions d’utilisation. Pour tester des prompts, Apidog et XenoSpectrum citent Qwen Chat, QwenWork, QwenStudio et Qoder comme options d’évaluation ; leur disponibilité est indiquée dans l’application et varie selon les comptes.
Effectuez la migration avant le 25 novembre 2026 :
- Remplacez l’identifiant de modèle
qwen4-max-previewparqwen4-max. - Abandonnez l’URL de base et la clé du Token Plan au profit d’une clé Model Studio en paiement à l’usage et de l’endpoint régional correspondant.
- Retestez les réglages de raisonnement (
xhighdevienthighpar défaut). - Mesurez à nouveau les budgets de sortie (limite preview partagée de 393K contre limites GA de 131K/262K).
Les premiers retours : très efficace pour démarrer, plus irrégulier avec les agents
Les tests réalisés sur de petits échantillons et compilés par AI First Look font état de projets fonctionnels générés à partir d’un seul prompt. Dans l’un d’eux, les 20 tests cachés sur 20 ont été réussis en environ 2,5 minutes, contre 17 minutes pour Qwen3.8-Max. Le même récapitulatif mentionne toutefois un test de jeu dans lequel Qwen4-Max a terminé plus vite, tout en obtenant la deuxième place au classement général.
J’obtiens constamment ces erreurs quand j’essaie de générer du code.
— @bijanbowen, publication (première impression d’un utilisateur, 16 novembre 2026 ; capture d’erreurs répétées lors de la génération de code)
Un premier récapitulatif de tests menés par des utilisateurs chinois (@weconomypistis) considère le prix et le coût par tâche comme les principaux atouts, mais juge les opérations dans le terminal et avec les agents en retrait par rapport à Kimi, avec des réponses plus lentes.
FAQ
Qwen4-Max est-il disponible en open weight ?
Non. Au 16 novembre, Qwen4-Max est uniquement hébergé et aucun poids n’a été annoncé, selon le suivi d’AI First Look. Qwen indique que des modèles Qwen4 plus petits seront ensuite proposés avec leurs poids ouverts, d’après l’annonce de Qwen4-Max, sans préciser de date, de tailles ni de licence.