 AIREITER
Disponible en version générale depuis le 3 août 2026, Qwen3.8-Max facture 2 $ par million de tokens en entrée et 6 $ en sortie. Son tarif de sortie est au moins quatre fois inférieur à celui de Claude Opus 4.8, Claude Fable 5 et GPT-5.6 Sol. Attention toutefois : reasoning_effort est réglé sur xhigh par défaut, ce qui peut faire grimper la facture dès la première requête.
Les tarifs par token de Qwen3.8-Max
Qwen3.8-Max est un modèle mixture-of-experts de 2 400 milliards de paramètres, dont 95 milliards sont actifs pour chaque token. Il succède à Qwen3.7-Max comme modèle phare d’Alibaba. Les tarifs ci-dessous proviennent de la page du modèle chez Alibaba, datée « Updated: Aug 2, 2026 » :
| Élément | Prix par million de tokens |
|---|---|
| Entrée | 2,00 $ |
| Sortie | 6,00 $ |
| Entrée (cache implicite) | 0,25 $ |
| Création d’un cache explicite | 2,50 $ |
| Lecture d’un cache explicite | 0,17 $ |
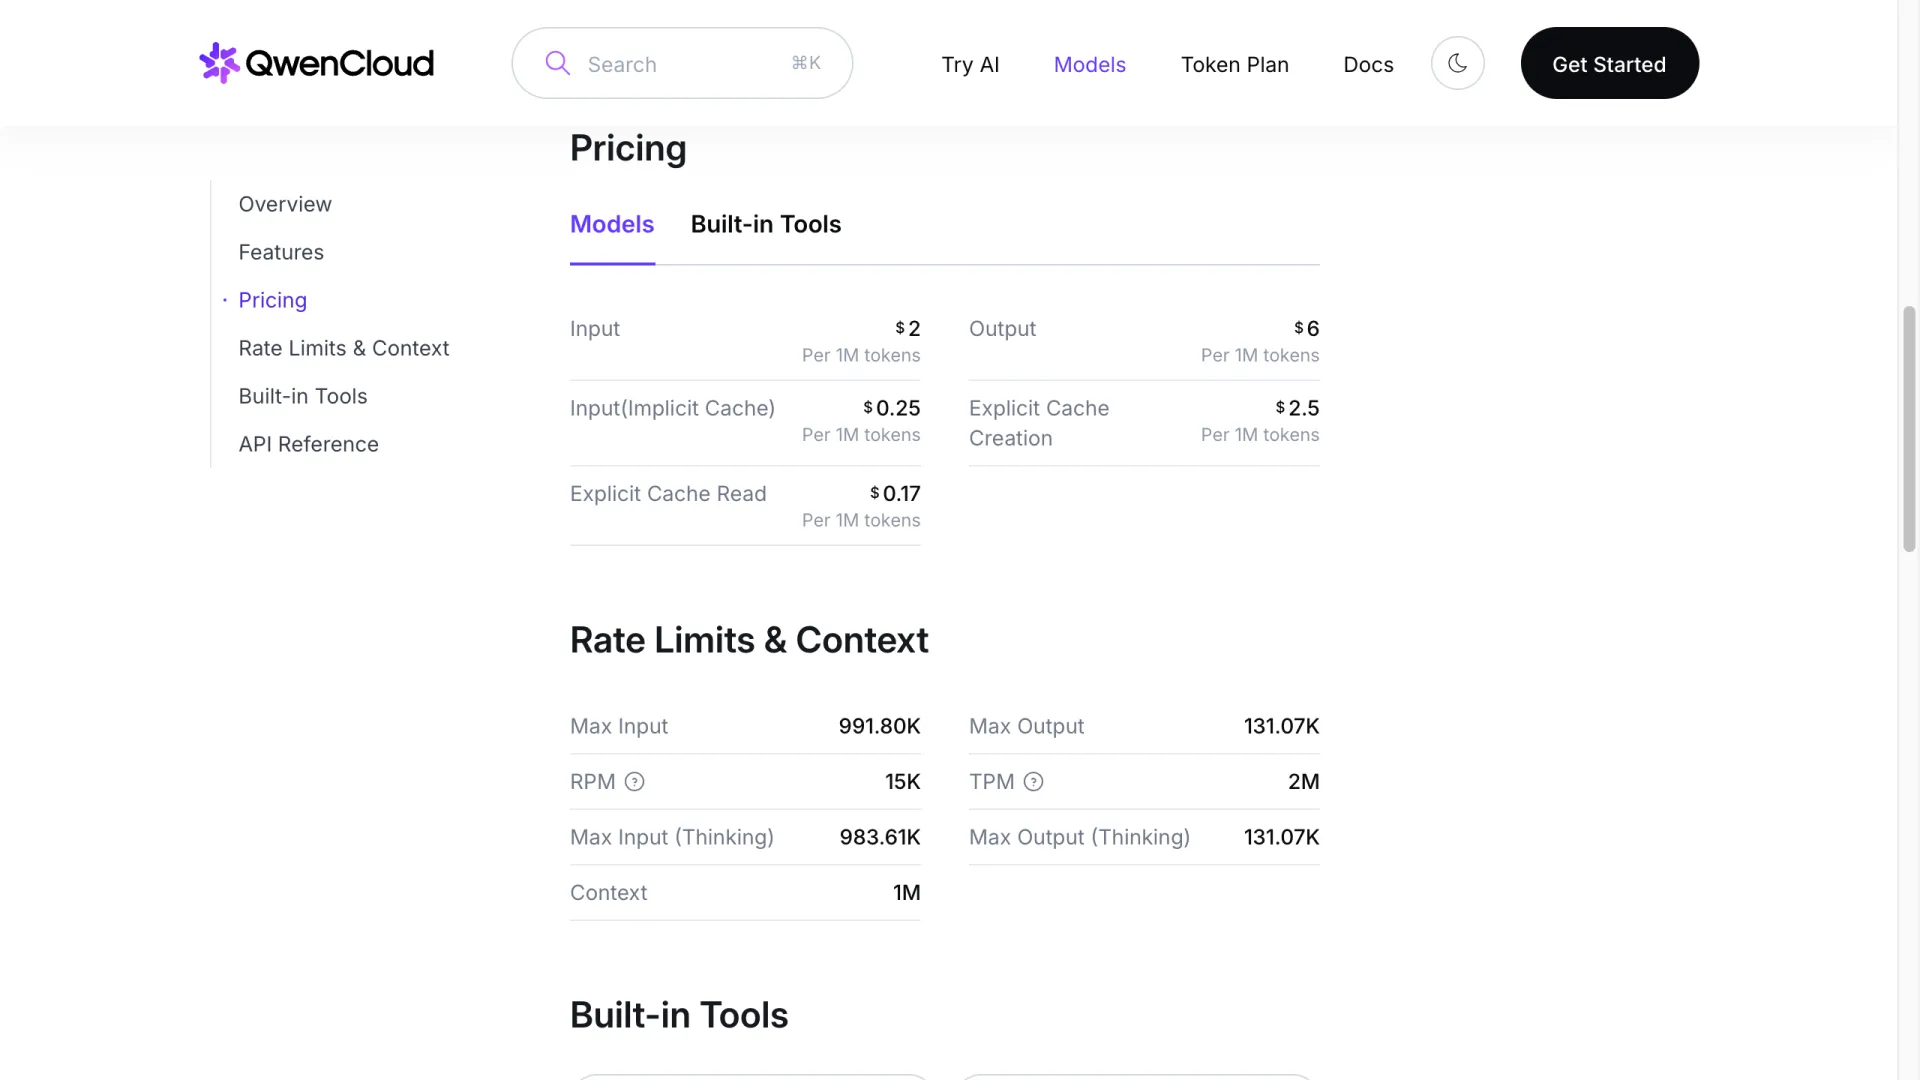
Le cache implicite ne demande aucune intégration particulière. Les préfixes répétés sont automatiquement facturés 0,25 $, soit un huitième du prix d’entrée standard. Le cache explicite, lui, implique un arbitrage : avec 2,50 $ à l’écriture et 0,17 $ à la lecture, il devient plus intéressant que l’entrée sans cache dès la deuxième lecture. En revanche, il ne bat le tarif implicite de 0,25 $ qu’autour de la trentième lecture d’un même préfixe. Dans la plupart des applications, mieux vaut donc s’en passer.
Une réserve importante : l’API est ouverte, mais pas les poids. Dans son billet de lancement, Alibaba indique que les poids de Qwen3.8-Max arriveront sur Hugging Face et ModelScope la semaine suivante. C’est le premier engagement daté après plusieurs semaines d’un « coming soon » sans date. Au 3 août, l’encadré latéral de la page du modèle affichait toujours Open Source: No.
Pourquoi 6 $ en sortie ne reflètent pas toujours le coût réel
La documentation de lancement d’Alibaba propose trois réglages pour reasoning_effort et place xhigh — le niveau le plus poussé — par défaut. Les deux autres sont medium, qui « équilibre précision et vitesse », et low, « optimisé pour la vitesse et le coût ». preserve_thinking est également activé par défaut dans tous les scénarios. Or les tokens de réflexion sont facturés comme des tokens de sortie : avant même d’avoir envoyé un prompt, ces deux réglages orientent donc la dépense vers le tarif de 6 $.
Les deux principaux leviers de coût sont donc configurés dans le mauvais sens à la sortie de boîte, alors qu’ils se changent avec un simple paramètre de requête. Passer à medium ou low, c’est éviter de payer 6 $ par million pour une réflexion approfondie dont votre tâche n’a peut-être pas besoin — et ne l’activer que lorsqu’elle se justifie.
Un premier testeur a résumé sans détour ce que lui apportait cette délibération, dans le titre d’un fil r/LocalLLaMA :
Qwen 3.8 max first impressions - model is moderate and it is awful on thinking
Il faut y voir une raison de tester chaque niveau d’effort sur votre propre charge de travail avant d’adopter le réglage par défaut, pas un résultat de benchmark.
Pas de surtaxe pour le long contexte : là où cela compte
La page de Qwen3.8-Max n’affiche qu’un tarif d’entrée et un tarif de sortie, sans aucune grille liée à la longueur du contexte. Gemini 3.1 Pro et GPT-5.6 Sol basculent tous deux vers une tarification plus élevée au-delà d’un seuil de contexte :
| Modèle | Entrée (contexte court) | Sortie (contexte court) | Entrée (contexte long) | Sortie (contexte long) |
|---|---|---|---|---|
| Qwen3.8-Max | 2,00 $ | 6,00 $ | 2,00 $ (jusqu’à 1M) | 6,00 $ (jusqu’à 1M) |
| Gemini 3.1 Pro | 2,00 $ (≤200K) | 12,00 $ | 4,00 $ (>200K) | 18,00 $ |
| GPT-5.6 Sol | 5,00 $ | 30,00 $ | 10,00 $ | 45,00 $ |
Gemini 3.1 Pro rejoint exactement Qwen3.8-Max à 2 $ en entrée jusqu’à 200K tokens, puis double son tarif. GPT-5.6 Sol double le prix d’entrée et augmente de moitié celui de sortie lorsqu’une requête entre dans sa tranche long contexte, malgré une grille déjà remaniée.
L’écart s’accroît donc avec la taille du contexte, au lieu de rester constant. Un prompt de 400K tokens coûte 0,80 $ en entrée sur Qwen3.8-Max, 1,60 $ sur Gemini 3.1 Pro et 4,00 $ sur GPT-5.6 Sol. C’est dans les pipelines documentaires, les longues sessions d’agents et l’analyse de dépôts entiers que la différence s’accumule. Sur de courts échanges conversationnels, elle pèse à peine.
Face aux modèles choisis par Alibaba pour la comparaison
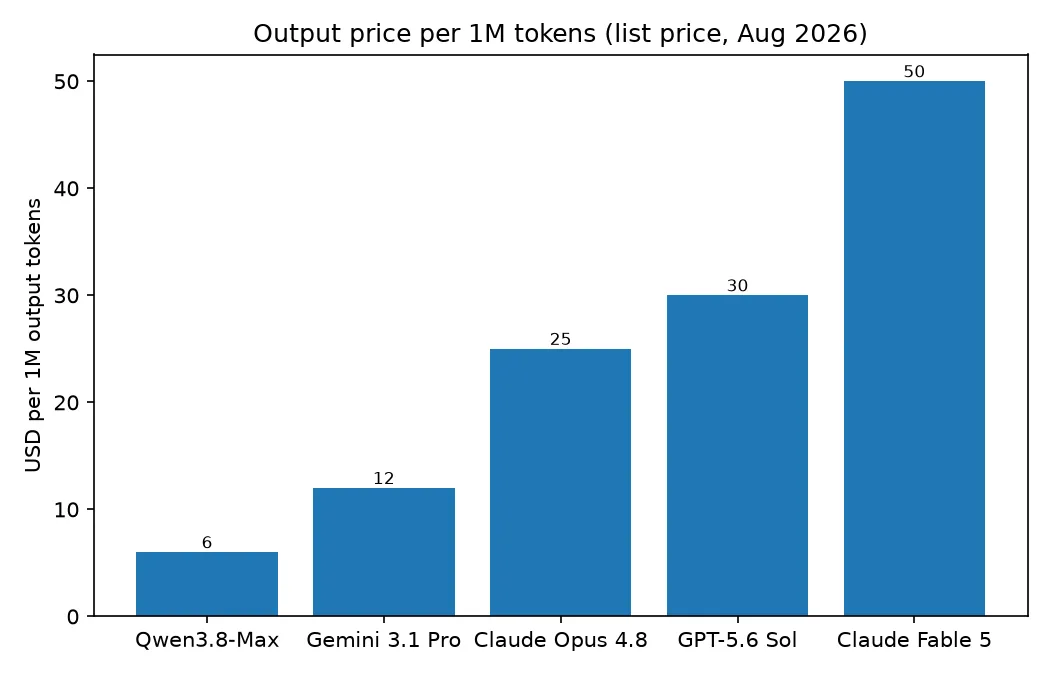
À 6 $ par million de tokens de sortie, Qwen3.8-Max coûte moins d’un quart des 25 $ de Claude Opus 4.8, et un cinquième des 30 $ de GPT-5.6 Sol. Claude Fable 5, à 50 $, dépasse son tarif de plus de huit fois. Reste à savoir si cet écart de prix vaut le compromis en capacités. Alibaba défend son modèle avec un tableau de 28 benchmarks :
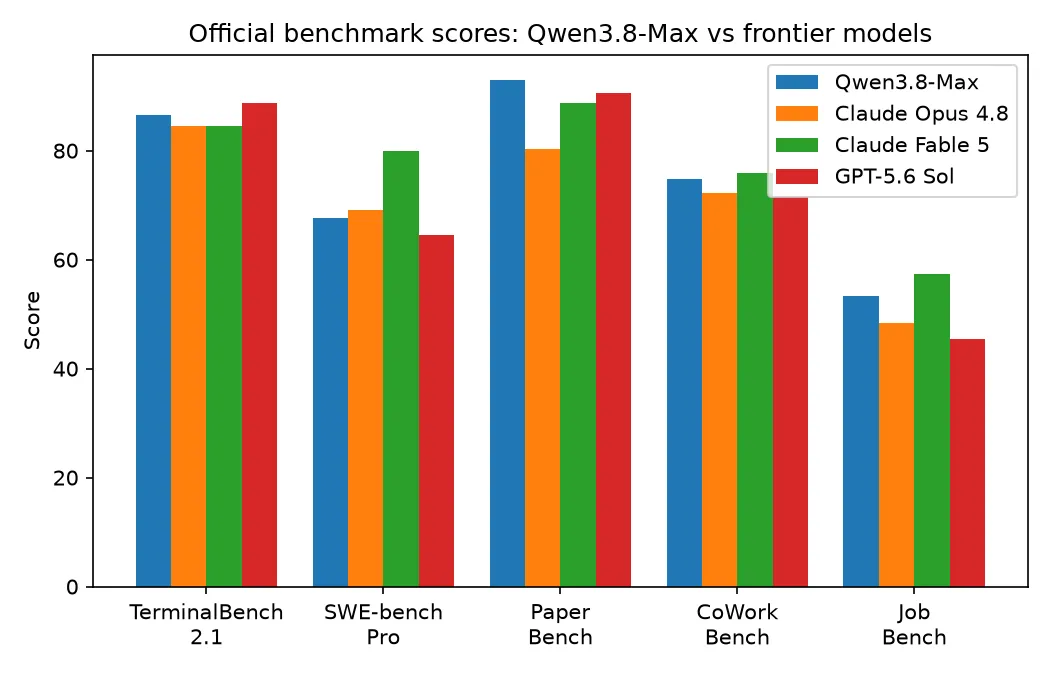
Qwen3.8-Max mène sur PaperBench avec 93,0, contre 90,5 pour GPT-5.6 Sol et 88,8 pour Fable 5 ; sur JobBench avec 53,4, face aux 48,4 d’Opus 4.8 ; et devance légèrement les deux modèles Claude sur Terminal Bench 2.1 avec 86,6. En revanche, il est largement battu sur SWE-bench Pro : les 80,0 de Fable 5 le distancent de plus de douze points, contre 67,7. Tous ces chiffres proviennent de benchmarks exécutés et publiés par le fournisseur sur cette même page.
Le choix se dessine assez nettement. Pour les tâches agentiques riches en sortie — longues boucles d’appels d’outils, génération de documents ou reproduction de recherche telle que mesurée par PaperBench — une remise de 4 à 8 fois sur la sortie transforme l’économie du produit. Pour l’ingénierie logicielle à l’échelle d’un dépôt, le type de tâche évalué par SWE-bench Pro, cette réduction s’accompagne d’une véritable perte de capacité : payer les tarifs de Fable 5 reste alors cohérent.
Tester cela sur vos propres charges est simple : le billet de lancement d’Alibaba documente des appels chat-completions et responses compatibles OpenAI, ainsi qu’une interface compatible Anthropic. Ce sont les deux mêmes formats de requête qu’acceptent Claude Opus 4.8 et GPT-5.6 Sol.
Les changements à faire dans votre code
L’identifiant du modèle est qwen3.8-max. Au 3 août, c’est la seule entrée 3.8 du catalogue de modèles d’Alibaba : l’identifiant de préversion qwen3.8-max-preview a disparu. Vérifiez donc votre fournisseur de relais avant de supposer qu’une remise de préversion a survécu au passage en disponibilité générale.
Les deux interfaces sont proposées depuis trois URL de base régionales : Pékin, Singapour et Virginie, aux États-Unis. Voici les plafonds que vous atteindrez en premier :
| Limite | Valeur |
|---|---|
| Fenêtre de contexte | 1M |
| Entrée maximale | 991,80K |
| Entrée maximale (thinking) | 983,61K |
| Sortie maximale | 131,07K |
| Requêtes par minute | 15K |
| Tokens par minute | 2M |
Notez l’écart d’environ 8K tokens entre les deux plafonds d’entrée : activer le raisonnement réduit votre marge de contexte en entrée, en plus d’ajouter des tokens de sortie. Si les poids arrivent bien la semaine suivante, le chiffre de 95 milliards de paramètres actifs sera le point de départ de toute comparaison entre l’auto-hébergement et le tarif de 2 $/6 $.
FAQ
L’API Qwen est-elle gratuite ?
Non. Qwen3.8-Max est facturé au token : 2 $ en entrée et 6 $ en sortie par million de tokens. L’abonnement Token Plan vendu sur la plateforme API d’Alibaba est un produit distinct, basé sur des crédits, et ne correspond pas à la facturation API au token.
Combien coûte Qwen Max ?
Pour la génération actuelle, le prix est de 2 $ par million de tokens d’entrée et 6 $ par million de tokens de sortie, avec un cache implicite des préfixes à 0,25 $. Les anciennes entrées qwen-max de la documentation Alibaba Cloud renvoient à des générations précédentes et appliquent d’autres tarifs.
Qwen3.8-Max facture-t-il un supplément pour sa fenêtre de contexte de 1M ?
Non. Les prix d’entrée et de sortie sont identiques pour 5K tokens comme pour 900K. C’est la différence structurelle la plus claire avec GPT-5.6 Sol et Gemini 3.1 Pro.
Qwen3.8-Max est-il moins cher que Qwen3.7-Max ?
Impossible de répondre à partir des pages officielles. La page du modèle Qwen3.7-Max affiche -- à la place des tarifs par token, derrière une mention de réduction de 50 %, sans donner de prix. Aucun chiffre publié ne permet donc la comparaison.
À lire aussi
- Tarifs de Claude Fable 5 : le niveau à 10 $/50 $ auquel ce modèle est comparé
- Réduire les coûts en tokens de Claude Fable 5 : les mêmes leviers d’effort et de cache chez un autre fournisseur