 AIREITER
Sur le papier, les deux API affichent le même tarif de 0,10 $ par million de tokens en entrée. En pratique, un document de règles répété peut coûter 520 $ chez l'un et 70 $ chez l'autre. OpenAI Decisions API est particulièrement adaptée aux historiques d'agents avec contexte récurrent, tandis que Gemini Decisions API prend l'avantage pour l'audio, la vidéo et les checklists allant jusqu'à 1 000 règles.
Le même tarif affiché, mais pas la même facture
OpenAI Decisions API et Gemini Decisions API facturent toutes deux 0,10 $ par million de tokens d'entrée non mis en cache, sans facturation des tokens de sortie. OpenAI Decisions API est devenue généralement disponible le 22 octobre 2026 avec le modèle gpt-6-luna, tandis que Gemini Decisions API a été lancée le 11 novembre 2026 en v1beta avec le modèle gemini-decision-1. Le meilleur prix dépend donc de la répétition et du type de données envoyées, pas du logo affiché.
| Critère | OpenAI Decisions API | Gemini Decisions API |
|---|---|---|
| Modèle | gpt-6-luna | gemini-decision-1 |
| Statut | GA depuis le 22 oct. 2026 (documentation OpenAI) | Preview v1beta depuis le 11 nov. 2026 (annonce Google) |
| Questions par requête | 1 à 400 (documentation OpenAI) | 1 à 1 000 (annonce Google) |
| Fenêtre de contexte | Multiplicateur 2x pour les contextes de plus de 272K tokens | 262 144 tokens |
| Entrées acceptées | Texte, images, input_json, conversations et appels d'outils | Texte, images, audio, vidéo et PDF |
| Facturation de la sortie | 0 $ | 0 $ |
| Entrée mise en cache | 0,01 $ par million de tokens, préfixe ≥1 024 tokens | Non pris en charge |
| Offre gratuite | Aucune offre gratuite séparée indiquée | Oui dans AI Studio, 200 RPM / 50K TPM / 10K RPD |
| Latence annoncée | Environ 10 fois plus rapide que Responses API | Calcul modèle de 50 à 100 ms, 150 à 250 ms de bout en bout jusqu'à 16K tokens |
| Entreprise | ZDR, HIPAA, régionalisation US/UE (+10 %) | Prise en charge Cloud à venir |
À quoi ressemble une requête en pratique
OpenAI Decisions API s'utilise avec POST /v1/decisions et un tableau ordonné de questions, chacune pouvant recevoir un name. Gemini Decisions API passe par client.decisions.create() et une map dont les clés sont des identifiants choisis par le développeur. Les deux services proposent trois types de questions, mais avec des noms et des limites différents.
Chez OpenAI, les types sont predicate (probabilité de 0 à 1), choice (catégories non ordonnées) et score (niveaux ordonnés de 2 à 10, avec moyenne pondérée par les probabilités), comme l'indique le guide OpenAI. Gemini propose noul (oui/non, probabilité de 0,01 à 0,99), choice (2 à 255 options) et score (2 à 255 niveaux, 2 à 10 recommandés), selon l'annonce Google. Les questions d'une même requête restent indépendantes dans les deux cas : pour enchaîner des règles, il faut passer par le code applicatif ou effectuer un second appel.
Trois pièges qui cassent les migrations
Gemini trie les clés de type choice par ordre alphabétique avant le scoring. Une option fourre-tout nommée none_of_the_above peut donc passer avant shipping (comportement documenté). OpenAI reprend le name de la question dans le tableau des réponses, alors que Gemini renvoie une map indexée par l'identifiant de la question. Enfin, noul ne renvoie jamais une valeur supérieure à 0,99 : un seuil >0.99 ne sera donc jamais atteint.
La gestion des refus diffère également. OpenAI peut renvoyer un refusal pour une question tout en répondant aux autres, d'après le guide OpenAI. Gemini rejette la requête entière avec une erreur HTTP 400 lorsqu'un déclencheur de sécurité ou de contenu interdit est détecté, avec des codes tels que safety et prohibited_content.
"Un détail assez étrange : Decisions et la génération de texte classique semblent utiliser des chemins distincts pour la mise en cache et l'inférence." — u/Balance- sur r/OpenAI
Si vous devez prendre en charge les deux endpoints, prévoyez un adaptateur minimal. Uniformisez les identifiants de questions, renommez les clés Gemini pour éviter les effets de tri alphabétique et limitez les seuils Gemini à ≤0,99.
Ce que chaque API accepte — et ce qu'elle vous oblige à construire
Gemini Decisions API accepte nativement le texte, les images, l'audio, la vidéo et les PDF dans une même entrée. OpenAI Decisions API accepte le texte, les images, input_json, l'historique des conversations, les appels de fonctions et les sorties d'outils, mais pas les fichiers ni l'audio. Cette différence détermine si les étapes de prétraitement disparaissent… ou deviennent votre problème.
Un enregistrement d'appel accompagné de métadonnées de compte peut être envoyé directement à Gemini, sans transcription. Même chose pour un PDF de sinistre numérisé accompagné de photos des dégâts, sans passer par l'OCR. À l'inverse, un historique d'agent avec appels d'outils s'intègre nativement à OpenAI grâce à la correspondance call_id, tandis que Gemini demande de l'aplatir en texte. OpenAI accepte aussi des images dans les instructions d'une question pour comparer un candidat à une référence.
Le décompte des tokens image varie selon le fournisseur. Lors d'un test indépendant (System Design Academy), une photo d'œuf de 224×224 a compté pour 523 tokens d'entrée chez OpenAI avec trois questions, contre une estimation de 390 tokens chez Gemini Low (257 tokens image), 663 en Medium et 1 223 en High, soit 0,039 $, 0,066 $ et 0,122 $ pour 1 000 photos.
Les chiffres de latence viennent des fournisseurs eux-mêmes. Google annonce 150 à 250 ms de bout en bout et une montée en charge presque plate de 1 à 100 questions jusqu'à 16K tokens. OpenAI annonce une vitesse environ 10 fois supérieure à celle de Responses API, sans fournir de valeur absolue. Les retours d'utilisateurs sont plus nuancés :
"La vitesse et le coût. Les résultats sont quasiment instantanés et coûtent une fraction du prix." — u/zyeus-guy sur r/OpenAI
J'ai testé Gemini Decision 1 avec l'offre gratuite : routage réussi 30 fois sur 30, médiane d'environ 0,24 s et répétitions déterministes. En revanche, le modèle a choisi avec assurance une mauvaise catégorie quand « autre » n'était pas proposée. — test pratique sur r/GeminiAI
Considérez donc la latence annoncée comme un plafond à vérifier lors de vos tests, pas comme une SLA de production.
Ce que coûtent vraiment 1 million de requêtes
Sur les deux API, les données partagées ne sont facturées qu'une fois par requête. Les questions supplémentaires n'ajoutent que leurs tokens d'instruction. L'écart apparaît lorsque les mêmes données sont répétées d'une requête à l'autre : OpenAI les met en cache, tandis que Gemini les refacture intégralement.
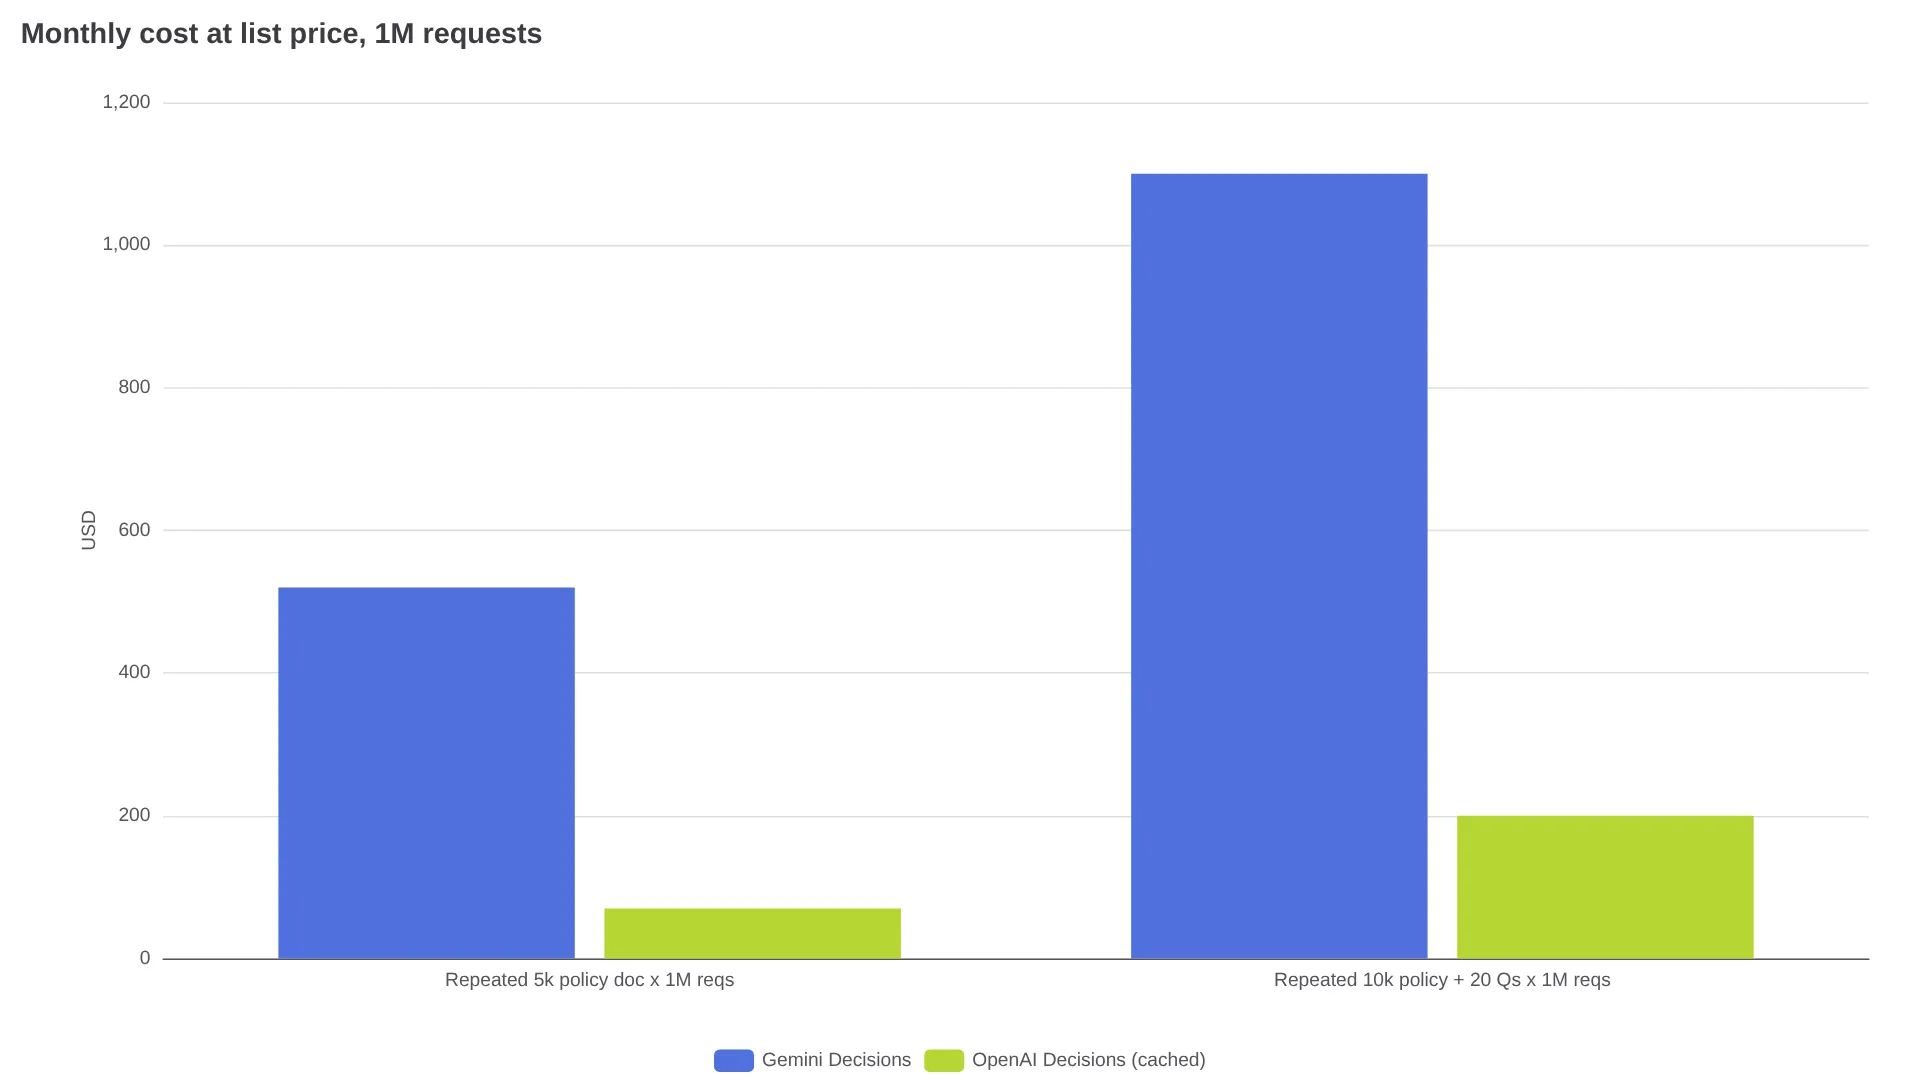
Ce calcul indicatif aux tarifs catalogue, basé sur le modèle publié par Apidog et BaristaLabs, suppose que les accès au cache OpenAI ont lieu avant les frais d'écriture :
- 1 million de tickets avec la même politique de 5 000 tokens et 200 tokens nouveaux : environ 520 $ avec Gemini, contre environ 70 $ avec OpenAI grâce au cache.
- 1 million de requêtes avec la même politique de 10 000 tokens et 20 questions d'environ 50 tokens : environ 1 100 $ avec Gemini, contre environ 200 $ avec OpenAI, hors écritures.
Avec des données fraîches et uniques, l'écart disparaît : un message de 400 tokens sans préfixe réutilisable bénéficie du même tarif de 0,10 $ par million de tokens chez les deux fournisseurs. Le regroupement des contrôles compte davantage que le choix du modèle : une requête contenant 20 vérifications sur un dossier de 4 000 tokens revient à environ 0,50 $ pour 1 000 dossiers, contre environ 8,10 $ pour 20 requêtes séparées.
Les longues conversations relues à chaque tour favorisent la mise en cache. Selon une modélisation, un routeur de 30 tours relisant 124 680 tokens coûte environ 12,47 $ pour 1 000 conversations avec Gemini Decision 1 sans cache, contre environ 6,31 $ avec un modèle conversationnel mis en cache.
Peut-on faire confiance au chiffre renvoyé ?
Dans le tableau publié par Google et résumé par AIToolsReview, Decision 1 devance Luna sur chaque test commun, avec une ECE top-1 de 0,0250 contre 0,0721 pour Luna et 0,0494 pour Jev 1.14. Sur le split public de JevBench, les scores sont de 92,2 % pour Decision 1, 90,9 % pour Luna et 90,0 % pour Jev 1.14. Le coût total de la suite s'élève à 0,88 $ pour Decision 1, 0,68 $ pour Jev et 0,93 $ pour Luna.
Une synthèse indépendante d'Artificial Analysis citée dans la même étude attribue à Decision 1 un Decision Index de 66, à égalité avec Jev 1.14, ce qui le place 9e sur 18, environ 7 points derrière Drex Max v1.1. Sur When2Call, les scores sont de 75,2 % pour Decision 1, 80,8 % pour Jev et 94,6 % pour Drex Max, pour un coût de 345 $ par million de tâches et 211 ms pour Decision 1, contre 156 $ et 92 ms pour Jev.
Pour automatiser des décisions par seuil, la calibration compte davantage que la précision affichée en gros titre. Une confiance de 0,90 devrait correspondre à environ 9 décisions correctes sur 10 dans la distribution de production. Validez vos seuils sur 200 à 500 cas annotés et mesurez la précision par tranche de confiance.
"Calibration : les probabilités calibrées façon Jev ne sont pas renvoyées par tous les endpoints compatibles avec OpenAI." — u/xapep sur r/LLMDevs
Deux erreurs reviennent régulièrement. Les premiers tests menés par des praticiens signalent un biais en faveur du premier choix chez OpenAI (@NatashaTheRobot), tandis que le test pratique de Gemini cité plus haut montre qu'en l'absence d'option fourre-tout, le modèle choisit l'option la moins mauvaise au lieu de s'abstenir. Dans les deux cas, ajoutez une option other, un prédicat séparé de vérification du périmètre, des descriptions courtes et bien distinctes, ainsi qu'une revue humaine sous le seuil.
La checklist avant le passage en production
OpenAI est en disponibilité générale, avec mise en cache, suivi de l'utilisation via GET /v1/organization/usage/decisions, ZDR et HIPAA pour les clients éligibles, ainsi qu'un traitement régional aux États-Unis et dans l'UE avec une majoration de 10 %. Gemini est en v1beta, avec la prise en charge Cloud annoncée pour bientôt. Les deux fournisseurs listent des intégrations avec des frameworks comme OpenRouter, LangChain, Vercel et LiteLLM.
Les règles de cache influencent directement l'architecture. OpenAI réutilise un préfixe d'entrée partagé d'au moins 1 024 tokens ; le contenu des questions ne compte pas dans ce minimum. Gemini ne propose ni mise en cache du contexte, ni niveaux Batch, Flex ou Priority. L'offre gratuite favorise le prototypage avec Gemini, mais son contenu peut servir à améliorer les produits Google : utilisez donc des données synthétiques et gardez les vraies données clients sur des clés payantes. Avant d'automatiser des actions sensibles, consignez la distribution des niveaux de confiance pendant une semaine.
Choisissez selon la charge, pas selon le logo
Pour une boucle d'agent avec appels d'outils et instructions répétées, OpenAI Decisions API s'impose naturellement. Les exigences de ZDR, HIPAA ou de résidence des données dans l'UE orientent également le choix dans cette direction.
En revanche, un enregistrement d'appel, une séquence vidéo ou un PDF numérisé accompagné de centaines de contrôles correspond mieux à Gemini Decisions API. La prise en charge native de l'audio, de la vidéo et des PDF supprime les étapes de transcription et d'OCR, tandis que les 1 000 questions par requête couvrent les listes de règles dépassant 400 éléments. Attention aux limites budgétaires : 100 MB en ligne par requête, 50 MB par PDF et 15 MB par URL externe.
Pour un texte court et unique avec moins de 400 questions, les deux solutions sont à égalité au tarif catalogue. Prototyp ez avec l'offre gratuite Gemini sur des données synthétiques, puis rejouez les mêmes 200 à 500 cas annotés sur les deux API. Comparez la précision par tranche, la latence p50/p95, le nombre de tokens par requête et le coût mensuel.
| Charge | Choix recommandé |
|---|---|
| Document de règles répété de 5K à 10K tokens, QPS élevé | OpenAI Decisions API, le cache économise 80 % ou plus |
| Routage d'agents avec historique d'appels d'outils, voix GPT-Live | OpenAI Decisions API |
| Décisions sur audio / vidéo / PDF, plus de 400 règles | Gemini Decisions API |
| Texte court et unique, moins de 400 questions | Égalité — choisissez la stack déjà en place |
| Prototypage gratuit | Gemini AI Studio, puis réévaluation sur une offre payante |
Gemini est-il moins cher qu'OpenAI ?
Au tarif catalogue, les deux sont à égalité : 0,10 $ par million de tokens, sans facturation de la sortie. OpenAI prend l'avantage avec un contexte répété mis en cache, tandis que Gemini est plus intéressant pour prototyper gratuitement.
OpenAI peut-il lire l'audio, la vidéo ou les PDF ?
Non. OpenAI accepte uniquement le texte, les images, le JSON et les conversations avec appels d'outils ; Gemini traite nativement l'audio, la vidéo et les PDF.
Combien de questions par requête ?
Gemini accepte de 1 à 1 000 questions dans une fenêtre de 262 144 tokens ; OpenAI en accepte de 1 à 400.
Gemini est-il prêt pour la production ?
Gemini est en v1beta et la prise en charge Cloud est encore attendue ; OpenAI est en disponibilité générale avec ZDR, HIPAA et traitement régional.
J'ai quand même besoin de Jev ou d'un classifieur local ?
Jev affiche un tarif de 0,042 $ par million de tokens et domine certains tests de sélection d'outils. Comparez-le aux deux autres lorsque le coût par tâche est le critère principal.
Que faire lorsque la confiance est faible ?
Définissez les seuils à partir de données annotées, automatisez au-dessus du seuil, envoyez la zone intermédiaire à un modèle plus puissant et confiez les blocages à un humain, en prévoyant toujours une option other.
À lire également :