 AIREITER
Google a lancé Gemini Decisions API le 11 novembre 2026. Son modèle Gemini Decision 1 évalue des choix prédéfinis en un seul passage. Mais pour savoir s’il est réellement plus intéressant qu’OpenAI, il faut surtout regarder les détails de la mise en cache et de la facturation.
Combien coûte un appel à Gemini Decisions API ?
Gemini Decisions API est facturé 0,10 $ par million de tokens d’entrée, sans aucun token de sortie facturé. Le bloc multimodal partagé n’est comptabilisé qu’une fois par requête, quel que soit le nombre de questions évaluées. Chaque question supplémentaire n’ajoute donc que ses propres instructions et critères.
Google présente Gemini Decision 1 comme presque cinq fois moins cher, sur une suite de benchmarks commune, que Gemini 3.5 Flash-Lite utilisé avec l’Interactions API. Il n’y a ni coût lié aux tokens de sortie, ni facturation variable des tokens de réflexion, ni frais séparés pour la transcription audio ou l’OCR. Pour les prototypes, Google AI Studio propose également un niveau d’utilisation gratuit.
| Cas d’usage (500 tokens d’entrée facturés par requête) | Requêtes mensuelles | Tokens d’entrée | Coût à 0,10 $/1 M |
|---|---|---|---|
| Routage des demandes au support | 10 000 | 5 M | 0,50 $ |
| Filtre de modération | 100 000 | 50 M | 5,00 $ |
| Sélection des outils d’un agent | 1 000 000 | 500 M | 50,00 $ |
La formule est la suivante : requêtes x tokens d’entrée moyens facturés / 1 000 000 x 0,10 $. Comme les éléments de preuve partagés ne sont facturés qu’une seule fois, regrouper 50 contrôles indépendants sur un même ticket dans une seule requête n’ajoute que les tokens propres à chaque question. L’économie vient donc du regroupement des évaluations, pas d’une remise appliquée à chaque question.
Ce que Gemini Decision 1 sait évaluer
Gemini Decision 1 (identifiant de modèle gemini-decision-1) est un classifieur et un moteur de scoring spécialisés, pas un modèle conversationnel. Une requête peut contenir un seul bloc multimodal partagé de 256 K tokens maximum ainsi que 1 000 questions indépendantes. Chaque réponse fournit des probabilités et un score de confiance compris entre 0 et 1.
Les entrées acceptées couvrent le texte, les images, l’audio, la vidéo et les PDF dans un même bloc partagé, avec le même format Content block que l’Interactions API. La résolution des images et des vidéos peut être ajustée : réduire les éléments de preuve avant leur envoi permet donc de maîtriser directement le coût en tokens. Les trois types de questions peuvent être combinés dans un même appel :
| Type | Format | Résultat | Cas d’usage adapté |
|---|---|---|---|
noul (oui/non) | Une condition, avec descriptions facultatives du vrai et du faux | Probabilité que la condition soit remplie | Contrôles de conformité, détection de déversements, filtres de pertinence |
choice (choix multiple) | De 2 à 255 options nommées, avec critères | Option gagnante et probabilités normalisées pour chaque candidate | Routage vers un modèle ou une file, sélection de l’action suivante |
score (barème ordonné) | Niveaux ordonnés commençant à 0 | Score pondéré continu et probabilités par niveau | Gravité, urgence, qualité d’un prospect |
Google annonce un temps de calcul médian de 50 à 100 ms et une latence de bout en bout de 150 à 250 ms, mesurés sur des entrées multimodales et des contextes allant jusqu’à 16 K tokens. Selon Google, la latence resterait presque stable avec 1 à 100 questions par requête. Sur des benchmarks couvrant le routage d’agents, le raisonnement, le classement et la compréhension multimodale, l’entreprise affirme aussi que Gemini Decision 1 arrive en tête avec la meilleure calibration. Dans les deux cas, il s’agit de résultats communiqués par le fournisseur, à prendre comme tels tant que des mesures indépendantes ne sont pas disponibles.
Gemini contre OpenAI Decisions API
La comparaison la plus directe est l’API Decisions d’OpenAI, lancée quelques semaines plus tôt au même tarif affiché. Gemini Decisions API s’aligne sur OpenAI avec un prix de 0,10 $ par million de tokens d’entrée et des sorties typées gratuites, mais les deux services divergent sur la capacité, les formats pris en charge et la mise en cache.
| Critère | Gemini Decisions API | OpenAI Decisions API |
|---|---|---|
| Modèle | gemini-decision-1 | Classe gpt-6-luna |
| Tarif affiché | 0,10 $ / 1 M en entrée, 0 $ en sortie | 0,10 $ / 1 M en entrée, 0 $ en sortie |
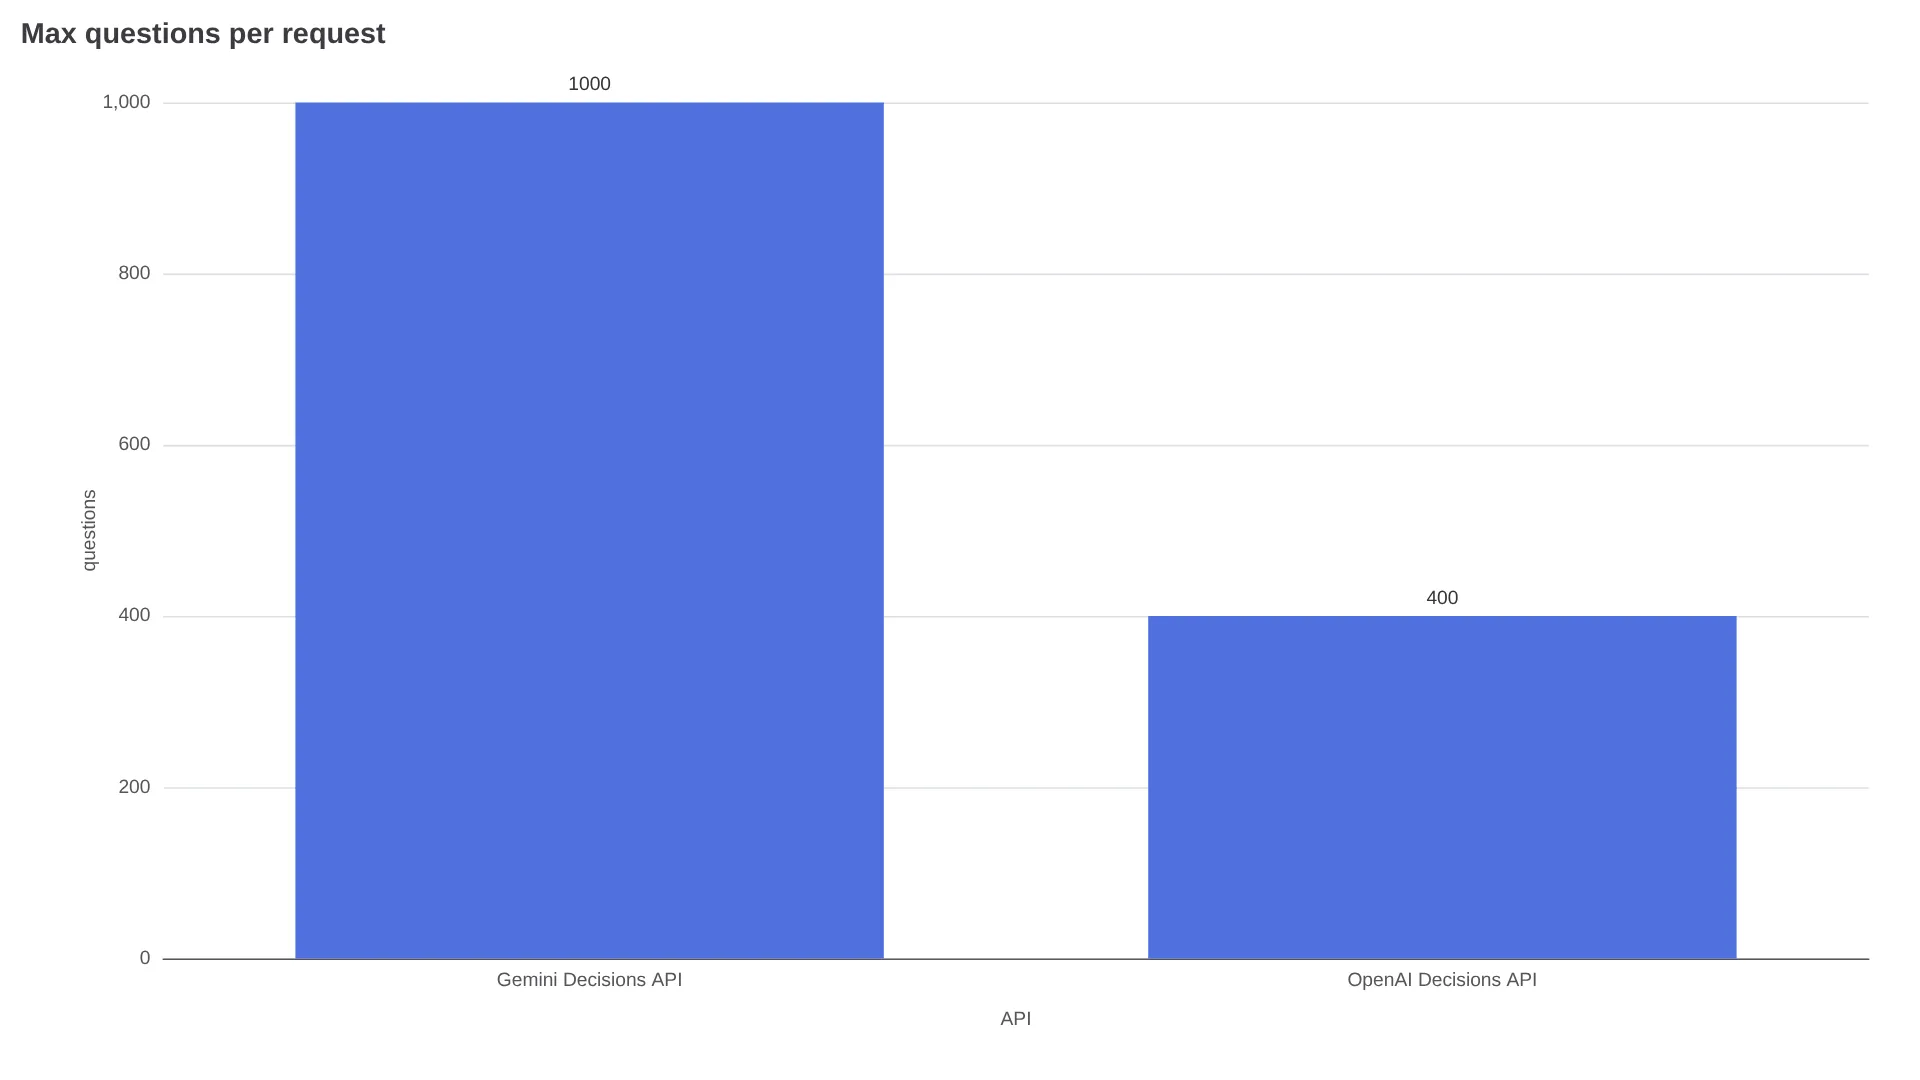
| Nombre maximal de questions par requête | 1 000 | 400 |
| Types de questions | oui/non, choix (2 à 255), score par barème | prédicat, choix, score (2 à 10 niveaux) |
| Modalités d’entrée | Texte, images, audio, vidéo, PDF (contexte de 256 K) | Texte, images (URL, base64), JSON natif, historique de conversation, sorties d’outils ; pas d’audio ni de fichiers |
| Promesse de latence | 150 à 250 ms de bout en bout, 50 à 100 ms de calcul modèle | Environ 10 fois plus rapide que Responses (aucun p50/p95 publié) |
| Mise en cache des prompts | Non annoncée dans le billet de lancement | Oui : préfixe minimal de 1 024 tokens, 0,01 $/1 M de lectures en cache |
| Offre gratuite | Oui, niveau gratuit dans AI Studio | Aucune offre gratuite dédiée documentée |
| Suivi de l’utilisation | Utilisation standard de l’API Gemini | GET /v1/organization/usage/decisions avec une clé administrateur |
Les données de la colonne Gemini proviennent du billet de lancement de Google. Celles d’OpenAI sont tirées du guide des tarifs d’OpenAI Decisions API publié par AIReiter, qui s’appuie sur la documentation officielle d’OpenAI.
Ce tableau permet de retenir trois éléments concrets.
- Choisissez Gemini Decisions API si vos éléments de preuve sont multimodaux. Associer un enregistrement d’appel à des métadonnées de compte, ou un PDF de déclaration numérisé à des photos de dégâts, est possible en un seul passage. Avec OpenAI, il faudrait généralement prévoir plusieurs étapes de prétraitement.
- Privilégiez-le pour les traitements à grande échelle. Avec 1 000 questions indépendantes par requête contre 400, un même ticket peut couvrir l’intention liée à un remboursement, le routage vers un service, l’évaluation de l’urgence et des dizaines de prédicats de conformité, sans second aller-retour.
- OpenAI conserve un avantage pour les politiques longues et répétées. La mise en cache des préfixes ramène le coût à 0,01 $/1 M, ce qui compte lorsque chaque requête renvoie un document de politique de 5 000 tokens et seulement quelques questions.
Quelle place pour Gemini Decisions API en production ?
Google indique utiliser ce point d’accès dans Notebook pour le routage, Stitch pour les wireframes, CC pour la sélection d’emojis et Search pour la sécurité MCP, selon l’annonce de lancement. Le principe reste le même : un bloc de preuves partagé, de nombreuses options encadrées, puis un routage applicatif basé sur la confiance renvoyée. C’est aussi la raison pour laquelle un ingénieur recommande la prudence :
« Le faible coût n’est pas le vrai sujet : c’est la réduction de l’espace des sorties qui compte. La confiance ne garantit pas l’exactitude. Calibrez donc le système sur de vrais échantillons métier et définissez des seuils d’abstention avant la mise en production. » — @david1989_zhu (traduit du chinois)
Constituez un jeu de données annoté à partir du trafic réel, en y incluant les cas ambigus. Mesurez ensuite les taux de faux positifs et de faux négatifs selon les différents seuils, et prévoyez explicitement une voie d’abstention vers une revue humaine pour les résultats peu fiables. Les tâches qui sortent de ce cadre — extraction ouverte, génération d’explications ou appels d’outils nécessitant des arguments — restent du ressort de l’Interactions API, de la Responses API ou du function calling.
Appeler Gemini Decision 1
Le point d’accès est disponible via la Gemini API dans Google AI Studio, avec le modèle gemini-decision-1 et client.decisions.create dans les SDK google-genai. Des guides Python, JavaScript et REST sont proposés dans la documentation de Decisions API. L’exemple officiel du comptoir de salle de pause confronte une photo et une note textuelle aux trois types de questions en une seule requête :
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})

result = client.decisions.create(
    model="gemini-decision-1",
    input=[
        {"type": "image", "uri": "https://storage.googleapis.com/generativeai-downloads/images/spill.jpg", "mime_type": "image/jpeg"},
        {"type": "text", "text": "Breakroom counter check before the 9 AM client meeting."},
    ],
    questions={
        "has_spill": {"type": "noul", "instructions": "Is there an uncleaned liquid spill on the counter?"},
        "next_action": {"type": "choice", "instructions": "Which cleanup action fits the scene?",
            "criteria": {"wipe_with_cloth": "Small counter spill with cloth nearby.",
                         "dispatch_janitorial": "Large floor hazard, broken glass, or active leak.",
                         "ready_for_meeting": "Counter is clean and ready."}},
        "severity": {"type": "score", "instructions": "Rate the severity of the counter mess.",
            "criteria": ["Clean and ready.", "Minor localized spill.", "Major spill or safety hazard."]},
    },
)
print(result)
Google annonce des intégrations avec OpenRouter, LangChain, Vercel, LiteLLM, Pydantic AI, Pipecat, LiveKit et OpenCode, tandis que la prise en charge de Google Cloud arrivera prochainement. Si votre application repose déjà sur le point d’accès d’OpenAI, la stratégie de migration est assez claire : commencez par les contrôles multimodaux et les traitements à grande échelle, conservez les traitements fondés sur de longues politiques mises en cache là où les remises s’appliquent, puis recalibrez tous les seuils depuis zéro. Les niveaux de confiance ne sont pas directement comparables entre fournisseurs.
| Votre cas d’usage | API à utiliser |
|---|---|
| Classer, router ou noter avec des options prédéfinies | Gemini Decisions API |
| Les éléments de preuve incluent de l’audio, de la vidéo ou des PDF | Gemini Decisions API |
| Plus de 400 contrôles indépendants par élément | Gemini Decisions API |
| Une politique longue est renvoyée à chaque appel | Tester d’abord les lectures en cache d’OpenAI |
| Besoin d’explications, d’extraction ou d’arguments pour un outil | Interactions / Responses / function calling |
| Action destructive ou soumise à des exigences de conformité | Decisions uniquement comme filtre, avec revue humaine |
Gemini Decisions API propose-t-elle une offre gratuite ?
Oui. Un niveau gratuit dans Google AI Studio permet de réaliser des prototypes.
Gemini Decisions API prend-elle en charge la mise en cache des prompts ?
Aucune option de mise en cache n’apparaît dans le billet de lancement au 12 novembre 2026.
Combien de questions peut-on inclure dans une requête Gemini Decisions API ?
Jusqu’à 1 000 questions indépendantes sur une même entrée partagée de 256 K tokens maximum.
Quelle latence prévoir en production ?
Prévoyez 250 ms de bout en bout tant que vous n’avez pas mesuré votre propre p95 régional.
L’Interactions API reste-t-elle nécessaire ?
Oui, pour composer du texte, extraire des champs arbitraires, expliquer des décisions ou produire les arguments d’un outil.