 AIREITER
ERNIE 5.5 Flash Preview est déjà accessible via API, mais Baidu précise que le post-entraînement n’est pas terminé et que la version finale pourrait se comporter différemment. Cette réserve est essentielle pour interpréter les démonstrations de programmation sur 11 heures, les 20 lignes de benchmarks et la promesse d’une publication des poids le 25 novembre.
Une preview, pas encore un lancement : ce que Baidu a publié le 11 novembre
ERNIE 5.5 Flash Preview est un checkpoint intermédiaire de post-entraînement, et non une version finale. Baidu a publié ERNIE 5.5 Flash Base le 5 novembre 2026 sous la forme d’un checkpoint de pré-entraînement brut (annonce de Base), puis la Preview le 11 novembre. Il s’agit de la première version post-entraînée à partir de ce Base, d’autres améliorations étant prévues avant la sortie officielle.
Le modèle repose sur une architecture sparse mixture-of-experts, avec 280 milliards de paramètres au total et 14 milliards de paramètres actifs par token. Le contexte annoncé est d’1 million de tokens ; une analyse de l’endpoint détaille les limites Qianfan : 1 024 000 tokens, dont 921 600 au maximum pour la sortie. Baidu revendique plus de 200 tokens par seconde et par utilisateur sur Qianfan (publication officielle).
Aucun dépôt Preview n’était disponible sur Hugging Face au 11 novembre ; la plateforme ne proposait que ERNIE-5.5-Flash-Base et sa variante BF16, publiées le 21 octobre. Le comportement de l’API, le tokenizer, le runtime et les tarifs actuels pourraient donc différer des poids téléchargeables après le 25 novembre.
Appeler ERNIE 5.5 Flash Preview dès aujourd’hui : Qianfan et OpenRouter
ERNIE 5.5 Flash Preview est accessible via Qianfan, la plateforme de Baidu, et OpenRouter. Qianfan utilise l’identifiant officiel ernie-5.5-flash-preview dans les rubriques génération de texte et raisonnement approfondi ; OpenRouter le référence sous le nom baidu/ernie-5.5-flash-preview.
La liste des modèles Qianfan (document du 10 novembre) indique un contexte, une entrée et une sortie d’1 million de tokens, avec des limites par défaut de 60 RPM et 1 000 000 TPM. En mode raisonnement approfondi, la limite de sortie d’1 million de tokens inclut la chaîne de réflexion. D’après la documentation de Baidu, le modèle est uniquement textuel ; les éléments visuels utilisés dans le banc de test de Baidu passent par un outil propulsé par Claude Opus 5.5 (analyse). Le raisonnement fonctionne à un niveau d’effort élevé fixe, sans possibilité de le désactiver (même analyse) : chaque appel consomme donc des tokens de raisonnement.
from openai import OpenAI
# OpenRouter path (verified model ID)
or_client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key="OPENROUTER_KEY")
or_client.chat.completions.create(
    model="baidu/ernie-5.5-flash-preview",
    messages=[{"role": "user", "content": "Summarize this 80-page supplier contract as a table."}],
    max_tokens=4000,
)
# Qianfan path (illustrative; copy base URL + key from Qianfan console, model ernie-5.5-flash-preview)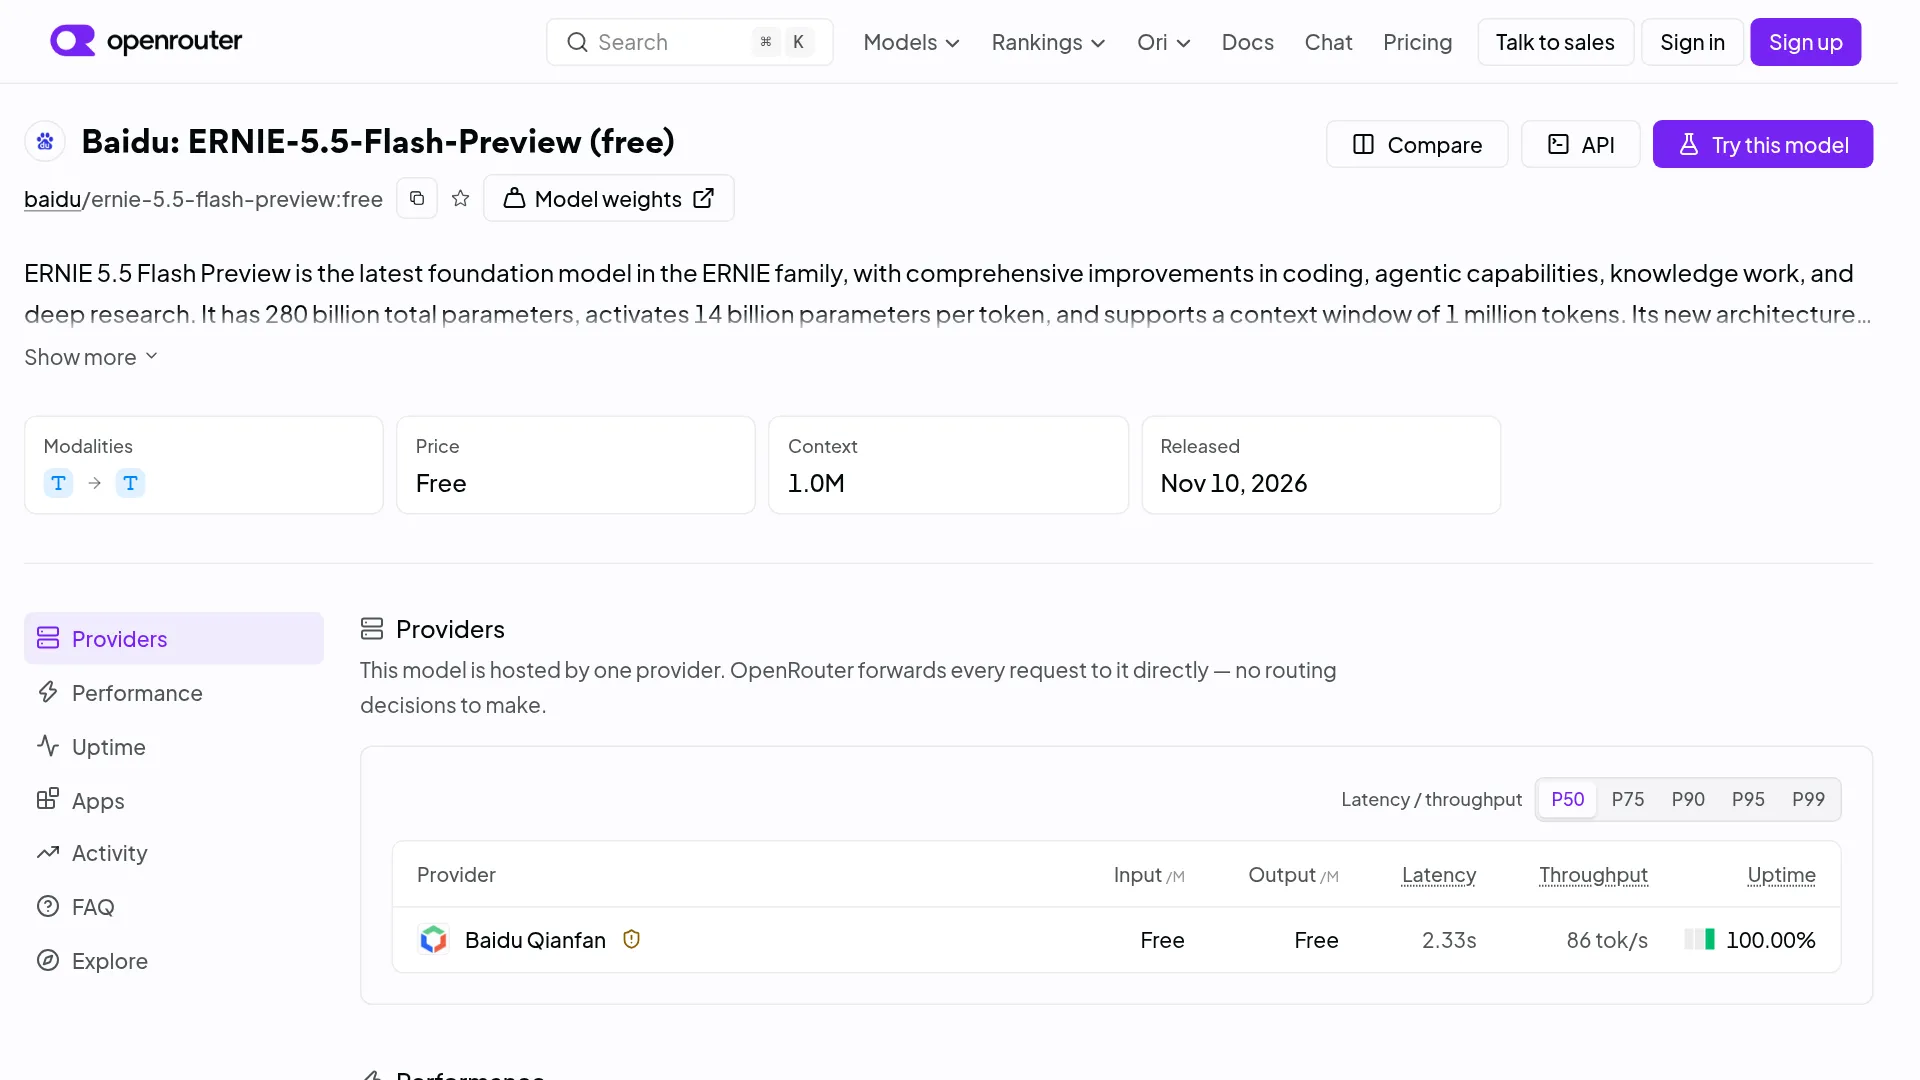
Combien coûte une longue session d’agent sur Qianfan et OpenRouter ?
Qianfan facture à l’usage, en yuans par millier de tokens. OpenRouter applique 0,28 $ par million de tokens en entrée et 1,13 $ en sortie, avec 0,028 $ pour les lectures en cache. Aux heures de pointe (8:00-22:00), les tarifs affichés sont de 0,001 / 0,002 yuan en entrée, 0,0001 / 0,0002 yuan pour le cache et 0,004 / 0,008 yuan en sortie par millier de tokens (tarifs Qianfan, document du 10 novembre). Les heures creuses divisent chaque montant par deux ; aucun fuseau horaire ni date de fin de la promotion n’est précisé.
| Accès | Entrée | Sortie | Cache | Remarques |
|---|---|---|---|---|
| Qianfan, promotion heures de pointe (8:00-22:00) | 1,00 yuan/M | 4,00 yuans/M | 0,10 yuan/M | À l’usage, document du 10-11-2026 |
| Qianfan, promotion heures creuses (22:00-8:00) | 0,50 yuan/M | 2,00 yuans/M | 0,05 yuan/M | Même document, fuseau horaire non précisé |
| Qianfan, tarif standard heures de pointe | 2,00 yuans/M | 8,00 yuans/M | 0,20 yuan/M | Tarif de secours hors promotion |
| OpenRouter | 0,28 $/M | 1,13 $/M | 0,028 $/M | baidu/ernie-5.5-flash-preview |
La formule est simple : tokens d’entrée × tarif d’entrée + (tokens de sortie + tokens de raisonnement) × tarif de sortie. Au tarif standard d’OpenRouter, 500 000 tokens en entrée coûtent environ 0,14 $, tandis que 500 000 tokens de sortie et de raisonnement reviennent à environ 0,57 $. Mesurez les tokens de raisonnement pour chaque tâche avant de fixer un budget par exécution, et programmez les traitements en volume pendant les heures creuses de Qianfan.
20 benchmarks revendiqués par Baidu, quatre démonstrations et un classement en milieu de tableau
Baidu a publié 20 lignes de benchmarks ainsi que quatre démonstrations. Tous les chiffres viennent de Baidu et n’ont pas été reproduits ; je n’ai trouvé aucun résultat indépendant concernant la Preview dans les listes d’Artificial Analysis citées par les articles de lancement (OrcaRouter, HandyAI). Il faut donc y voir une fiche de revendications du fournisseur, pas un classement de référence.
Voici sept lignes sélectionnées dans le tableau de 20 résultats de Baidu (chiffres fournis par Baidu sauf mention contraire) :
| Benchmark | ERNIE 5.5 Flash Preview | Meilleur concurrent dans le tableau de Baidu |
|---|---|---|
| Terminal-Bench 4.0 | 46.5 | Claude Opus 5.5 63.6-66.4 (graphique contre nouvelle exécution du tableau) |
| DeepSWE v1.1 | 71.2 | DeepSeek V4.1 Flash 77.0 |
| AutomationBench | 61.9 | DeepSeek V4.1 Flash 60.5, Hy4 56.2 : ERNIE en tête |
| SpreadsheetBench V2 | 36.4 | Claude Opus 5.5 35.1, GPT-6.1 Sol 32.0 : ERNIE en tête |
| OfficeQA Pro V2 | 67.9 | GPT-6.1 Sol 70.0 : ERNIE accuse un retard de 2.1 |
| APEX-Agents 1.1 | 64.2 | Hy4 77.6, Claude Opus 5.5 73.5 : ERNIE est derrière |
| DRACO | 84.9 | Hy4 90.7, Claude Opus 5.5 87.4 : ERNIE reste dans le milieu du classement |
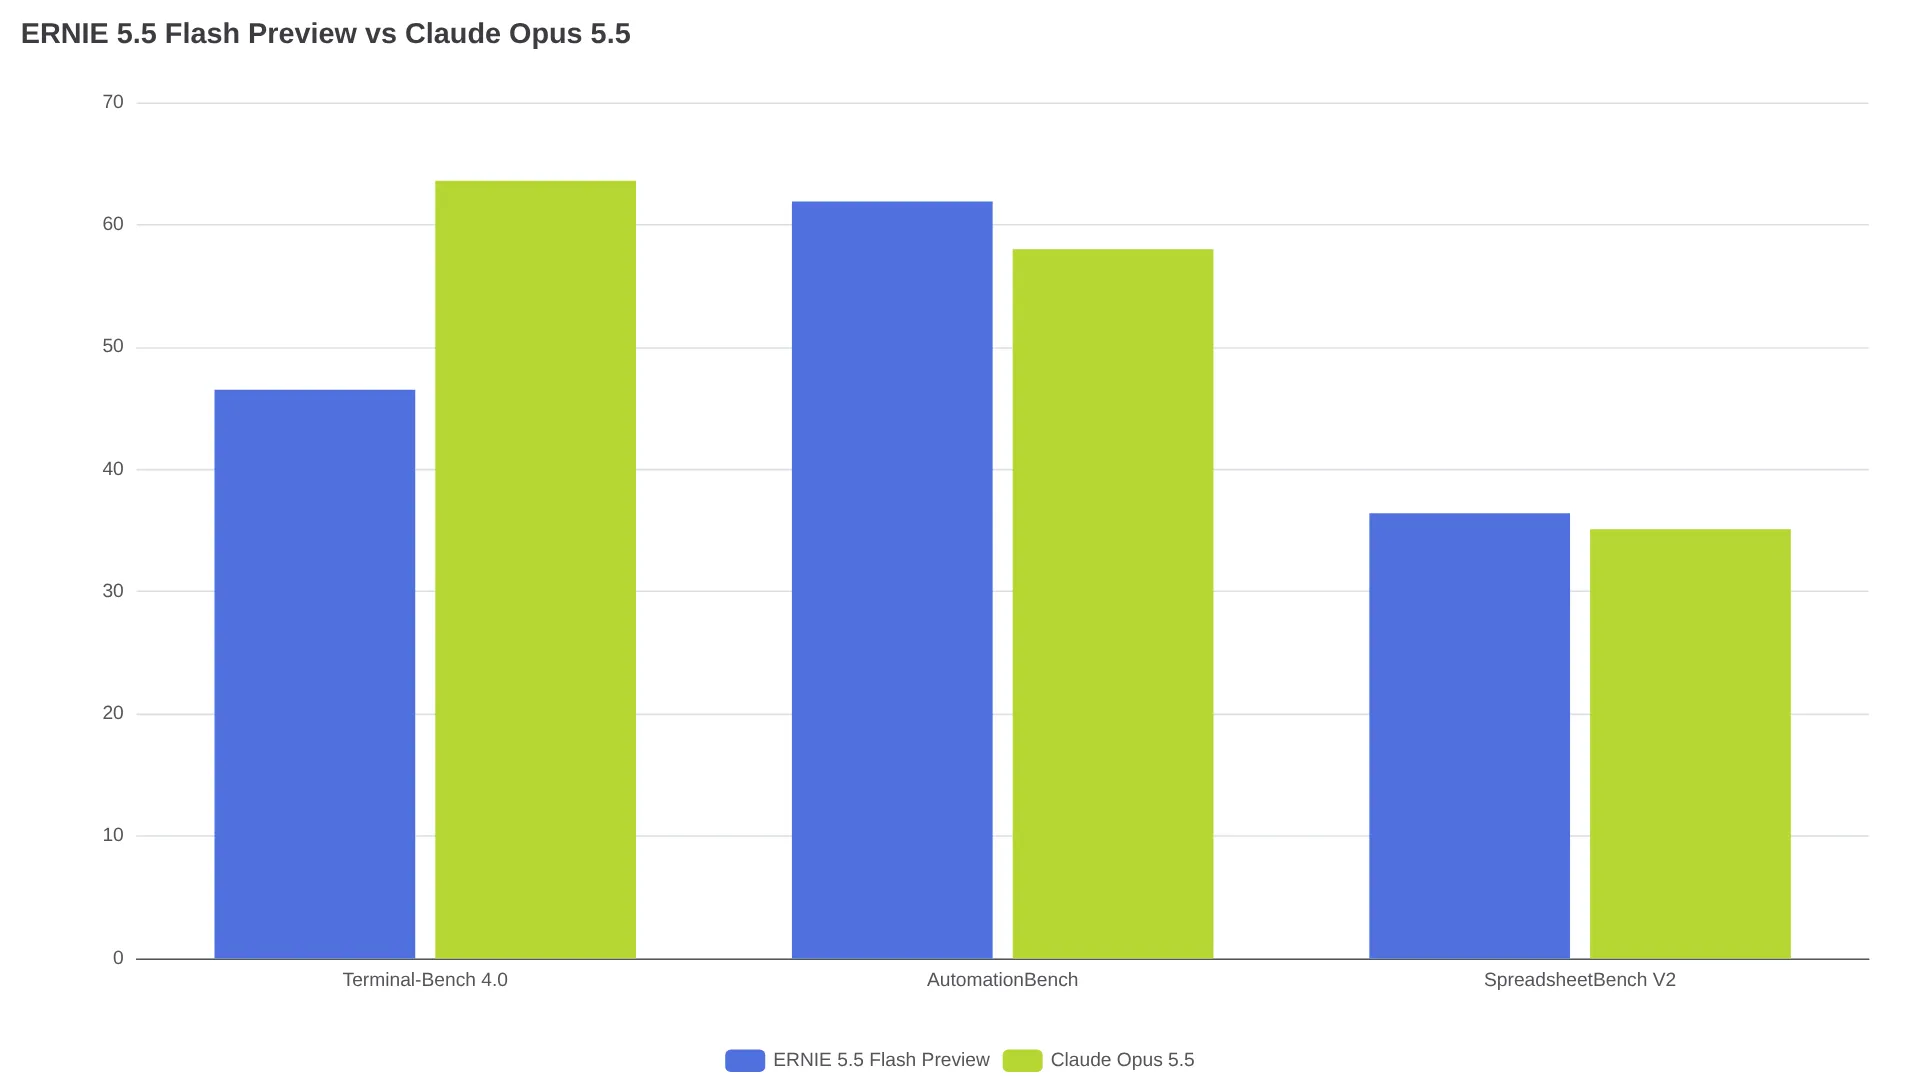
Plusieurs éléments invitent à relativiser ces résultats : les lignes marquées d’un astérisque correspondent à des évaluations réalisées par Baidu lui-même ; les deux lignes « AA » utilisent les bancs de test d’Artificial Analysis, mais avec des exécutions effectuées par Baidu (analyse) ; les tests visuels s’appuient sur un outil propulsé par Claude ; enfin, une vérification indépendante a constaté que les nouvelles exécutions de Baidu pour ses concurrents sur AutomationBench dépassaient de plus de 15 points les chiffres publiés (HandyAI). L’annexe, fournie sous forme d’image, empêche par ailleurs tout audit sérieux.
Les démonstrations de Baidu mettent en avant l’endurance du modèle sur quatre fronts (chiffres fournis par Baidu) : une production wuxia sous Unreal Engine 5.8 pendant 11 heures, accompagnée d’environ 100 mini-jeux mobiles ; des scènes et modèles dans Blender, dont un aéroport et le complexe de Hōryū-ji (environ 2 100 objets, 1,82 million de triangles), ainsi que des pièces dans FreeCAD ; des rapports de recherche de 20 et 24 pages, un tableur Monte Carlo et un fichier WAV orchestral de 6m34s ; enfin, un court-métrage de 116 secondes consacré à un pélican, décliné dans 20 styles au moyen de plus de 10 000 lignes de Python.
Les agrégations tierces placent la Preview dans le milieu du classement : Handy AI lui attribue 67.8 points (17e au classement général) et 69.1 points (6e sur 57 modèles à poids ouverts), derrière Kimi K3.1 Pro (94.4), Hy4 (73.9) et DeepSeek V4.1 Flash 1017 (71.9).
« Le nouveau modèle de Baidu n’est pas le sujet principal. C’est la licence. ... Si Apache 2.0 se confirme, ce sera un vrai changement. » — @thestonyground, publication sur X
Poids, licence et exécution en local : la promesse du 25 novembre et ses ambiguïtés
Les poids sont promis, mais pas encore publiés. L’annonce en anglais évoque une licence Apache 2.0 prochaine ; l’annonce en chinois parle d’une publication avant le 25 novembre sans mentionner de licence.
Flash Base a été publié sous une licence restrictive excluant l’Union européenne, le Royaume-Uni et la Corée du Sud, avec des obligations d’attribution (dépôt, analyse). Les équipes présentes dans ces régions ont intérêt à attendre les conditions applicables à la Preview noir sur blanc.
Je n’ai trouvé ni fichier GGUF, ni tableau de quantification, ni chiffre officiel concernant la VRAM pour la Preview. Le nombre de paramètres actifs ne correspond pas à la mémoire réellement occupée : 280 milliards de paramètres en 4 bits représentent environ 140 Go avant surcharge. Une configuration avec 32 Go de VRAM implique donc un déport important vers le CPU. Le fil r/LocalLLaMA avance seulement une estimation communautaire approximative de 32 Go de VRAM et 128 Go de RAM, tout en doutant que les 200 tokens par seconde correspondent aux performances d’une machine grand public en batch 1. N’achetez pas de matériel avant le 25 novembre.
Faut-il bâtir un produit sur la Preview cette semaine ?
La Preview mérite des essais pilotes à faible coût sur de longs contextes ; pour tout usage critique, mieux vaut attendre la version finale. Les premiers cas à tester au vu des chiffres non reproduits de Baidu sont l’édition de feuilles de calcul, les questions-réponses sur des fichiers bureautiques et les traitements d’automatisation.
| Situation | À faire |
|---|---|
| Traitements de type Spreadsheet / OfficeQA / AutomationBench | Testez l’API dès maintenant ; les heures creuses de Qianfan ou OpenRouter permettent de limiter le coût |
| Lecture de contextes d’1 million de tokens et synthèse de recherches | Lancez un pilote avec des budgets de sortie stricts ; le raisonnement obligatoire alourdit les exécutions |
| Programmation dans un terminal comme dépendance principale | Restez sur Opus / GPT / DeepSeek ; refaites un test après des évaluations indépendantes |
| Production ou hébergement autonome dans l’UE / au Royaume-Uni / en Corée du Sud | Attendez le dépôt et une licence Apache 2.0 explicitement nommée |
| Fine-tuning ou distillation | Attendez ; vérifiez les conditions d’entraînement dans la licence de la Preview |
Les démonstrations de Baidu suggèrent une bonne endurance, mais leur vérifiabilité reste insuffisante. Pour l’instant, utilisez la Preview comme second modèle peu coûteux pour les longues sessions d’agents, en attendant des résultats indépendants et un dépôt Apache 2.0 daté.
ERNIE 5.5 Flash Preview est-il déjà open source ?
Non. L’accès à l’API est disponible, mais les poids n’étaient pas publics sur Hugging Face le 11 novembre. Leur publication est promise avant le 25 novembre, et seule l’annonce en anglais mentionne Apache 2.0.
ERNIE 5.5 Flash Preview est-il multimodal ?
Non, il est uniquement textuel. Les démonstrations orchestrent des outils externes par le code ; les éléments visuels des benchmarks utilisent un outil propulsé par Claude.
Quelle différence entre Flash Base, Flash Preview et le Flash final ?
Base, publié le 5 novembre, est un checkpoint brut ; Preview, publiée le 11 novembre, est la première version intermédiaire post-entraînée ; le Flash final correspond à la future version officielle.
Pourquoi l’écart avec Claude Opus 5.5 sur Terminal-Bench est-il important ?
Cet écart suggère une fiabilité moindre sur les longues tâches dans un terminal. Comme le raisonnement est obligatoire, les nouvelles tentatives peuvent également augmenter la facture. ERNIE obtient 46.5, contre 63.6-66.4 pour Opus 5.5.
La Preview peut-elle être utilisée sans risque en production ?
Non. Aucun nouveau test indépendant n’était disponible au lancement et le comportement du modèle peut encore changer. Réservez-la à des traitements non critiques et conditionnez tout passage en production à de nouvelles évaluations ainsi qu’à la licence finale.