 AIREITER
Gemini 4 Carbon ne mérite ses contraintes d’accès que pour les chantiers qui peuvent tourner toute une nuit : refontes multi-agents, production de documents à partir de 200 vues, ou boucles allant de l’exploit au correctif. Google le dit lui-même : Gemini 4 Argon reste le meilleur choix pour l’essentiel de l’ingénierie logicielle et du travail de connaissance. Carbon vise les tâches les plus difficiles, avec une consommation de tokens plus élevée.
Gemini 4 Carbon est un modèle de raisonnement de pointe construit sur Gemini 4 Argon. Google l’a annoncé le 28 octobre 2026, avant sa disponibilité générale le 10 novembre 2026. La fiche modèle de DeepMind indique une date limite de connaissances en mars 2026, jusqu’à 1 million de tokens combinés en entrée et en sortie, des entrées texte/documents/images/audio/vidéo, et une sortie texte.
Qui peut réellement utiliser Carbon aujourd’hui ?
L’accès à Gemini 4 Carbon dépend du canal utilisé, et l’offre grand public est la plus restrictive. Les développeurs y accèdent via le palier API payant de Google AI Studio, ainsi que dans Android Studio et Gemini pour les entreprises. Côté particuliers, Carbon est proposé dans l’application Gemini, AI Mode dans Search et Google Antigravity, mais uniquement avec Google AI Ultra. Les scientifiques peuvent demander six mois d’accès gratuit au niveau d’usage le plus élevé d’Antigravity, tandis que les défenseurs vérifiés peuvent candidater au programme Fairwind.
Les abonnés Google AI Pro n’ont pas accès à Carbon sur les interfaces grand public, une restriction régulièrement signalée dans les fils de lancement de r/GeminiAI.
« Disponible pour ULTRA. Argon pour Pro disparaît en deux prompts. » — u/Nodayssoff sur r/GeminiAI
Les documents de lancement liés ne précisent ni quotas grand public fixes, ni date d’arrivée dans l’offre Pro, ni parité entre pays. Dans le fil sur l’accès et le fil sur les quotas, des utilisateurs évoquent des enveloppes de cinq heures et hebdomadaires épuisées après quelques prompts, ainsi que des clés fonctionnelles sur une interface mais bloquées dans Antigravity. Des erreurs An internal error has occurred sont également apparues dès le premier jour. Considérez donc Ultra comme un siège de test pour Carbon, pas comme un accès illimité.
Carbon et Argon : les différences essentielles
Gemini 4 Carbon et Gemini 4 Argon affichent les mêmes tarifs catalogue et une fenêtre de contexte comparable. Ce qui les sépare, ce sont les capacités, la latence et l’appétit en tokens.
| Critère | Gemini 4 Carbon | Gemini 4 Argon |
|---|---|---|
| Base | Construit sur Argon, avec davantage de raisonnement pour les travaux longs et difficiles | Modèle de pointe de base, choix par défaut pour l’ingénierie courante |
| Disponibilité générale | 10 novembre 2026 | 13 octobre 2026 selon la comparaison ToolColumn |
| ID du modèle API | À vérifier dans AI Studio au moment de l’appel ; aucun ID stable distinct n’est indiqué dans les publications de lancement | gemini-4-argon selon la comparaison ToolColumn |
| Tarif catalogue API, lancement jusqu’au 30 novembre 2026 | 2 $ en entrée / 10 $ en sortie par million de tokens, 0,10 $ pour l’entrée en cache | 2 $ en entrée / 10 $ en sortie par million de tokens, 0,10 $ pour l’entrée en cache |
| Tarif catalogue API à partir du 1er décembre 2026 | 4 $ en entrée / 20 $ en sortie par million de tokens | 4 $ en entrée / 20 $ en sortie par million de tokens |
| Contexte | Jusqu’à 1 M de tokens combinés en entrée + sortie | 1 048 576 tokens selon la comparaison ToolColumn |
| Modalités en entrée | Texte, documents, images, audio, vidéo | Texte, images selon Artificial Analysis |
| Artificial Analysis Intelligence Index v5.0.1 | 60 | 50 |
| Coût pondéré par tâche d’index | 7,76 $ | 9,95 $ |
| Vitesse de sortie | 82 tok/s | 68 tok/s |
| Délai avant le premier token de réponse | 67,54 s | 40,02 s |
| Niveaux de réflexion | Configurables ; les niveaux élevés consomment davantage de tokens | Low / Medium / High, Medium par défaut selon la comparaison ToolColumn |
Les prix proviennent de l’annonce de disponibilité de Google ; les données de vitesse, latence, coût par tâche et répartition des modalités viennent de Artificial Analysis Carbon vs Argon. L’entrée mise en cache bénéficie de 95 % de réduction sur le tarif catalogue, soit 0,10 $ par million de tokens aux tarifs de lancement.
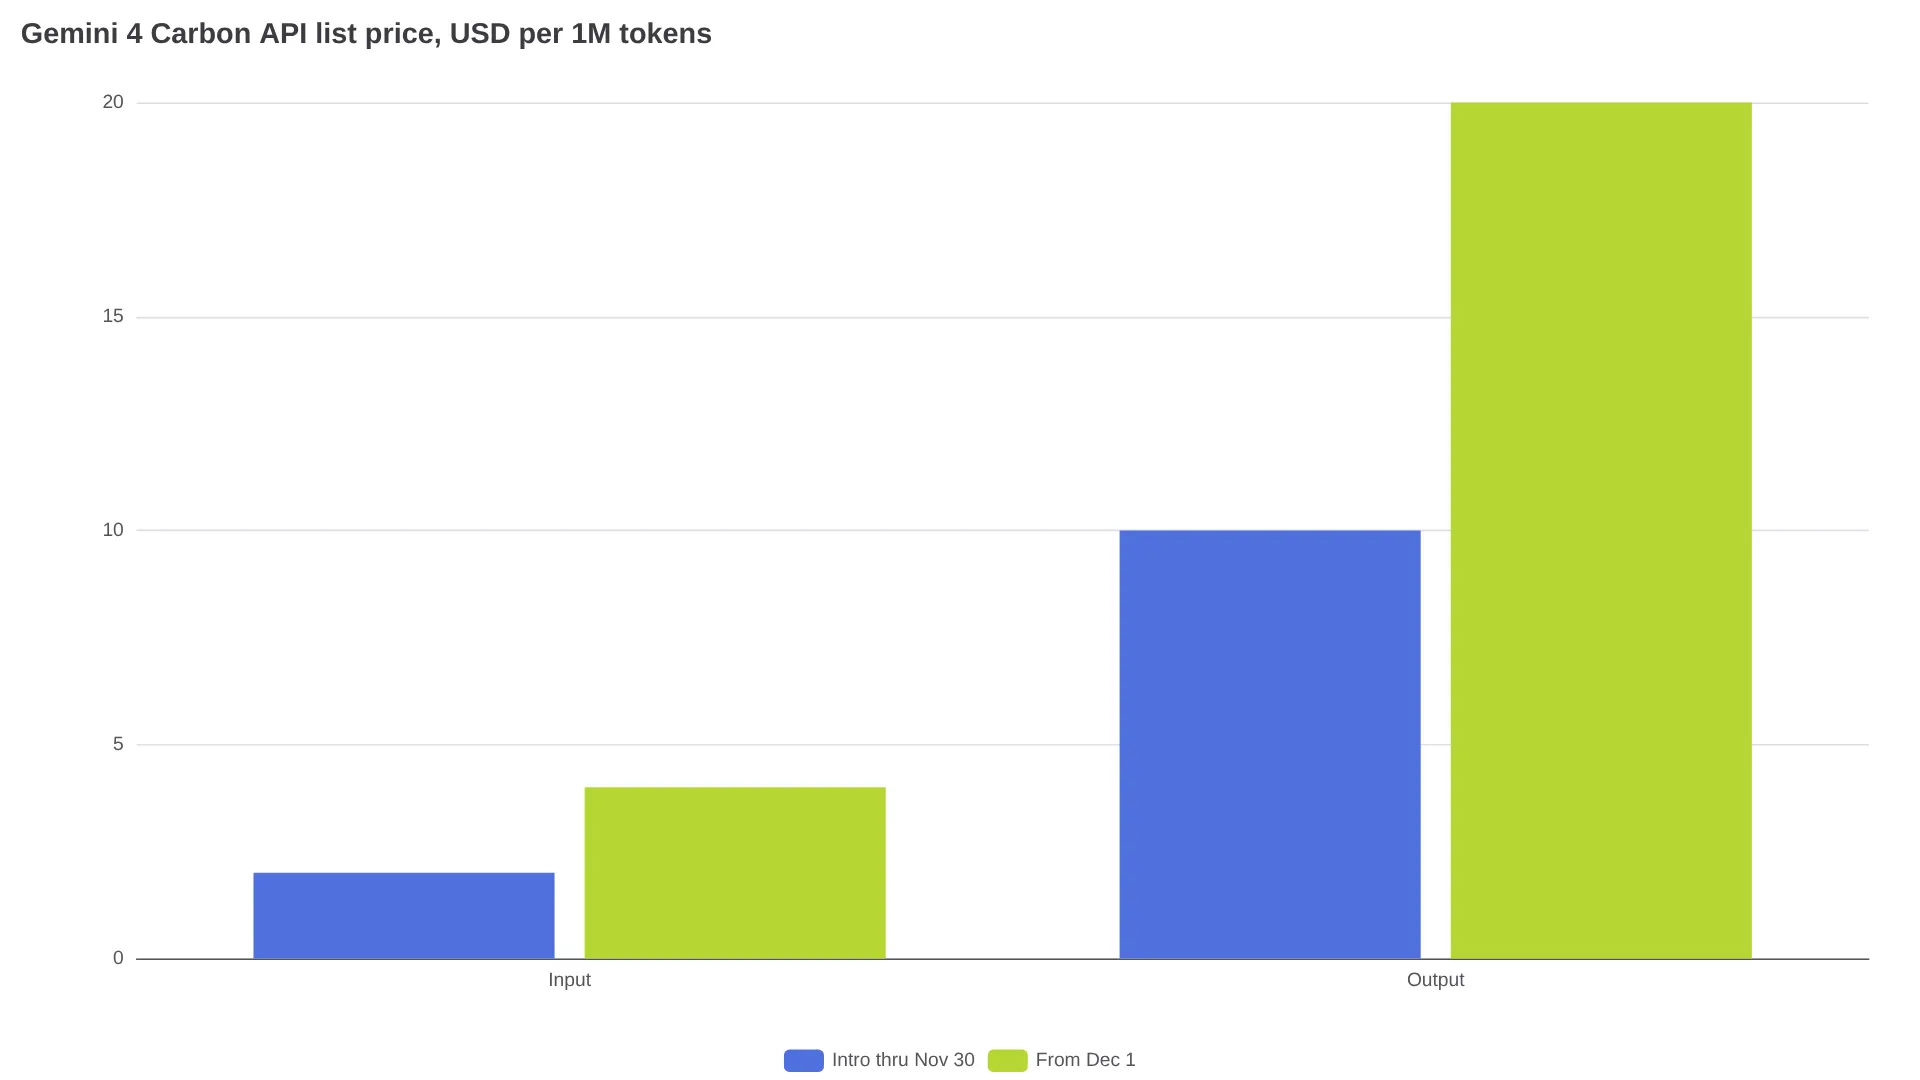
Les tarifs catalogue sont identiques, mais pas le coût réel des charges de travail. Artificial Analysis mesure 7,76 $ pour Carbon contre 9,95 $ pour Argon par tâche pondérée de l’Intelligence Index, alors même que Carbon génère en moyenne environ 7 000 tokens de sortie supplémentaires par tâche. Carbon boucle ces tâches pondérées en 24,9 minutes, contre 28,6 minutes pour Argon, mais attend 67,54 secondes avant son premier token de réponse, contre 40,02 secondes. Carbon est donc plus performant sur la durée, mais moins réactif au démarrage.
Là où Carbon prend l’avantage — et là où l’écart se resserre
Google communique 17 évaluations ; une sélection des résultats Carbon face à Argon figure ci-dessous. Gemini 4 Carbon dépasse Gemini 4 Argon sur les 17 lignes et domine l’ensemble des cinq modèles sur 15 d’entre elles. Les deux exceptions sont importantes : GPT-6 Astra mène FrontierSWE 2 avec 65,5 %, contre 61,2 % pour Carbon, tandis que Claude Opus 5.5 devance Carbon sur OSWorld-2.1 offline, avec 87,2 % contre 81,5 %.
| Type de charge | Benchmark | Carbon | Argon | Écart |
|---|---|---|---|---|
| Code agentique | SWE-sweep | 9,6 % | 4,3 % | +5,3 pp |
| Code agentique | Terminal-Bench 4.0 | 65,2 % | 57,1 % | +8,1 pp |
| Code agentique | FrontierSWE 2 | 61,2 % | 55,0 % | +6,2 pp, mais reste derrière Astra |
| Utilisation d’ordinateur | Agents' Last Exam v1.1 | 77,4 % | 69,0 % | +8,4 pp |
| Utilisation d’ordinateur | OSWorld-2.1 offline | 81,5 % | 74,7 % | +6,8 pp, mais reste derrière Opus 5.5 |
| Travail de connaissance | AutomationBench, Zapier | 53,9 % | 51,3 % | +2,6 pp |
| Travail de connaissance | Vending-Bench 2 balance | 16 484 $ | 13 718 $ | +2 766 $ de solde simulé |
| Contexte long | GraphWalks 256K-1M BFS F1 | 96,2 % | 84,2 % | +12,0 pp |
| Science | Terminal-Bench-Science 0.1 | 64,8 % | 52,9 % | +11,9 pp |
| Science | RiemannBench | 80,0 % | 76,0 % | +4,0 pp |
| Cybersécurité | ExploitGym | 54,8 % | 42,0 % | +12,8 pp |
| Cybersécurité | SEC-bench Pro | 88,2 % | 83,4 % | +4,8 pp |
| Cybersécurité | CWE-bench | 71,0 % | 68,0 % | +3,0 pp |
Toutes ces lignes sont issues du tableau de la fiche modèle DeepMind, d’octobre 2026. Les résultats cyber reflètent l’accès Fairwind sans garde-fous, et non le comportement standard du produit. Cette même fiche ajoute Chartography (72,5 % contre 71,6 %), Vals Index (70,4 % contre 69,2 %), AA Index v5.0 (59 contre 50) et Blueprint-Bench 2 similarity (58,6 % contre 54,4 %), ce qui complète les 17 évaluations.
- Charges techniques les plus difficiles : les écarts les plus marqués en faveur de Carbon concernent la validation d’exploits, la recherche dans des graphes de 256K à 1M, la science en terminal et le code terminal en plusieurs étapes.
- Travail de connaissance courant : l’écart tombe à 1 à 3 points sur la lecture de graphiques, les évaluations générales et l’automatisation bureautique.
- Honnêteté et sécurité : dans son billet de présentation de Carbon, Google annonce 92 % de réussite aux tests d’honnêteté agentique sur 375 tâches, contre 70 % pour Argon, ainsi que 0,0 % de réussite aux injections indirectes de prompt, contre 0,7 % pour Argon ; les affirmations non étayées seraient environ divisées par deux.
Artificial Analysis place Carbon devant sur les neuf composantes de son Intelligence Index, notamment en raisonnement physique et en ingénierie sur dépôts ouverts : FrontierCode 2.0 atteint par exemple 40,6 % contre 25,7 % pour Argon. L’annonce de disponibilité de Google revendique aussi la première place sur CursorBench 4.0, Perplexity WANDR et Zapier AutomationBench, à un coût par tâche inférieur de plus de 2x à celui du meilleur modèle externe suivant.
Quelles tâches confier à Carbon, lesquelles laisser à Argon ?
Réservez Gemini 4 Carbon aux tâches où les boucles de vérification remboursent leur coût : reconstructions Three.js nocturnes en 10 boucles à partir de plus de 200 vues de dessins PDF, ou builds de physique multi-agents /swarm documentés dans l’annonce de disponibilité de Google. Cet exemple de la communauté illustre le principe à plus petite échelle.
« Je touche de l’herbe avec Gemini 4 Carbon. J’ai créé cette prairie de toutes pièces en CUDA et C++, sans moteur de jeu ni bibliothèque 3D. 52k brins d’herbe et fleurs sauvages, et j’ai fini par synthétiser aussi le son du vent en C++ pour que les mêmes rafales [pilotent l’audio]. » — @GlitterPixely sur X
Gardez le travail courant sur Gemini 4 Argon. Carbon affiche ses plus faibles gains mesurés en lecture de graphiques et automatisation bureautique : commencez donc les modifications sur un seul fichier, le CRUD standard et les feuilles de calcul au schéma verrouillé sur Argon. Vous éviterez aussi le délai plus long avant le premier token et la consommation accrue de Carbon. Le niveau High consomme rapidement des tokens sur les récits courts : un retour OpenRouter évoque environ 6 000 tokens de réflexion pour une histoire de 4 000 caractères en High.
En pratique, lancez les nouveaux agents sur Argon Medium pour valider les prompts, les quotas et les autorisations d’outils. Ne basculez vers Carbon que pour la longue traîne qui échoue : migrations entre packages, recherche de cause racine à travers plusieurs sous-systèmes, corpus documentaires de plus de 100K tokens avec dessins et tableaux, et boucles scan-triage-correction de type Fortify. Sur ce dernier cas, l’annonce de disponibilité rapporte en interne 100 % de rappel au scan et 95 % de précision au triage. Dans /swarm, attribuez à Carbon les rôles d’architecte, de coordinateur et de vérificateur adversarial, et laissez les modèles plus légers faire tourner les espaces de travail parallèles. Si une exécution Carbon enchaîne les erreurs internes, relancez-la dans une nouvelle session avant d’augmenter le niveau de réflexion : les fils du premier jour rapportent des erreurs dont la cause reste floue.
Budgéter Carbon après le 1er décembre
Lorsque les tarifs catalogue de l’API doublent le 1er décembre, une mise en cache agressive des entrées, avec 95 % de réduction, devient le principal levier pour réutiliser dépôts, dessins et sorties d’outils.
Ne construisez pas votre budget sur le seul tarif catalogue. Carbon génère davantage de tokens de sortie par tâche mesurée : un mois à 50M de tokens d’entrée et 5M de sortie passe donc de 150 $ au tarif de lancement à 300 $ après cette période, au tarif catalogue et pour l’un ou l’autre modèle, avant même de compter la réflexion supplémentaire de Carbon. Pourtant, Artificial Analysis relève encore un coût pondéré inférieur par tâche Intelligence Index terminée pour Carbon, car moins de tentatives et un débit soutenu plus rapide compensent le volume de tokens. La règle est simple : High pour les chaînes d’exploits et la science en terminal, où Carbon progresse de 8 à 13 points ; Medium ou Low pour les documents et les finitions d’interface, où l’avance se limite à 1 à 3 points.
Pour un calcul détaillé poste par poste, consultez le test des tarifs API de Gemini 4 Carbon du site.
FAQ Gemini 4 Carbon
Google AI Pro aura-t-il un jour accès à Carbon ?
Les documents liés ne donnent aucune date pour Pro. Restez sur Argon et considérez Ultra comme un siège de test Carbon à court terme.
Quel niveau de réflexion pilote la facture ?
Medium sert à valider les prompts ; High est à réserver aux chaînes d’exploits et à la science en terminal, avec des écarts de 8 points ou plus.
Carbon et Argon partagent-ils les mêmes quotas ?
Aucun document ne confirme clairement l’existence de quotas partagés. Vérifiez les limites de votre compte sur chaque interface ; le chiffre de 1 M désigne la capacité de contexte, pas un quota d’usage.
La décision en un tableau
| Si votre travail ressemble à | Choix | Pourquoi |
|---|---|---|
| Livrer cette semaine, code et documents courants | Argon Medium | Écart de 1 à 3 points, premier token plus rapide, consommation moindre |
| Migration sur plusieurs jours, dépôt de plus de 100K tokens + dessins | Carbon, puis retour à Medium une fois au vert | +8 à +12 points en terminal et contexte long |
| Scanner, trier et corriger des vulnérabilités open source | Carbon via Fairwind/API | +12,8 points sur ExploitGym selon la fiche modèle ; taux de code sécurisé supérieur à plus de 2x celui d’Argon |
| Agents de documents finance/juridique avec graphiques | Argon d’abord, Carbon pour les chiffres contestés | Carbon est n° 2 sur Multimodal Knowledge Agent, à un coût par tâche 6x inférieur à celui du leader selon l’annonce de disponibilité, mais Argon est proche sur AutomationBench |
| Abonné Ultra avec un quota hebdomadaire serré | Argon au quotidien, Carbon pour une exécution difficile | Certains utilisateurs signalent que Carbon épuise les enveloppes en quelques prompts |
Carbon est un spécialiste à louer pour les tâches difficiles, pas un modèle à utiliser par défaut. Argon garde la file des travaux quotidiens ; Carbon ne justifie son tarif catalogue de décembre que lorsque les boucles de vérification et la profondeur exploit-vers-correctif font la différence.