 AIREITER
Google a annoncé Gemini 4 Carbon le 28 octobre 2026, en le présentant comme son modèle le plus puissant à ce jour. Il arrive en tête de l’Artificial Analysis Intelligence Index v5.0 avec un score de 59. Le point bloquant reste toutefois l’accès : cette semaine, seuls des défenseurs de la cybersécurité préalablement validés peuvent l’utiliser dans le cadre du programme Fairwind. Aucun identifiant de modèle public n’est encore disponible pour l’API.
Avant l’annonce, les trackers parlaient encore d’une fuite non confirmée. Google publie désormais des benchmarks et des tarifs. Ce guide les met en regard de l’évaluation indépendante de Vals.ai et propose un plan Argon pour continuer à développer sans attendre.
Peut-on appeler Gemini 4 Carbon aujourd’hui ?
Non. Au 28 octobre 2026, Gemini 4 Carbon est annoncé, mais n’est pas disponible de manière générale pour les développeurs, les entreprises ou les particuliers. Google indique qu’un groupe de défenseurs de la cybersécurité y aura accès pendant la semaine de l’annonce, puis que des partenaires de confiance pourront l’utiliser via le programme Fairwind. Une ouverture plus large est promise dès que possible, sans date précise.
Ce déploiement progressif s’explique par des tests de cybersécurité sans garde-fous et par le travail de sécurité mené avant la sortie, notamment avec des organismes de test du gouvernement américain. Google continue d’ajuster ses protections. Aucun identifiant de modèle public, aucune entrée dans AI Studio et aucune limite de requêtes ne sont indiqués.
Cette situation remplace celle de la semaine dernière. Avant le 28 octobre, la documentation développeur de Google ne listait que gemini-4-argon comme modèle d’API Gemini 4, et les trackers avaient raison d’indiquer qu’aucun identifiant Carbon n’existait. C’était exact à l’époque, mais ce n’est plus à jour : Carbon existe désormais comme produit annoncé, pas encore comme endpoint appelable.
Si un fournisseur affiche aujourd’hui gemini-4-carbon, considérez cette entrée comme non vérifiée tant qu’il n’a pas documenté le modèle amont, le type de route — publique, restreinte, expérimentale ou alias — et les autorisations associées. Une simple fiche catalogue ne prouve pas que Google a bien routé ce checkpoint vers l’appelant.
À quoi sert réellement Carbon ?
Gemini 4 Carbon vise les travaux d’ingénierie qui s’étendent sur plusieurs jours, plutôt que les échanges ponctuels. Google affirme que ses équipes internes l’ont vu travailler pendant plusieurs jours, en persistant malgré les impasses sur des tâches comme l’identification de bugs subtils, leur correction dans de grandes bases de code et le travail sur des systèmes bas niveau.
Ce positionnement s’appuie sur les retours d’utilisateurs concernant le code, les agents autonomes, les tâches scientifiques, le développement web full-stack et la compréhension multimodale. Le seul classement externe cité ici par Google est WebDev Arena : Carbon y a gagné 89 points Elo pour atteindre 1768 et la 4e place, un résultat que Google attribue à une meilleure qualité de sortie et à de meilleurs artefacts générés.
Google revendique également un taux de réussite en génération de code sécurisé supérieur de plus de 2 fois à celui de Gemini 4 Argon dans ses tests internes. Le multiplicateur n’est pas détaillé en valeur absolue : pas de référence, de taille d’échantillon ni de répartition par langage. Il faut donc y voir une indication de tendance, pas une justification suffisante pour migrer. L’affirmation de l’équipe Chrome, selon laquelle Carbon produirait plus de 10 fois plus de correctifs de haute qualité qu’un autre grand modèle de pointe d’un autre laboratoire, souffre du même défaut : le modèle concurrent n’est pas nommé et la métrique n’est pas définie.
Argon a été lancé à la mi-octobre 2026. Carbon se situe au sommet de la même gamme et du même dispositif de sécurité.
Le bilan cybersécurité, et ce que les chiffres ne disent pas
La principale différence mise en avant pour Carbon est sa couverture de tout le cycle de cybersécurité : repérer les vulnérabilités, vérifier qu’elles sont exploitables, puis corriger leurs causes profondes. Google précise que les trois évaluations externes ont été menées sans garde-fous. Elles mesurent donc les capacités intrinsèques du modèle, pas ce qu’un endpoint de production protégé autorisera réellement.
| Étape | Benchmark | Score de Carbon | Ce qui est testé |
|---|---|---|---|
| Détection | SEC-bench Pro | 88,2 % | Détecter de manière autonome de véritables failles dans des logiciels réels |
| Exploitation | ExploitGym | 54,8 % | Vérifier si les failles sont réellement exploitables |
| Correction | CWE-bench | 71,0 % | Corriger les causes profondes avec du code fonctionnel |
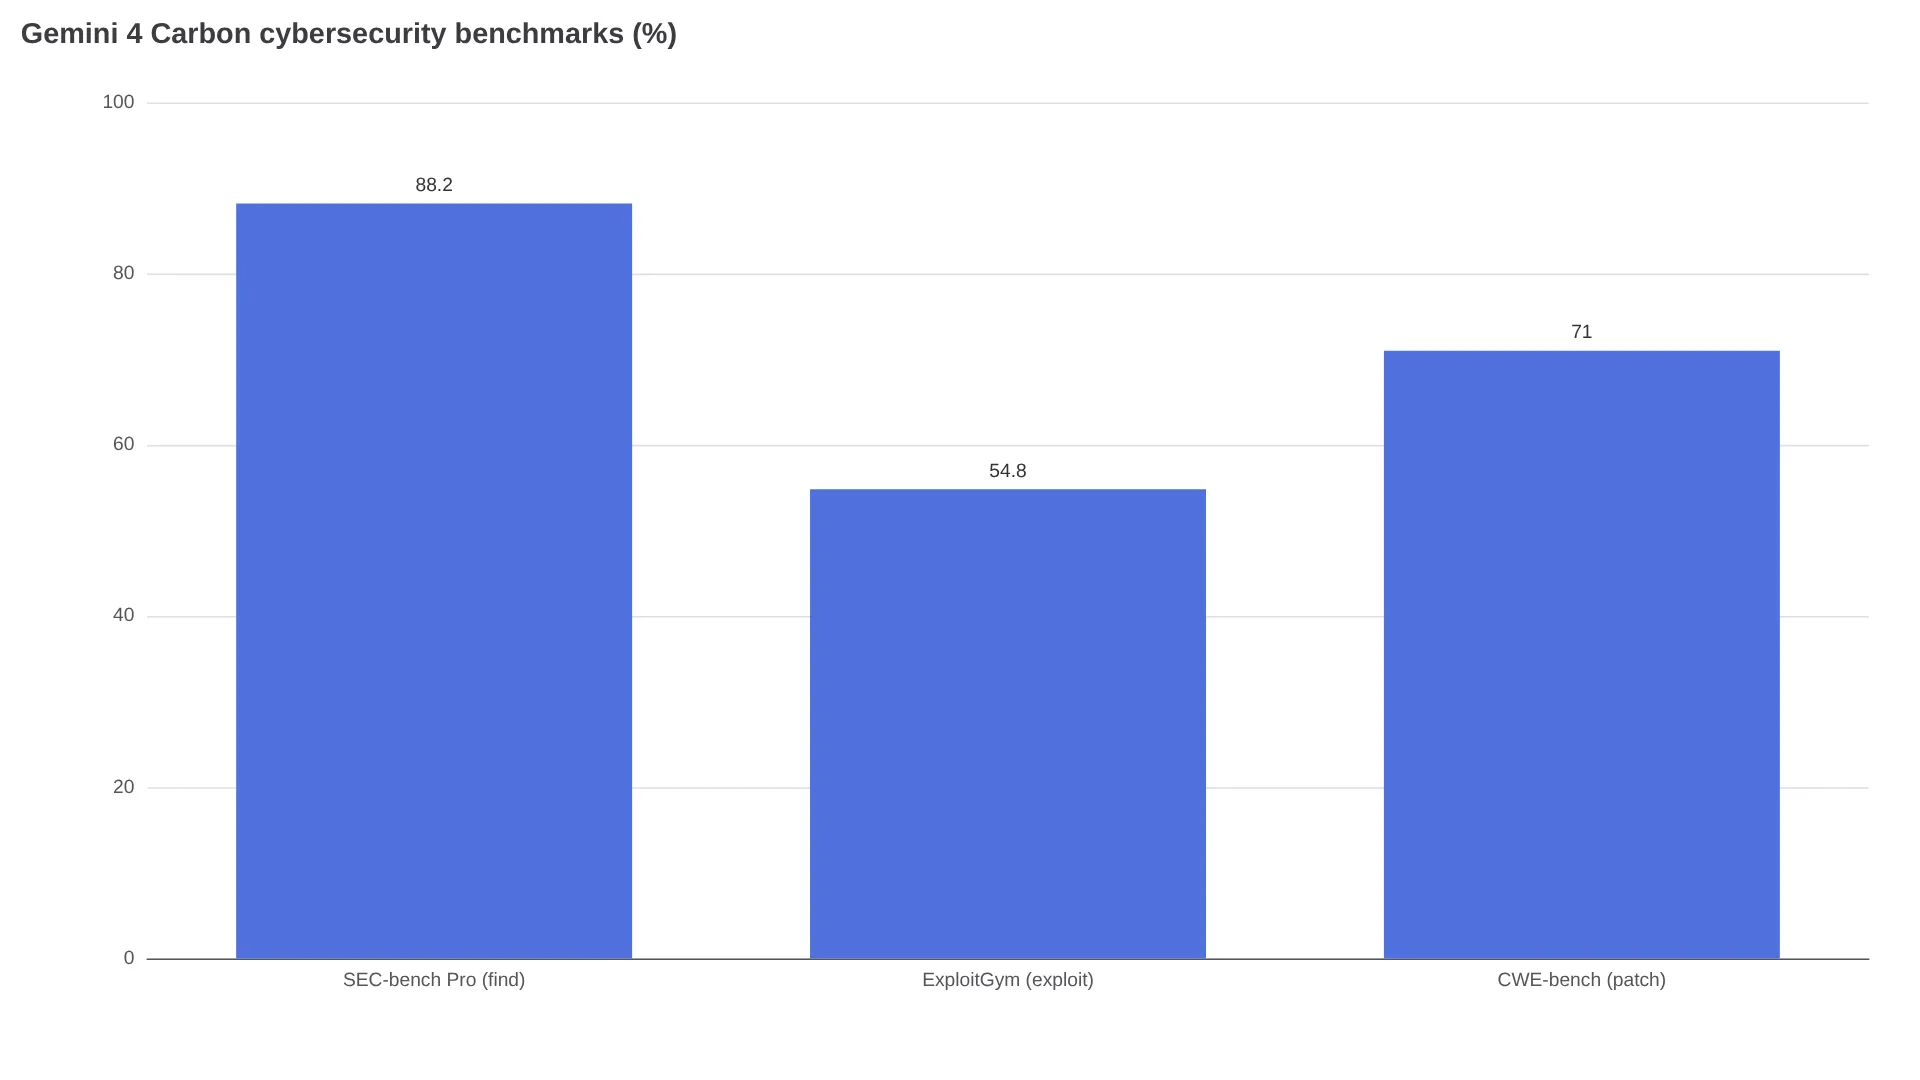
Trois précautions comptent davantage que les pourcentages. D’abord, ne multipliez pas 88,2 % × 54,8 % × 71,0 % pour obtenir un taux de réussite de bout en bout : chaque score provient d’un ensemble de tâches différent. Ensuite, la détection — 88,2 % — est généralement plus facile à automatiser qu’une remédiation sûre — 71,0 % — tandis que l’exploitation — 54,8 % — demande le plus de planification. Cette baisse progressive est donc attendue, pas révélatrice d’un défaut. Enfin, la position de leader en pentest web revendiquée par Google et Wiz dans le cadre de l’initiative Scan for Good n’est accompagnée ni du nom ni du score du benchmark : impossible de la comparer.
En pratique, Carbon semble surtout adapté au triage et à la correction des failles pour les équipes qui accumulent les tickets, plutôt qu’à un red team autonome. Ses capacités d’exploitation expliquent aussi pourquoi l’accès est limité au départ.
Sécurité et fiabilité : 0 % de triche, 0 % d’injection de prompt
La deuxième promesse de Carbon concerne sa fiabilité sous pression, avec des chiffres particulièrement précis. Google fait état de 0,0 % de triche réussie et de 0,4 % de tentatives de triche sur Terminal-Bench 4.0, tandis que la précision globale augmentait simultanément. Les alertes de désalignement à haute gravité ont diminué de presque 80 % dans des environnements internes de développement utilisés en conditions réelles.
La résistance aux injections de prompt progresse elle aussi sur le benchmark Gray Swan Indirect Prompt Injection. Le précédent meilleur résultat d’Argon était un taux de réussite des attaques de 0,7 % ; Carbon affiche 0,0 %, aucune attaque réussie n’ayant été enregistrée dans l’évaluation publiée. Google ajoute 26 % de dépassements de périmètre en moins et 29 % de sous-exécution en moins par rapport à la référence précédente, ce qui doit se traduire par une exécution en plusieurs étapes plus fiable et mieux cantonnée.
Ces améliorations ne fournissent toutefois pas les dénominateurs nécessaires à leur reproduction. Google ne donne ni le nombre d’attaques derrière le 0,0 %, ni le taux d’alertes de référence correspondant à la baisse de presque 80 %, ni la grille de notation des dépassements et sous-exécutions, ni la méthodologie de détection de la triche. Considérez la tendance comme encourageante pour les agents, mais conservez vos propres journaux d’appels d’outils et vos protections de branches. La stack interne de Google — entraînement, défenses contre les abus en temps réel, résistance aux injections de prompt et surveillance de la chaîne de pensée — ne se transfère pas automatiquement à votre propre infrastructure.
La vérification indépendante : Vals.ai le classe 2e, pas 1er
Les benchmarks des fabricants méritent une seconde source, et Vals.ai en a publié une le 28 octobre 2026. Son Vals Index général place Carbon 2e sur 29 avec 70,36 % (±0,97), entre Claude Sonnet 5.5 à 70,85 % et Claude Opus 5.5 à 70,18 %. Le test a coûté 10,51 $, pour une latence d’évaluation de 47 minutes et 45 secondes avec un niveau de raisonnement élevé.
Le détail des résultats est plus instructif que le classement général. Carbon est 1er sur 87 au Legal Research Bench et 1er sur 33 au Vals Finance Index, 2e sur 35 à EMB v1.1 et 4e sur 57 à Terminal-Bench 4.0 avec 63,13 %. Son résultat le plus faible est de 17,50 % sur HLAB-Vals-1.1, soit la 6e place sur 30. Ses 89,06 % à Vibe Code Bench v1.1 ne lui valent par ailleurs que la 8e place sur 121 : un score brut solide, dans un domaine très concurrentiel.
L’avantage de Carbon se concentre donc sur la recherche, la finance et les tâches juridiques pilotées par agent, avec de bonnes performances en programmation, plutôt que sur une domination uniforme. Vals indique une fenêtre de contexte de 1 million de tokens, des poids privés et des tarifs de 4 $ par million de tokens en entrée / 20 $ par million en sortie — après la période de lancement —, en accord avec les tarifs standard de Google présentés plus bas. Vals précise que certains benchmarks peuvent utiliser des fournisseurs ou des paramètres différents : vérifiez la configuration de chaque test avant de citer un chiffre isolé.
Les trackers antérieurs à l’annonce précèdent à la fois les tarifs et la mise à jour de Vals. Une analyse détaillée affirme encore qu’aucun prix n’a été publié.
Combien coûtera l’API à son ouverture ?
Google a publié les tarifs de Carbon dès l’annonce, aux mêmes conditions de lancement qu’Argon. Aucune date de fin n’est prévue pour cette période introductive et aucun tableau d’abonnement ou de limites de requêtes n’a encore été communiqué.
| Type de token | Tarif de lancement | Tarif standard |
|---|---|---|
| Entrée | 2,00 $ / 1 M | 4,00 $ / 1 M |
| Sortie | 10,00 $ / 1 M | 20,00 $ / 1 M |
| Entrée mise en cache (95 % de remise sur l’entrée) | ~0,10 $ / 1 M | ~0,20 $ / 1 M |
Le calcul de l’entrée mise en cache est dérivé, et non repris tel quel dans la publication : une remise de 95 % sur 2 $ donne 0,10 $, et une remise de 95 % sur 4 $ donne 0,20 $. Les agents qui réutilisent de longs contextes de code sont ceux qui profiteront le plus de cette remise, mais les tokens de sortie restent le principal poste de dépense, à un tarif cinq fois supérieur à celui de l’entrée.
Ne construisez pas votre budget à partir du tarif affiché uniquement. Mesurez le coût par résultat accepté : dépenses totales, reprises, sorties écartées, contexte répété et appels de réparation compris, divisées par le nombre de résultats validés. Une route moins chère qui exige régulièrement trois passes de correction perd souvent face à une route plus coûteuse qui aboutit en une seule. Google ne communique aucun chiffre de latence ou de débit pour Carbon ; toute comparaison en tokens par seconde serait donc spéculative.
À lire également sur la facture actuelle : les tarifs et la disponibilité de l’API Gemini 4 Argon et ce que l’on sait de Gemini 4.
Pourquoi les premiers testeurs sont-ils agacés ?
Les testeurs de la préversion décrivent le même compromis dans le bilan du 23 octobre de TestingCatalog : une génération 3D visiblement meilleure qu’avec Argon, mais des réponses beaucoup plus lentes et des résultats toujours faibles côté frontend et interface utilisateur. L’un des testeurs estime que les réponses sont environ 2 à 4 fois plus lentes selon la tâche.
Dans les discussions d’utilisateurs, la frustration liée à l’accès prend le dessus sur les benchmarks :
je ne comprends vraiment pas la stratégie de Google pour sortir ses modèles. gemini 4 carbon semble impressionnant dans les benchmarks, mais une fois encore, les gens ne peuvent pas l’utiliser. l’accès est limité au départ, sans date pour la sortie générale.
Le même constat revient dans plusieurs fils : consommation des quotas jugée imprévisible sur Argon, sessions de cinq minutes qui atteignent les limites horaires, et fragmentation des versions entre Gemini App, AI Studio et Antigravity. Un autre testeur résume ainsi le problème de vérification :
Seuls des défenseurs de la cybersécurité validés y ont accès cette semaine, avec une ouverture plus large « bientôt ». Mon avis : un classement obtenu dans le propre environnement du fabricant ne vaut que la moitié du résultat. Attendons que quelqu’un le teste dans un environnement neutre.
Que construire cette semaine ?
Ne mettez pas vos développements en pause dans l’attente de Carbon. La stratégie la plus pragmatique consiste à déployer dès maintenant avec un modèle confirmé, tout en gardant le nouveau modèle interchangeable.
- Développez dès aujourd’hui avec
gemini-4-argonvia son API documentée, en gardant l’URL de base, la clé API et l’identifiant du modèle en dehors de la logique métier. - Constituez un jeu d’évaluation de 30 à 50 tâches à partir de votre propre dépôt — corrections de bugs, refactorisations, audits de sécurité — puis mesurez le taux de réussite, le temps de revue et le coût par résultat accepté avant l’arrivée de Carbon.
- Mettez dès maintenant en place les garde-fous dont les exécutions sur plusieurs jours auront de toute façon besoin : travail par branche, plafonds de dépenses, journaux d’audit des appels d’outils, points de contrôle et étapes de validation humaine.
- Lorsqu’une route Carbon sera documentée pour votre compte, ajoutez-la comme candidate, relancez le même jeu de tests et comparez la qualité, la latence, le coût et la prise en charge des fonctionnalités — streaming, images, appels de fonctions et sorties structurées — avant de lui transférer du trafic. Lancez de nouvelles sessions plutôt que de changer de modèle en cours de tâche.
Les équipes qui ont un important backlog AppSec devraient en plus journaliser chaque appel d’outil et rechercher dans leur propre dépôt les tricheries de type benchmark — sorties codées en dur, modifications des fichiers de test. Le 0,0 % de Google est un résultat obtenu sur son environnement, pas une garantie dans le vôtre.
| Situation | À faire cette semaine |
|---|---|
| Vous devez livrer un agent ou un outil de sécurité | Utilisez Argon via l’API et mesurez le coût et la latence |
| Vous êtes bloqué uniquement par les scores cyber de Carbon | Aucune procédure de demande publique n’est documentée ; surveillez l’annonce Fairwind de Google |
| Vous hésitez entre Carbon, Opus 5.5 et GPT-6.1 Terra | Attendez des relances neutres ; Vals place actuellement Sonnet 5.5 devant au classement général et Opus 5.5 juste derrière Carbon |
| Vous développez une application sensible au prix avec un long contexte | Concevez-la dès le départ pour tirer parti de l’entrée mise en cache ; c’est la longueur de la sortie qui déterminera la facture |
FAQ Gemini 4 Carbon
Gemini 4 Carbon est-il disponible via l’API ?
Pas publiquement. L’accès pendant la semaine de l’annonce est limité aux défenseurs de la cybersécurité, avant une extension aux partenaires de confiance de Fairwind. Aucune date n’est donnée pour les développeurs, les entreprises et les particuliers. Développez avec Argon et rendez l’identifiant du modèle configurable.
Quel est l’identifiant du modèle Gemini 4 Carbon ?
Google n’en a pas publié. Ne partez pas du principe que gemini-4-carbon fonctionne. Utilisez uniquement un identifiant documenté explicitement par votre fournisseur, avec son endpoint, ses autorisations et ses tarifs.
Combien coûte Gemini 4 Carbon ?
Le tarif de lancement est de 2 $ par million de tokens en entrée et 10 $ par million en sortie, avec une remise de 95 % sur l’entrée mise en cache (~0,10 $). Les tarifs standards ultérieurs seront de 4 $ en entrée et 20 $ en sortie (~0,20 $ pour l’entrée mise en cache). La durée de la période de lancement n’est pas indiquée.
Comment Carbon se compare-t-il à Argon ?
Google revendique une progression de plus de 2 fois en génération de code sécurisé, 26 % de dépassements de périmètre en moins, 29 % de sous-exécution en moins et un taux de réussite des injections de prompt de 0,0 %, contre 0,7 %. Les données indépendantes de Vals ne portent que sur Carbon ; considérez les écarts avec Argon comme des résultats internes au fournisseur tant que des relances neutres n’auront pas été publiées.
Carbon dépasse-t-il Claude Opus 5.5 ou GPT-6.1 Terra ?
Ce n’est pas démontré par une comparaison directe. Une impression d’employé publiée avant le lancement et rapportée par GetAICodingAgent indiquait que Carbon ressemblait à Opus 5.5 pour le code. Dans l’ensemble, Vals place Carbon à 70,36 %, juste devant Opus 5.5 à 70,18 %, mais derrière Sonnet 5.5 à 70,85 %. Aucun résultat contrôlé comparant Carbon à Terra n’a été publié.
Quand aura lieu la disponibilité générale ?
Google parle d’une ouverture dès que possible après les phases consacrées aux défenseurs et aux partenaires, sans donner de date. Consultez le blog officiel de DeepMind et le catalogue de modèles de votre fournisseur, plutôt que les fils consacrés aux fuites.