 AIREITER
Un menu de café avec quatre prix paraît anodin… jusqu’à ce que le modèle en modifie un. MOSS Image réussit beaucoup plus souvent qu’on ne l’imaginerait pour un modèle de cette taille, à condition de lui fournir une structure claire et de relire le résultat comme le ferait un graphiste.
C’est précisément ce compromis que ce test examine : un modèle texte-vers-image de 5B paramètres, sous licence Apache 2.0, capable d’accepter des prompts allant jusqu’à 4 096 tokens ainsi que des boîtes englobantes JSON facultatives pour positionner textes et objets. L’équipe OpenMOSS l’a publié le 16 octobre 2026 avec les checkpoints Base et SFT, puis l’API hébergée sur la plateforme MOSI a été mise en ligne le 20 octobre. Pour créer des affiches, menus, étiquettes ou infographies avec un texte exact, il mérite clairement un essai. Pour assurer la cohérence d’un personnage ou retoucher une photo, mieux vaut rester sur un modèle fermé.
Le verdict se dessine dès les premières images : le texte tient, la finition moins
MOSS Image se distingue surtout sur les textes longs et exacts, pas par son esthétique générale. Le LongLongTextBench de l’éditeur lui attribue une couverture textuelle Mean-6 globale de 96,3 — 97,1 pour l’anglais long et 92,4 pour le chinois long, sur 240 tâches comptant en moyenne environ 1 340 caractères — contre 99,0 pour GPT Image 2 et 96,6 pour Nano Banana Pro. Ces chiffres proviennent d’un benchmark conçu et exécuté par l’éditeur : il faut donc les considérer comme des résultats à vérifier, pas comme une promesse.
Le respect de la mise en page est l’autre indicateur clé. Le rapport technique détaillé dans ce test indique un mIoU de 0,88 et un Layout AUC de 0,70 sur le test de suivi de boîtes 7Bench, soit environ deux fois les scores d’Ideogram 4 — 0,44 et 0,20 — et nettement mieux que GPT Image 2, à 0,30 et 0,16 dans le même rapport. Sur RealLayoutArena, qui regroupe 61 tâches évaluées à l’aveugle sur des affiches, infographies et interfaces, le système MOSS complet avec amélioration du prompt atteint 1 698,70 Elo. Il arrive derrière GPT Image 2 à 1 844,35, tandis que le backbone seul arrive premier lorsque tous les générateurs reçoivent le même prompt amélioré. Là encore, ces résultats viennent de l’éditeur et attendent une réplication indépendante.
Un petit test contrôlé permet de mieux saisir l’écart. L’équipe de mossimage.run a comparé une fois par prompt MOSS Image SFT et FLUX.1 dev, sur le même canevas 1024x1024 et avec les mêmes seeds, sans sélectionner uniquement les réussites : les échecs sont restés dans l’échantillon. Je n’ai pas relancé les mesures de latence de l’API MOSI hébergée pour ce test ; les résultats du tableau correspondent aux premières sorties de cette équipe via les endpoints fal. L’API MOSI est, elle, évaluée à partir de sa documentation et de son statut de facturation pendant la période gratuite :
| Test | Ce que demandait le prompt | Première sortie de MOSS Image SFT | Première sortie de FLUX.1 dev |
|---|---|---|---|
| Menu de café | MORNING MENU ainsi que Espresso 3.50, Flat White 4.20, Butter Croissant 3.80, Avocado Toast 8.50, alignés à droite | Les quatre plats et leurs prix sont reproduits à l’identique | Mise en page claire, mais 3.80 devient 3.60 |
| Étiquette de miel | WILDFLOWER HONEY, Raw & Unfiltered, Net Wt. 12 oz (340 g) en suivant la courbure de l’étiquette | Les trois lignes sont reproduites à l’identique | Le titre et le poids sont corrects, mais la ligne centrale devient Raw & Unfilterelrd |
| Affiche bilingue | 周末市集 / WEEKEND MARKET, Sat 10:00–18:00, Riverside Park, Free entry / 免费入场 | Les informations chinoises et anglaises sont reproduites à l’identique | Composition réussie, mais chinois illisible et 10.00–178.00 |
Les réglages étaient de 50 étapes et CFG 3 pour MOSS, contre 28 étapes et un guidage de 3,5 pour FLUX, via fal-ai/moss-image et fal-ai/flux/dev. Trois exemples ne suffisent évidemment pas à désigner un vainqueur, comme le rappelle la page. Mais c’est bien le type d’échec qui compte ici : une image convaincante contenant un prix ou un horaire modifié est plus problématique qu’une image manifestement ratée.
« MOSS Image gère bien la mise en page structurée et le texte anglais pour un modèle de 5B paramètres. Ce n’est pas parfait dans les moindres détails, mais le workflow est enfin devenu contrôlable. » — @Olaemmy1200, dans une vidéo présentant l’ensemble du workflow d’affiche
Ce que l’API fournit réellement : un générateur compact, un lecteur ambitieux
MOSS Image est un transformeur de diffusion à flux unique, composé de 42 couches et entraîné from scratch. Les 5B paramètres concernent uniquement le générateur. Autour de lui, on trouve un encodeur de texte Qwen3.5-9B gelé, chargé de lire le prompt, ainsi qu’un VAE FLUX.2 small-decoder qui génère les pixels. Cette séparation explique à la fois ses qualités et ses besoins matériels : sa compréhension des prompts longs et bilingues vient d’un lecteur de 9B paramètres, et non du débruiteur de 5B.
La fenêtre de contexte constitue son avantage le plus concret. Langage naturel, séquences de tags et mise en page JSON partagent une capacité allant jusqu’à 4 096 tokens — suffisamment pour écrire chaque ligne d’une affiche au lieu de la réduire à une légende courte. La documentation de l’API MOSI parle d’une limite hébergée de 4 000 caractères pour les textes longs, avec prise en charge du rendu textuel, des prompts négatifs et de la génération de layouts. Les sorties sont recommandées dans une plage de 1 à 2 mégapixels, avec une extrapolation possible de 512x512 jusqu’à 2K et des dimensions divisibles par 16.
Deux checkpoints déterminent principalement le résultat :
- MOSS-Image-SFT est la version Base affinée par fine-tuning supervisé sur des données sélectionnées. L’équipe OpenMOSS la recommande pour la génération directe, avec des regroupements de texte plus propres et des layouts mieux maîtrisés. L’API hébergée utilise par défaut
moss-image-sft-1.0, avec le snapshot figémoss-image-sft-1.0-2026-10-09pour garantir la reproductibilité. - MOSS-Image-Base n’intègre ni post-entraînement ni distillation CFG, afin de préserver le signal brut de l’entraînement. Le guide officiel le recommande pour le fine-tuning et conseille de geler l’encodeur de texte. Choisissez Base pour entraîner un LoRA ou explorer une autre distribution stylistique, pas pour produire une affiche immédiatement.
Les deux poids ainsi que le code d’inférence fourni sont publiés sous licence Apache 2.0, selon la fiche du modèle sur Hugging Face et la page officielle du projet. Cette licence autorise l’usage commercial et le fine-tuning, mais elle ne vous donne pas automatiquement les droits sur chaque personnage, logo ou visage généré pour une campagne. Conservez le fichier de licence et la révision exacte avec tout projet commercial. Le code se trouve dans le dépôt GitHub d’OpenMOSS.
Le layout JSON justifie à lui seul la complexité du workflow
Le langage naturel fonctionne toujours, mais c’est la syntaxe de mise en page qui intéresse vraiment les designers. Un prompt structuré décrit d’abord la scène globale, puis attribue à chaque texte ou objet son propre descriptif et sa propre boîte. Ces boîtes orientent la génération ; elles ne constituent ni des calques vectoriels ni une garantie de précision au pixel près.
La convention de coordonnées piège presque tout le monde au premier essai. Avec bbox_coord_space: "abs_centralized" et bbox_format: "yxyx", chaque boîte suit le format [y_min, x_min, y_max, x_max] en pixels par rapport au centre du canevas. Sur une image 1024x1024, chaque axe va de -512 à +512. Il ne faut donc pas coller directement des coordonnées classiques partant du coin supérieur gauche, ni un layout communautaire sur une échelle de 0 à 1000, sans effectuer la conversion.
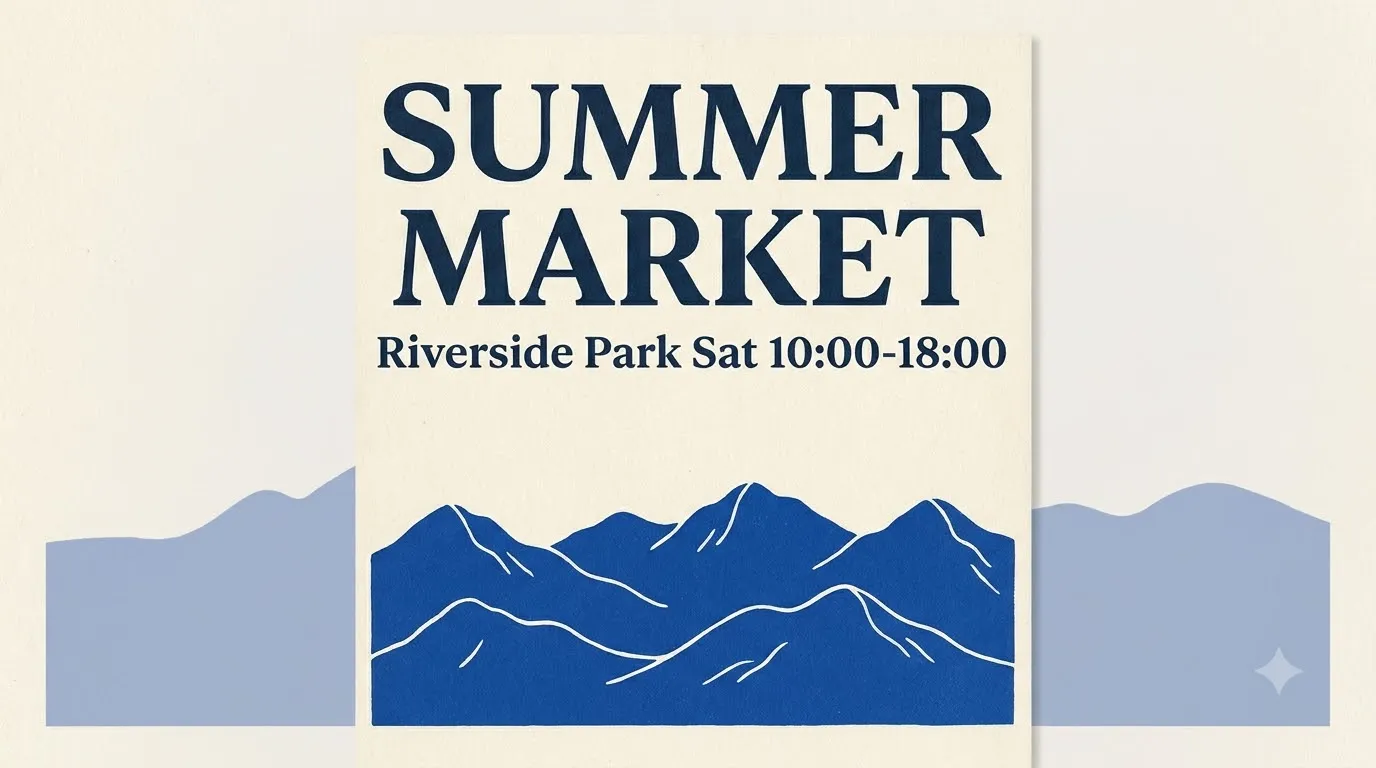
Voici une structure minimale — le titre au-dessus, l’illustration en dessous :
{
  "summary": {"meta": ["poster"], "canvas": "single",
    "caption": "A minimalist travel poster with cream background, blue mountain illustration below, and exact title SUMMER MARKET at top."},
  "items": [
    {"label": "text", "caption": "Large dark-blue title centered at top.",
     "text": "SUMMER MARKET", "bbox": [-416, -384, -288, 384]},
    {"label": "object", "caption": "A flat blue mountain illustration in lower center.",
     "bbox": [-192, -288, 384, 288]}
  ],
  "bbox_coord_space": "abs_centralized",
  "bbox_format": "yxyx"
}
Personne ne va saisir manuellement ces boîtes pour une infographie de 20 éléments. Le workflow qui se dessine chez les premiers utilisateurs consiste à demander à un LLM doté de capacités visuelles de générer le JSON à partir d’un brief ou d’une esquisse, puis à corriger les coordonnées avant de lancer la génération. Le testeur japonais @chimolog7 résume bien le problème : le format bbox est trop difficile à manipuler pour un humain, alors il l’a fait générer par Opus. Il a ensuite constaté un taux de fautes perçues d’à peine 1 % pour le rendu japonais, là où Krea 2 continuait à faire de nombreuses erreurs (publication).
L’autre astuce consiste à régénérer de manière ciblée. Comme le modèle fonctionne uniquement en texte-vers-image et n’accepte pas d’image de référence, impossible de lui fournir une photo en img2img tout en la conservant. En revanche, vous pouvez modifier le texte ou la position d’une seule boîte, conserver le même seed et relancer la génération : le reste du layout reste largement stable. L’utilisateur @li9292 l’a montré sur une couverture de rapport hebdomadaire contenant des milliers de caractères chinois et 20 boîtes : une seule boîte a été modifiée avec le même seed tandis que la mise en page restante n’a pas bougé (publication). Pour les contenus dont le texte doit être exact, cette boucle « une boîte + même seed » est plus utile que n’importe quel preset stylistique.
Pour replacer le rendu de texte dans un contexte plus large, notre test des meilleurs modèles d’image pour le rendu de texte en 2026 montre pourquoi il fallait une solution pensée d’abord pour la mise en page.
Appel API et vrai coût de la gratuité
Le chemin hébergé passe par un seul endpoint. La documentation de l’API MOSI indique POST /v1/images/generations pour moss-image-sft-1.0, avec uniquement du texte en entrée et une image en sortie : aucune image source, pas d’audio ni de vidéo, pas de streaming ni d’API de tâches asynchrones. L’amélioration du prompt est intégrée, mais désactivée par défaut ; activez-la avec prompt_enhance: true, la version de l’outil d’amélioration étant sélectionnée côté serveur.
curl https://platform.mosi.cn/v1/images/generations \
  -H "Authorization: Bearer $MOSI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "moss-image-sft-1.0",
    "prompt": "A cafe menu card on a light oak table, exact heading MORNING MENU",
    "size": "1024x1024",
    "prompt_enhance": false
  }'
Lorsque vous avez besoin d’un contrôle boîte par boîte, transmettez la chaîne JSON complète du layout dans prompt ; la forme courte en langage naturel ci-dessus reste l’appel le plus simple à copier-coller.
Au moment de la vérification, la facturation affichait Free for a limited time, soit 0 credits, avec un lien vers la tarification complète pour la suite. Le guide comparant Base et SFT relève le même flou : playground en ligne depuis le 20 octobre, mais aucun tarif durable par image publié. Il faut donc prévoir la suite — période gratuite pour prototyper, puis tarifs du fournisseur auxquels s’ajoute le coût des générations rejetées pour cause de fautes.
L’inférence locale supprime le prix par image, mais pas la facture matérielle. Le listing de fichiers Comfy-Org vérifié le 20 octobre totalise environ 29,72 Go de poids BF16 avant l’environnement et le cache : backbone ~10,16 Go, encodeur de texte ~19,31 Go, petit VAE ~0,25 Go. ConvRot en INT8 réduit environ de moitié l’empreinte du transformeur — backbone ~5,41 Go, encodeur ~9,75 Go — tandis qu’une version GPTQ W4A8 de l’encodeur descend près de 7,34 Go.
| Configuration | À télécharger | À retenir |
|---|---|---|
| BF16 complet | 29,72 Go de poids + mémoire de travail | Très juste même avec 32 Go sans offload ; la RAM système et la longueur du prompt comptent |
| INT8 quantifié | Environ 15 Go + offload | Configuration documentée avec 12 Go à ~1 MP, une image par batch (~9,7 Go au maximum dans le test communautaire cité ici) ; c’est le point de départ à privilégier avec une carte de 8 à 12 Go |
| DMD communautaire en 8 étapes / 4 étapes | Adaptateur + workflow compatible | ~24 secondes contre ~137 secondes dans le même rapport sur une RTX 3060 à 1 MP, mais les premiers adaptateurs perdaient en nuance — commencez par établir une référence à 50 étapes |
La configuration d’échantillonnage officielle utilise Euler, 50 étapes, CFG 3.0, un shift de 5.0 et un skip-layer guidance à la couche 22, en 1024x1024. La prise en charge native de ComfyUI a été intégrée le 16 octobre (annonce) ; mettez ComfyUI à jour, recherchez les templates MOSS-Image et utilisez le workflow Base ou SFT correspondant avec les fichiers Comfy-Org, plutôt que de mélanger un graphe de plugin avec un chargeur natif.
Si vous comparez plus largement les tarifs des fournisseurs, notre analyse de l’API de génération d’images la moins chère constitue un bon point de départ pour estimer le temps GPU et le coût des rejets.
Pourquoi les modèles fermés gardent l’avantage
Les limites sont claires et il vaut mieux les prendre en compte avant de confier une création à ce workflow. La version publiée est uniquement texte-vers-image. Elle ne permet ni l’édition d’image ni l’utilisation d’une image de référence ; la génération basée sur une référence est annoncée comme une évolution future. Si vous devez conserver une photo importée ou maintenir un personnage identique d’un plan à l’autre, utilisez plutôt un modèle conçu pour l’édition, comme Qwen Image 2.1 pour l’édition en production.
Les personnages et la direction artistique constituent le deuxième point faible. Avec 5B paramètres, les visages peuvent sembler génériques, les proportions dérivent et les mains reproduisent les défauts habituels.
« Il ne sait pas non plus très bien gérer les proportions des personnages. Et il reste médiocre face aux problèmes classiques de “mauvaises mains” et autres défauts du même genre. » — @SlipperyGem
Les tests pratiques cités invitent à vérifier la même liste avant publication : les prompts courts, les personnages nommés, les tags d’artistes et les contraintes exactes restent irréguliers, les petits caractères nécessitent une relecture et les langues qui ne figurent pas dans le benchmark anglais/chinois doivent faire l’objet de contrôles manuels. La configuration officielle en 50 étapes est exigeante sur une machine modeste, tandis que les adaptateurs rapides échangent une partie des nuances d’éclairage et du respect des contraintes contre de la vitesse. Pour chaque image conservée, notez le checkpoint, l’encodeur, le VAE, la précision, le prompt, le seed et le temps total, encodage compris.
Les tests de génération locale axés sur la vitesse racontent la même histoire côté matériel. Lucebox a mesuré 2,7 secondes pour une image 1024x1024 à 8 étapes, CFG 1, sur une Radeon AI PRO R9700 avec ses propres kernels, soit 1,8 fois plus rapide de bout en bout que ComfyUI sur une DGX Spark avec les mêmes réglages. Mais son contrôle visuel a relevé 4 sorties déformées sur 8 à CFG 1, contre 1 sur 8 à CFG 2,5, au prix de 5,2 secondes. Plus rapide ne signifie donc pas automatiquement plus exploitable.
FAQ sur MOSS Image API
MOSS Image est-il gratuit pour un usage commercial ?
Les poids et le code fourni sont publiés sous Apache 2.0, ce qui autorise l’usage commercial et le fine-tuning sans frais de licence. Les endpoints hébergés fixent leurs propres tarifs et règles de contenu, tandis que les quantifications ou LoRA tiers restent soumis à leurs propres conditions.
Base ou SFT : lequel utiliser avec l’API ?
L’API hébergée utilise SFT (moss-image-sft-1.0), le checkpoint affiné que l’équipe recommande pour la génération. Téléchargez SFT pour créer dès maintenant des affiches et infographies ; choisissez Base pour le fine-tuning ou l’entraînement d’un LoRA.
Peut-il fonctionner avec 12 Go de VRAM ?
Une configuration documentée fonctionne avec 12 Go grâce à un workflow quantifié et à l’offload CPU, à ~1 MP et avec une image par batch.
Peut-il retoucher une photo ou conserver un personnage parfaitement identique ?
Non. Le backbone publié ne se conditionne pas sur des images de référence. Réutiliser un seed avec un JSON modifié permet de guider une régénération, mais ne conserve ni une photographie importée ni l’identité d’un personnage de manière garantie.
À qui MOSS Image s’adresse-t-il ?
| Votre besoin | Choisissez MOSS Image si | Choisissez autre chose si |
|---|---|---|
| Affiche, menu, diapositive ou maquette d’interface avec texte exact | Le texte bilingue long et le placement au niveau des boîtes comptent davantage que le photoréalisme des personnages | Vous avez seulement besoin de slogans courts : un modèle fermé sera plus rapide à prompter |
| Pipeline e-commerce ou éditorial | Vous pouvez ajouter une étape LLM-vers-JSON et une relecture, et souhaitez des poids Apache 2.0 à héberger ou affiner vous-même | Vous avez besoin dès maintenant d’img2img, d’inpainting ou de personnages verrouillés par référence |
| Créateur local avec un budget limité | 12 Go avec quantification vous conviennent, ou la période gratuite de MOSI couvre votre prototype | Vous avez besoin d’un débit garanti, du streaming ou de tâches asynchrones : l’API hébergée ne propose encore aucun de ces éléments |
Pour les créations riches en texte dont la mise en page peut être spécifiée, MOSS Image est l’un des rares modèles ouverts dont le système de contraintes constitue réellement le produit. Dès qu’il faut qu’un visage reste le même visage, considérez-le comme un moteur typographique à utiliser aux côtés d’un modèle d’image fermé, et non comme un remplacement.