 AIREITER
Avec le tarif standard, une décision de routage fondée sur 500 tokens coûte 0,00005 $. L’API Decisions est donc suffisamment bon marché pour gérer des contrôles à grande échelle. Cela ne la rend pas pour autant fiable par défaut pour les actions sensibles : ses probabilités doivent être calibrées sur vos propres données annotées.
La facture se compte en fractions de centime, pas à l’appel
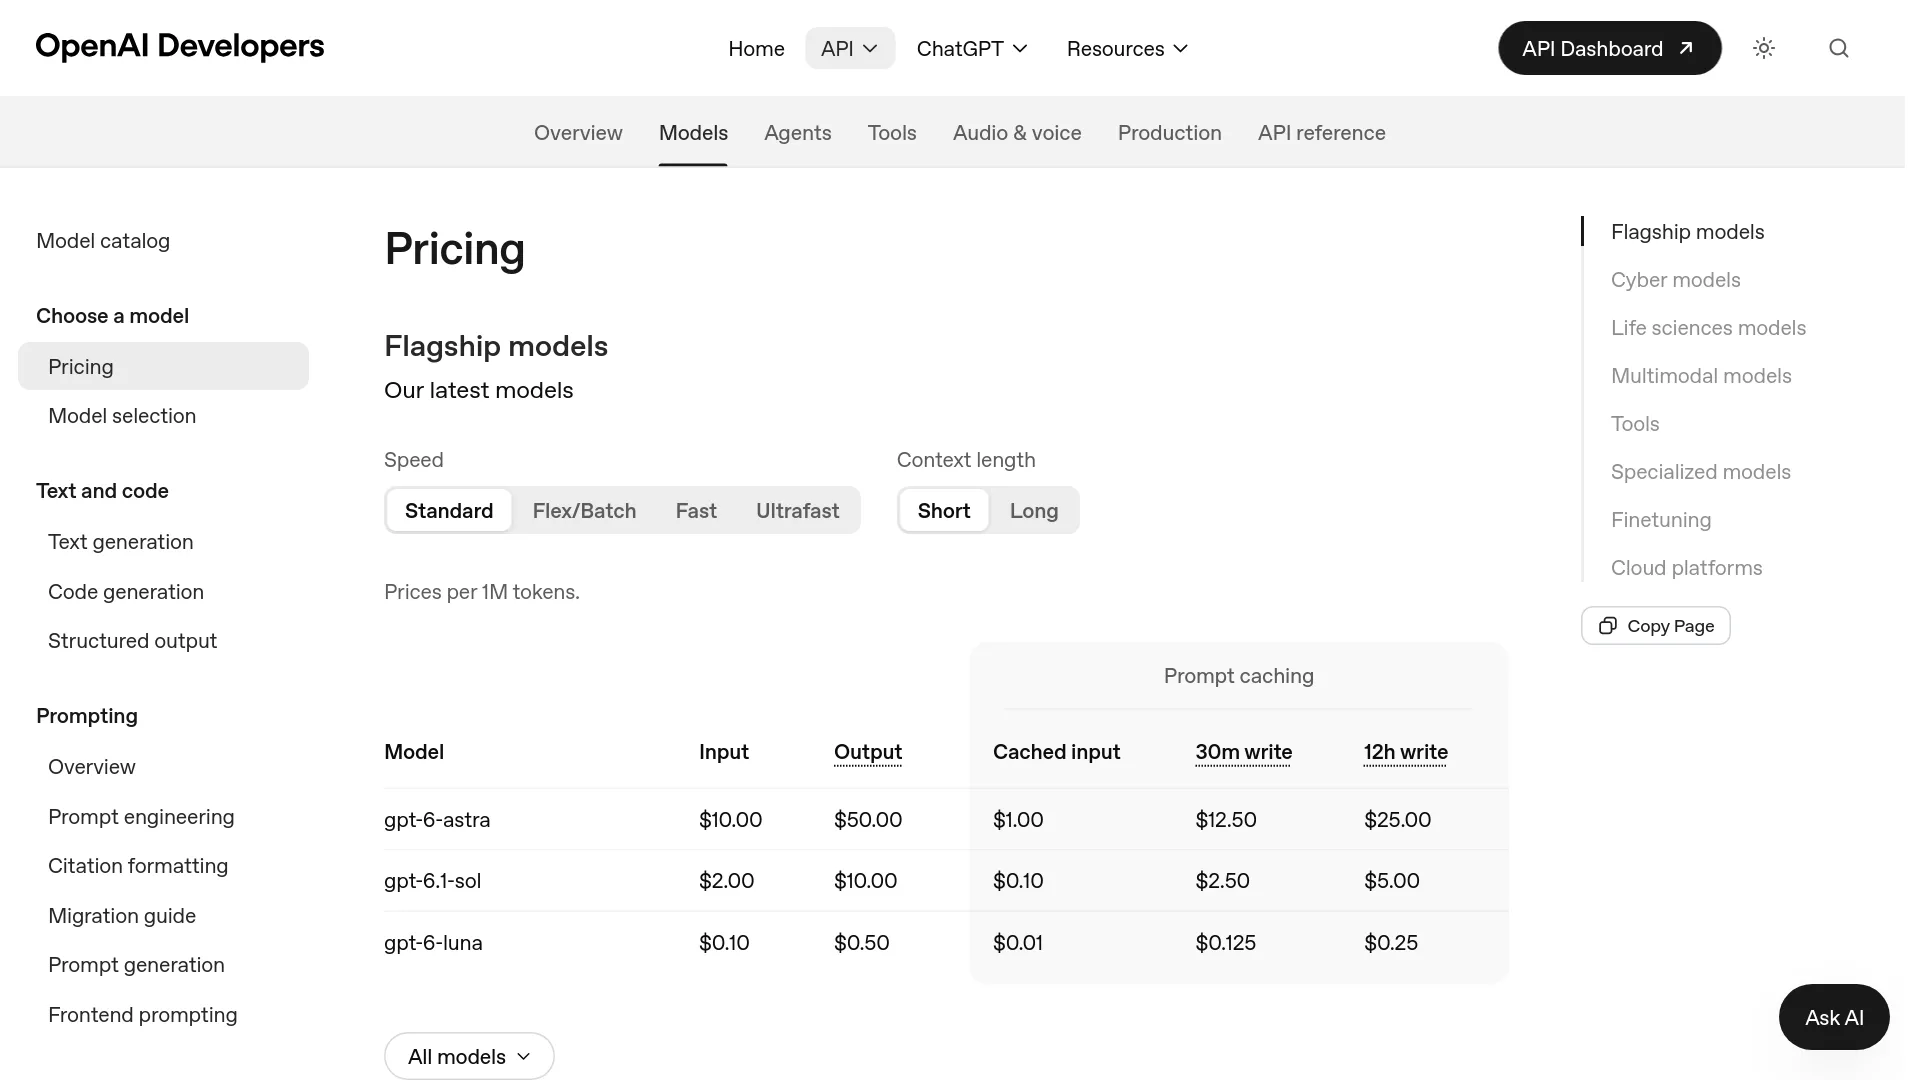
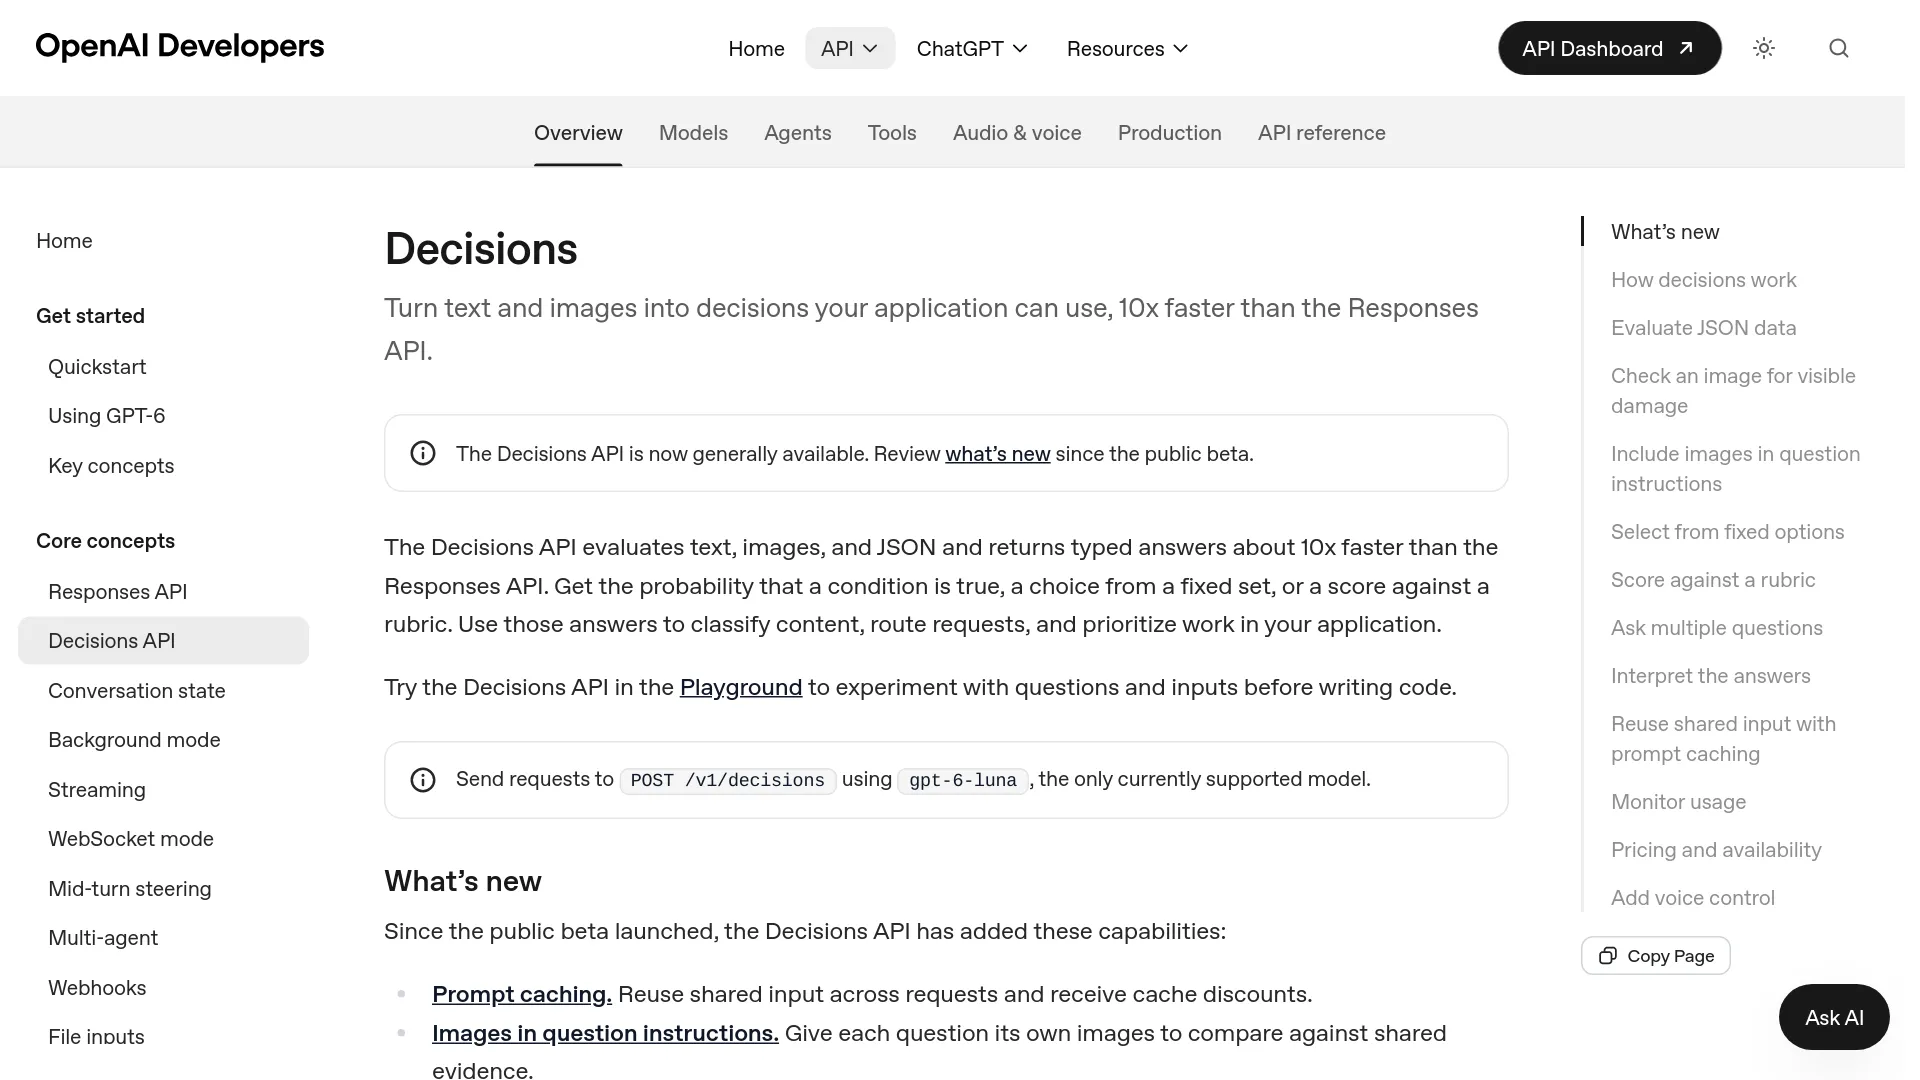
La tarification de l’API Decisions d’OpenAI est de 0,10 $ par million de tokens d’entrée non mis en cache, tandis que les tokens de sortie sont gratuits. OpenAI présente désormais cet endpoint comme généralement disponible, exclusivement propulsé par gpt-6-luna, et accessible via POST /v1/decisions dans le guide Decisions actuel.
La grille tarifaire publiée ne prévoit pas de frais distincts par requête. Le calcul de base est le suivant :
coût mensuel = requêtes × nombre moyen de tokens d’entrée facturés ÷ 1,000,000 × $0.10
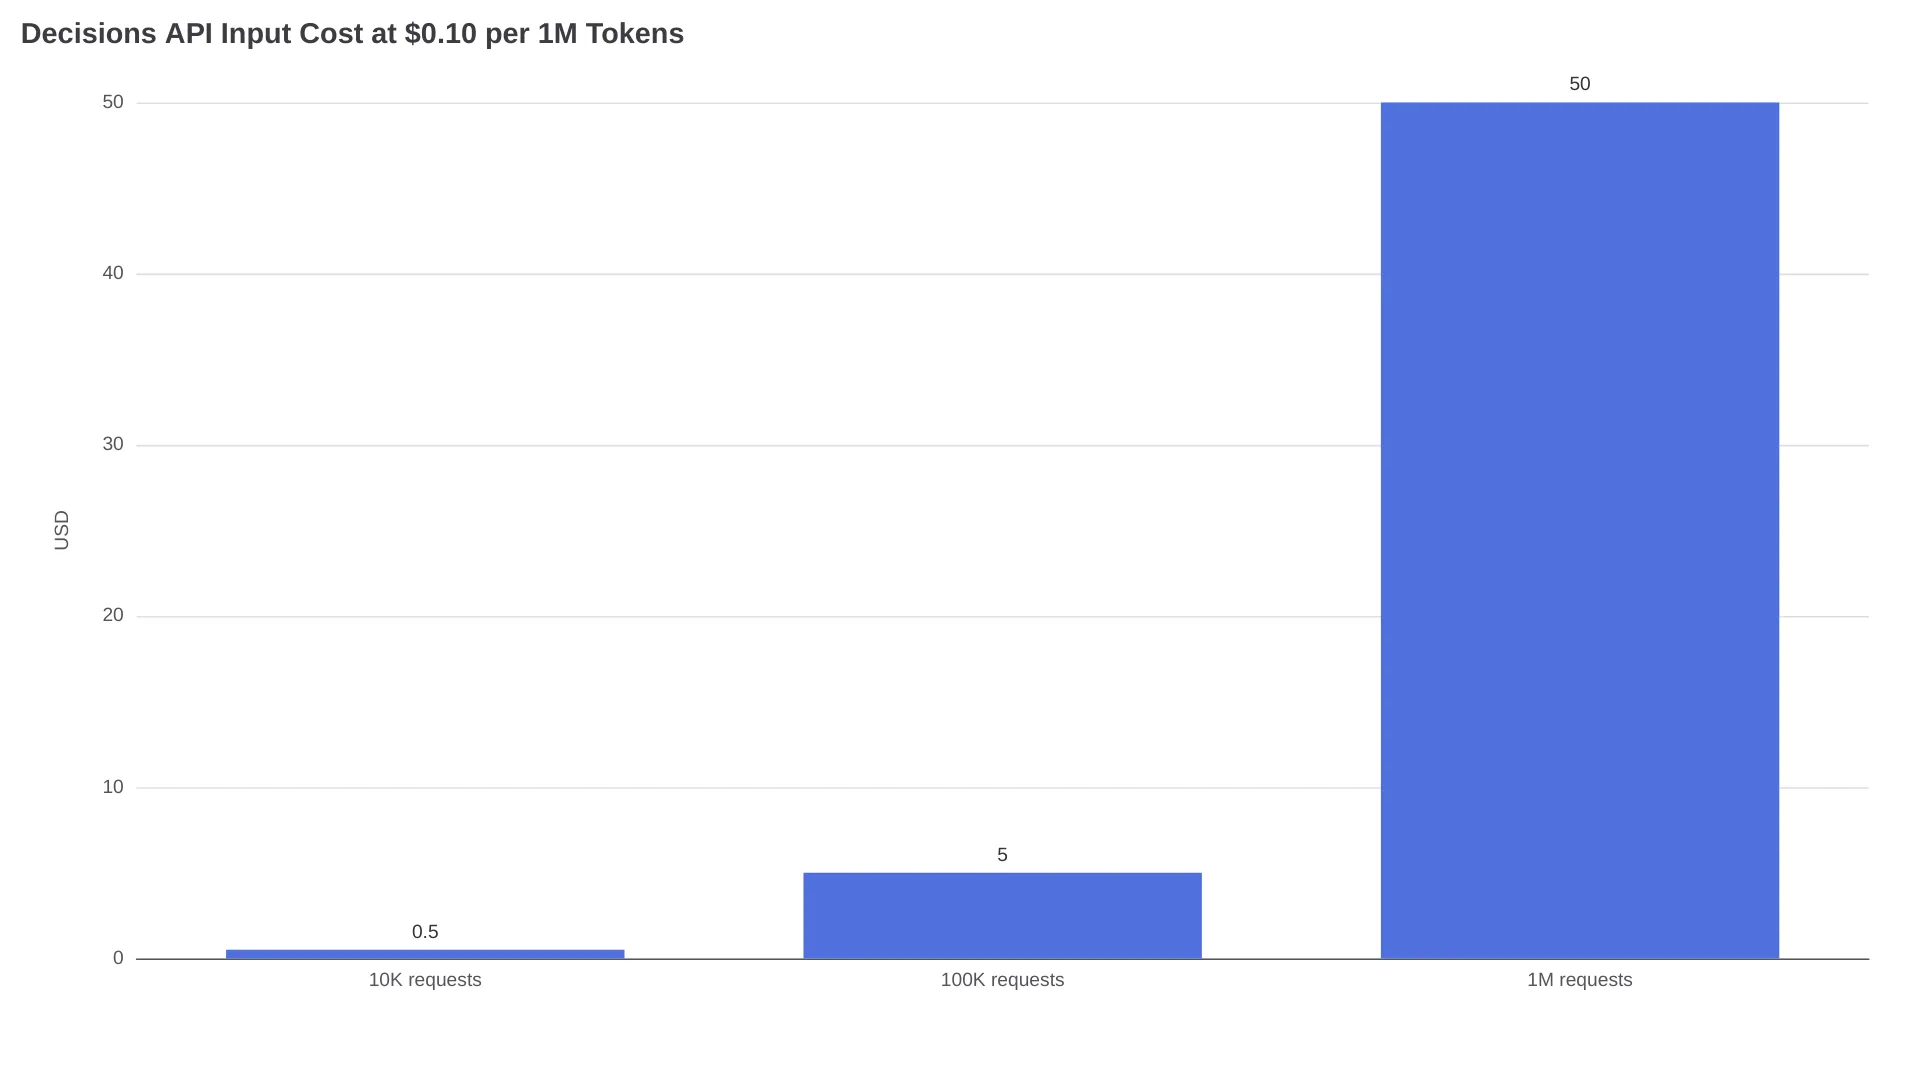
Exemples de coûts pour 10 000, 100 000 et 1 million de requêtes
Pour une charge qui compte en moyenne 500 tokens d’entrée par requête :
| Requêtes mensuelles | Tokens d’entrée | Coût standard de l’entrée | Coût par requête |
|---|---|---|---|
| 10 000 | 5 millions | 0,50 $ | 0,00005 $ |
| 100 000 | 50 millions | 5,00 $ | 0,00005 $ |
| 1 000 000 | 500 millions | 50,00 $ | 0,00005 $ |
Les sorties de type prédicat, choix et score n’ajoutent aucun frais lié aux tokens de sortie. Un JSON équivalent généré avec Responses est facturé au tarif de sortie du modèle ; le tableau des tarifs d’OpenAI indique un prix standard de 0,50 $ par million de tokens de sortie pour gpt-6-luna.
Lectures et écritures du cache, traitement régional et contexte long
Le tarif de 0,10 $ n’est pas le seul prix possible pour les tokens d’entrée. Le guide actuel précise que les lectures du prompt cache bénéficient d’un tarif réduit, tandis que les écritures utilisent les tarifs standard d’écriture du cache de gpt-6-luna. La grille tarifaire d’OpenAI indique, pour Luna, 0,01 $ par million de tokens d’entrée lus depuis le cache, 0,125 $ pour une écriture avec conservation de 30 minutes et 0,25 $ pour une conservation de 12 heures.
La mise en cache ne commence que lorsque le préfixe partagé réutilisable contient au moins 1 024 tokens. Les questions ne sont pas comptabilisées dans ce minimum, et les images propres à chaque question restent en dehors du préfixe réutilisable. Les lectures et écritures du cache sont déjà incluses dans usage.input_tokens ; les ajouter une seconde fois reviendrait à compter l’utilisation en double, comme l’explique la section consacrée au prompt caching.
Les endpoints régionaux ou soumis à des exigences de résidence des données peuvent appliquer une majoration de 10 % pour certains modèles récents. La section officielle sur les tarifs et la disponibilité avertit également que des multiplicateurs liés aux contextes longs peuvent s’appliquer. Consultez la grille tarifaire en vigueur avant de déployer une charge soumise à des contraintes de conformité : ces deux modificateurs peuvent changer le simple calcul basé sur 0,10 $.
Un endpoint volontairement spécialisé
L’API Decisions transforme des éléments de preuve en l’un de trois résultats typés. C’est un outil de classification et de scoring, pas une version moins chère d’un endpoint de réponse généraliste.
| Type de question | Résultat renvoyé | Bon cas d’usage | Mauvais cas d’usage |
|---|---|---|---|
predicate | Probabilité comprise entre 0 et 1 | Filtre antifraude, détection de dommages visibles, filtre de pertinence | Obtenir une justification écrite de la décision |
choice | Une option fournie, les probabilités des options et le niveau de confiance | Routage vers une file, catégorie de document, prochaine action | Une catégorie inconnue ou générée dynamiquement |
score | Score pondéré, probabilités par niveau et niveau de confiance | Gravité, urgence, qualité d’un prospect | Extraire des noms, des dates ou des champs arbitraires |
Un score accepte de 2 à 10 niveaux ordonnés. Une requête peut contenir de 1 à 400 questions, mais seules les questions indépendantes doivent être regroupées. Si la question deux dépend de la réponse à la question une, OpenAI recommande d’envoyer une seconde requête après réception de la première réponse.
Plusieurs questions indépendantes peuvent réutiliser les mêmes éléments de preuve. Un même ticket d’assistance peut ainsi être analysé pour détecter une demande de remboursement, orienté vers le bon service et évalué selon son urgence, sans renvoyer trois fois le ticket. Le guide consacré à l’utilisation précise que num_model_requests compte la requête, pas le nombre de questions qu’elle contient.
Ce qui a changé depuis la bêta publique
La liste actuelle des nouveautés supprime plusieurs limites présentes au lancement :
- Le plafond de questions est passé de 200 à 400.
- La mise en cache des prompts est disponible pour les entrées partagées.
- Les entrées peuvent inclure du JSON natif, un historique de conversation, des enregistrements d’appels de fonctions et les résultats d’outils correspondants.
- Les images peuvent être fournies via des URL HTTP/HTTPS publiques ou en base64 inline ;
file_id, l’audio, les fichiers et les références à des items restent incompatibles. - Les rapports d’utilisation au niveau de l’organisation sont accessibles via
GET /v1/organization/usage/decisions; ils nécessitent une clé administrateur avecapi.usage.readet peuvent regrouper les résultats par projet, clé API ou modèle.
Choisissez Decisions ou Responses selon le contrat de sortie
Privilégiez l’API Decisions lorsque le code de l’application connaît déjà la forme attendue de la réponse. Choisissez Responses lorsque le modèle doit composer des informations, et l’appel de fonctions lorsqu’il doit sélectionner un outil et fournir ses arguments.
| Besoin | Choix par défaut | Pourquoi |
|---|---|---|
| Décision oui/non avec probabilité | Decisions | Sortie de type prédicat native ; aucun frais de génération de réponse |
| Sélectionner une route connue | Decisions | Renvoie la probabilité de chaque option ainsi que le niveau de confiance |
| Évaluer selon une grille ordonnée | Decisions | Score pondéré natif et répartition par niveau |
| Renvoyer des champs JSON arbitraires | Responses avec Structured Outputs | Decisions ne permet pas de définir un schéma de sortie JSON personnalisé |
| Expliquer pourquoi un élément a été rejeté | Responses | Decisions ne génère pas d’explications en prose |
| Choisir un outil et construire ses arguments | Function calling | Decisions sélectionne une réponse, mais ne produit pas les arguments de l’outil |
Pour 100 000 appels contenant chacun 400 tokens d’entrée, les tokens d’entrée de Decisions coûtent 4 $. Si un appel Responses équivalent génère 30 tokens de sortie par requête, les tarifs publiés de Luna donnent 4 $ d’entrée auxquels s’ajoutent 1,50 $ de sortie, soit 5,50 $ avant les éventuels tokens de raisonnement. Le choix de l’endpoint dépend toutefois toujours du besoin de générer des champs ou des explications.
Les deux endpoints bénéficient désormais de tarifs réduits pour les lectures du cache. Mesurez les tokens lus depuis le cache à partir de l’objet d’utilisation renvoyé par la réponse, plutôt que de les estimer à partir de la longueur du prompt.
Une erreur bon marché peut quand même coûter cher
Une facture faible ne réduit pas le coût d’une approbation erronée, d’une mauvaise action de modération ou d’un routage de paiement incorrect. Le guide d’OpenAI consacré à l’interprétation des réponses recommande de définir les seuils à partir d’exemples annotés et de pondérer différemment les coûts des faux positifs et des faux négatifs.
Cette prudence ressort aussi des échanges entre développeurs. Dans une discussion Reddit orientée production au sujet des API de décision, u/Ctbhatia écrit :
« un garde-fou qui préfère ignorer vaut mieux qu’un garde-fou qui se trompe. » Source : u/Ctbhatia sur r/LLMDevs
Le niveau de confiance et les probabilités de l’API sont des indicateurs, pas une garantie de calibration publiée. Un résultat affichant une confiance de 0,90 ne doit pas être considéré comme correct dans 90 % des cas tant que cette relation n’a pas été mesurée sur des données représentatives.
Dans son guide officiel, OpenAI affirme que Decisions est environ 10 fois plus rapide que Responses, mais ne publie aucun chiffre p50 ou p95, ni précision sur la région, la taille des charges utiles ou la configuration de comparaison. Effectuez vos benchmarks depuis la région de déploiement visée avant de fixer un budget de latence.
Le passage en production : calibrer, s’abstenir, puis automatiser
- Constituez un jeu de données annotées à partir de la charge réelle, en incluant les cas ambigus et les scénarios d’échec les plus coûteux.
- Exécutez les mêmes questions sur ce jeu de données et mesurez les taux de faux positifs et de faux négatifs selon différents seuils.
- Ajoutez un chemin d’abstention explicite dans le code de l’application. Les réponses peu fiables ou contradictoires doivent être envoyées en revue humaine plutôt que de forcer un routage.
- Surveillez l’utilisation des tokens et le nombre de requêtes avec
GET /v1/organization/usage/decisions, puis auditez un échantillon des résultats automatisés après le lancement.
Tableau d’aide au déploiement
L’API Decisions d’OpenAI est le choix par défaut pour les évaluations courtes, bornées et exécutées à grande échelle au sein d’une stack OpenAI existante. Son prix, à lui seul, ne justifie pas une migration.
| Charge | Recommandation | Condition principale |
|---|---|---|
| Routage de tickets ou de prospects | Utiliser Decisions | Les catégories sont fixes et des exemples annotés sont disponibles |
| Détection de dommages sur des images | Tester Decisions | Évaluer la précision sur les images ; les URL hébergées sont désormais prises en charge |
| Politique longue et élément court | Tester les deux endpoints | Vérifier les tokens réellement lus depuis le cache et la latence |
| Conformité ou action destructive | Utiliser Decisions uniquement comme garde-fou | Prévoir l’abstention, la revue humaine et des seuils asymétriques |
| Extraction avec explication | Utiliser Responses | Un appel plus riche peut éviter une seconde requête de génération |
| Sélection d’un outil avec arguments | Utiliser function calling | Le contrat de sortie correspond directement à l’action |
| Charge européenne ou réglementée | Envisager Decisions | Confirmer l’éligibilité, la résidence des données et la majoration régionale |
FAQ sur les tarifs de l’API Decisions d’OpenAI
L’API Decisions est-elle facturée à la requête ou au token ?
Elle est facturée selon le nombre de tokens d’entrée, et non selon le nombre de requêtes. Les tokens d’entrée standard non mis en cache coûtent actuellement 0,10 $ par million, avant l’application éventuelle des règles de cache et des majorations régionales ou liées aux contextes longs.
Les tokens de sortie de l’API Decisions sont-ils gratuits ?
Oui. Le guide officiel de Decisions précise que les tokens de sortie ne sont pas facturés.
Existe-t-il une offre gratuite ?
La documentation actuelle d’OpenAI sur Decisions ne mentionne pas d’offre gratuite dédiée. Les crédits disponibles sur le compte ou les conditions contractuelles peuvent toutefois modifier le montant payé par une organisation.
Le prompt caching fonctionne-t-il avec l’API Decisions ?
Oui. Les préfixes d’entrée partagés d’au moins 1 024 tokens peuvent être éligibles, et OpenAI place par défaut un point de séparation implicite à la fin de l’entrée partagée. Le contenu des questions et les images propres à chaque question ne font pas partie de ce préfixe réutilisable.
Decisions est-elle moins chère que l’API Responses ?
Généralement, oui, pour les classifications courtes et bornées qui ne nécessitent pas de texte généré. L’avantage peut se réduire lorsque Responses produit très peu de tokens, voire disparaître si le workflow nécessite un second appel pour l’extraction ou l’explication.
Combien de questions peut-on inclure dans une requête ?
La limite actuelle est comprise entre 1 et 400 questions. Les questions indépendantes peuvent partager les mêmes entrées ; les questions dépendantes nécessitent des requêtes séparées.
Les images sont-elles prises en charge et facturées ?
Oui. Decisions accepte les URL d’images HTTP/HTTPS hébergées ainsi que les images inline encodées en base64, et les images d’entrée sont incluses dans l’utilisation facturée. Les références d’images file_id ne sont pas prises en charge.
Le traitement régional coûte-t-il plus cher ?
C’est possible. La page des tarifs d’OpenAI applique une majoration de 10 % aux endpoints régionaux et soumis à des exigences de résidence des données pour certains modèles récents ; vérifiez le tarif en vigueur dans la région cible avant le déploiement.