 AIREITER
À caractéristiques presque égales, l'écart de facture est considérable. Kimi K3 et Qwen 3.8 Max sont deux modèles mixture-of-experts chinois dotés d'un contexte d'un million de tokens, lancés à trois semaines d'intervalle et configurés pour raisonner au maximum par défaut. Kimi K3 est le meilleur choix pour le code, mais ses tokens de sortie coûtent $15 par million, soit 2,5× les $6 de Qwen 3.8 Max. Qwen est donc l'option la plus récente et la moins chère, disponible en GA depuis le 3 août 2026, avec l'avantage sur les graphiques et l'usage informatique. Revers de la médaille : les deux modèles génèrent systématiquement beaucoup de raisonnement, ce qui amplifie le surcoût de sortie de Kimi ; et les poids ouverts de Qwen ne sont pas attendus avant environ le 11 août.
Deux mastodontes très proches, mais un vrai arbitrage
Qwen 3.8 Max et Kimi K3 sont deux modèles mixture-of-experts de plusieurs milliers de milliards de paramètres, avec une fenêtre de contexte d'un million de tokens et une vision native. Tous deux sont sortis à moins de trois semaines d'écart au milieu de 2026. Sur le papier, ils évoluent dans la même catégorie, ce qui réduit souvent leur comparaison à un simple ping-pong de benchmarks. Le choix est en réalité plus ciblé : accepterez-vous un coût de sortie supérieur pour gagner en qualité de code, et avez-vous besoin dès maintenant de poids ouverts ou d'un modèle multimodal particulièrement solide ?
| Caractéristique | Qwen 3.8 Max | Kimi K3 |
|---|---|---|
| Paramètres totaux | 2.4T | 2.8T |
| Actifs par token | ~95B | 104B |
| Architecture | MoE (~4% actifs) | MoE (16 experts sur 896) |
| Fenêtre de contexte | ~1M (991K d'entrée max.) | 1,048,576 |
| Vision | Oui (entrée texte + image) | Oui (native) |
| Raisonnement par défaut | xhigh, réflexion activée | effort maximal, raisonnement activé |
| Poids ouverts | Non (attendus vers le 11 août) | Oui (HF, 27 juil., 1.56TB MXFP4) |
| Statut de l'API | GA, 3 août 2026 | GA |
Sources : comparatif direct de yottalabs, Alibaba QwenCloud via AIReiter et Moonshot platform.kimi.ai, vérifiés le 6 août 2026.
Tarifs, coût réel d'une charge de travail et accès
Les deux éditeurs affichent leurs tarifs au token, mais l'écart ne se situe pas forcément là où les nombres de paramètres le laisseraient penser. Il se concentre sur les tokens de sortie, là où les modèles de raisonnement consomment l'essentiel du budget. Kimi K3 facture $15 par million de tokens de sortie, contre $6 pour Qwen 3.8 Max. Comme les deux modèles exposent leur raisonnement par défaut, ce prix s'applique aussi bien aux traces de réflexion qu'à la réponse finale.
| Prix pour 1M de tokens | Qwen 3.8 Max | Kimi K3 |
|---|---|---|
| Entrée (cache manqué) | $2.00 | $3.00 |
| Entrée (cache atteint) | $0.25 | $0.30 |
| Sortie (réflexion incluse) | $6.00 | $15.00 |
| Contexte | ~1M | 1,048,576 |
Sources : page modèle Alibaba QwenCloud, mise à jour le 2 août 2026, et Moonshot platform.kimi.ai/docs/pricing/chat-k3, vérifiées le 6 août 2026.
Sur une charge de code typique comprenant 20M de tokens d'entrée, avec 60% de cache atteint, et 5M de tokens de sortie, Kimi K3 revient à environ $103 ($27.60 d'entrée et $75 de sortie), contre environ $49 pour Qwen 3.8 Max ($19 d'entrée et $30 de sortie). L'écart de 2× vient presque entièrement de la sortie : le cache réduit la différence à l'entrée, mais rien ne réduit celle des sorties. Or, puisque les deux modèles raisonnent au maximum par défaut, cette part devient importante.
L'accès n'est pas symétrique. Qwen 3.8 Max est devenu disponible en général via l'API d'Alibaba le 3 août 2026, mais ses poids ne sont pas publics : sa page indique toujours Open Source: No, avec une publication attendue sur Hugging Face et ModelScope durant la semaine du 11 août (Alibaba, via la page tarifaire de Qwen 3.8 Max). Kimi K3 est l'option ouverte : Moonshot a publié le checkpoint MXFP4 de 1.56 TB le 27 juillet, et son API est active.
Kimi K3 est également accessible via l'endpoint API Kimi K3 d'AIReiter, au tarif officiel de Moonshot et sans marge. C'est pratique pour tester K3 face à d'autres modèles avec une seule facture. Qwen 3.8 Max n'y est pas encore intégré.
Kimi K3 prend l'avantage sur le code agentique
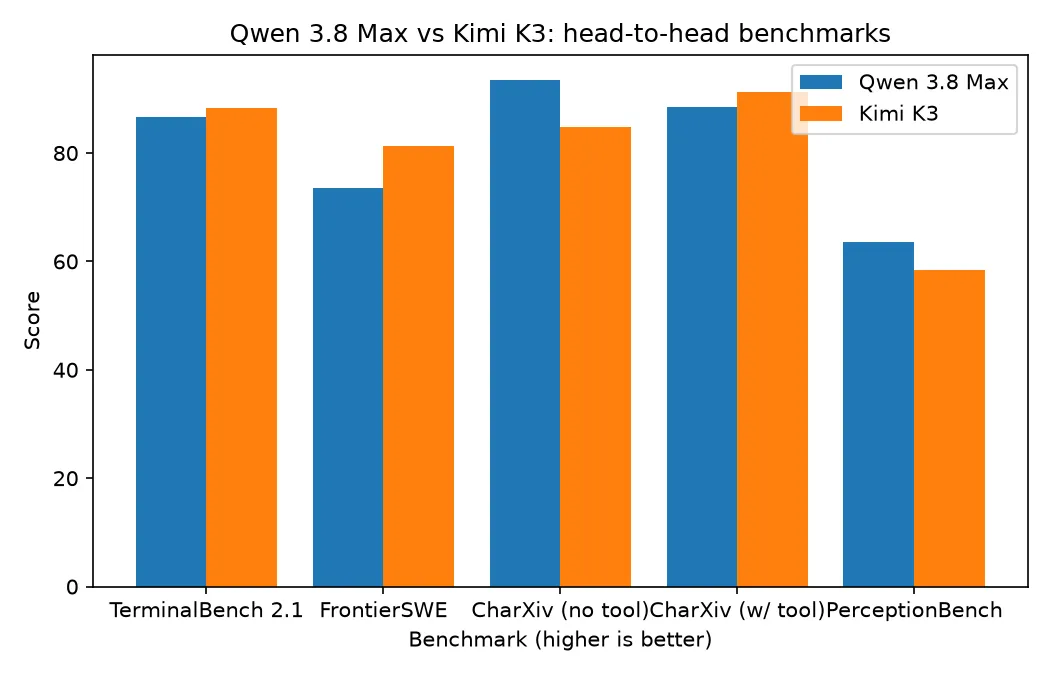
Kimi K3 est le choix à privilégier pour le code en plusieurs étapes : boucles d'agents, refactoring de dépôts, tâches de type SWE qui demandent d'appeler des outils puis de se sortir d'impasses. Il devance régulièrement Qwen 3.8 Max sur les benchmarks agentiques publics, avec un écart particulièrement net sur les tâches les plus proches du travail d'ingénierie réel.
| Benchmark | Qwen 3.8 Max | Kimi K3 |
|---|---|---|
| FrontierSWE | 73.5 | 81.2 |
| TerminalBench 2.1 | 86.6 | 88.3 |
| CharXiv (avec outil) | 88.4 | 91.3 |
Source : comparatif direct de yottalabs, vérifié le 6 août 2026.
Le verdict de la communauté va dans le même sens, avec la réserve de coût qui définit toute cette comparaison :
« K3 est dans une catégorie à part. Qwen 3.8 lui est presque comparable. Cela dit, l'abonnement ou le coût API ne se justifie pour aucun des deux modèles tels qu'ils sont… » — r/Qwen_AI
« K3 écrase largement Qwen 3.8 sur cet exercice ; Qwen a généré cette landing page 3 fois plus vite que Kimi. » — @filicroval sur X
Kimi K3 affiche aussi un score d'intelligence brute supérieur, avec un Artificial Analysis Intelligence Index de 57, mais il est lent : environ 39 tokens de sortie par seconde et 3.1 secondes avant le premier token (Artificial Analysis). On échange donc de la latence et un coût supérieur contre davantage de qualité et des poids ouverts.
Qwen 3.8 Max : meilleur en multimodal, plus intéressant au prix
Qwen 3.8 Max est le choix pertinent lorsque les tâches reposent sur la lecture de graphiques, de captures d'écran ou le pilotage d'un navigateur, et lorsque le coût de sortie prime sur les derniers points gagnés dans un benchmark de code. Il bat Kimi K3 sur les benchmarks documentaires et de perception, détient un état de l'art vérifié sur un benchmark d'usage informatique, et ne facture que 40% du tarif de sortie de Kimi K3.
| Benchmark | Qwen 3.8 Max | Kimi K3 |
|---|---|---|
| CharXiv (sans outil) | 93.5 | 84.8 |
| PerceptionBench | 63.5 | 58.5 |
| OSWorld-Verified | 86.1% (SOTA) | aucun score public |
Source : comparatif direct de yottalabs, vérifié le 6 août 2026.
Le point faible de Qwen 3.8 Max correspond précisément au terrain de prédilection de Kimi K3, celui où ce dernier rejoint les modèles fermés de pointe. Sur SWE-bench Pro, Qwen atteint 67.7, loin des 80 de Claude Fable 5 (tableau publié par Alibaba, exécuté par le fournisseur) : ce n'est donc pas le modèle à retenir pour les évaluations d'ingénierie logicielle les plus ardues. Son API n'a par ailleurs que trois jours au moment de la rédaction, la disponibilité générale datant du 3 août 2026, et ses poids restent fermés. Ceux qui doivent auto-héberger dès aujourd'hui devront attendre ou choisir Kimi K3.
Quel modèle choisir selon votre charge de travail ?
Le bon choix dépend moins d'un vainqueur absolu que de l'usage que vous ferez du modèle. Le tableau ci-dessous associe les charges de travail les plus courantes au modèle recommandé, avec la raison vérifiée qui motive ce choix.
| Si votre charge de travail concerne… | Choisissez | Pourquoi |
|---|---|---|
| Boucles d'agents, refactoring de dépôts, tâches SWE (si le coût n'est pas la contrainte) | Kimi K3 | FrontierSWE 81.2 contre 73.5, TerminalBench 88.3 contre 86.6 |
| Analyse de documents et graphiques, navigateur ou usage informatique, budget sensible | Qwen 3.8 Max | CharXiv 93.5, OSWorld 86.1% SOTA, $6 contre $15 en sortie |
| Auto-hébergement aujourd'hui | Kimi K3 | Poids disponibles sur HF depuis le 27 juil. ; ceux de Qwen arrivent vers le 11 août |
FAQ
Qwen 3.8 Max est-il meilleur que Kimi K3 pour coder ?
Non. Kimi K3 domine les benchmarks de code agentique les plus pertinents, avec 81.2 contre 73.5 sur FrontierSWE et 88.3 contre 86.6 sur TerminalBench 2.1. Pour les tâches d'ingénierie en plusieurs étapes, Kimi K3 est donc le choix le plus solide.
Lequel est le moins cher, Qwen 3.8 Max ou Kimi K3 ?
Qwen 3.8 Max. Il facture $6 par million de tokens de sortie, contre $15 pour Kimi K3, et $2 en entrée contre $3. Avec des tarifs proches sur les accès au cache, l'écart atteint environ 2× sur une charge de code typique.
Lequel coûte le moins cher pour du code agentique avec raisonnement maximal ?
Toujours Qwen 3.8 Max : les deux modèles facturent les tokens de raisonnement comme des tokens de sortie à effort maximal. Le tarif de $15/M de Kimi K3 creuse donc l'écart précisément sur le type de charge de code où il est le meilleur.
Les deux modèles prennent-ils en charge un contexte d'un million de tokens ?
Oui. Qwen 3.8 Max accepte environ 991K tokens en entrée, moins lorsque la réflexion est activée, tandis que Kimi K3 en accepte 1,048,576. Les deux offrent nominalement une fenêtre d'un million de tokens.
Les poids sont-ils ouverts ?
Ceux de Kimi K3 le sont. Moonshot a publié le checkpoint MXFP4 de 1.56 TB le 27 juillet 2026. Ceux de Qwen 3.8 Max ne le sont pas encore : Alibaba les présente comme fermés, avec une sortie sur Hugging Face et ModelScope attendue durant la semaine du 11 août.
À lire aussi
- Page modèle Kimi K3 : présentation détaillée de Kimi K3
- Tarifs API de Qwen 3.8 Max : détail complet des prix et des caractéristiques techniques de Qwen 3.8 Max
- Qwen3.8-27B : la version Qwen 3.8 plus légère à poids ouverts pour l'auto-hébergement
- Kimi K2.7 Code vs GLM 5.2 : une comparaison connexe dans la même famille de modèles de code