Avec Tool Retrieval dans l’API Gemini, un agent peut référencer des centaines d’outils sans en charger immédiatement tous les paramètres. Il ne récupère que les schémas complets nécessaires à la tâche en cours. Le revers de la médaille, c’est que chaque recherche déclenche un nouveau passage du modèle : si elle intervient à chaque tour, la facture peut augmenter au lieu de baisser.
Cette fonction a été lancée en préversion le 19 novembre 2026, uniquement dans l’Interactions API, selon l’annonce de Google. Elle ajoute un outil tool_search ainsi qu’un indicateur defer_loading: true. Les outils différés exposent leur nom et leur description, tandis que le JSON de leurs paramètres reste hors du contexte. Aucun tarif spécifique ne s’applique : la facturation standard des entrées, des entrées mises en cache et des sorties reste valable.
Pourquoi 200 outils pouvaient coûter 164 000 tokens avant le moindre appel
Ce n’est pas seulement le nombre d’outils qui compte, mais surtout la taille de leurs schémas. Dans les catalogues volumineux, ceux-ci peuvent occuper l’essentiel du prompt.
Une analyse technique indépendante des documents de Google met en avant un écart parlant : environ 164 000 tokens d’entrée sans différer les schémas, contre quelque 23 650 avec Tool Retrieval, pour une bibliothèque de 200 outils dont seuls quelques-uns sont utilisés par requête. Il s’agit d’une illustration basée sur des chiffres ronds, pas d’un benchmark. L’idée est simple : vous ne payez plus pour les schémas qui ne servent jamais.
Le deuxième enjeu est la précision. Lorsque des dizaines de schémas similaires se retrouvent dans le contexte, le modèle a davantage de possibilités de sélectionner le mauvais outil. Google présente donc Tool Retrieval comme un moyen de réduire à la fois la consommation de tokens et les erreurs de sélection. Aucun chiffre de précision n’a été publié : cette seconde promesse reste à vérifier sur vos propres tâches.
Comment fonctionne Gemini Tool Retrieval avec tool_search et defer_loading
La configuration repose sur deux fragments de déclaration abrégés : une entrée tool_search de type {"type": "tool_search"}, puis "defer_loading": true pour chaque outil différé. La structure complète de la requête figure dans l’analyse de la documentation. Le modèle continue de voir le nom et la description de chaque outil différé. Comme l’explique le guide consacré à defer_loading, si short_description est défini, c’est cette version qui est affichée au modèle ; sinon, il voit la première phrase de la description complète.
En mode serveur, tout se déroule dans une seule requête :
- Le modèle émet un
tool_search_call, par exemple pour demanderissue_refund. - L’API renvoie un
tool_search_resultcontenant le schéma complet. - Le modèle émet le véritable
function_call— dans l’exemple de remboursement de Google, il utiliseorder_id: "A-1042"etamount: 40avec le modèlegemini-4-hydrogen. - Votre code exécute l’action et renvoie un
function_result.
Journalisez tout ce qui apparaît dans interaction.steps. Si le mauvais outil est chargé, commencez par examiner la trace : des noms ou des descriptions trop vagues sont souvent en cause.
Mode serveur ou client : une seule requête contre un aller-retour supplémentaire
| Mode | Qui effectue la recherche ? | Index à construire | Allers-retours supplémentaires | Cas idéal |
|---|---|---|---|---|
| Serveur (par défaut) | Gemini | Aucun — « Il n’y a aucun index à construire ou à héberger. » | Aucun, dans la même requête | Grandes bibliothèques plutôt statiques ; serveurs MCP complets |
Client ("execution": "client") | Votre application | Votre registre ou index vectoriel | Un par recherche | Autorisations par utilisateur, registres privés, outils ajoutés en cours de conversation |
La récupération côté serveur ne nécessite aucun index hébergé et s’effectue dans la même réponse. En ajoutant defer_loading: true à un outil mcp_server, vous différez tous les outils exposés par ce serveur, selon l’analyse de la documentation.
En mode client, tool_search est utilisé avec "execution": "client" — l’exemple emploie le nom search_tools et une chaîne query obligatoire. Votre application renvoie les résultats dans un function_result, puis enchaîne avec client.interactions.create en transmettant previous_interaction_id. Toujours selon cette analyse, une seule recherche tool_search est autorisée par requête et les deux modes ne peuvent pas être combinés.
Privilégiez le mode client lorsque les autorisations dépendent de l’utilisateur ou que des intégrations peuvent apparaître en cours de conversation : une recherche côté serveur dans un catalogue partagé n’applique pas à elle seule le filtrage des permissions utilisateur, d’après l’analyse citée. C’est également le seul mode qui permet de faire apparaître des outils au milieu de la conversation sans tout déclarer dès le départ.
Facturation de Gemini Tool Retrieval : 26 tokens maintenant, puis un nouveau passage complet
Tool Retrieval n’ajoute aucun frais spécifique, comme le précise l’annonce de Google : « Tool Retrieval n’a aucun coût supplémentaire. » Quatre postes restent toutefois mesurés, selon l’analyse économique des tokens :
tool_searchajoute à chaque requête un petit bloc fixe de tokens d’entrée.- L’analyse citée estime à environ 26 tokens chaque ligne contenant le nom et la description d’un outil différé.
- Chaque recherche côté serveur déclenche un nouveau passage du modèle sur le contexte actuel. D’après cette analyse, il est facturé via
total_tool_use_tokens, à un volume proche de celui du prompt d’entrée, déduction faite des éléments récupérés depuis le cache. - Chaque schéma chargé continue d’être facturé comme entrée pour le reste de la conversation et ne peut pas être retiré.
| Charge de travail (estimations illustratives de l’analyse citée) | Sans récupération | Avec récupération | Verdict |
|---|---|---|---|
| 200 outils, quelques-uns utilisés par tâche | ~164 000 tokens | ~23 650 tokens | Économie |
| 10 outils, contexte de 30 000 tokens, recherche presque à chaque tour | ~68 000 tokens | ~92 830 tokens | Coûte plus cher |
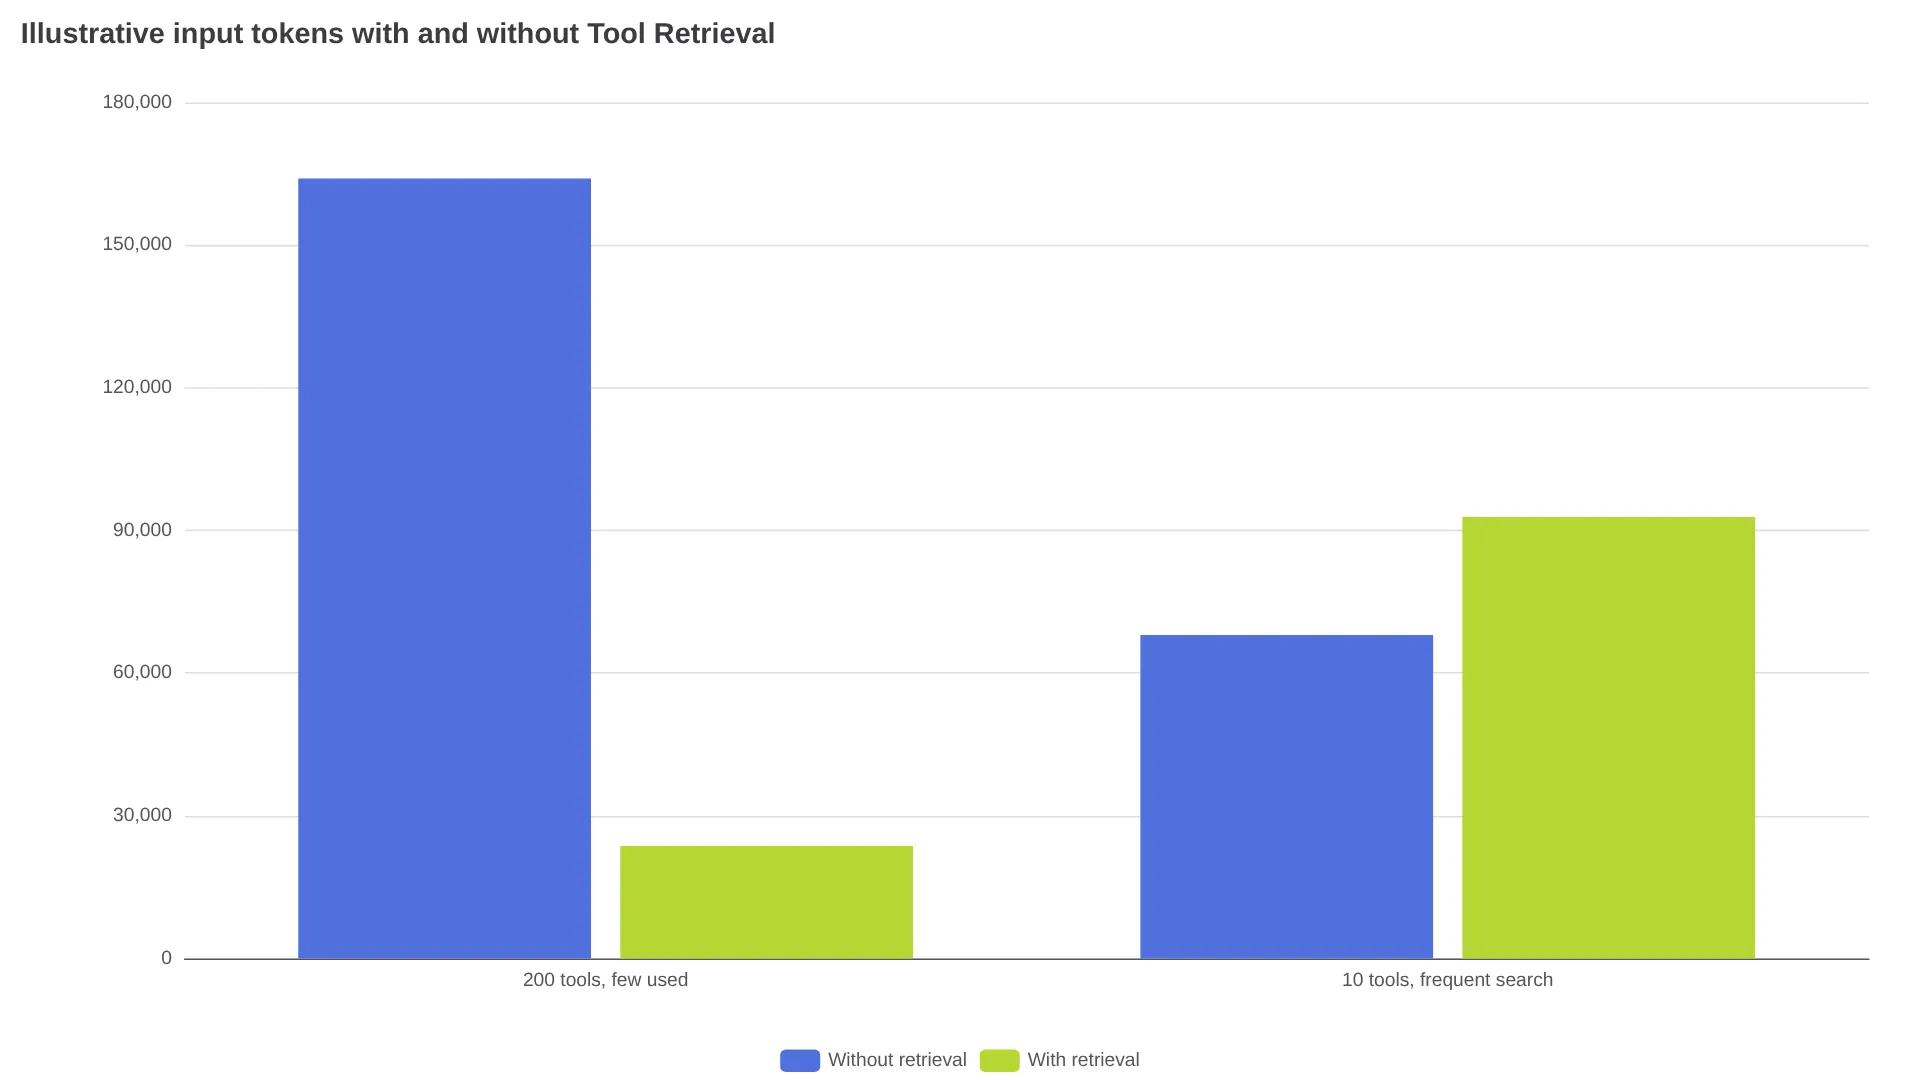
La recommandation de Google dans la même annonce tient en une phrase : « Mesurez les résultats sur votre propre trafic. »
« En mode serveur… chaque recherche côté serveur ajoute un nouveau passage du modèle sur le contexte actuel… Une grande bibliothèque dont chaque tâche n’utilise que quelques outils peut donc y gagner. À l’inverse, une petite bibliothèque avec une longue conversation et des recherches fréquentes peut coûter plus cher. » — @tekroch
Le différé peut stabiliser le préfixe mis en cache, mais il peut aussi faire passer le prompt sous le seuil de taille requis pour le cache. Selon l’analyse citée, suivez donc le taux d’utilisation du cache en parallèle des tokens d’entrée.
Quand différer les outils et quand les laisser chargés
Pour les petites bibliothèques, commencez par mesurer le chargement statique. La fréquence des recherches et la taille des schémas comptent davantage qu’un quelconque seuil de nombre d’outils. Dans les grands catalogues où une tâche n’utilise que 1 à 3 outils, différez la partie rarement sollicitée côté serveur et laissez chargés les outils fréquemment utilisés, c’est-à-dire ceux appelés sur la majorité des requêtes. Pour les outils liés à un utilisateur ou ajoutés pendant le chat, choisissez le mode client et prévoyez un aller-retour par recherche.
Les notes d’implémentation citées recensent trois cas problématiques à anticiper :
- Ne différez pas un outil mentionné dans les instructions système ou dans la sortie d’un autre outil : le modèle peut l’appeler sans effectuer de recherche, ce qui risque de faire échouer le tour suivant.
- Les fonctions différées doivent tout de même inclure un bloc
parameterscomplet dans la requête. Un simple nom accompagné d’une description peut produire un schéma vide et inutilisable. - Dans une application sans état, renvoyez à chaque tour, sans modification,
tool_search_call,tool_search_result, les signatures et le tableau complettools.
La qualité des descriptions détermine la récupération : avant de voir le moindre schéma, le modèle choisit à partir des noms et des descriptions. « Rechercher les factures client selon une plage de dates » est précis ; « Assistant facturation » risque de se confondre avec d’autres outils. Le différé ne constitue pas une barrière de sécurité : les noms et descriptions MCP différés restent visibles comme entrées du prompt, et les outils chargés s’exécutent avec les permissions que vous leur avez accordées, selon l’analyse de sécurité.
Ce que la préversion ne propose pas
La fonction est encore en préversion et se limite à l’Interactions API, sur l’interface v1beta. Elle ne prend pas en charge generateContent ; sur un modèle non compatible, l’utilisation de defer_loading renvoie une erreur HTTP 400, selon l’analyse de la documentation.
La compatibilité est actuellement plus limitée que ne le laisse penser l’annonce : Google parle de Gemini 3.6 et des versions ultérieures, y compris tous les modèles Gemini 4, tandis que l’analyse citée indique que la documentation en ligne liste actuellement gemini-4-hydrogen, gemini-4-argon, gemini-3.8-flash et gemini-3.6-flash. Vérifiez votre modèle dans la documentation avant de supposer que les autres modèles de la famille fonctionneront. Aucune date de disponibilité générale n’a été annoncée. Anthropic avait lancé une idée similaire avec defer_loading en bêta en novembre 2025 ; les spécificités de Google sont la récupération MCP côté serveur et le mode client, selon la couverture du lancement.
| Configuration de votre bibliothèque | Mode à choisir | Première action |
|---|---|---|
| Petite et stable | Chargement statique | Mesurer les tokens des schémas avant d’ajouter de la complexité |
| 50 à 200 outils, quelques-uns utilisés par tâche | Différé côté serveur | Différer les outils rarement sollicités et garder les plus utilisés chargés |
| Outils par utilisateur ou ajoutés pendant le chat | Récupération côté client | Mettre en place une recherche tenant compte des permissions |
| Tous les outils utilisés à chaque tour | Chargement statique | Le coût des recherches risque de dépasser les économies |
Commencez par déployer une portion de votre catalogue rarement utilisée, puis comparez les tokens d’entrée, total_tool_use_tokens, la latence et le taux de réussite sur des tâches identiques, avec et sans différé.
FAQ
Tool Retrieval fonctionne-t-il avec generateContent ?
Non. La fonction est réservée à l’Interactions API sur v1beta.
Quels modèles sont compatibles ?
La compatibilité annoncée concerne Gemini 3.6 et les versions ultérieures, y compris Gemini 4. L’analyse citée indique toutefois que la documentation en ligne la limite actuellement à certains modèles, dont gemini-4-hydrogen et gemini-3.6-flash. Vérifiez la documentation pour le modèle exact que vous utilisez.
Cette fonction peut-elle augmenter ma facture ?
Oui. Dans l’exemple illustratif cité, une charge de 10 outils passe d’environ 68 000 à ~92 830 tokens lorsque les recherches ont lieu presque à chaque tour.