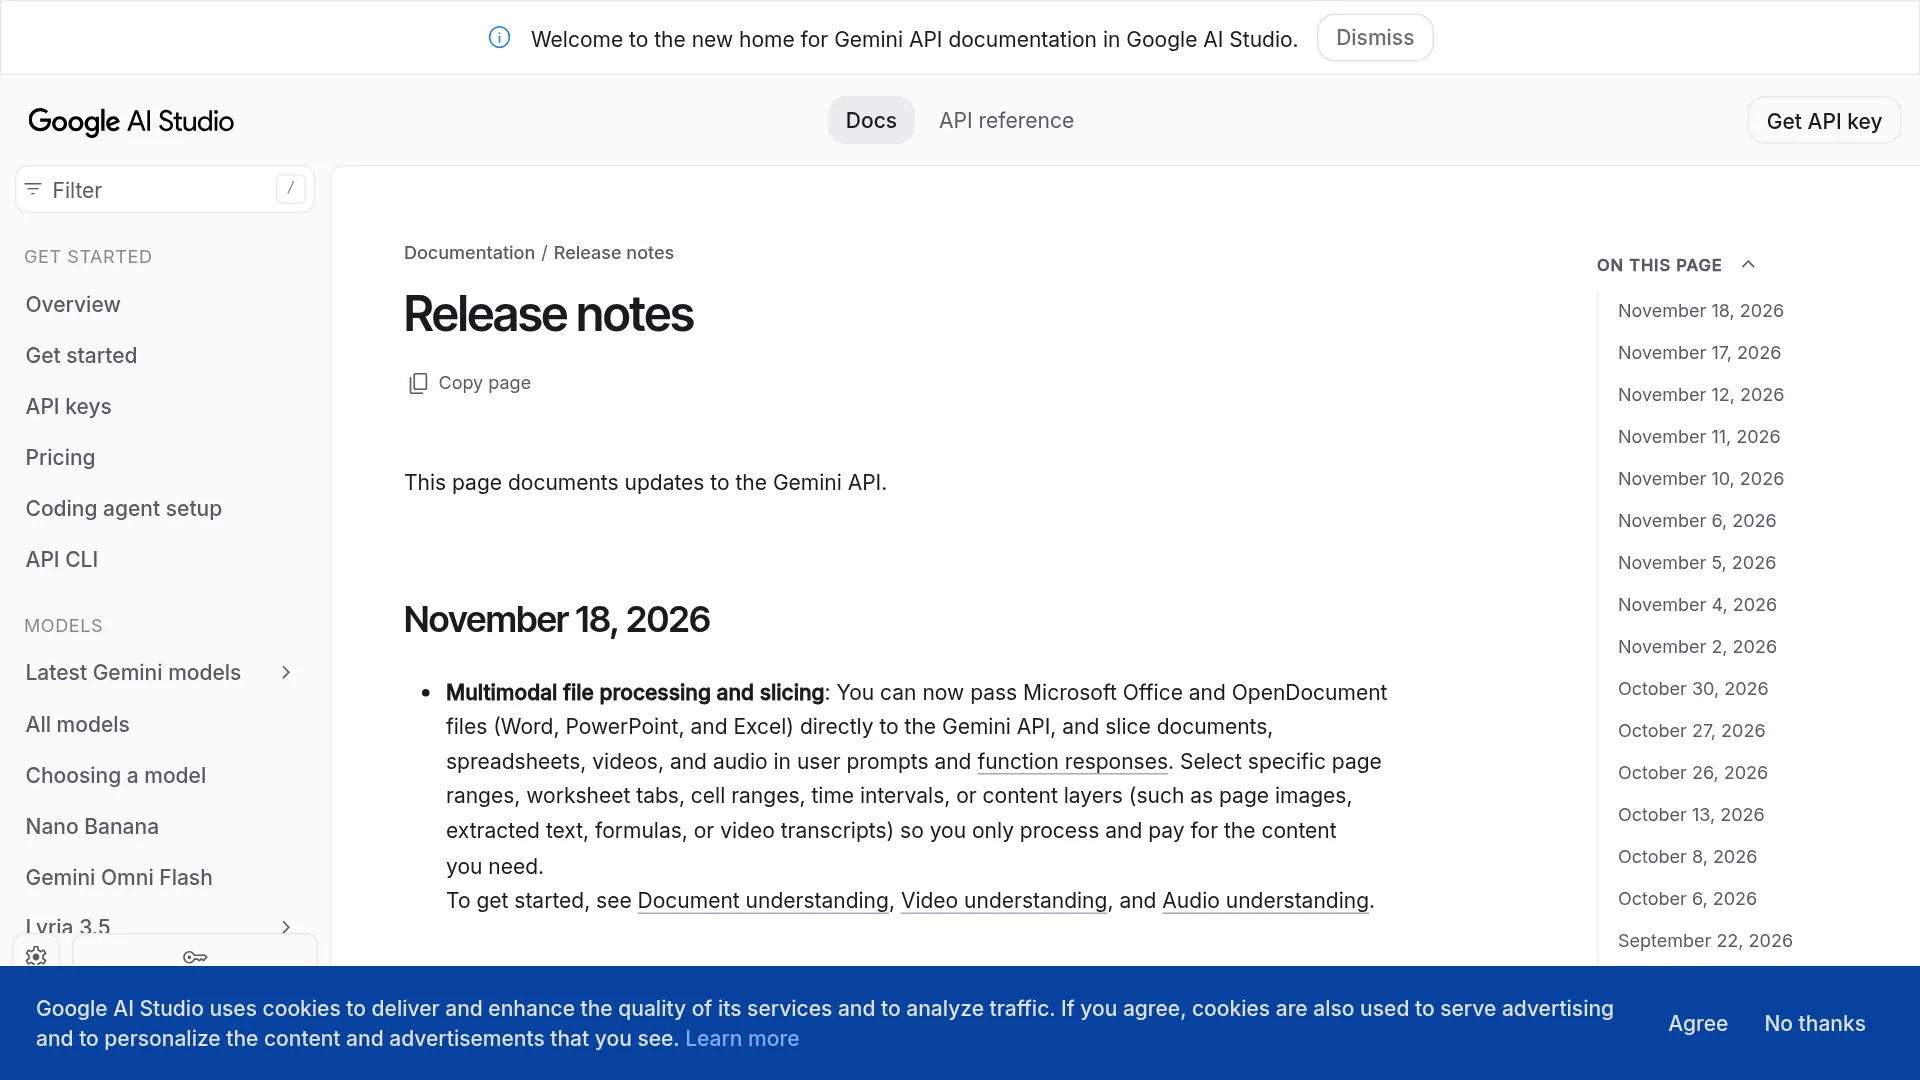
Inutile de transformer systématiquement vos classeurs Excel en CSV avant d'appeler la Gemini API. Depuis le 18 novembre 2026, elle accepte directement les fichiers Word, Excel et PowerPoint. Google indique que vous ne « traitez et ne payez que » l'extrait sélectionné (journal des modifications de Google AI Studio).
Cette économie suppose toutefois de définir explicitement les sélecteurs. Sans cela, le fichier entier peut encore être traité, comme le rappelle @zg0820.
Pourquoi l'ancien flux Excel n'était plus tenable
Auparavant, le comportement documenté ne lisait que la première feuille d'un fichier XLSX, au format CSV. Il fallait donc réorganiser les onglets ou découper les classeurs :
« La documentation indique toujours que seule la première feuille d'un XLSX est lue, en CSV. » — @aitrackerbot
L'entrée du 18 novembre remplace ce contournement par une prise en charge directe des formats Office et OpenDocument, ainsi que par le découpage du contenu dans les prompts et les réponses de fonctions (analyse de DocsWatch).
Ce que change concrètement la mise à jour du 18 novembre
Cette entrée ajoute deux capacités à l'extension du 5 novembre vers les formats PPT, ODP et ODS :
- Import direct des formats Office et OpenDocument. Les fichiers Word, PowerPoint et Excel peuvent être envoyés sans conversion préalable en PDF ou en texte.
- Découpage du contenu. Vous pouvez cibler des plages de pages, des onglets de feuille, des plages de cellules A1, des intervalles temporels ou des couches de contenu telles que les images de page, le texte extrait, les formules et les transcriptions.
Le découpage fonctionne dans les prompts comme dans les parties FunctionResponse. Un outil peut ainsi renvoyer une seule plage de feuille plutôt qu'un classeur complet (résumé d'AI Index).
Fichiers pris en charge et modèles compatibles
La page Firebase consacrée aux exigences des fichiers d'entrée, mise à jour le 18 novembre 2026 UTC, associe la prise en charge d'Office aux modèles Gemini 4.x (documentation Firebase AI Logic) :
| Famille | Extensions | Type MIME |
|---|---|---|
| Word | .doc, .docx, .dotx | application/msword, application/vnd.openxmlformats-officedocument.wordprocessingml.document, application/vnd.openxmlformats-officedocument.wordprocessingml.template |
| PowerPoint | .ppt, .pptx | application/vnd.ms-powerpoint, application/vnd.openxmlformats-officedocument.presentationml.presentation |
| Excel | .xls, .xlsx | application/vnd.ms-excel, application/vnd.openxmlformats-officedocument.spreadsheetml.sheet |
| OpenDocument | .odt, .odp, .ods | application/vnd.oasis.opendocument.text, application/vnd.oasis.opendocument.presentation, application/vnd.oasis.opendocument.spreadsheet |
| Formats de base | .pdf, .txt | application/pdf, text/plain |
Limites officielles, que le découpage ne relève pas :
- 50 MB par fichier, 1 000 pages par fichier et 3 000 fichiers de document par requête.
- 20 MB pour la taille totale de la requête avec des données base64 inline ; au-delà, utilisez des URL Cloud Storage.
À part, une information communautaire non vérifiée : un lecteur du journal des modifications évoque un plafond spécifique aux fichiers Office d'environ 2 000 pages ou diapositives (@lawson_ste3476). Google ne l'a pas documenté : ne bâtissez pas votre architecture sur cette hypothèse.
Word et PowerPoint : plages de pages et couches de contenu
DocumentMetadata a été repéré dans les documents Discovery publics de v1beta/v1alpha, mais pas dans la version stable v1 (rapport de schéma ORIENS) :
startPage: première page, indexée à partir de 1, incluse.endPage: dernière page, indexée à partir de 1, incluse.contentLayers:PAGE_IMAGE(image rendue ; valeur par défaut signalée lorsque les métadonnées sont présentes mais que les couches sont vides) ouPAGE_TEXT(texte extrait).
Choisissez PAGE_IMAGE pour la mise en page, les diapositives et les pages numérisées ; préférez PAGE_TEXT pour du texte exploitable en recherche, comme des contrats. Firebase documente le modèle sous-jacent : les PDF sont traités comme des images, chaque page comptant comme une image, et les images de 384 px ou moins sur les deux dimensions coûtent 258 tokens (documentation Firebase AI Logic).
Excel : feuilles, plages de cellules et trois modes de couche
D'après le schéma Discovery, SpreadsheetMetadata s'attache à la partie fichier fournie via inline_data ou file_data, dans un Part d'entrée ou un FunctionResponsePart (rapport de schéma ORIENS) :
sheetIndex: ordre du classeur indexé à partir de 1. Le texte Discovery dev1betaindique que toutes les feuilles sont utilisées lorsqu'il est omis ; les SDK Python et JavaScript parlent de la première feuille. Définissez-le systématiquement.visibleCells: plage A1 telle queA1:G35; si elle est omise, la zone occupée de la feuille sélectionnée est utilisée.contentLayers:DATA(valeurs, fusions, formatage),FORMULAS(expressions et résultats calculés),VISUAL(image rendue). La valeur par défaut signalée est[DATA, FORMULAS].
Pour un audit, utilisez DATA et FORMULAS ; ajoutez VISUAL pour la mise en page et le contexte des cellules fusionnées ; pour une simple recherche, limitez au maximum la plage visibleCells.
N'envoyer que l'extrait utile : exemple Python REST
Les noms de champs ci-dessous correspondent à la révision Discovery 20261116. Cette structure est en bêta et absente de la version stable v1 : vérifiez-la avec votre SDK installé avant tout usage en production.
import os
from google import genai
import requests

client = genai.Client()  # reads GEMINI_API_KEY
workbook = client.files.upload(
    file="q3_revenue.xlsx",
    config={"mime_type": "application/vnd.openxmlformats-officedocument.spreadsheetml.sheet"},
)

api_key = os.environ["GEMINI_API_KEY"]
url = f"https://generativelanguage.googleapis.com/v1beta/models/gemini-4-hydrogen:generateContent?key={api_key}"
payload = {
    "contents": [{
        "parts": [
            {
                "fileData": {
                    "fileUri": workbook.uri,
                    "mimeType": "application/vnd.openxmlformats-officedocument.spreadsheetml.sheet",
                },
                "spreadsheetMetadata": {
                    "sheetIndex": 2,
                    "visibleCells": "A1:G35",
                    "contentLayers": ["DATA", "FORMULAS"],
                },
            },
            {"text": "Summarize revenue variance in this range using computed values."},
        ]
    }]
}
r = requests.post(url, json=payload, timeout=120)
r.raise_for_status()
print(r.json()["candidates"][0]["content"]["parts"][0]["text"])
Pour Word, remplacez ce bloc par "documentMetadata": {"startPage": 12, "endPage": 18, "contentLayers": ["PAGE_TEXT"]} et utilisez le type MIME .docx. PowerPoint emploie la même structure documentMetadata avec le type MIME .pptx et les numéros de page des diapositives.
Calculer le gain réel sur la facturation
Ni le journal des modifications ni les notes tarifaires Firebase ne mentionnent de SKU distinct pour le découpage. Les économies correspondent donc aux tokens d'entrée évités, aux tarifs habituels. Le journal indique un prix de $1.50 par million de tokens d'entrée pour gemini-4-hydrogen.
Estimation illustrative pour un rapport de 200 pages dont seules les pages 12 à 18 sont utiles. L'hypothèse de 800 tokens par page de texte sert uniquement à cet exemple ; ce n'est pas un tarif documenté :
- Avant : 200 pages sous forme d'images × 258 tokens minimum par image de page = 51 600 tokens d'entrée. Coût : 51 600 / 1 000 000 × $1.50 = $0.0774.
- Après : 7 pages de texte extrait × 800 tokens supposés = 5 600 tokens d'entrée. Coût : 5 600 / 1 000 000 × $1.50 = $0.0084.
- Économie : environ 89% sur l'entrée de cette requête, hors tokens de sortie. Remplacez cette hypothèse par la densité de pages que vous mesurez.
Mesurez également l'effet de la taille des plages sur vos propres classeurs : une multitude de petites requêtes découpées peut coûter plus cher qu'une plage unique bien choisie (@zg0820).
Checklist de vérification et de migration
La réussite d'un envoi ne prouve pas que le document a été correctement analysé. Vérifiez chaque pipeline :
- Validez l'analyse. Demandez le nombre de lignes, le nom de la feuille ou le nombre de pages, puis comparez avec la source.
- Définissez tous les sélecteurs.
sheetIndex,visibleCellsou une plage de pages, ainsi quecontentLayers. - Adaptez la couche à la question. Les graphiques et la mise en page nécessitent
VISUALouPAGE_IMAGE; les audits,DATAetFORMULAS; la recherche,PAGE_TEXT. - Testez les dépassements de plage en préproduction. Le schéma ne précise pas si une page ou une plage invalide produit une erreur, est ramenée aux bornes ou ne renvoie rien.
- Respectez les plafonds d'envoi. Un fichier de 60 MB échoue toujours face à la limite de 50 MB. Au-delà de 20 MB en inline, utilisez des URL Cloud Storage.
- Migrez dans cet ordre. Remplacez les outils de découpage Excel par
sheetIndexetvisibleCells; les outils de rastérisation de rapports par des plages de pages avecPAGE_TEXT— en réservantPAGE_IMAGEà la mise en page ; et les retours d'outils de fichiers complets par des réponses de fonctions découpées.
Les sources citées ne précisent pas le traitement des lignes masquées, cellules fusionnées, graphiques, images intégrées, ou fichiers protégés par mot de passe, contenant des macros ou corrompus. Ni l'annonce du découpage ni la page Firebase sur les exigences des fichiers d'entrée liée plus haut ne les abordent. Testez ces cas sur vos propres modèles.
FAQ
Peut-on aussi découper le contenu dans les réponses de fonctions ?
Oui. Les outils peuvent renvoyer une URI de fichier accompagnée de SpreadsheetMetadata ou DocumentMetadata, afin que le modèle ne voie que l'extrait concerné. C'est particulièrement adapté aux flux documentaires pilotés par des agents.
Quelle version de l'API prend en charge le découpage ?
La fonctionnalité a été observée dans v1beta et v1alpha, révision Discovery 20261116, mais pas dans la version stable v1. Épinglez vos versions et testez votre modèle cible avant la mise en production.
Pourquoi Gemini affirme-t-il ne pas voir mon fichier envoyé ?
Vérifiez le type MIME, la taille et les sélecteurs explicites à partir du tableau et des limites ci-dessus. Demandez ensuite au modèle de restituer les noms des feuilles ou le nombre de pages afin de confirmer l'analyse.
À lire aussi : guide Gemini 4 Carbon vs Hydrogen API pour choisir le modèle à placer derrière un pipeline Office.