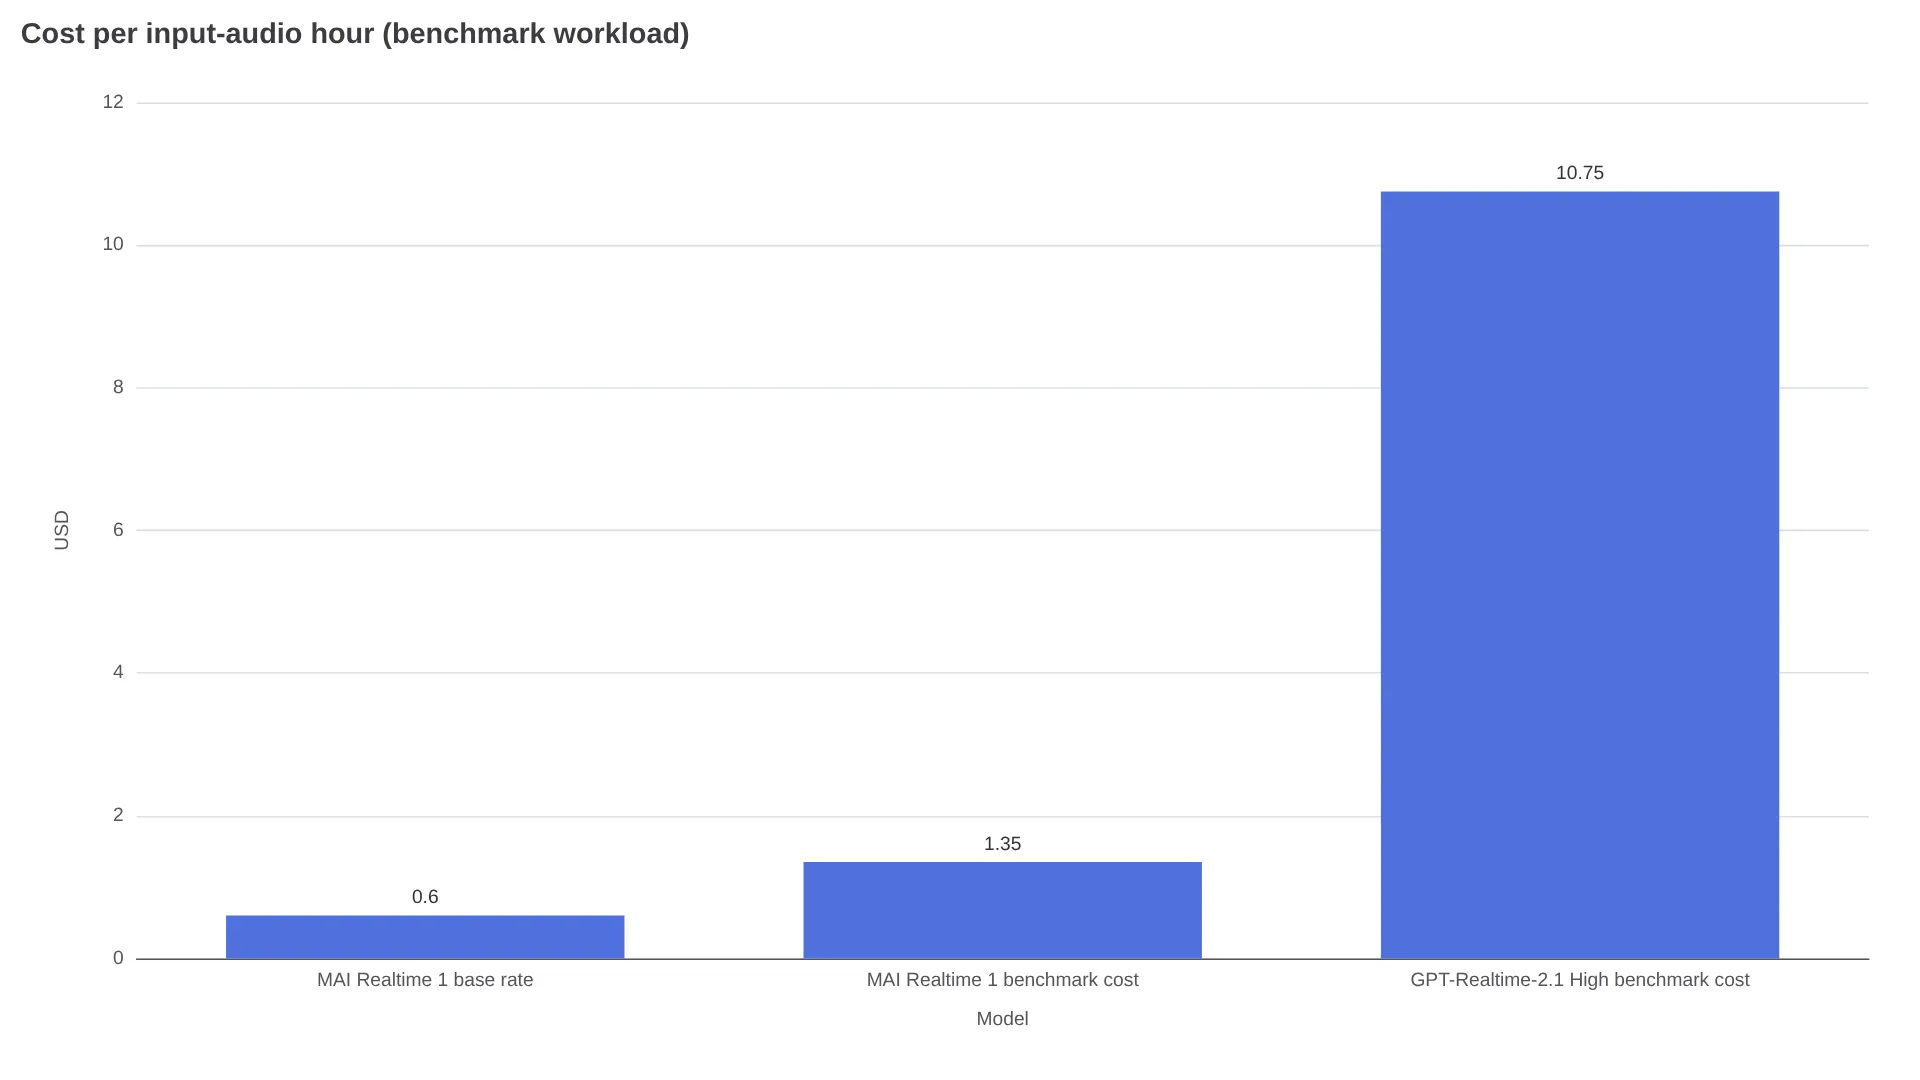
À 1,35 $ par heure d’audio en entrée selon le benchmark normalisé de Microsoft, MAI Realtime 1 revient environ 87 % moins cher que la configuration GPT-Realtime-2.1 High, affichée à 10,75 $. Mais le tarif de 0,01 $ la minute n’est qu’un plancher : il couvre l’audio, tandis que le raisonnement est facturé en supplément.
Microsoft a présenté MAI Realtime 1, son premier modèle speech-to-speech, le 17 novembre 2026 lors d’Ignite. Le modèle est proposé en préversion limitée via Microsoft Foundry, sur inscription et sans facturation jusqu’à la préversion publique. Une courte démonstration est aussi accessible dans MAI Labs.
Les 0,01 $ par minute ne paient que l’audio
La grille tarifaire officielle publiée par Microsoft AI comporte trois postes :
| Facturation | Prix |
|---|---|
| Speech-to-speech de base | 0,01 $ par minute audio |
| Entrée de raisonnement | 1 $ par million de tokens |
| Sortie de raisonnement | 5 $ par million de tokens |
Hors raisonnement, le calcul est simple : 60 minutes coûtent 0,60 $, et 1 $ finance 100 minutes d’audio. Microsoft parle d’un tarif « starting at », car chaque appel faisant intervenir le moteur de raisonnement approfondi génère des frais de tokens additionnels.
La fréquence d’activation du raisonnement n’est pas précisée. Microsoft indique qu’un système conversationnel rapide gère les échanges courants et que seules les demandes plus difficiles mobilisent un raisonnement plus puissant. En revanche, l’entreprise ne publie ni consommation de tokens par minute, ni règle indiquant si l’audio de l’appelant et celui du modèle sont tous deux comptabilisés, ni mode d’arrondi. Considérez donc le centime comme un minimum, pas comme le montant final de la facture.
« Les comparaisons de performances, de latence et de coût varient selon l’application et la méthodologie. » — Microsoft AI, annonce de MAI Realtime 1
Pourquoi le benchmark affiche 1,35 $ de l’heure, et non 0,60 $
Les 0,60 $/heure correspondent au seul audio brut. Les 1,35 $ représentent le coût d’une charge de travail normalisée selon le benchmark de Microsoft ; les détails de comptage publiés ne suffisent pas à reconstituer l’écart à partir d’une estimation des tokens par minute. Les chiffres ci-dessous proviennent de l’analyse de Magica des données de Microsoft.
| Configuration du modèle | Raisonnement vocal (Big Bench Audio, 40 q.) | Achèvement agentique (τ-Voice) | Coût par heure d’audio en entrée |
|---|---|---|---|
| MAI Realtime 1 | 98.9% | 57.5% | 1,35 $ |
| GPT-Realtime-2.1 High | 95.8% | 45.7% | 10,75 $ |
| Gemini 3.8 Live | — | 30.1% | 0,84 $ |
| Gemini 3.8 Live Extended Thinking (High) | — | 68.6% | 3,50 $ |
| Phonic 1 (High) | — | 79.9% | 4,20 $ |
MAI surpasse la configuration GPT listée sur les deux tests, pour environ un huitième de son coût de benchmark. Il devance le Gemini le moins cher de 27,4 points sur l’achèvement, mais reste à 11,1 points d’Extended Thinking et à 22,4 points de Phonic 1 High.
Ces chiffres sont tous à considérer comme des données fournies par les éditeurs : Microsoft a évalué MAI en interne et attribue les résultats des concurrents à Artificial Analysis. L’échantillon Big Bench Audio ne comprend que 40 questions sélectionnées, et le score d’achèvement τ-Voice n’équivaut pas à un taux mesuré de résolution en service client.
Ce que Realtime 1 apporte à un appel en direct
MAI Realtime 1 prend en charge la gestion des interruptions, l’usage d’outils et le routage vers le raisonnement pour les agents téléphoniques. Il tolère le bruit de fond et permet de piloter la personnalité par prompt. Son positionnement vise les usages téléphoniques et le support, plutôt que le chat grand public. Microsoft le présente comme compatible avec l’OpenAI Realtime API, afin de faciliter les tests et la migration, sous réserve de différences entre endpoints, schémas d’outils, voix et gestion des erreurs.
Restent inconnus : les langues et voix prises en charge, la latence exacte, la taille de la fenêtre de contexte, les limites de débit et de concurrence, les régions disponibles ainsi que la politique de rétention.
Tester MAI Labs ou rejoindre la préversion Foundry
Démonstration MAI Labs : essai public réservé à un usage personnel non commercial, avec des sessions d’environ 2 minutes maximum et un accès à partir de 18 ans. C’est utile pour juger la qualité vocale et la gestion des interruptions, beaucoup moins pour tester la charge. Préversion limitée Foundry : c’est la voie entreprise. Inscrivez-vous via le formulaire d’intérêt de la page du modèle MAI Realtime 1, attendez l’approbation, puis développez sur l’endpoint Realtime compatible OpenAI. Aucun frais ne sera appliqué avant le lancement de la préversion publique, dont la date n’a pas été annoncée.
Si vous avez besoin cette semaine de SLA de production, de régions disponibles ou d’un engagement GA, ce modèle n’est pas encore achetable. Limitez-vous au prototypage.
Chiffrez vos 1 000 premiers appels avant de vous engager
Un tarif à la minute masque l’essentiel de la décision. Partez d’une formule unique, puis ramenez le résultat au cas résolu :
Cost = audio minutes x $0.01 + input reasoning tokens / 1M x $1 + output reasoning tokens / 1M x $5
Exemple : un appel de support de 4 minutes coûte 0,04 $ d’audio. S’il consomme 2 000 tokens de raisonnement en entrée et 500 en sortie, ajoutez 0,002 $ + 0,0025 $, soit 0,0045 $ ; le total atteint environ 0,0445 $ par appel. Pour 1 000 appels avec un taux de relance de 15 %, environ 1 150 équivalents d’appels facturés coûtent environ 51,18 $. Si 600 des 1 000 appels initiaux sont résolus, le coût par cas résolu est d’environ 0,085 $. La durée des relances et la consommation de tokens varient selon les parcours : remplacez ces hypothèses par votre propre profil de relance.
Utilisez 1,35 $ par heure d’audio en entrée comme indicateur issu du benchmark éditeur, en attendant que vos propres essais révèlent les coûts réels des tokens de raisonnement et du comptage ; ce n’est pas un plafond. Votre charge peut se situer au-dessus comme au-dessous de cet indicateur selon des mécanismes de raisonnement et de comptage qui ne sont pas publiés. Mesurez-les pendant la préversion.
| Votre situation | Choix recommandé |
|---|---|
| Application OpenAI Realtime existante, pression sur les coûts, recherches simples | Testez MAI Realtime 1 en parallèle ; la compatibilité limite le travail de migration |
| Tâches complexes en plusieurs étapes, où le taux d’achèvement prime sur le coût brut | Comparez-le à des options Extended Thinking ou de la classe Phonic avant de basculer uniquement sur le prix |
| Besoin immédiat de GA, de SLA ou de langues et régions documentées | Attendez ; conservez votre fournisseur actuel et réévaluez à la préversion publique |
FAQ
Comment les minutes audio sont-elles comptabilisées ?
Microsoft indique seulement une facturation « par minute audio », sans préciser la répartition entre appelant et modèle ni la règle d’arrondi. Prévoyez de comptabiliser l’ensemble de l’audio tant que la grille tarifaire ne l’aura pas clarifié.
Que permet réellement de tester la préversion ?
La démonstration Labs permet d’évaluer la qualité vocale et la gestion des interruptions lors de courtes sessions. Seule la préversion Foundry, dont l’accès est contrôlé, expose l’endpoint compatible OpenAI pour les appels d’outils et les tests de charge ; elle reste sans facturation.
À quel moment faut-il vérifier à nouveau ce tarif ?
Lorsque Microsoft annoncera une date de préversion publique et publiera la grille tarifaire Foundry avec les détails de comptage, de langues et de régions. D’ici là, considérez tous les chiffres de cet article comme des tarifs de préversion.