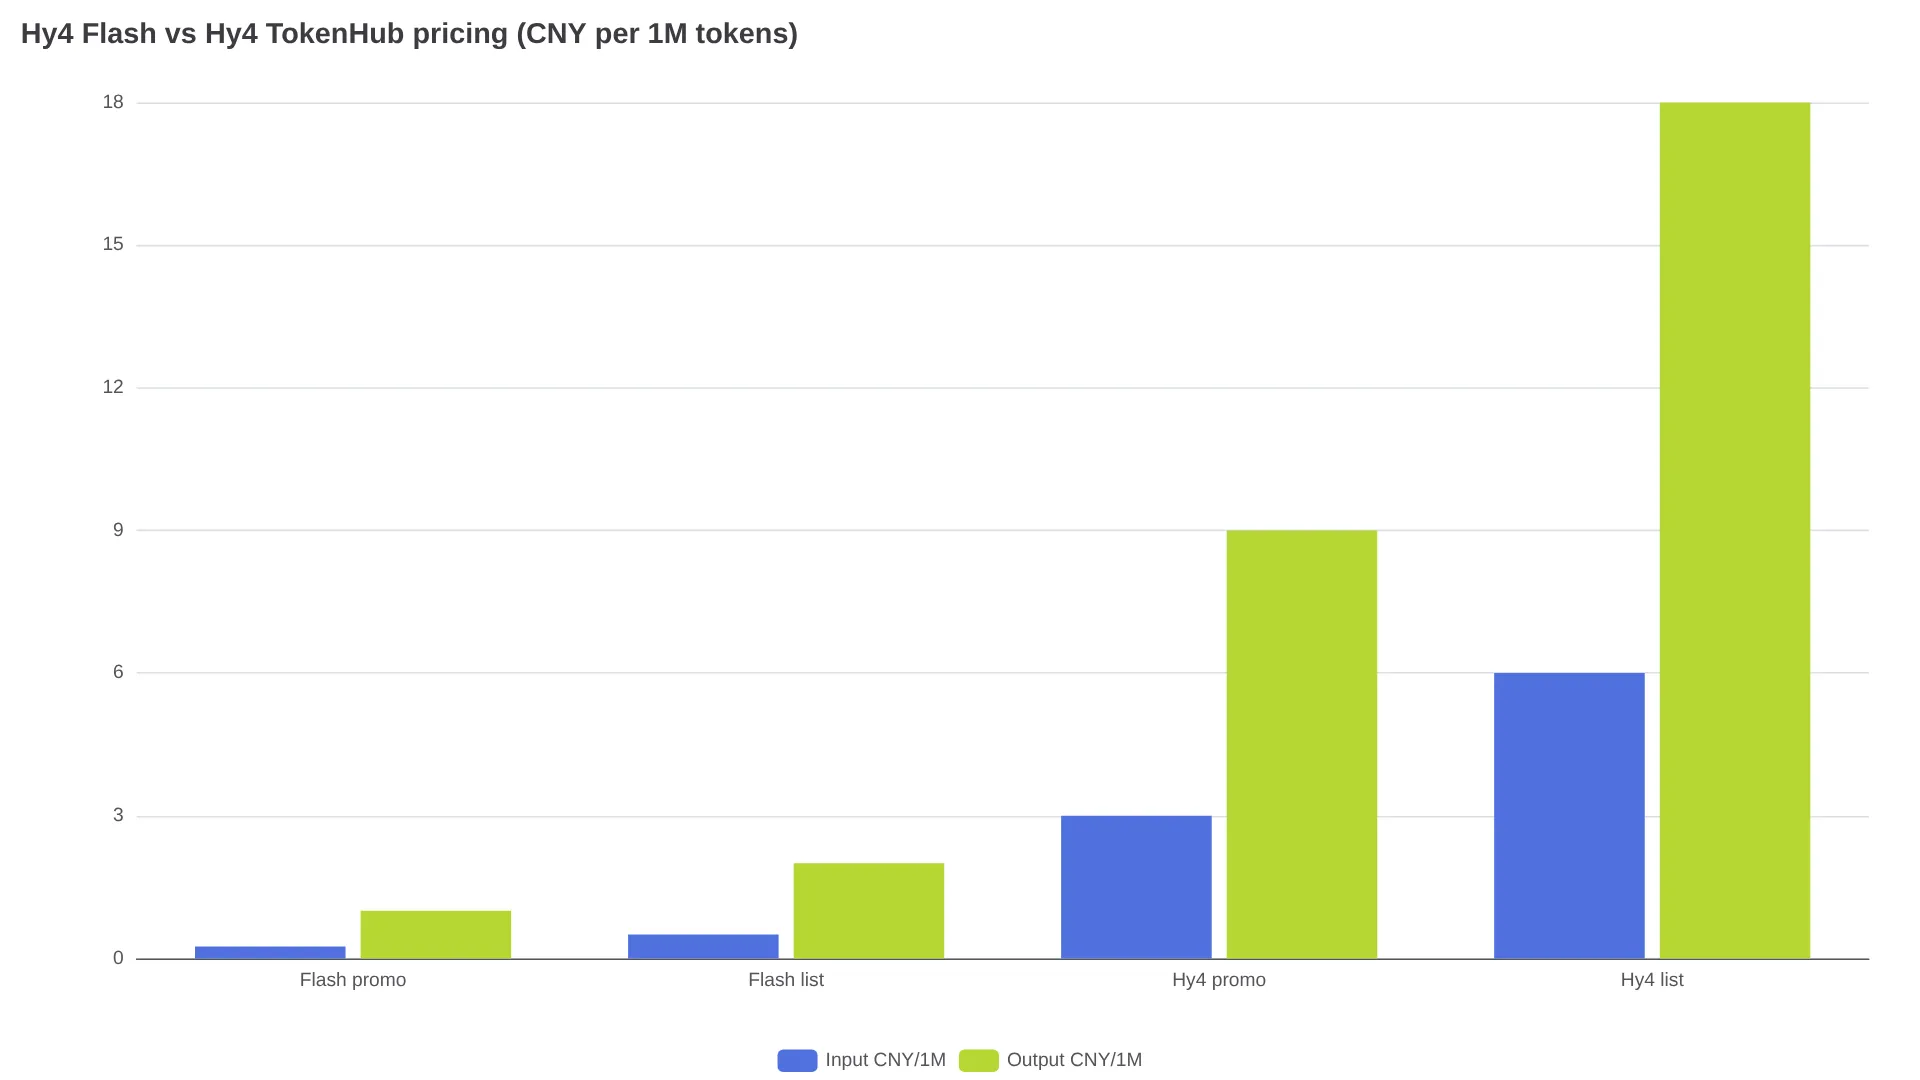
Le Hunyuan Hy4 Flash de Tencent est disponible depuis le 16 novembre 2026. Ce modèle totalise 224B de paramètres, dont 12B actifs, et accepte un contexte de 1M de tokens. Son tarif standard est de 0,50 CNY en entrée et 2,00 CNY en sortie par million de tokens (0,070 $ / 0,281 $). Jusqu’au 30 novembre à midi, heure de Pékin, le tarif de lancement TokenHub bénéficie toutefois d’une remise de 50 % : 0,25 / 1,00 CNY.
Flash n’est pas simplement un Hy4 allégé destiné aux mêmes usages. La facturation dépend de l’identifiant envoyé : hy4-flash correspond à l’offre économique, hy4 au modèle phare et hy4-preview au checkpoint d’août.
Hy4 Flash est disponible : ce qui a été lancé le 16 novembre
L’annonce de Hy4 du 4 novembre ne précisait pas encore le prix de Flash. Le message de lancement du 16 novembre, accompagné de la mise en ligne sur TokenHub le même jour, a levé le doute (ITHome, Sina Finance, caractéristiques sur LLMLearner).
- TokenHub de Tencent Cloud, identifiant modèle
hy4-flash— disponible. - WorkBuddy, Yuanbao et les applications Tencent — WorkBuddy est gratuit jusqu’au 30 novembre.
- OpenRouter — prévu, mais pas encore disponible. Au 16 novembre, seul
tencent/hy4est référencé. En attendant l’arrivée de Flash sur OpenRouter, utilisez le point de terminaison TokenHub de Singapour.
Les caractéristiques qui expliquent pourquoi Flash coûte dix fois moins cher que Hy4
Hy4 Flash compte 224B de paramètres au total, dont 64B de paramètres Engram, avec 12B actifs par token, selon une architecture à mixture-of-experts (LLMLearner, Sina). Sa fenêtre de contexte atteint 1M de tokens (1 048 576). L’entrée accepte du texte et des images, tandis que la sortie reste textuelle.
Pour la facture, le point important est ailleurs : le cache KV est six fois plus compact que celui de Hy4 et 24 fois plus compact que celui de Hy3. Le modèle combine aussi megakernel, quantification 4 bits et accélération dflash, avec un décodage dépassant 150 tokens/s. Le même endpoint prend en charge les images, l’analyse de graphiques et les problèmes de mathématiques visuelles.
Les poids ont été annoncés, mais pas publiés : contrairement à Hy4-preview, disponible sous licence Apache 2.0, Flash ne dispose au 16 novembre d’aucun checkpoint public, d’aucune date de publication ni d’aucune licence annoncée.
Tarifs de l’API Hy4 Flash : le détail en un tableau
TokenHub publie des catalogues distincts pour la Chine continentale (CNY) et l’international (USD) : il s’agit de grilles régionales, pas de simples conversions. La promotion de Flash court jusqu’au 30 novembre à 12 h, heure de Pékin (LLMLearner). Celle du modèle phare se poursuit jusqu’au 31 décembre à 23 h 59, heure de Pékin (vérification CostMyTokens, ChinaModelAPI).
| Offre | Entrée / 1M | Sortie / 1M | Lecture du cache / 1M | Validité |
|---|---|---|---|---|
| Flash, tarif catalogue (CNY) | ¥0.50 | ¥2.00 | ¥0.02 | standard |
| Flash, promotion (CNY) | ¥0.25 | ¥1.00 | ¥0.01 | jusqu’au 30 novembre, 12 h, heure de Pékin |
| Flash, tarif catalogue (USD) | $0.070 | $0.281 | $0.003 | standard |
| Hy4, tarif catalogue (CNY) | ¥6.00 | ¥18.00 | ¥0.30 | standard |
| Hy4, promotion (CNY) | ¥3.00 | ¥9.00 | ¥0.15 | jusqu’au 31 décembre, 23 h 59, heure de Pékin |
| Hy4, tarif catalogue (USD) | $0.834 | $2.501 | $0.042 | standard |
| Hy4, promotion (USD) | $0.417 | $1.2505 | $0.021 | jusqu’au 31 décembre |
Exemple avec le tarif promotionnel de Flash : 100K tokens d’entrée non mis en cache + 500K tokens d’entrée en cache + 5K tokens de sortie = 0,1 × ¥0.25 + 0,5 × ¥0.01 + 0,005 × ¥1.00 = ¥0.035.
La véritable différence se mesure au coût par tâche. Tencent annonce environ un vingtième du coût de Hy4, un treizième de celui de Hy4 preview et un huitième de celui de DeepSeek-V4.1-Flash (max) (Sina). En s’appuyant sur le test à l’aveugle de Tencent mené auprès de 85 utilisateurs internes sur 259 tâches (LLMLearner), les calculs de la communauté publiés dans le fil de lancement arrivent à ¥0.26 par tâche, contre ¥4.73 pour Claude Haiku 5.5 (high) et ¥1.20 pour DeepSeek-V4.1-Flash, avec une satisfaction de 2.79 contre 2.81 (analyse de @alphaw0ng). Il n’existe pas encore de tableau indépendant : ces chiffres doivent donc être considérés comme les résultats d’un test fournisseur, complétés par des calculs communautaires.
Pour les agents, le cache peut faire varier fortement la facture : la lecture du cache coûte 4 à 5 % du tarif d’une entrée fraîche (¥0.02 contre ¥0.50 ; $0.003 contre $0.070).
« Est-ce un modèle à la pointe ? Non, pas du tout. Mais c’est la clé pour faire de WorkBuddy le Doubao des agents de travail. Avec seulement 200B de paramètres, Tencent peut déployer des tokens très bon marché à grande échelle, suffisamment performants pour les tâches relativement simples. » — @LeroyLi311063, réaction publiée le jour du lancement
Hy4 Flash, Hy4 ou Hy4 Preview : choisissez selon votre charge de travail
| Hy4 Flash | Hy4 (GA, 4 novembre) | Hy4 Preview (28 août) | |
|---|---|---|---|
| Paramètres | 224B au total / 12B actifs | non communiqué (référence preview : 770B / 49B) | 770B / 49B |
| Contexte | 1M | 1M — 960K max en entrée, 64K max en sortie (guide de configuration) | 1M |
| Modalités | texte + image en entrée, texte en sortie | texte + image en entrée, texte en sortie, utilisation d’un ordinateur | texte, checkpoint préliminaire |
| Identifiant TokenHub | hy4-flash | hy4 | hy4-preview |
| Entrée/sortie au tarif catalogue | ¥0.5 / ¥2.0 | ¥6 / ¥18 ($0.834 / $2.501) | ¥6 / ¥18 |
| À privilégier pour | recherche, documents, présentations, frontend simple, usage informatique quotidien | développement logiciel sur de longues séquences, agents complexes, recherche financière | tester les poids ouverts (Apache 2.0) |
Le contexte du modèle phare est important précisément parce que Flash lui est inférieur. Dans l’annexe des benchmarks Hy4 de Tencent, Hy4 reste derrière les meilleurs modèles propriétaires sur Terminal-Bench 4.0 (44.4 contre environ 66 pour une classe Opus 5.5) et ProgramBench (30.0 contre 56.5+). Pour le style SWE-bench ou les agents de terminal mobilisés pendant plusieurs heures, le tarif promotionnel de ¥0.25 en entrée ne suffit donc pas à faire de Flash le bon choix. Les tarifs du modèle phare sont détaillés dans notre guide des tarifs de l’API Hy4 Preview et notre comparatif des API LLM les moins chères.
Appeler hy4-flash en 10 minutes
TokenHub est compatible avec l’API OpenAI et propose /v1/chat/completions, /v1/responses ainsi que l’endpoint Anthropic /v1/messages (guide des endpoints). Utilisez une clé TokenHub, pas un jeton de session Yuanbao ou WorkBuddy. Choisissez Guangzhou avec https://tokenhub.tencentmaas.com/v1 ou Singapour avec https://tokenhub-intl.tencentmaas.com/v1, activez le service du modèle dans la console — un service désactivé renvoie une erreur 402 selon le même guide — puis envoyez hy4-flash.
curl https://tokenhub-intl.tencentmaas.com/v1/chat/completions \
  -H "Authorization: Bearer $TOKENHUB_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "hy4-flash",
    "messages": [{"role": "user", "content": "Summarize this 80-page PDF in 10 bullets"}]
}'from openai import OpenAI
client = OpenAI(api_key="YOUR_TOKENHUB_API_KEY",
base_url="https://tokenhub-intl.tencentmaas.com/v1")
resp = client.chat.completions.create(
model="hy4-flash",
messages=[{"role": "user", "content": "Hello"}],
)
print(resp.choices[0].message.content)La longueur maximale des sorties de Flash n’est pas communiquée ; Hy4, lui, est documenté avec une limite de 64K. Ne partez donc pas du principe que Flash bénéficie de la même limite. Consultez la fiche du modèle dans la console avant de prévoir des générations de plus de 100K tokens.
La règle de routage : Flash par défaut, Hy4 pour les 5 % de tâches difficiles
| Si votre charge de travail concerne… | Utilisez | Pourquoi |
|---|---|---|
| Documents, présentations, feuilles de calcul, préparation de réunions, recherche approfondie | hy4-flash | Satisfaction proche de Haiku, à environ ¥0.26 par tâche dans le test de Tencent |
| Agents à haut volume avec de longs préfixes stables | hy4-flash | Le ratio de cache de 4 à 5 % devient rapidement rentable |
| Frontend simple, usage informatique quotidien | hy4-flash | C’est le positionnement annoncé par Tencent ; un débit supérieur à 150 tps favorise la réactivité |
| Développement sur de longues séquences, agents de terminal, synthèse de programmes | hy4 | Flash n’est explicitement pas destiné à ces usages |
| Auto-hébergement dès aujourd’hui | poids de hy4-preview | Seule la preview propose des poids Apache 2.0 téléchargeables |