 AIREITER
Le prix au token de Hy4 preview ne suffit pas à trancher. Tencent propose une grille en CNY, OpenRouter donne accès à un endpoint hébergé, mais le meilleur choix dépend surtout de votre usage du cache, de vos besoins en outils et de votre capacité à exploiter un modèle distribué sur huit GPU.
Tarifs de l’API Hy4 preview en bref
Sur Tencent Cloud TokenHub, Hy4 preview est facturé CNY 6 par million de tokens d’entrée, CNY 18 par million de tokens de sortie et CNY 0.30 par million de tokens d’entrée lus depuis le cache. La page du modèle hébergé sur OpenRouter affiche respectivement $0.834, $2.501 et $0.042.
| Accès | Entrée / 1 M de tokens | Sortie / 1 M de tokens | Entrée en cache / 1 M de tokens | ID du modèle |
|---|---|---|---|---|
| Tencent Cloud TokenHub | CNY 6 | CNY 18 | CNY 0.30 | À vérifier dans TokenHub |
| OpenRouter | $0.834 | $2.501 | $0.042 | tencent/hy4-preview |
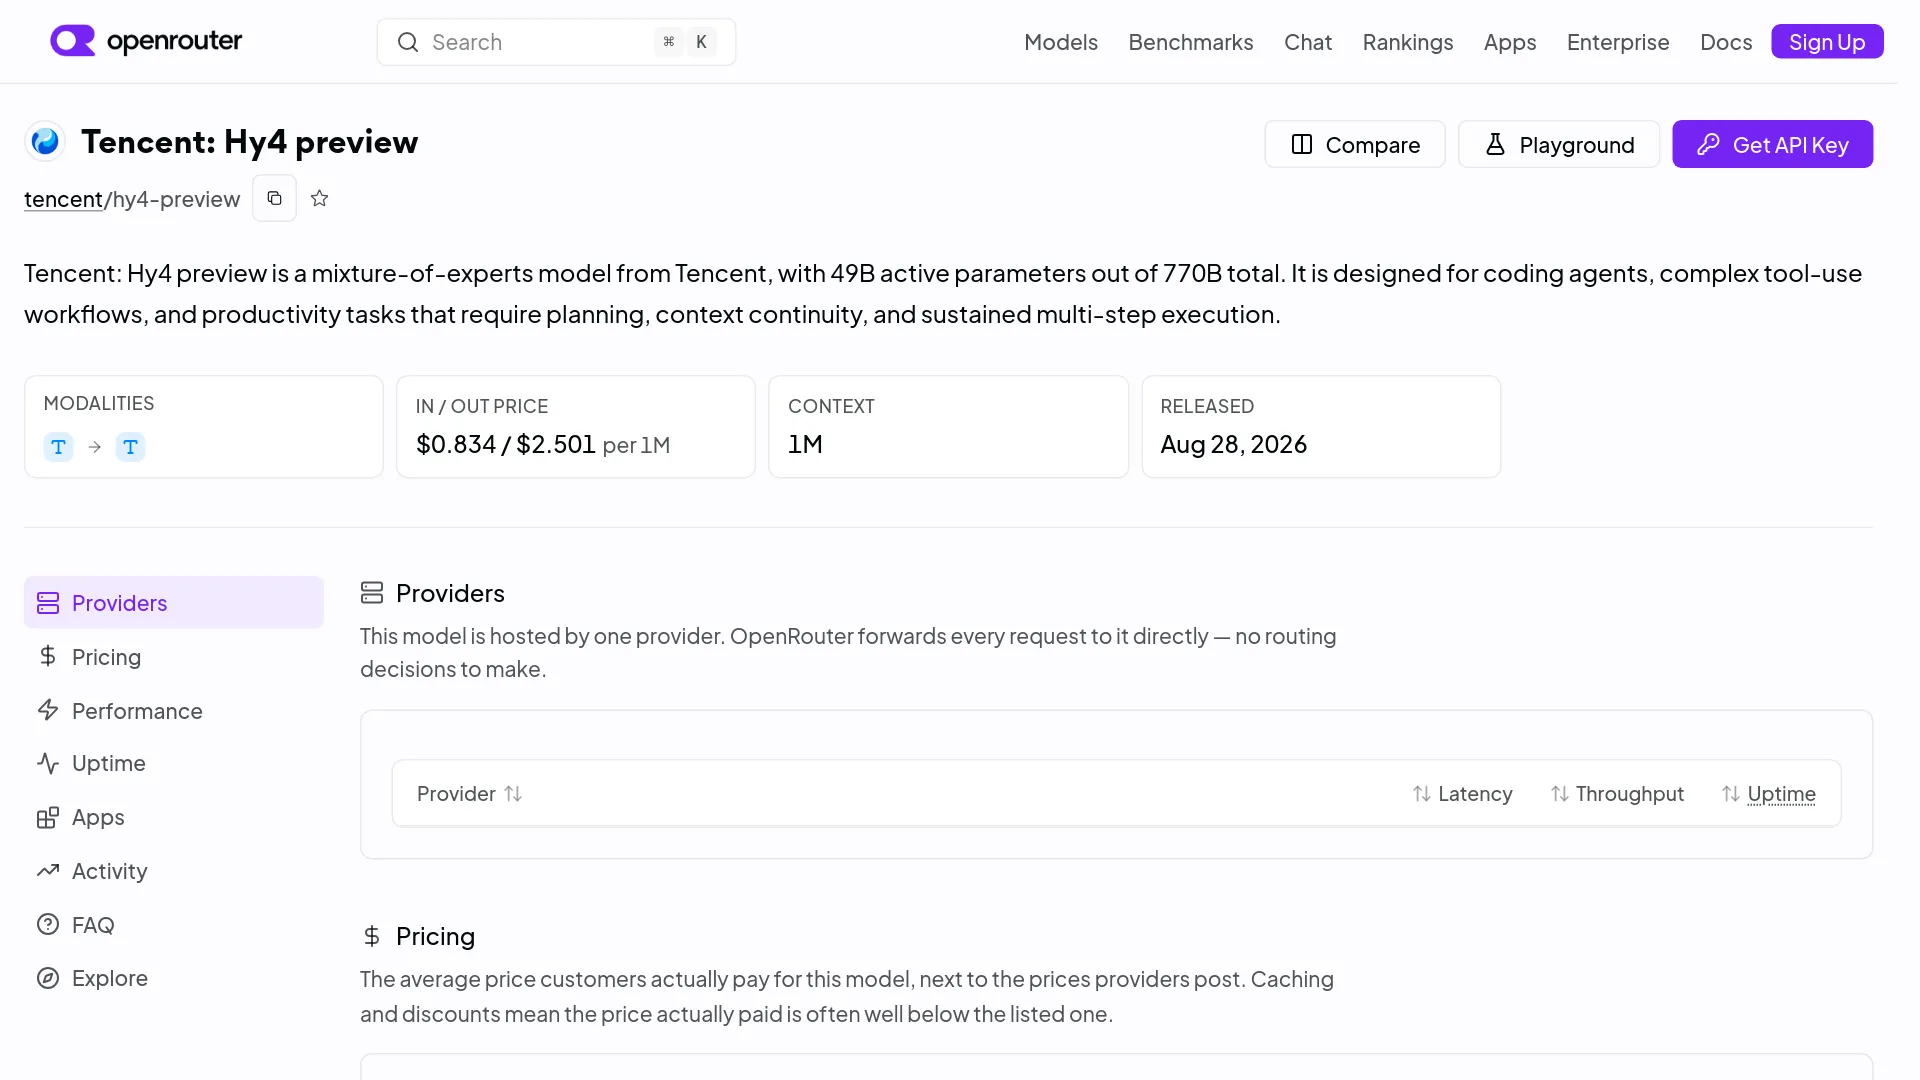
La page tarifaire officielle de Tencent Cloud TokenHub, mise à jour le 28 août 2026, est la source la plus fiable pour les prix en CNY. La page du modèle OpenRouter renseigne l’ID du modèle hébergé, la limite exacte de contexte, le plafond de génération et les fonctionnalités de l’endpoint.
Le rapport entre chacun des tarifs OpenRouter et son équivalent Tencent est d’environ $0.139 par CNY pour les trois compteurs. Il s’agit d’un alignement implicite entre les grilles tarifaires publiées, et non d’un taux de change de marché : taxes, frais de devise, conditions de compte et routage peuvent toujours modifier la facture.
Calculer concrètement le coût de Hy4
Une requête comprenant 100 000 tokens en entrée et 10 000 tokens en sortie revient à CNY 0.78 selon les tarifs publiés par Tencent :
- Entrée :
0.1 × CNY 6 = CNY 0.60. - Sortie :
0.01 × CNY 18 = CNY 0.18. - Total : CNY 0.78.
Si les 100 000 tokens d’entrée bénéficient d’un hit de cache, cette même requête coûte environ CNY 0.21 : 0.1 × CNY 0.30 + 0.01 × CNY 18.
Aux tarifs affichés par OpenRouter, les montants équivalents sont de $0.10841 sans cache et de $0.02921 avec l’entrée en cache. Ces calculs supposent exactement les volumes de tokens indiqués et excluent les frais propres au fournisseur ou les ajustements liés au compte.
Pourquoi les tokens de sortie font vite grimper la facture
Sur les deux grilles affichées, la sortie coûte trois fois plus cher que l’entrée non mise en cache. Des traces d’agents longues, des correctifs de code ou des rapports générés peuvent donc devenir le principal poste de dépense, même si le prompt système stable ou le préfixe d’un dépôt est mis en cache.
Suivez séparément les tokens d’entrée non mis en cache, les lectures de cache et les tokens de sortie. Un hit de cache réduit la part liée au prompt, pas le coût de la réponse générée.
Ce que couvre le prix de l’API
Hy4 preview est un modèle Mixture-of-Experts doté d’une architecture totalisant 770B paramètres, de 49B paramètres actifs par token et d’une fenêtre de contexte de 1M tokens. Tencent le positionne pour le travail logiciel de longue durée, la planification et les tâches de productivité, mais les éléments disponibles sur sa qualité proviennent du fournisseur et non d’un benchmark d’API indépendant.
| Information sur l’API ou le modèle | Détail vérifié |
|---|---|
| ID du modèle OpenRouter | tencent/hy4-preview |
| Contexte | 1M tokens sur la grille Tencent ; 1,048,576 sur OpenRouter |
| Génération maximale | 64,000 tokens sur OpenRouter |
| Licence | Apache License 2.0 sur la carte de modèle Tencent |
| Checkpoints publiés | Hy4 preview et Hy4 preview-FP8 |
| Runtimes locaux officiels | vLLM et SGLang |
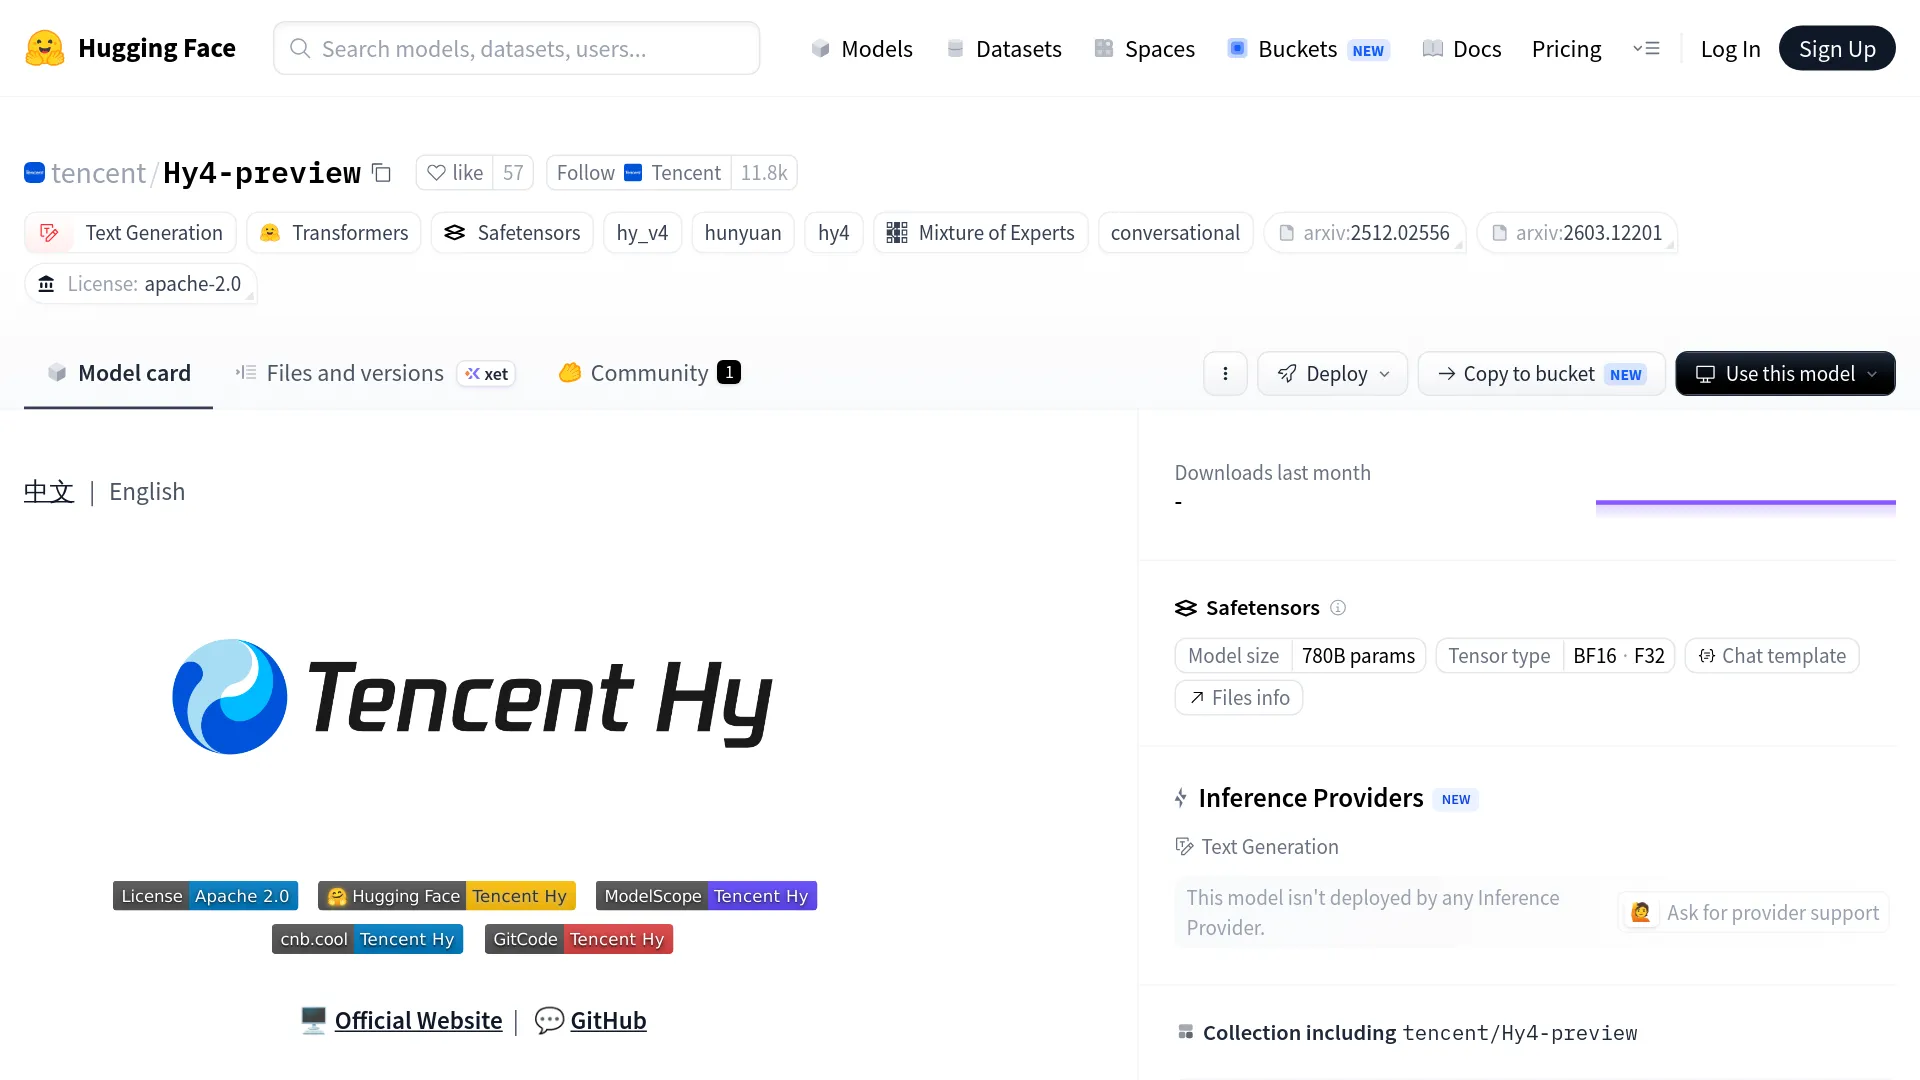
La carte de modèle officielle de Tencent publie les poids, la licence et la documentation de déploiement. Ses exemples de serving recommandent le checkpoint FP8, sans chiffrer toutefois l’écart de mémoire, de débit ou de qualité avec le checkpoint non FP8.
Attention pour les agents : OpenRouter n’expose ni outils ni JSON contraint
La fiche OpenRouter indique que cet endpoint n’accepte pas tools et ne prend pas en charge response_format pour imposer une sortie structurée. C’est une limite de cette route, pas la preuve que tous les déploiements locaux de Hy4 sont dépourvus de support de parseurs.
Les exemples Tencent pour vLLM et SGLang incluent des parseurs pour les appels d’outils et le raisonnement de Hy4. Si votre application dépend d’appels de fonctions natifs ou d’un JSON contraint par schéma, vérifiez le fournisseur choisi avant l’intégration et prévoyez, si nécessaire, une couche externe d’orchestration ou de validation.
API hébergée ou déploiement local ?
Pour l’évaluation et la plupart des premières expérimentations en production, l’accès hébergé évite le travail de stockage, de GPU et d’exploitation nécessaire à la recette locale publiée. Servir le modèle en local n’a de sens que si votre équipe maîtrise déjà les opérations sur GPU distribués ou doit garder un contrôle strict sur les données.
| Critère de décision | API hébergée | Déploiement local de Hy4 |
|---|---|---|
| Mise en place | Compte fournisseur et clé API | Téléchargement des poids et construction du runtime |
| Passage à l’échelle | Géré par le fournisseur | Les exemples officiels utilisent un parallélisme tensoriel sur 8 voies |
| Stockage | Aucun poids local | Dépôt Hugging Face indiqué à environ 1.56 TB |
| Comportement de l’API | Dépend du fournisseur | La configuration de vLLM/SGLang est sous votre contrôle |
| Risque principal | Limites de preview et modifications de route | Matériel, compatibilité du runtime et coût d’exploitation |
Dans quels cas héberger Hy4 en local
N’auto-hébergez Hy4 que si vous exploitez déjà une infrastructure multi-GPU adaptée, devez conserver les prompts dans votre environnement, pouvez maintenir vLLM ou SGLang et acceptez le comportement d’un modèle preview. Tencent documente vLLM avec Python 3.12 et SGLang avec transformers>=5.6.0, mais ces commandes sont des exemples, pas des prérequis minimaux garantis.
Une première discussion de la communauté rappelle aussi pourquoi la question matérielle doit précéder celle des benchmarks :
« Je ne sais pas qui ... fait tourner des modèles de 780b... » — u/_-_David dans la discussion r/LocalLLaMA consacrée à Hy4 preview.
C’est une réaction d’utilisateur, pas une mesure de capacité. Elle reste néanmoins un filtre utile : un modèle proposant 1M tokens de contexte n’est pas automatiquement praticable en local.
Hy3 reste la référence la moins chère
Hy3 standard est l’option la moins coûteuse dans la grille TokenHub actuelle de Tencent : CNY 1 en entrée, CNY 4 en sortie et CNY 0.25 pour l’entrée en cache par million de tokens. Le tarif d’entrée non mise en cache de Hy4 est six fois plus élevé, et son tarif de sortie 4.5 fois supérieur. Le passage à Hy4 doit donc répondre à un besoin réel de contexte plus vaste ou de meilleures performances sur des tâches difficiles.
| Question de sélection | Choisissez Hy4 preview si… | Choisissez Hy3 standard si… |
|---|---|---|
| Contexte | Votre charge de travail exige la classe des 1M tokens | Vos prompts tiennent dans une limite actuelle plus faible |
| Budget | Les capacités supplémentaires justifient le tarif CNY 6/18 | La réduction du coût par token est prioritaire |
| Stabilité | Vous pouvez tester une route preview | Vous préférez la référence établie, plus simple |
La même page officielle de TokenHub indique la suppression de Hy3 preview le 31 août 2026 : ce n’est donc pas une cible pertinente pour une nouvelle intégration.
Avant de mettre Hy4 preview en production
- Consignez le fournisseur, l’ID du modèle, la devise, la région et l’horodatage de la grille tarifaire.
- Envoyez une requête courte, puis vérifiez le modèle et le fournisseur retournés.
- Répétez une requête avec un préfixe stable pour tester la comptabilisation du cache.
- Testez la longueur de contexte réellement requise par votre application au lieu de supposer une qualité homogène sur toute la fenêtre.
- Testez séparément une génération longue, car la sortie est le compteur coûteux.
- Envoyez des requêtes d’appel d’outils et de sortie structurée si votre application en a besoin ; OpenRouter les indique actuellement toutes deux comme non prises en charge.
- Journalisez les entrées non mises en cache, les lectures de cache, les sorties, les erreurs et les tentatives répétées.
- Gardez une solution de repli et des prompts de régression pendant que la route construit son historique de disponibilité et d’usage.
OpenRouter indique actuellement ne pas disposer de suffisamment de données de disponibilité et d’utilisation applicative pour Hy4 preview. Cela ne prouve pas une faible fiabilité, mais laisse peu d’historique de service public pour planifier la capacité.
FAQ sur les tarifs de l’API Hy4 preview
Quel est le prix de l’API Hy4 preview ?
Tencent Cloud TokenHub affiche CNY 6 en entrée, CNY 18 en sortie et CNY 0.30 pour l’entrée en cache par million de tokens. OpenRouter affiche $0.834, $2.501 et $0.042 pour ces mêmes compteurs sur sa page hébergée.
Quel est l’ID de modèle de Hy4 preview sur OpenRouter ?
Utilisez tencent/hy4-preview. Vérifiez le fournisseur et le modèle retournés dans votre compte, car les réglages de routage hébergé peuvent évoluer.
Hy4 preview prend-il en charge une fenêtre de contexte de 1M tokens ?
Oui. La carte de modèle Tencent indique 1M tokens, tandis qu’OpenRouter spécifie 1,048,576 tokens et une génération maximale de 64,000 tokens pour sa route.
Hy4 preview est-il open source ?
Tencent publie les checkpoints Hy4 preview sous Apache License 2.0 sur sa carte de modèle officielle. « Open-weight » est une formulation plus précise pour désigner les checkpoints téléchargeables.
L’endpoint OpenRouter prend-il en charge les appels d’outils ?
La fiche OpenRouter consultée répond non. Elle n’accepte pas tools et ne prend pas en charge une sortie structurée imposée via response_format ; le serving local et d’autres fournisseurs peuvent offrir un comportement différent.
La décision en une phrase
Utilisez une route Hy4 preview hébergée pour une évaluation contrôlée et des expérimentations de contexte long ; ne l’auto-hébergez que si la capacité GPU distribuée, les exigences de contrôle des données et le risque lié au statut preview correspondent tous à votre charge de travail.