Avec $8 en entrée et $40 en sortie par million de tokens pour Astra, contre $2 et $10 pour Sol, Astra affiche un tarif quatre fois supérieur. Mais la facture réelle est plus nuancée : dans les chiffres de coût par tâche FrontierCode ci-dessous, Sol gère le code courant pour environ un cinquième du prix ($1.29 contre $5.97). Astra garde en revanche une avance d’environ 4 à 10 points sur les tests spécialisés les plus exigeants, là où une exécution réussie peut éviter plusieurs tentatives.
Tarifs OpenAI et disponibilité des modèles
OpenAI présente Astra comme le modèle destiné aux projets les plus complexes, et Sol comme celui du travail quotidien (annonce de lancement). Ne mélangez pas les deux compteurs : l’usage inclus dans les forfaits ChatGPT/Codex ne couvre pas les appels API, et les appels API ne déduisent rien des quotas de ces forfaits. Les deux modèles offrent une fenêtre de contexte de 1,050,000 tokens, avec jusqu’à 922,000 tokens en entrée et 128,000 tokens en sortie par requête. Ils acceptent du texte et des images en entrée, et produisent du texte. Leurs identifiants sont gpt-6.2-astra et gpt-6.2-sol dans les API Responses et Chat Completions.
Tarifs API Standard, par million de tokens :
| Modèle | Entrée | Entrée en cache | Écriture en cache (30 min) | Sortie |
|---|---|---|---|---|
| GPT-6.2 Astra | $8.00 | $0.40 | $10.00 | $40.00 |
| GPT-6.2 Sol | $2.00 | $0.10 | $2.50 | $10.00 |
| GPT-6 Astra (prédécesseur) | $10.00 | $1.00 | $12.50 | $50.00 |
| GPT-6.1 Sol (prédécesseur) | $2.00 | $0.10 | $2.50 | $10.00 |
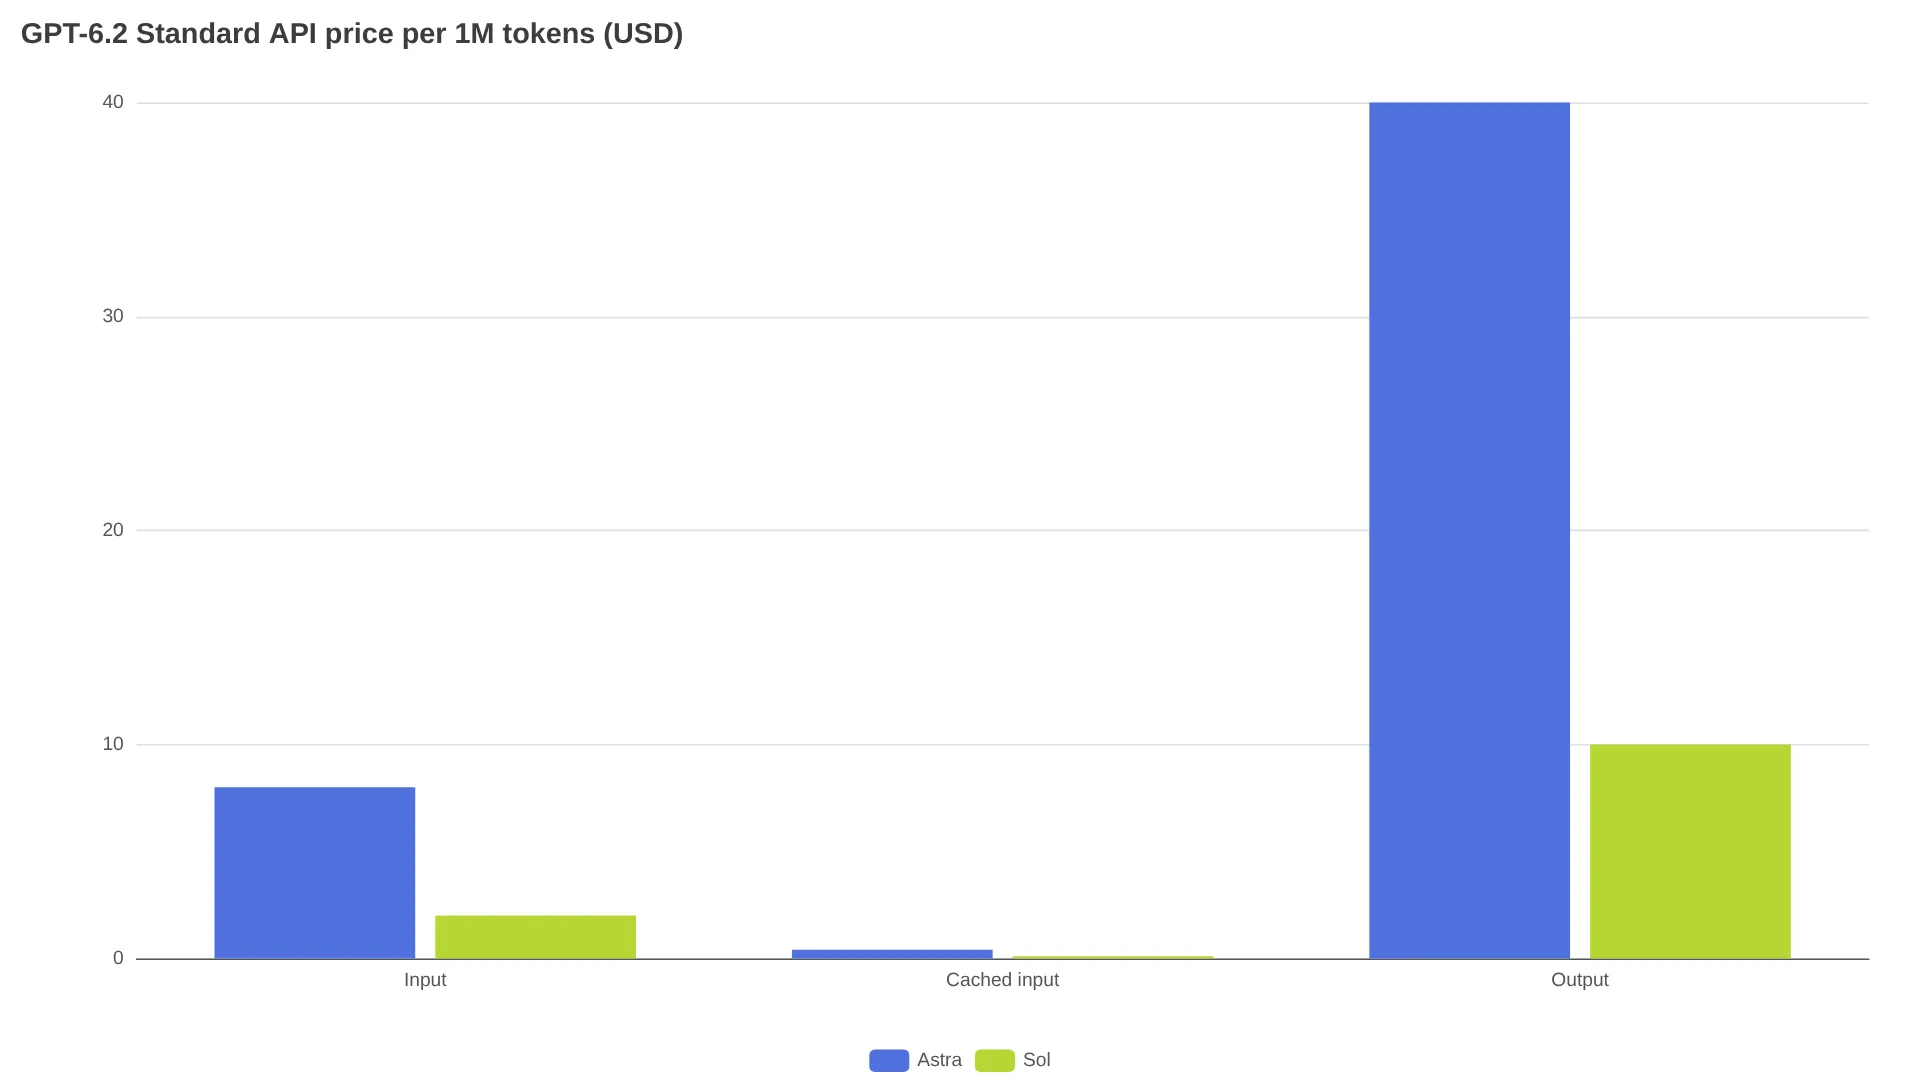
Astra coûte 20 % de moins que GPT-6 Astra en entrée comme en sortie, et 60 % de moins pour les entrées servies depuis le cache. Sol conserve les tarifs de GPT-6.1 Sol. Au lancement, le 17 novembre 2026, les deux modèles sont généralement disponibles dans l’API ; Batch est 50 % moins cher que Standard, tandis que les fenêtres d’exécution en arrière-plan bénéficient de 30 à 40 % de réduction (détail des paliers par GenAI Brief).
Les trois facteurs qui font varier la facture
1. Écrire dans le cache est payant. La lecture depuis le cache revient à 5 % du tarif d’entrée ($0.40 pour Astra, $0.10 pour Sol). L’écriture dans le cache coûte 1.25x le prix d’entrée pour une durée de conservation de 30 minutes ($10.00 pour Astra, $2.50 pour Sol), et 2.5x pour 12 heures, selon la grille tarifaire de GenAI Brief. Exemple : réécrire 108,000 tokens d’historique après un échec de cache coûte 108,000 × $10/M = $1.08 avec Astra, ou 108,000 × $2.50/M = $0.27 avec Sol, avant même la sortie.
2. Au-delà de 272,000 tokens, toute la requête change de tarif. Dès que l’entrée dépasse 272K tokens, le prix d’entrée double ($8 à $16 pour Astra, $2 à $4 pour Sol) et celui de la sortie est multiplié par 1.5 ($40 à $60 pour Astra, $10 à $15 pour Sol). Dans le test tarifaire détaillé de GenAI Brief, ajouter 20K tokens d’historique pour franchir ce seuil a fait passer un tour Astra de $0.344 à $0.624 : une hausse de 81 % pour 7 % d’entrée supplémentaire. Résumez ou tronquez l’historique avant 272K ; si cela modifie le préfixe mis en cache, prévoyez aussi un échec de cache.
3. Les niveaux de vitesse multiplient tous les prix. Fast coûte 2x Standard. Ultrafast coûte 3x jusqu’au 28 février 2027, puis 6x à partir du 1er mars 2027 (résidence américaine uniquement ; Standard/Fast/Batch prennent en charge les États-Unis et l’UE), selon les règles de paliers de GenAI Brief et la documentation OpenAI sur les niveaux de traitement. À 3x, la sortie Astra coûte $120/M ; à 6x, elle atteint $240/M.
Le bon indicateur : le coût par tâche
À volume de tokens identique, Astra coûte quatre fois plus cher que Sol. Il ne devient rentable que s’il consomme moins de tokens, nécessite moins de tentatives ou évite des corrections humaines coûteuses. La règle d’équilibre est simple : à empreinte de tokens égale, une tentative Astra doit remplacer plus de quatre tentatives Sol, ou réduire d’environ 75 % le volume de tokens pondéré, pour l’emporter sur le seul coût API direct.
Coûts par tâche rapportés ci-dessous : les benchmarks, niveaux d’effort et méthodes de calcul diffèrent, donc utilisez-les pour orienter vos tests et confirmez-les avec vos propres relectures :
| Source / charge de travail | Astra | Sol | Ce qu’il faut en retenir |
|---|---|---|---|
| Intelligence Index d’Artificial Analysis, effort maximal | 62 pour $4.00/tâche, 10.4 min (GPT-6 Astra : 57 pour $6.24) | 57 pour $1.01/tâche, 7.9 min | Sol égale le score de 57 de GPT-6 Astra pour environ un sixième du coût par tâche de $6.24 |
| FrontierCode 2.0 via DataCamp, effort maximal | 44.2 % pour $5.97/tâche | 43.8 % pour $1.29/tâche | 0.4 point d’écart pour environ 5x le coût par tâche ; sur ces résultats de programmation, Astra ne justifie pas son surcoût |
| Harvey LAB-AA / SecureSWE / Terminal-Bench-Science via DataCamp | 15.0 % / 65.7 % / 77.1 % | 11.1 % / 55.6 % / 68.0 % | L’écart d’Astra est le plus marqué ici ; à tester pour le juridique, le code sécurisé et les sciences |
| BenchCAD 2.1 Core via DataCamp | 82.5 % | 73.1 % | Un écart d’environ 9 points en CAO justifie un test d’Astra pour ce type de travail |
| Reconstruction de slide par DataCamp, test à une seule exécution | $0.22, 4,968 tokens de sortie | $0.07, tailles de police exactes | Aucun écart de qualité visible sur cette tâche à base de modèle ; Sol l’emporte sur le coût |
| Agents' Last Exam, résumé par DataCamp des chiffres d’OpenAI, Sol High vs ancien Astra Max | — | Sol High 72.0 % pour $0.69/tâche, contre GPT-6 Astra Max 73.1 % pour $8.99 | Environ 1 point de moins pour environ 1/13 du coût dans cette configuration |
Exemple chiffré : à $0.10 par essai Sol, avec 2 réussites sur 3, Sol revient à $0.15 par résultat accepté. Astra, à $0.40 l’essai, ne peut pas faire mieux uniquement grâce à son taux de réussite. Astra devient gagnant lorsque la réussite de Sol s’effondre : par exemple, 1 réussite en 5 essais ($0.50 par résultat accepté) face à Astra qui réussit du premier coup ($0.40). OpenAI indique qu’Astra produit 22 % de tokens de sortie en moins sur GDPval v2 ; considérez cette affirmation du fournisseur comme un indicateur, pas comme une certitude.
Commencez avec Sol pour le code courant et les agents à fort volume ; testez Astra pour le juridique, la CAO ou les longues exécutions scientifiques. Ne basculez vers Astra que si total spend / accepted tasks, en intégrant les nouvelles tentatives et les corrections, est inférieur.
Stabilisez le préfixe pour éviter de tout repayer
En cours de conversation, modifier les instructions, les outils, les schémas ou une sortie précédente peut invalider le cache et déclencher un nouveau raisonnement dans GPT-6.2.
Pour préserver le cache de préfixe (notes d’intégration de GenAI Brief, documentation des modèles OpenAI) :
- Ajoutez un nouveau message développeur ou
configuration_update, plutôt que de réécrire les messages d’ouverture. - Ajoutez des outils avec
additional_tools, ou contrôlez-les avectool_choice/allowed_tools, au lieu de remplacer la liste d’outils en pleine conversation. - Réduisez les anciennes sorties d’outils et la taille des images avant le premier envoi.
- Utilisez Prompt Cache Diagnostics et
input_transformationsde Responses (prefix_mismatch) pour diagnostiquer le problème avant de basculer le trafic de production.
Checklist de migration vers Astra et Sol
D’après le guide de migration d’EpiFive et les règles d’intégration de GenAI Brief, vérifiés par rapport au comparatif des modèles OpenAI :
- Remplacez
modelpargpt-6.2-astraougpt-6.2-sol. - Commencez avec
reasoning.effort: mediumdans Responses, oureasoning_effort: mediumdans Chat Completions.noneest refusé ; utilisezlowpour les appels à faible latence. - Supprimez
temperature,top_petlogprobs/top_logprobsdes requêtes. Déplacez l’appel d’outils vers l’API Responses. - Lors d’une migration depuis GPT-5.5 ou une version antérieure, remplacez
prompt_cache_retentionparprompt_cache_options.ttl: "30m"et prévoyez le coût des écritures en cache. - Avec Zero Data Retention,
storeest traité commefalse: renvoyez les éléments de sortie précédents dans l’ordre, y compris les éléments de raisonnement chiffrés. - Rejouez 30 tâches courtes par modèle en mesurant le taux de réussite, les nouvelles tentatives, les tokens de sortie et le coût par résultat accepté. Ajoutez une longue session d’agent avec préfixe stable, puis une autre après modification du préfixe, afin de mesurer le taux de cache touché et le coût total par tâche.