Avec une facturation au token, le choix de Gemini 4 Neon dépend d’abord du calendrier : Carbon reste moins cher pendant les 11 prochains jours, puis Neon coûtera 25 % de moins à partir du 1er décembre. Google a lancé Gemini 4 Neon le 18 novembre 2026, au tarif de 3 $ par million de tokens en entrée et 15 $ par million en sortie. Le modèle dispose d’une fenêtre de 1 million de tokens et n’offre aucun niveau gratuit.
Le 30 novembre, la hiérarchie des prix s’inverse
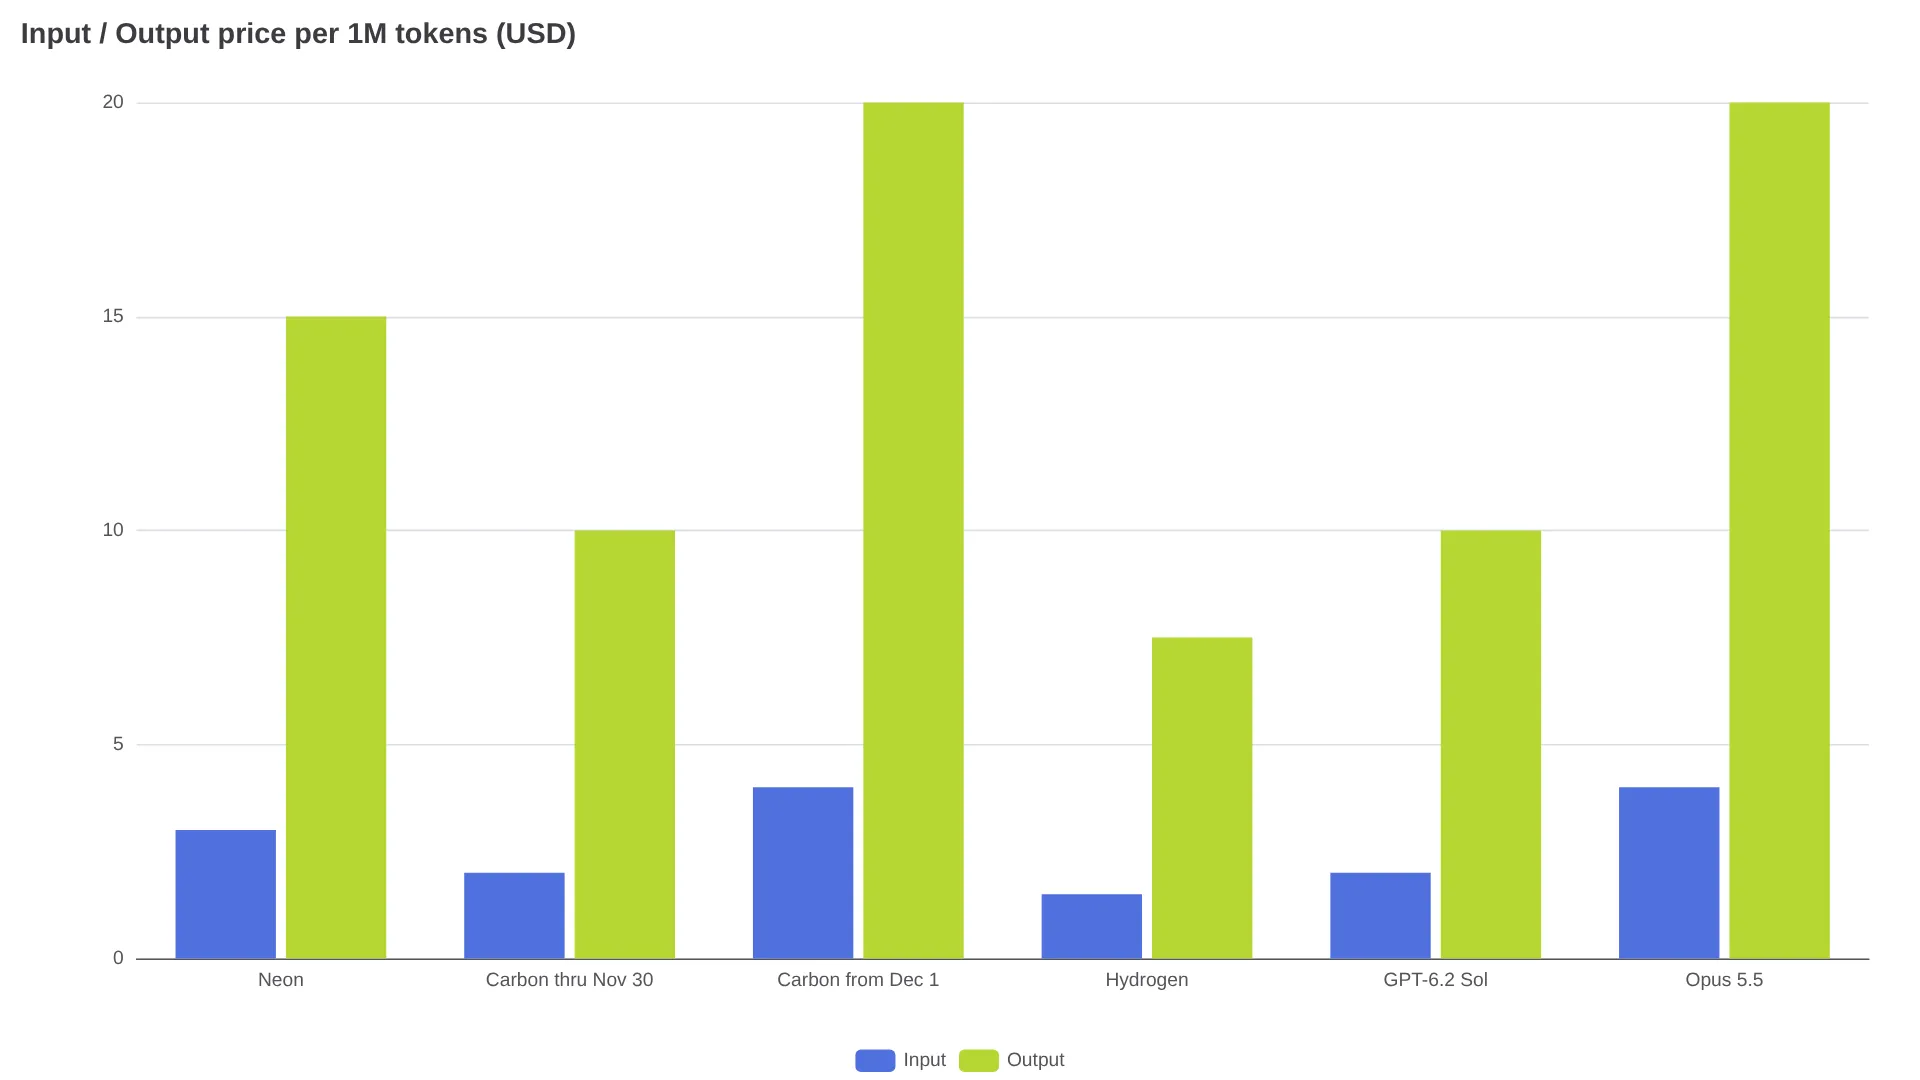
Le tarif de l’API Gemini 4 Neon n’a vraiment de sens qu’en tenant compte de la date. Jusqu’au 30 novembre 2026, Gemini 4 Carbon est proposé à titre promotionnel à 2 $ en entrée et 10 $ en sortie par million de tokens. À partir du 1er décembre, Carbon et Argon passent à 4/20 $, ce qui rend Neon, à 3/15 $, exactement 25 % moins cher par token (comparatif des tarifs). Avant cette date, Neon coûte donc 50 % de plus que Carbon au tarif promotionnel.
Google préfère comparer le coût par tâche et affirme que Neon revient 32 % moins cher que Carbon avec un niveau de réflexion élevé, et permet au moins 36 % d’économies en mode xhigh face à des concurrents non précisés (analyse du lancement). Pour établir votre budget, partez des tarifs publiés de 3/15 $. Les chiffres par tâche viennent de Google et ne reposent sur aucune référence concurrente nommée.
La place de Neon dans la gamme Gemini 4
Gemini 4 Neon occupe le milieu de la gamme : il va plus loin que Hydrogen en raisonnement et se rapproche de la qualité de Carbon, tout en exécutant les tâches plus rapidement, selon le positionnement du modèle par OpenRouter. Carbon était le choix par défaut pour le code de pointe, Argon le modèle phare pour les tâches de raisonnement en mathématiques et en sciences, tandis que Hydrogen joue le rôle de modèle économique pour les gros volumes, à 1,50/7,50 $ (index des prix). Neon propose quatre niveaux de raisonnement — low, medium, high et xhigh — avec high comme réglage par défaut (caractéristiques fournisseur).
Voici les accès disponibles au lancement, d’après l’annonce de Google et la présentation détaillée du lancement :
| Service | Accès à Neon |
|---|---|
| Gemini API | Développeurs payants, identifiant de modèle gemini-4-neon (fiche catalogue) |
| AI Studio / application Gemini / Antigravity | Formule payante ainsi que Google AI Pro et Ultra |
L’appellation Neon dans Antigravity mérite toutefois quelques réserves. Des utilisateurs du fil Antigravity indiquent que l’entrée de l’orchestrateur peut encore pointer vers un prompt système Carbon dans certaines sessions. Une réponse résume la situation ainsi : « its just the orchestrator. not neon » (fil de discussion). Tant que Google n’aura pas publié la correspondance avec les identifiants de build, basez votre facturation sur l’identifiant du modèle API, pas sur le libellé de l’interface.
Ce que couvrent vraiment les tarifs 3/15 $
Le tarif standard est de 3,00 $ en entrée, 15,00 $ en sortie et 0,15 $ pour les tokens d’entrée mis en cache par million (annonce officielle). Ces prix restent identiques sur toute la fenêtre de contexte de 1 048 576 tokens (vérification des tarifs). Des index tiers indiquent 1,50/7,50 $ pour Batch et Flex, ainsi que 5,40/27,00 $ pour Priority (caractéristiques et tableau fournisseur). Mais Google n’avait pas encore publié ces offres Neon sur sa page générale des tarifs au lancement : considérez donc Neon comme disponible uniquement en Standard jusqu’à la mise à jour de cette page (analyse du lancement).
La formule est simple : coût = entrée nouvelle / 1 M × 3 $ + entrée en cache / 1 M × 0,15 $ + sortie, raisonnement compris, / 1 M × 15 $.
Trois règles de facturation changent sensiblement le prix affiché (analyse du lancement et référence tarifaire) :
- Les tokens de réflexion sont facturés comme des tokens de sortie. À 15 $, la sortie pèse donc lourd dans toutes les factures.
- Le cache est uniquement implicite, avec un prompt minimum de 4 096 tokens et une remise de 95 % sur les entrées éligibles. Il n’existe ni cache explicite via
cachedContents, ni frais d’écriture du cache. - La sortie synchrone est limitée à 65 536 tokens (caractéristiques). Pour aller plus loin, il faut passer par une exécution en arrière-plan.
Les prompts de moins de 4 096 tokens ne bénéficient absolument pas du cache (référence tarifaire). Un bot de support qui reçoit 1 200 tokens en entrée ne pourra donc jamais profiter du tarif de 0,15 $.
Le coût de deux charges de travail types
Ces simulations utilisent un nombre de tokens fixe et excluent les nouvelles tentatives ainsi que la longueur variable du raisonnement. Le poids de la sortie est déterminant. Toutes les lignes appliquent les mêmes taux de mise en cache, avec les tarifs catalogue propres à chaque modèle, issus du tableau tarifaire du lancement.
Session de programmation : 50 appels, 80 000 tokens en entrée par appel, dont 90 % issus du cache, et 2 500 tokens en sortie par appel, raisonnement compris. Totaux : 400 000 tokens d’entrée nouvelle, 3,6 millions en cache et 125 000 en sortie.
| Modèle | Coût de la session |
|---|---|
| Gemini 4 Neon 3/15 $ | 3,62 $ (1,20 $ d’entrée nouvelle + 0,54 $ en cache + 1,88 $ de sortie = 3,615 $) |
| Carbon jusqu’au 30 novembre 2/10 $ | 2,41 $ |
| Carbon à partir du 1er décembre 4/20 $ | 4,82 $ |
| Hydrogen 1,50/7,50 $ | 1,81 $ |
| GPT-6.2 Sol 2/10 $ | 2,41 $ |
Support à grande échelle : 10 000 conversations par jour pendant 30 jours, 6 000 tokens en entrée par conversation dont 75 % éligibles au cache, et 500 tokens en sortie par conversation. Totaux : 450 millions de tokens d’entrée nouvelle, 1,35 milliard en cache et 150 millions en sortie.
| Modèle | Coût mensuel |
|---|---|
| Gemini 4 Neon 3/15 $ | 3 802,50 $ (dont 2 250 $ pour la sortie) |
| Carbon jusqu’au 30 novembre 2/10 $ | 2 535,00 $ |
| Carbon à partir du 1er décembre 4/20 $ | 5 070,00 $ |
| Hydrogen 1,50/7,50 $ | 1 901,25 $ |
| GPT-6.2 Sol 2/10 $ | 2 535,00 $ |
Neon coûte deux fois plus cher qu’Hydrogen par token et 50 % de plus que Sol à 2/10 $. Pour être compétitif à l’échelle d’une tâche, il doit donc parvenir au résultat avec moins de tokens ou moins de nouvelles tentatives. Les chiffres cités — Intelligence Index 61, classé n° 3, et Coding Agent Index, classé n° 1 — sont communiqués par les fournisseurs et ne prouvent pas que le coût réel par tâche sera inférieur (récapitulatif des benchmarks).
Le prix des tokens ne dit rien de votre quota
Les pourcentages affichés dans l’application ne se convertissent pas directement en dollars API. Un utilisateur Pro rapporte une consommation de 1 à 2 % par message lors de longues sessions Neon :
J’ai aussi essayé de basculer des conversations existantes avec un long contexte vers Neon : je vois une consommation de 1 à 2 % par message. Ce modèle pourrait donc être réellement utilisable avec l’offre Pro ! — u/biblecrumble (fil de discussion)
Le quota de l’application dépend des fenêtres de cinq heures, du niveau de réflexion et des appels aux outils. La facturation API, elle, compte chaque token traité, y compris ceux du raisonnement, auxquels s’ajoutent les recherches grounding facturées séparément pour chaque requête (analyse du lancement). Pour l’API, raisonnez en dollars à partir des tableaux ci-dessus ; pour l’abonnement, mesurez la marge disponible à partir de vos propres essais en high et xhigh.
Changer d’identifiant ne suffit pas : trois réglages à corriger
Les utilisateurs de Carbon, Argon ou Hydrogen peuvent migrer en remplaçant l’identifiant du modèle par gemini-4-neon (analyse du lancement). Trois pièges peuvent toutefois encore faire échouer les appels (analyse du lancement) :
- Définissez explicitement
thinking_level. Neon utilise high par défaut. - Supprimez les champs
cached_content. Le cache explicite n’est pas pris en charge. - Supprimez
temperature,top_pettop_k. Les valeurs hors plage renvoient une erreur HTTP 400 ; les autres sont ignorées.
Augmentez également max_output_tokens jusqu’à 65 536 ou utilisez une exécution en arrière-plan pour les sorties longues.
Faut-il migrer maintenant ou profiter encore de Carbon ?
| Situation | Choix recommandé |
|---|---|
| Mise en production avant le 30 novembre, besoin d’un raisonnement maximal | Restez sur Carbon à 2/10 $ et testez Neon en parallèle |
| Agents en production en décembre, contexte long | Neon à 3/15 $ est le candidat au tarif catalogue — validez le taux de réussite et les nouvelles tentatives avant de migrer |
| Chat simple à gros volume | Restez sur Hydrogen à 1,50/7,50 $, la seule option gratuite de cette sélection (index des tarifs) |
| Tarif catalogue le moins cher parmi les modèles de pointe aujourd’hui | GPT-6.2 Sol à 2/10 $, si votre architecture autorise OpenAI |
| Besoin d’une offre Batch documentée | Attendez : Batch n’est pas publié pour Neon |
FAQ
Combien coûte l’API Gemini 4 Neon ?
3 $ en entrée, 15 $ en sortie et 0,15 $ pour l’entrée en cache par million de tokens, selon Google.
Quelles sont les limites de contexte et de sortie ?
1 048 576 tokens en entrée et 65 536 tokens en sortie synchrone.
Existe-t-il une offre gratuite ?
Non. Neon est réservé aux offres payantes ; Hydrogen conserve une formule gratuite.
Batch, Flex et Priority sont-ils disponibles ?
Google ne les avait pas publiés au lancement. Des listings tiers affichent 1,50/7,50 $ pour Batch et Flex, ainsi que 5,40/27 $ pour Priority — vérifiez ces tarifs avant de bâtir votre budget.
Comment fonctionne le cache ?
Il est uniquement implicite, avec un minimum de 4 096 tokens et une remise de 95 % sur les entrées éligibles.
Quel est l’identifiant du modèle ?
gemini-4-neon.
Neon, Hydrogen ou Carbon : lequel choisir ?
Hydrogen pour les gros volumes à bas coût ; Carbon jusqu’au 30 novembre pour les tokens de pointe les moins chers ; Neon à partir du 1er décembre pour le raisonnement avancé, à un tarif 25 % inférieur aux 4/20 $ de Carbon.
Combien coûte une requête avec 2 000 tokens en entrée et 500 en sortie ?
0,0135 $ au tarif catalogue, avant mise en cache. Les tokens de réflexion sont facturés comme de la sortie.