Avec le niveau high, Neon offre ici le meilleur rapport qualité-prix pour les agents qui travaillent sur de longs contextes, surtout quand il faut limiter les mauvaises réponses. Astra et Sol restent toutefois moins chers à la tâche. Cette synthèse réalisée le jour du lancement s’appuie sur les spécifications officielles, les classements et des tests indépendants. Je n’ai pas testé Neon moi-même.
Neon accélère l’approche de Carbon pour les agents, avec un compromis bien identifié
Gemini 4 Neon est sorti le 18 novembre 2026 sous le nom gemini-4-neon. D’après Google et 9to5Google, il occupe le milieu de la gamme Gemini 4, entre Hydrogen et Carbon. Google annonce des exécutions complètes plus rapides que celles de Carbon, pour un coût inférieur par tâche — une analyse reprise par des membres de DeepMind, qui le décrivent comme moins cher et plus rapide que Carbon (@_mohansolo). Il se classe 3e de l’Artificial Analysis Index avec un score de 61 en xhigh et 2e d’Agent Arena avec 1336 points sur plus de 4 200 sessions. Les documents de lancement consultés ne donnent pas les scores d’Opus 5.5 et de Fable 5.2 sur le même classement Arena. La comparaison ci-dessous croise donc les rangs des index avec des tests réalisés sur les mêmes tâches.
Tarifs, fenêtre de contexte et disponibilité
Neon coûte 3 $ par million de tokens en entrée, 15 $ en sortie et 0,15 $ pour les tokens d’entrée mis en cache, selon Google. Sa fenêtre de contexte atteint 1 048 576 tokens, avec une limite de 65 536 tokens pour une réponse unique. Les niveaux de raisonnement low / medium / high (par défaut) / xhigh sont facturés comme de la sortie : les niveaux supérieurs peuvent consommer davantage de tokens de raisonnement et faire grimper la facture. Le niveau par défaut high est confirmé par l’analyse des niveaux publiée par DataCamp et par les notes API de SpringPrompt.
L’accès est payant uniquement, sans offre gratuite, d’après la vérification de l’API menée par eesel. Selon Google et 9to5Google, Neon est disponible via l’API payante d’AI Studio, Gemini pour les entreprises, Antigravity (Pro/Ultra), l’application Gemini (Pro/Ultra, qui remplace Argon), Android Studio, ainsi que Cursor. Sur ce dernier, il atteint 63,7 % dans CursorBench avec l’effort par défaut, contre 57,3 % pour Hydrogen, selon Cursor.
| Modèle | Entrée / sortie par million | Raisonnement par défaut |
|---|---|---|
| Gemini 4 Neon | 3 $ / 15 $, entrée mise en cache à 0,15 $ | high |
| Gemini 4 Hydrogen | 1,50 $ / 7,50 $ | high |
| Gemini 4 Carbon | 2 $ / 10 $ jusqu’au 30 novembre, puis 4 $ / 20 $ | medium |
| Claude Opus 5.5 | 4 $ / 20 $, réglage maximal testé | maximal testé |
| GPT-6.2 Sol | 2 $ / 10 $, réglage maximal testé | maximal testé |
Les tarifs des concurrents et les réglages retenus sont compilés dans le tableau comparatif d’eesel. À partir du 1er décembre, Neon coûtera 25 % de moins par token que Carbon. Détails : tarifs de Neon.
Pour verrouiller les niveaux de raisonnement, passez par l’API ; pour profiter d’un quota géré, utilisez l’application ou Antigravity. Les retours sur les quotas ne sont que des repères de planification anecdotiques : environ 1 à 3 % du quota Pro par conversation, contre environ 5 % pour une exécution de 10 minutes avec 3 sous-agents, selon des témoignages d’utilisateurs.
Benchmarks face à Opus 5.5, Fable 5.2 et Sol
Les scores sont communiqués par les fournisseurs via Google, puis compilés par eesel et DataCamp.
| Test | Neon | Concurrent | À retenir |
|---|---|---|---|
| Vals Index | 70,9 %, 2e | Fable ~71,3 % | Tout près du sommet |
| AutomationBench | 56,3 %, 1er | Opus 42,5 %, Sol 41,3 % | Avantage aux agents |
| GraphWalks 256K–1M | 95,2 % | Opus 66,8 %, Sol 80,1 % | Avantage sur les longs contextes ; commencez par rejouer votre fichier le plus volumineux, certains utilisateurs d’Argon signalant des résumés excessifs (discussion) |
| Terminal-Bench 4.1 | 65,2 % | Opus 65,8 % | Quasi-égalité, Opus garde 0,6 point |
| FrontierCode 2.0 | 46,2 % | Opus 47,3 % | Opus devance Neon de 1,1 point |
| CursorBench 4.1 | 63,7–65,4 % | Opus 58,1 % | Neon domine avec l’effort par défaut |
Le coût par tâche change complètement la lecture des tarifs au token, selon Artificial Analysis via eesel :
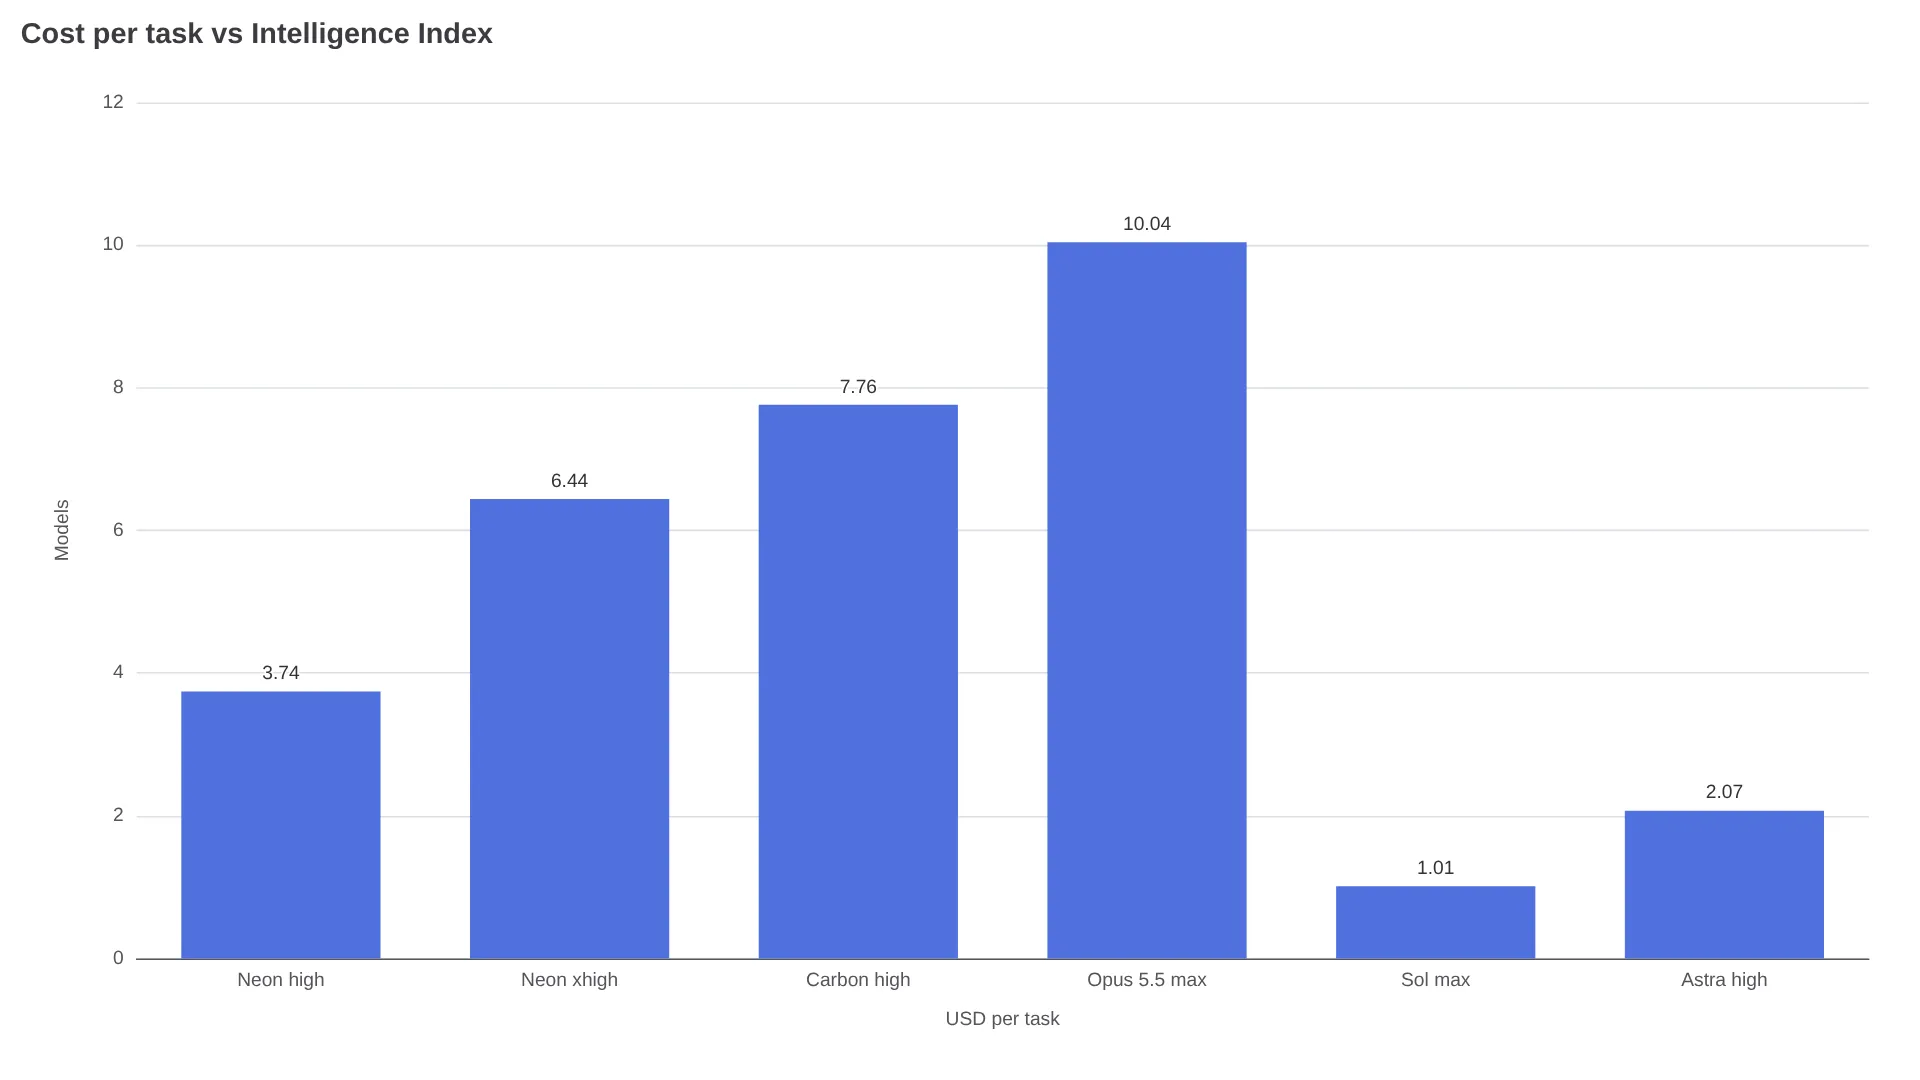
Neon en high obtient 59,6 pour 3,74 $ en 14,8 minutes ; Carbon en high atteint 60,0 pour 7,76 $ en 37,2 minutes ; Opus au maximum obtient 59,1 pour 10,04 $ ; Astra en high atteint 60,1 pour 2,07 $ ; Sol au maximum obtient 57,3 pour 1,01 $. Neon en xhigh monte à 61,4 pour 6,44 $ en 21,5 minutes. Utilisez high, sauf si 1,8 point supplémentaire justifie 2,70 $ et 6,7 minutes de plus.
Neon face à Fable 5.2 : les premiers retours plaident pour une répartition des rôles
Sur le SWE-sweep avec le harnais du fournisseur (harnais Antigravity), Neon atteint 39,0 %, contre 10,1 % pour Opus et 8,3 % pour Sol. Avec le mini-harnais SWE partagé, les résultats sont de 12,8 % pour Neon, 11,6 % pour Sol et 3,6 % pour Opus, selon DataCamp. Une grande partie de l’écart mis en avant vient donc du harnais, et pas uniquement du modèle.
"J’utilise Fable 5.2 comme orchestrateur et développeur, avec Neon comme agent de codage, et c’est la meilleure combinaison que j’aie jamais utilisée." — u/1969Stingray (discussion)
À en croire les retours d’utilisateurs, Fable se prête mieux à l’orchestration et Neon à l’implémentation ; vérifiez toutefois le résultat sur votre dépôt. Dans AA-Omniscience, Neon produit 14 % de réponses erronées au lieu de décliner, contre 50 % pour Opus, 55 % pour Sol, 58 % pour Astra et Fable. En revanche, sa couverture atteint 59–60 % de réponses correctes, contre 66 % pour Astra et 77 % pour Fable, selon eesel.
Tests pratiques : échecs aux échecs, fiches produit et 105 bugs réels
| Test | Résultat | Limite |
|---|---|---|
Page d’échecs, 3 exécutions en medium (DataCamp) | Neon réussit 3 fois sur 3 pour 0,83–1,06 $ ; Carbon 1 fois sur 3, deux exécutions atteignant la limite de 65K ; 16 parties, aucun coup illégal | Une seule tâche ; Carbon aurait probablement terminé avec le mode en arrière-plan |
| CatalogBench factuel (SpringPrompt) | 78,6 % de contenus prêts à publier après 3 exécutions, 1er sur 35 ; lit les caractéristiques directement sur l’emballage | Ventes : 32,1 % ; présentations : 24e ; questionnaires : 22e avec le budget activé |
| 105 bugs réintroduits (@PawelHuryn) | Neon xhigh 63, contre Astra 62,7, Fable 58 et Carbon 57,3 | Un seul testeur |
SpringPrompt a utilisé OpenRouter en medium, tandis que l’API Google adopte high par défaut : le niveau de verbosité n’est donc pas comparable. Des cas isolés de fuites dans AI Studio ont également été signalés (discussion). Pour le chat, les mesures d’eesel donnent 56,5 s avant le premier token avec Neon en xhigh. Pour les réponses interactives, mieux vaut donc préférer medium ou Hydrogen.
Quel modèle choisir selon votre usage
| Usage | Choix | Pourquoi |
|---|---|---|
| Agents complexes, longs documents, refactorings | Neon high | 59,6 pour 3,74 $, 2e d’Agent Arena, 3 réussites sur 3 aux échecs |
| Projets nécessitant le plus long horizon | Carbon, selon le positionnement de la gamme par Google | Google réserve Carbon aux projets les plus difficiles ; aucun test sur la même tâche ne le confirme ici |
| Orchestration et développement | Fable en tête + Neon pour le code | Combinaison fondée sur les retours anecdotiques ci-dessus ; validez-la d’abord |
| Facture minimale par tâche | Sol au maximum à 1,01 $ ; Astra en high à 2,07 $ obtient un meilleur score | Les deux affichent davantage de mauvaises réponses dans AA-Omniscience |
| Chat interactif | Hydrogen ou Neon en medium | La latence avant le premier token en xhigh est trop élevée pour discuter |
| Usage réglementé | Attendez la documentation | Le rapport de sécurité complet n’était toujours pas disponible le 19 novembre ; ne validez le modèle qu’au regard des documents dont vous avez besoin |
Testez-le vous-même en une après-midi
Lancez le même prompt, avec les mêmes fichiers et le même budget de raisonnement, sur Neon en high, sur votre modèle actuel par défaut et sur une alternative moins chère. Notez le taux de réussite, le coût, la durée et les mauvaises réponses. Pour votre file de tâches, cette comparaison vaut mieux que n’importe quel classement. Pour les calculs côté Opus : test d’Opus 5.5, test de Fable 5.2.