Les graphiques des services hébergés annoncent 280 tokens par seconde. Sur un portable, les premiers essais oscillent pourtant entre 8 et 220 tok/s selon le matériel et le moteur utilisé. Inkling 2 Mini mérite le détour pour les agents de code hors ligne : ce modèle à poids ouverts de 26,4 Md de paramètres tient dans environ 20 Go. Mais ses limites en conversation, en factualité et côté API sont à connaître avant de lancer le téléchargement.
À qui profite Inkling 2 Mini — et qui ferait mieux de passer son chemin
Inkling 2 Mini excelle dans un cas d’usage précis et se montre nettement moins convaincant dans plusieurs autres. Tout dépend donc du travail à lui confier, bien plus que du tableau de benchmarks. Son terrain de prédilection : l’assistance au code hors ligne avec outils et recherche. Le chat intensif et l’utilisation exclusivement via API ne sont pas son fort.
| Votre usage | Verdict pour Mini |
|---|---|
| Agent de code hors ligne sur un Mac de 32 Go ou plus, ou sur un DGX Spark | Très bon choix : c’est là que ses meilleurs scores apparaissent |
| Travail privé avec long contexte (jusqu’à 1M de tokens en théorie) | À tester : commencez plutôt avec un contexte de 32K en pratique |
| Chat à plusieurs tours ou respect strict des consignes | À éviter : Qwen3.8-27B obtient de meilleurs résultats ici |
| Utilisation via une API hébergée aujourd’hui | À éviter : aucune offre serverless pour le moment, seulement des tarifs d’échantillonnage et de fine-tuning |
La suite détaille les chiffres derrière cette distinction : ce que change la boucle, quels benchmarks résistent à l’examen, à quoi ressemblent réellement les performances en local et ce que vous achetez pour le prix demandé.
Inkling 2 Mini : fonctionnement et particularités de la boucle
Thinking Machines Lab a publié Inkling 2 Mini le 20 novembre 2026 sous licence Apache 2.0, avec des poids ouverts. Ils sont disponibles sur Hugging Face sous le nom thinkingmachines/Inkling-2-Mini. Le modèle accepte du texte et des images en entrée, génère du texte et annonce un contexte maximal de 1 million de tokens.
| Caractéristique | Inkling 2 Mini |
|---|---|
| Sortie | 20 novembre 2026, Thinking Machines Lab |
| Licence | Apache 2.0 |
| Paramètres | 26,4 Md au total / 3,4 Md actifs par token / 5,4 Md effectifs avec les boucles |
| Couches | 24 stockées ; les 12 du milieu s’exécutent 3 fois par token (6 + 3x12 + 6 = 48 applications) |
| Routage MoE | 8 experts sur 128 par token et par couche |
| Précision | NVFP4 pour 20 couches, MXFP8 pour les 4 dernières ; checkpoint d’environ 20 Go (19,5 Go + 0,64 Go pour le prédicteur) |
| Contexte / modalités | Jusqu’à 1M de tokens ; texte + image en entrée, texte en sortie |
| Cibles locales | Mac avec 32 Go de mémoire ou plus via Ollama, ou un NVIDIA DGX Spark d’après la fiche du modèle |
Le chiffre de 3,4 Md correspond aux paramètres actifs stockés. En comptant les trois passages dans les couches bouclées, on arrive à environ 5,4 Md de calcul effectif. Les poids réutilisés réduisent la taille du fichier, mais augmentent le calcul nécessaire pour chaque token, comme l’explique le guide technique de Hugging Face.
La boucle ajoute du calcul, pas des connaissances stockées. Dans son annonce de lancement, le laboratoire présente Mini comme moins performant que les modèles Inkling plus grands en matière de rappel factuel, car les connaissances progressent surtout avec le nombre total de paramètres. D’où l’importance de la recherche et des outils pour ce modèle.
Les benchmarks convaincants — et ceux qu’il faut relativiser
Tous les scores ci-dessous proviennent des propres bancs de test du laboratoire, via la fiche Hugging Face. Mini domine pour le code et la recherche pilotés par des outils, mais fait jeu égal ou recule en raisonnement, en vision et en discipline conversationnelle.
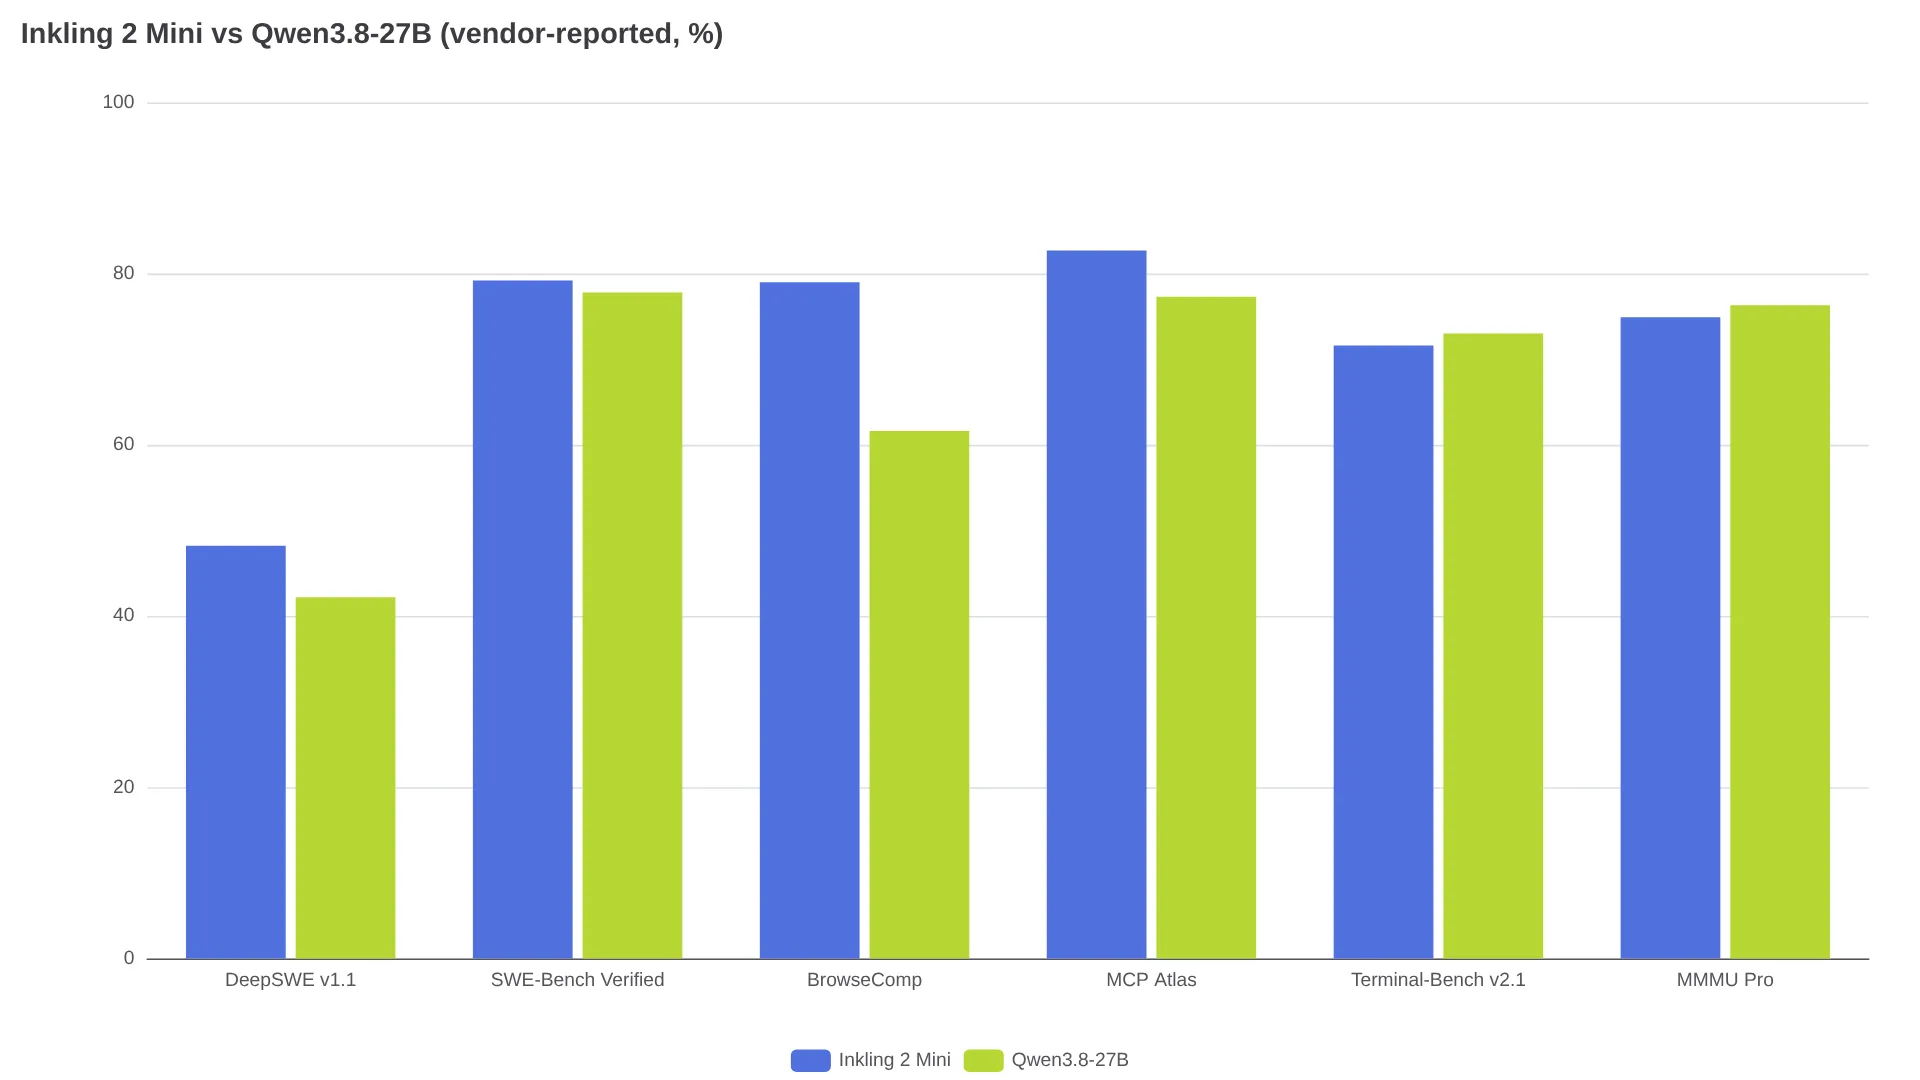
Mini prend l’avantage sur DeepSWE v1.1 avec 48,2 %, contre 42,2 % pour Qwen3.8-27B, sur SWE-Bench Verified avec 79,2 % contre 77,8 %, sur BrowseComp avec 79,0 % contre 61,6 %, et sur MCP Atlas avec 82,7 % contre 77,3 %. Artificial Analysis attribue aux deux modèles un score de 20,1 à son Intelligence Index, mais Mini termine la tâche d’indexation en 9,0 minutes contre 38,2 pour Qwen. De son côté, ARC Prize rapporte 84,5 % sur ARC-AGI-1 et 49,3 % sur ARC-AGI-2 avec le niveau de raisonnement maximal.
L’autre moitié du tableau, toujours selon la fiche du modèle, est moins flatteuse pour Mini : 15,2 % contre 15,3 % sur HLE-Diamond, 74,9 % contre 76,3 % sur MMMU Pro et 71,6 % contre 73,0 % sur Terminal-Bench v2.1. L’écart en factualité est plus net encore, avec 63,4 % de réponses sans hallucination sur AA-Omniscience, contre 71,4 % pour Qwen. Mini est également derrière sur ComplexConstraints (33,4 %) et MultiChallenge (50,0 %).
En local, les performances dépendent de bien plus que du modèle
La fiche officielle d’Ollama et la fiche du modèle recommandent un Mac de 32 Go ou un DGX Spark. Mais la prise en charge encore récente des modèles bouclés rend les performances très variables. Le débit hébergé de 280 tok/s mesuré par Artificial Analysis prédit mal ce qu’un portable peut réellement obtenir.
| Configuration | Vitesse rapportée | Source |
|---|---|---|
| Évaluation hébergée (Artificial Analysis) | 280 tok/s | Mesure tierce |
| RTX 4090, vLLM corrigé + FP8/NVFP4 + drafter | ~190-220 tok/s | Utilisateur de Reddit, uniquement après correctif (117 en référence) |
| MacBook Pro M5 Max | ~125 tok/s | @alexocheema |
| MacBook Pro M1 Max 64 Go, quantification 4 bits | ~20 tok/s | Utilisateur de Hacker News gregsadetsky, via le test de lancement d’eesel |
| Premières versions de llama.cpp, matériel varié | ~5-10 tok/s | Discussion r/LocalLLM |
« Impossible de dépasser 5 t/s. » — u/KURD_1_STAN, discussion comparative sur r/LocalLLM
Le moteur d’exécution et la quantification expliquent une bonne partie de cette dispersion. Les versions actuelles gèrent mieux les couches bouclées que les premières versions, tandis que le choix de la quantification modifie l’empreinte mémoire : la version 4 bits recommandée occupe environ 17,6 Go, auxquels s’ajoutent un projecteur de vision de 639 Mo, selon le guide d’Unsloth relayé par Crewmark. Les contextes longs augmentent ensuite la pression sur le cache KV.
Lors d’un test de rapprochement de paiements mené à latence égale, Qwen a atteint 98,2 % de précision sans aucun faux rapprochement, contre 96,9 % et cinq faux rapprochements pour Mini :
« Nous avons testé Inkling 2 Mini face à Qwen3.8-27B sur notre véritable charge de rapprochement de paiements... Qwen : 98,2 % de précision, 0 faux rapprochement... Inkling : 96,9 %, 5 faux rapprochements... Pour cette tâche, Qwen reste le meilleur choix. » — @exebat3 (publication)
À retenir : commencez avec un contexte de 32K, réduisez-le si la mémoire vient à manquer et vérifiez que votre moteur prend bien en charge les couches bouclées avant de juger la qualité du modèle.
Un tarif affiché, mais aucun bouton pour acheter
Les tarifs Tinker indiqués sur la page du modèle Artificial Analysis sont de 0,15 $ par million de tokens en entrée, 0,015 $ pour les tokens mis en cache et 0,50 $ en sortie. Le fine-tuning coûte 0,75 $ en 64K et 1,50 $ en 256K. Appliqués à la consommation mesurée, ces tarifs donnent 0,59 $ par tâche d’indexation, contre 3,53 $ pour Qwen3.8-27B.
Ces 0,59 $ correspondent à une estimation, pas à un tarif hébergé que l’on peut réellement acheter. Au moment de ce test, Mini n’apparaît dans aucune offre d’inférence serverless ; le test d’eesel le confirme après vérification auprès de Tinker et OpenRouter. Mini a aussi généré 161M de tokens de sortie lors de l’évaluation d’index, contre une médiane de 85,7M. La facture par token est donc moins avantageuse qu’elle n’en a l’air. En auto-hébergement, comparez plutôt le coût du matériel, de l’électricité et de la mise en place avec celui d’un Qwen hébergé ou d’une API de modèle de pointe.
Deux réglages qui font toute la différence
L’intensité du raisonnement va de none (0.0) à minimal (0.1), low (0.2), medium (0.7), high (0.9, valeur par défaut), puis xhigh/max (0.99). Le niveau minimum ne désactive pas complètement le raisonnement, précise la fiche du modèle.
Réduire ce niveau peut s’avérer payant. Dans la discussion Terminal-Bench sur r/LocalLLM, un utilisateur a réussi 10 tâches sur 13 avec un niveau low, tandis que le niveau medium expirait régulièrement. Par ailleurs, un testeur de Hacker News cité dans l’article d’eesel a consommé 19 200 tokens de réflexion sans outil et n’a pas terminé sa tâche. Avec la recherche activée, il a obtenu une solution, mais avec un mauvais nom de hook.
Limitez le nombre de tokens générés et de tours de l’agent, isolez l’accès au système de fichiers et imposez une validation humaine avant toute utilisation en production. La fiche du modèle met en garde contre les actions destructrices effectuées sans confirmation et les boucles de raisonnement dont le modèle ne sort plus, notamment pendant le débogage.
Le compromis à accepter avant le téléchargement
Mini augmente la puissance de calcul sans grossir son checkpoint en réutilisant ses couches centrales. Le laboratoire fournit aussi un checkpoint de recherche à nombre de boucles variable pour étudier ce comportement (guide). Les problèmes rencontrés sont très concrets : boucles pendant le débogage, passage signalé par un utilisateur au japonais en pleine réponse et appels d’outils qui doivent être étroitement encadrés. Téléchargez-le pour coder hors ligne avec des garde-fous ; attendez encore si vous recherchez un chat soigneux ou une API utilisable en un clic.
FAQ
Inkling 2 Mini peut-il fonctionner sur un ordinateur portable ?
Oui, à condition d’utiliser une version adaptée : un Mac Apple Silicon de 32 Go ou plus via Ollama ou une version récente de llama.cpp, idéalement en 4 bits (~17,6 Go auxquels s’ajoute le projecteur). Comptez environ 20 tok/s sur un ancien M1 Max et plus de 100 tok/s sur du matériel M5 ; avec un moteur non corrigé, les performances peuvent tomber à quelques unités par seconde (voir le tableau ci-dessus).
Inkling 2 Mini est-il meilleur que Qwen3.8-27B ?
Pour les agents de code, oui ; pour le chat, non. Comme le montre le graphique ci-dessus, Mini domine sur DeepSWE, SWE-Bench Verified, BrowseComp et MCP Atlas. Qwen prend l’avantage sur Terminal-Bench v2.1, MMMU Pro, la factualité et le respect des consignes complexes. Tous les chiffres sont communiqués par les éditeurs via la fiche du modèle.
Pourquoi les sources parlent-elles à la fois de 3,4 Md et de 5,4 Md de paramètres actifs ?
Les 3,4 Md désignent les paramètres actifs stockés ; les 5,4 Md ajoutent trois passages dans les boucles, d’environ 1,0 Md chacun. Utilisez 5,4 Md pour estimer le calcul et 3,4 Md pour la mémoire.
Puis-je appeler Inkling 2 Mini via une API hébergée aujourd’hui ?
Non : aucun endpoint serverless propriétaire n’était disponible au moment du test. Tinker affiche des tarifs d’échantillonnage et de fine-tuning, mais aucune offre serverless pour Mini, selon la vérification d’eesel. Faites tourner les poids Hugging Face en local ou attendez que les services hébergés le prennent en charge.
Comment éviter les boucles de raisonnement ?
Commencez avec le niveau low (0.2), limitez les tokens générés et les tours de l’agent, puis isolez les outils, conformément aux recommandations de la fiche du modèle.
À lire aussi : notre test d’Inkling 2 Small et ses tarifs API, pour découvrir le modèle frère de 594B auquel Mini répond ; les meilleurs LLM pour les agents de code en 2026, afin de situer Mini face aux autres options ; et notre guide de llama.cpp v1.0, le moteur dont Mini dépend en local.