 AIREITER
Un agent de code capable de lire des fichiers, d’exécuter des tests et de corriger sa copie consomme facilement 50 000 à 200 000 tokens pour résoudre un seul problème. Avec GPT-5.6 Sol, facturé 30 $/M tokens en sortie, cela représente déjà 1,50 à 6 $ rien qu’en tokens générés. DeepSeek V4 Pro affiche un tarif de 0,87 $/M en sortie — environ 34 fois moins cher — mais sa fiabilité sur les workflows en plusieurs étapes n’a pas encore été évaluée de façon indépendante avec le même niveau de profondeur que Claude ou GPT. Voici comment six modèles se comparent sur les benchmarks de code publiés, les tarifs API vérifiés, la taille de contexte et les usages agentiques auxquels ils se prêtent le mieux.
Les six modèles à retenir pour les agents de code en 2026
Chaque fiche s’appuie sur des chiffres issus de sources officielles ou de classements reconnus, ainsi que sur des tarifs API vérifiés en août 2026. Lorsqu’aucun score n’est disponible pour le modèle exact, nous citons la variante la plus proche en la présentant clairement comme une référence indicative.
1. Claude Opus 5 — Le meilleur choix quand la qualité prime
Claude Opus 5 conserve l’avance de la famille Claude dans le classement officiel SWE-bench Verified. Son prédécesseur, Claude 4.5 Opus, a obtenu 76,8 % avec le harness mini-SWE-agent : un indicateur utile du niveau attendu pour Opus 5, même si son score SWE-bench Verified spécifique n’a pas encore été publié. Opus 5 dispose d’un contexte de 1 million de tokens et peut générer jusqu’à 128 000 tokens. À 5 $/M en entrée et 25 $/M en sortie, c’est l’option généraliste la plus chère de cette sélection. Pour une refonte complexe touchant plusieurs fichiers, où un échec coûte davantage en temps humain qu’en tokens, c’est le modèle à privilégier. Pour les modifications répétitives à grande échelle, en revanche, son prix est difficile à justifier.
2. GPT-5.6 Sol — Le spécialiste des tâches dans le terminal
GPT-5.6 Sol (identifiant modèle gpt-5.6-sol) est facturé 5 $/M tokens en entrée et 30 $/M en sortie, avec une fenêtre de contexte de 1,05 million de tokens. Dans la comparaison de benchmarks publiée par xAI, GPT-5.6 Sol Max domine Terminal-Bench v3.0 avec 34,6 % (contre 26 % pour Grok 4.6), ainsi que DeepSWE v1.1 avec 73 %. Ce sont les tests les plus parlants pour les agents qui pilotent directement un terminal. Le revers de la médaille est son tarif : à 30 $/M en sortie, Sol est le modèle le plus cher de cette liste. OpenAI annonce également 64,6 % pour Sol et 63,4 % pour Terra, sa variante intermédiaire, sur SWE-bench Pro. Une donnée intéressante si vous cherchez une option OpenAI moins coûteuse pour les tâches moins exigeantes.
3. Grok 4.6 — Le compromis idéal pour les agents qui tournent longtemps
Grok 4.6, lancé le 12 août 2026, vise les workflows agentiques de longue durée. D’après l’annonce de xAI, il égale GPT-5.6 Sol Max sur l’Artificial Analysis Intelligence Index, avec un score de 61, et le devance sur CursorBench v3.2 (69,9 % contre 67,2 %), FrontierCode v1.1 (61,3 % contre 60,6 %) et APEX-Agents (57,5 % contre 56,7 %). Facturé 2 $/M en entrée et 6 $/M en sortie, il offre des performances comparables à celles de GPT-5.6 Sol Max pour environ un cinquième du coût en sortie. Son point faible reste l’exécution brute dans le terminal : il obtient 26 % à Terminal-Bench v3.0, loin derrière les 34,6 % de Sol Max. Si votre agent travaille surtout dans un IDE — Cursor ou Grok Build — plutôt que depuis le terminal, Grok 4.6 offre le meilleur rapport qualité-prix de cette sélection. Une variante « fast » double les tarifs, à 4 $/M en entrée et 12 $/M en sortie, en échange d’une latence réduite. Sa fenêtre de contexte est de 500 000 tokens.
4. DeepSeek V4 Pro — Le modèle économique qui fait le travail
DeepSeek V4 Pro est le modèle de niveau frontier le moins cher accessible par API : 0,435 $/M tokens en entrée et 0,87 $/M en sortie, tandis que les tokens d’entrée mis en cache ne coûtent plus que 0,003625 $/M. Avec un contexte de 1 million de tokens et une sortie maximale de 384 000 tokens, il peut traiter des tâches à l’échelle d’un dépôt complet. Aucun benchmark publié n’évalue encore DeepSeek V4 Pro face à Claude ou GPT dans un environnement agentique multi-étapes aussi exigeant. Avant de lui confier une refactorisation complexe, mieux vaut donc tester la fiabilité de ses appels d’outils dans votre propre configuration. Pour les équipes contraintes par leur budget, ou comme modèle de première passe dans un système de routage, son économie est très convaincante. Pour les refontes multi-fichiers les plus délicates, où la fiabilité compte davantage que le prix des tokens, prévoyez une escalade vers un modèle plus robuste.
5. Gemini 3.1 Pro — Le lecteur de dépôts à très grand contexte
La version Preview de Gemini 3.1 Pro est facturée 2 $/M tokens en entrée et 12 $/M en sortie pour les requêtes de moins de 200 000 tokens, puis 4 $/M et 18 $/M au-delà de ce seuil. Son principal atout est sa capacité de contexte : avec 2 millions de tokens, Gemini possède la plus grande fenêtre de cette sélection. Il peut ainsi parcourir un dépôt entier en une seule passe, lorsque la taille du code le permet. À titre indicatif, Gemini 3 Flash a obtenu 75,8 % à SWE-bench Verified dans un instantané publié en juin 2026 par Tembo, juste derrière Claude 4.5 Opus. La régularité des appels d’outils de Gemini dans les longues boucles agentiques n’a toutefois pas été évaluée avec le même niveau de profondeur que Claude ou GPT. Testez-le dans votre harness avant de le déployer sur des workflows en plusieurs étapes.
6. Kimi K3 — L’option open weight pour les agents locaux
Kimi K3, développé par Moonshot AI, a obtenu 70,8 % à SWE-bench Verified dans le même instantané de juin 2026. Il reste derrière GLM-5 (72,8 %) et MiniMax M2.5 (75,8 %) parmi les modèles open weight. Son avantage est de pouvoir être auto-hébergé par les équipes qui ne peuvent pas laisser leur code sortir de leur réseau. Moonshot propose également K3 via une API hébergée, mais le tarif exact dépend de la configuration de déploiement. Avec suffisamment de GPU, K3 associé à un harness léger comme OpenCode permet de mettre en place un agent de code compétent sans coût API par token.
Tarifs API et coût réel d’une tâche terminée
Le prix par token ne raconte qu’une partie de l’histoire. Le chiffre qui compte vraiment est le coût d’une tâche terminée : combien faut-il dépenser pour résoudre un véritable ticket GitHub avec une boucle agentique ?
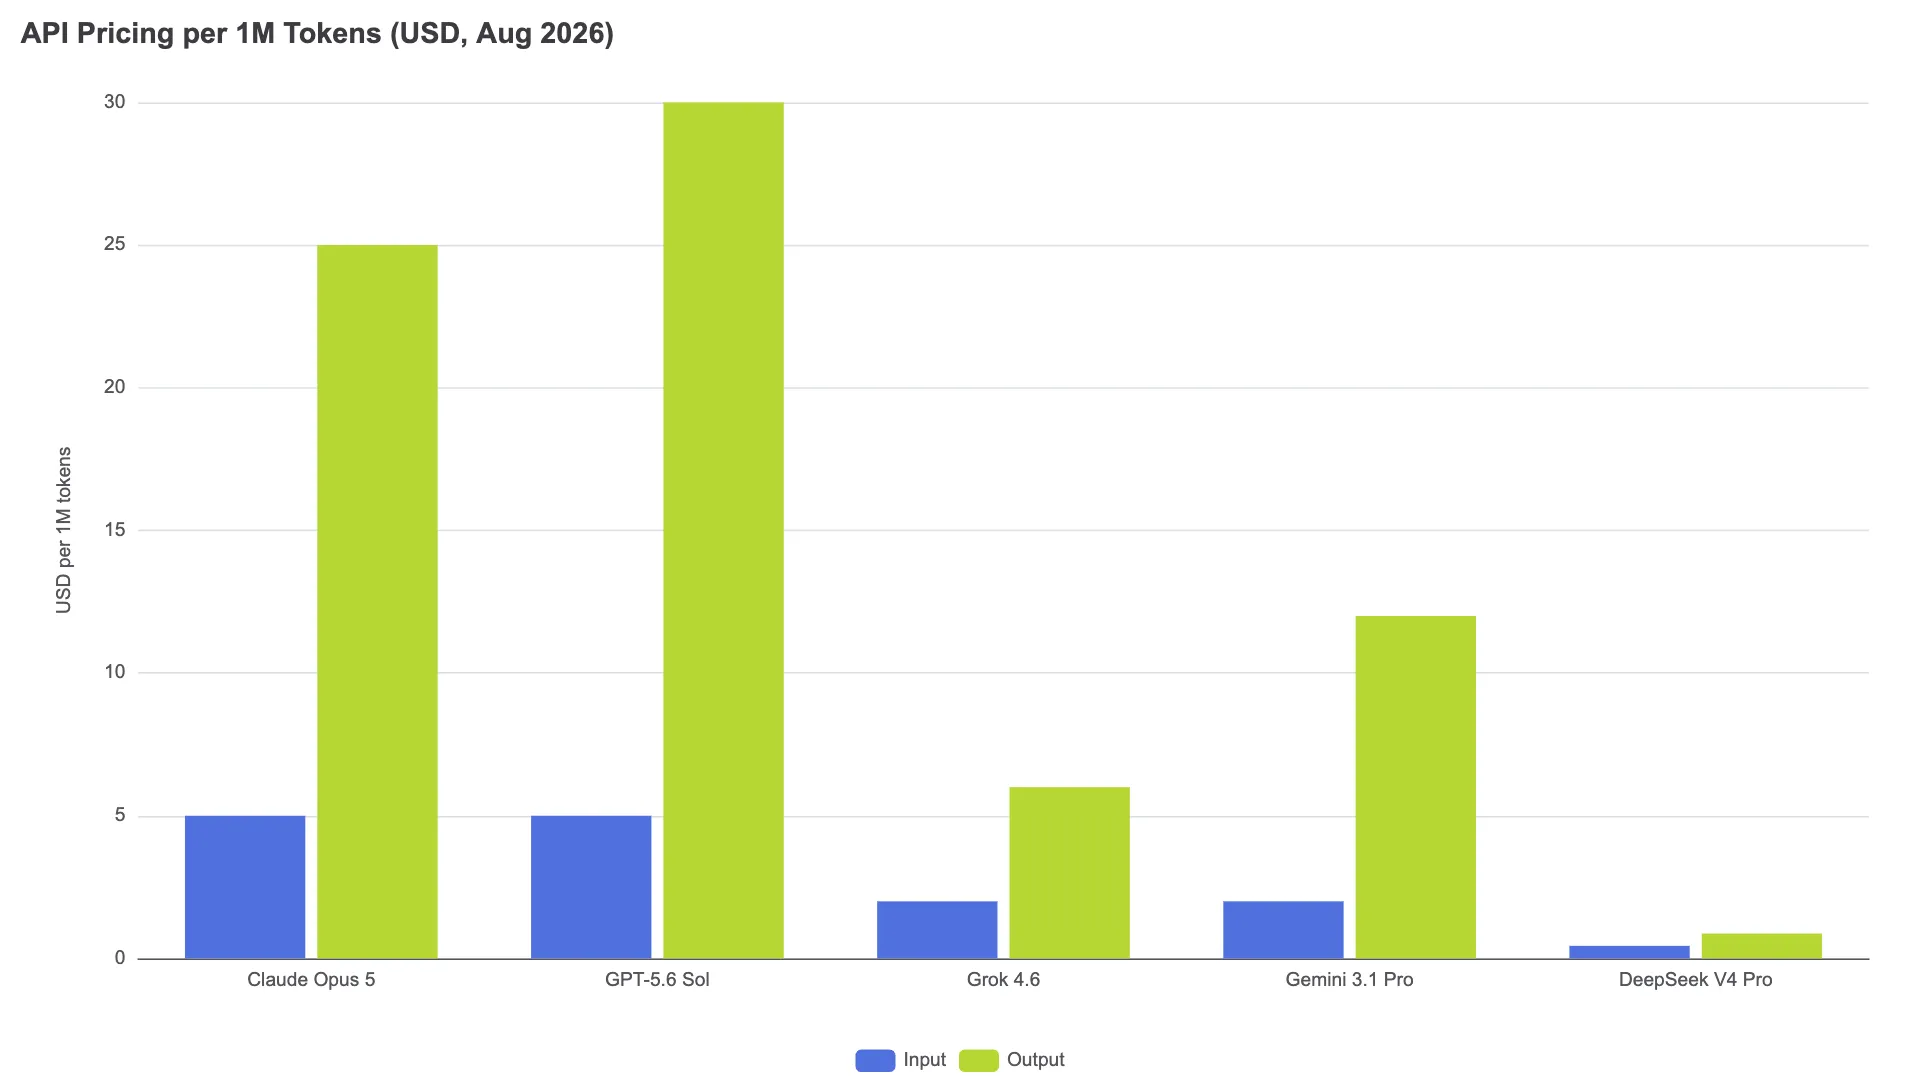
Une boucle classique — lecture des fichiers, planification, modification, exécution des tests et correction des échecs — consomme environ 50 000 à 200 000 tokens par problème résolu, dont 30 à 50 % en sortie. Ces chiffres sont des estimations du secteur, tirées notamment des analyses de boucles agentiques de Tembo et d’autres acteurs. Votre consommation réelle dépendra de la taille du dépôt, de la durée de la suite de tests et de l’efficacité du harness. En prenant le point médian de 125 000 tokens au total (75 000 en entrée et 50 000 en sortie), voici le coût d’un problème résolu avec chaque modèle :
| Modèle | Coût d’entrée | Coût de sortie | Total par tâche |
|---|---|---|---|
| Claude Opus 5 | 0,375 $ | 1,25 $ | 1,63 $ |
| GPT-5.6 Sol | 0,375 $ | 1,50 $ | 1,88 $ |
| Grok 4.6 | 0,15 $ | 0,30 $ | 0,45 $ |
| Gemini 3.1 Pro | 0,15 $ | 0,60 $ | 0,75 $ |
| DeepSeek V4 Pro | 0,033 $ | 0,044 $ | 0,077 $ |
Kimi K3 ne figure pas dans ce tableau, car son coût dépend entièrement du choix entre l’API hébergée de Moonshot et l’auto-hébergement sur vos propres GPU. Il n’existe donc pas de tarif catalogue unique à comparer. Grok 4.6 se situe dans une zone particulièrement intéressante à 0,45 $ la tâche : il égale le score de GPT-5.6 Sol Max sur l’Artificial Analysis Intelligence Index pour environ un quart du coût par tâche de Sol.
Ces estimations ne tiennent pas compte des nouvelles tentatives, des remises liées aux tokens mis en cache, des appels d’outils ni de l’infrastructure. En pratique, un modèle qui nécessite davantage de retries ou de corrections humaines peut revenir plus cher que ne le laisse penser son tarif par token. C’est pourquoi le routage — confier les tâches courantes à DeepSeek ou Grok et réserver les refontes difficiles à Opus — peut être plus efficace que de s’en remettre à un seul modèle.
Quel modèle choisir selon votre workflow d’agent de code ?
Il n’existe pas de modèle universel. Voici lequel associer à chaque type de tâche.
Boucles rapides et modifications courantes. Pour les tâches fréquentes et peu risquées — explication d’erreurs, petits ajouts de fonctions, squelettes de tests ou mises à jour de documentation — misez sur Gemini 3.5 Flash (1,50 $/9 $ par million de tokens) ou Claude Sonnet 5.
Refactorisation profonde et architecture. Claude Opus 5 est le choix le plus sûr pour les changements multi-fichiers, les dépendances entre modules et les décisions d’architecture où une mauvaise interprétation peut coûter des heures de débogage. Sa précision dans le suivi des instructions et sa capacité à conserver une vision cohérente sur de longues sessions font la différence.
Agents autonomes de longue durée. Grok 4.6 a été conçu pour ce scénario. Selon l’annonce de xAI, son développement s’est concentré sur des trajectoires agentiques prolongées et des mécanismes d’auto-vérification. À 0,45 $ la tâche, il est possible de le laisser travailler plus longtemps sans subir la pression tarifaire imposée par GPT-5.6 Sol et ses 1,88 $ par tâche. Pour les workflows très orientés terminal, l’avance de GPT-5.6 Sol à Terminal-Bench (34,6 %) en fait toutefois le choix le plus prudent.
Budget limité et auto-hébergement. Via API, DeepSeek V4 Pro est le choix par défaut des équipes attentives aux coûts, avec environ 0,077 $ par tâche. Pour les organisations qui ne peuvent pas envoyer leur code vers des API externes, il est possible d’auto-héberger un modèle open weight comme Kimi K3 (70,8 % à SWE-bench Verified) ou MiniMax M2.5 (75,8 %). Sur SWE-bench Verified, les modèles open weight ont réduit l’écart avec les modèles propriétaires à quelques points seulement.
Le problème du harness : votre outil peut limiter le modèle
Le harness utilisé par votre agent — Claude Code, Codex CLI, Cursor ou un outil open source comme OpenCode — contrôle quatre éléments que le modèle ne maîtrise pas directement : la gestion du contexte (ce qu’il faut compacter et conserver), la définition et le routage des outils, les mécanismes de récupération après erreur et les étapes de revue ou d’approbation. Comme le souligne l’analyse de Tembo, le score obtenu par un modèle avec un harness contrôlé comme mini-SWE-agent ne reflète pas forcément son taux de résolution dans un environnement configuré différemment. Pour comparer les modèles, les benchmarks qui gardent le harness constant sont donc plus instructifs que les scores publiés par les fournisseurs, qui mélangent souvent les progrès du modèle et ceux du harness.
Avant de changer de modèle, commencez par auditer votre harness. Vérifiez qu’il compacte correctement le contexte, que les définitions d’outils sont propres et que la récupération après erreur relance les opérations de façon pertinente au lieu de tourner en boucle.
FAQ
Quel est le LLM le moins cher pour les agents de code ?
DeepSeek V4 Pro, facturé 0,435 $/M tokens en entrée et 0,87 $/M en sortie, est l’option de niveau frontier la moins chère. Le coût d’une tâche agentique résolue tourne autour de 0,08 $.
Comment tester les modèles d’agents de code sur mon propre dépôt ?
Sélectionnez 20 à 30 problèmes représentatifs dans votre backlog réel, en mélangeant corrections de bugs, fonctionnalités et refactorisations. Faites traiter les mêmes tâches à chaque modèle avec le harness de votre choix. Suivez trois indicateurs : le taux de résolution (le patch de l’agent passe-t-il vos tests ?), la consommation de tokens par tâche et le temps nécessaire pour la terminer. Cette évaluation sur votre propre dépôt sera plus prédictive que n’importe quel benchmark public.