 AIREITER
À 0,04 $ par million de tokens en entrée, l’API hébergée reste l’option la plus simple. Mais les nouveaux checkpoints à poids ouverts rendent l’inférence locale réaliste, à condition d’accepter un écart de qualité net entre les modèles 3B et 600M.
Trois versions de Liquid d1, trois usages distincts
Liquid AI propose désormais trois options pertinentes : le service propriétaire hébergé d1, le modèle à poids ouverts d1-3B et l’expérimental d1-omni-600M, également à poids ouverts. Liquid AI n’a pas indiqué que son modèle hébergé était identique à l’un ou l’autre des checkpoints téléchargeables : les chiffres de benchmark et de latence doivent donc toujours être rattachés au modèle qui les a produits.
| Option | Accès et tarif | Entrées | Contexte publié | Usage recommandé |
|---|---|---|---|---|
d1 hébergé | Liquid API ; 0,04 $ par million de tokens en entrée, sans facturation des tokens de sortie | Texte et images directement via Liquid | 66K affichés par Vercel | Intégration rapide, coût d’inférence négligeable, aucune exploitation de modèle |
d1-3B | Poids téléchargeables ; aucun coût par token pour le modèle | Texte, JSON et images | 32 768 tokens | Meilleure qualité locale, vision, évaluation en production |
d1-omni-600M | Poids expérimentaux téléchargeables ; aucun coût par token pour le modèle | Texte avec image, ou texte avec audio | 16 384 tokens | Faible empreinte, expérimentations de commandes vocales, appareils edge contraints |
Ces trois modèles répondent à des questions typées, pas à des demandes de rédaction. noul renvoie une probabilité de oui, choice des probabilités sur des options nommées, et score une position pondérée par les probabilités sur une grille ordonnée. Ils sont adaptés au routage, à la modération, à l’inspection, aux garde-fous et au scoring ; ils ne remplacent ni un modèle conversationnel ni un modèle de code.
La recommandation est simple : utilisez d1 hébergé pour un pilote, optez pour d1-3B si les données doivent rester en local ou si la latence doit éviter un saut réseau, et considérez d1-omni-600M comme un modèle expérimental, sauf si l’audio ou l’empreinte réduite est la contrainte décisive.
Tarif API ou coût du déploiement local
L’API Liquid AI d1 coûte 0,04 $ par million de tokens en entrée. Il n’y a pas de coût sur les tokens de sortie, puisque le service renvoie des décisions plutôt que du texte généré. Une charge de 100 millions de tokens en entrée revient à 4 $ avant d’éventuels frais de passerelle ; un milliard de tokens en entrée coûte 40 $.
À 0,04 $/M de tokens, l’auto-hébergement est rarement rentable sur le seul coût d’inférence. Le déploiement local se justifie plutôt par la confidentialité, le fonctionnement hors ligne, la latence sur l’appareil, la personnalisation ou une utilisation soutenue.
Les deux checkpoints ouverts n’ont pas de tarif officiel hébergé au token. Leurs pages Hugging Face n’affichaient aucun fournisseur d’inférence au moment du test : le prix de d1 hébergé ne doit donc pas être présenté comme celui de d1-3B ou de d1-omni-600M.
Le service hébergé facture aussi les images comme des entrées. Liquid AI indique 1,5 token par bloc de 32×32 pixels : une image de 1024×1024 représente donc 1 536 tokens avant le texte de la question. À 0,04 $/M, la partie image coûte environ 0,00006144 $ ; chaque question est facturée comme un prompt distinct, image associée comprise.
Des poids ouverts ne signifient ni usage sans restriction ni coût nul
Les deux dépôts utilisent la licence lfm1.0 de Liquid AI, et non Apache 2.0 ou MIT. Les conditions tarifaires générales de Liquid AI indiquent que ses modèles téléchargeables sont gratuits pour un usage commercial sous 10 millions de dollars de chiffre d’affaires annuel. Les organisations plus importantes doivent vérifier les conditions commerciales en vigueur plutôt que de déduire une autorisation de l’expression « open-weight ».
Le budget local doit inclure l’achat de GPU ou d’appareils, la capacité inutilisée, la supervision, les mises à jour et le temps des équipes. La facture hébergée est variable et minime ; le coût local est principalement fixe.
d1-3B privilégie la qualité, omni réduit l’empreinte
L’annonce Open d1 officielle rapporte un score Decision Index v0.2.1 de 48,57 pour d1-3B, contre 15,95 pour d1-omni-600M. Liquid AI a exécuté le scoreur officiel pour les deux, mais ces résultats ne constituent pas des soumissions officielles au leaderboard.
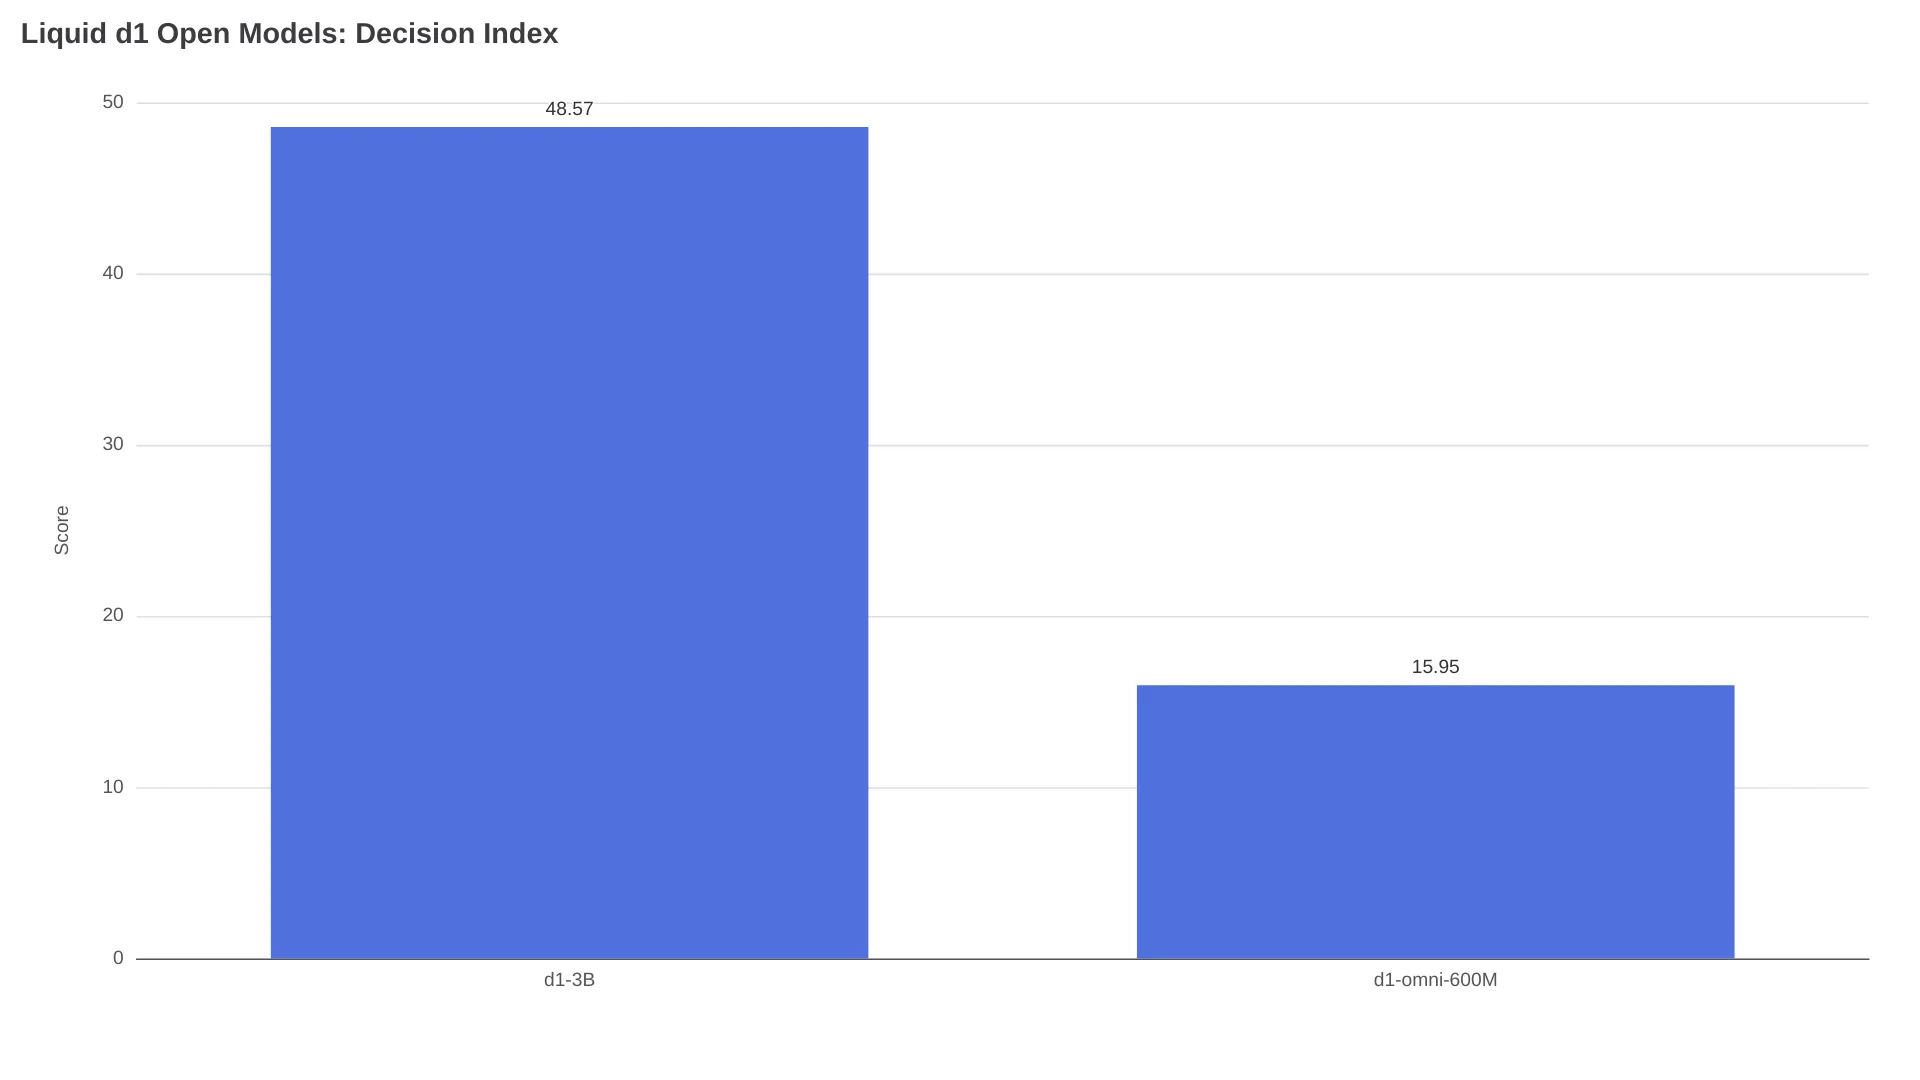
Le plus petit modèle n’est pas mauvais partout. Sur sept benchmarks textuels publics, Liquid AI rapporte des moyennes de 82,9 pour d1-3B et 78,4 pour d1-omni-600M. Omni est devant sur Civil Comments (95,8 contre 93,0) et PAWS-X (79,5 contre 76,9), tandis que 3B mène sur les cinq autres tâches listées. L’écart bien plus large au Decision Index montre que quelques bons résultats en classification ne font pas du checkpoint 600M un substitut général à 3B.
| Caractéristique | d1-3B | d1-omni-600M |
|---|---|---|
| Nombre détaillé de paramètres | 3,12B | 587M |
| Empreinte du dépôt et des poids en pleine précision | Dépôt de 6,27 Go ; poids de 6,25 Go | Modèle F32, environ 0,6B paramètres |
| Contexte | 32 768 | 16 384 partagés entre les modalités |
| Texte autorisé avec image | Dans le contexte du modèle | Texte d’état et de question limité à 896 tokens avec des images |
| Audio | Non | Un clip mono 16 kHz, jusqu’à 30 secondes |
| Image et audio simultanés | Sans objet | Non pris en charge ; déclenche ValueError |
| Tableau de vitesse officiel | Oui | Non ; publication de recherche précoce |
La fiche du modèle d1-omni-600M précise qu’il a été entraîné en float32. Le Float16 a conservé la meilleure réponse sur 243 lignes texte, 214 lignes image et 416 lignes audio, tandis que bfloat16 a changé la meilleure réponse sur 0,8 % des lignes texte et 1,7 % des lignes audio. Le dtype est donc une variable à valider, pas seulement un levier d’optimisation.
Le déploiement local s’installe vite, mais se valide longtemps
Les deux fiches de modèle exposent system_one pour un état unique et system_one_batch pour des requêtes regroupées. Le chemin le plus court pour d1-3B passe par Transformers 5.14 ou version ultérieure, PyTorch, TorchVision, Pillow et le code personnalisé fourni par le dépôt.
- Installez les dépendances documentées :
pip install "transformers>=5.14" torch torchvision pillow- Chargez le modèle en autorisant le code distant du dépôt :
import torch
from transformers import AutoModel

model_id = "LiquidAI/d1-3B"
device = "cuda" if torch.cuda.is_available() else "cpu"
dtype = torch.bfloat16 if device == "cuda" else torch.float32

model = AutoModel.from_pretrained(
    model_id,
    trust_remote_code=True,
    torch_dtype=dtype,
).to(device)- Envoyez des décisions nommées plutôt qu’un prompt de chat :
questions = {
    "queue": {
        "type": "choice",
        "instructions": "Which team should handle this ticket?",
        "criteria": {
            "billing": "Charges, invoices, and refunds",
            "technical": "Application or website faults",
            "fraud": "Suspected unauthorized use",
        },
    }
}

result = model.system_one(
    "I was charged twice this month; refund one charge.",
    questions,
)
print(result["answers"]["queue"])
trust_remote_code=True signifie que le Python du dépôt s’exécute dans le processus de service. Épinglez un commit examiné avant la mise en production, au lieu de charger une branche mouvante. Le dépôt d1-3B propose aussi des quantifications pour des runtimes compatibles avec llama.cpp, Ollama et LM Studio ; un artefact communautaire quantifié représente une décision distincte, en matière de chaîne d’approvisionnement et de précision, par rapport aux poids officiels BF16.
La fiche du modèle d1-3B indique des temps d’appel à chaud de 8 ms pour une question sur RTX 4090, de 30 ms sur Apple M5 Pro et de 50 ms sur Jetson Orin Nano. Un état de 3,4K tokens a pris respectivement 102 ms, 640 ms et 1 640 ms sur ces mêmes appareils. Les chiffres GPU sont des médianes sur 20 exécutions ; le résultat de 8 ms sur 4090 utilisait des graphes CUDA compilés, et une nouvelle forme d’entrée entraîne un surcoût de compilation ou de sélection de kernel.
Il n’existe pas de tableau de vitesse officiel pour d1-omni-600M. Un portage navigateur a rapporté environ 180 ms par commentaire pour quatre décisions :
« I didn't test it against other machines yet, just my MBP M4 Pro. » — u/FinancialAd1961 sur Reddit
Ce résultat sur un seul appareil démontre la faisabilité dans un navigateur, pas les performances selon les navigateurs, GPU, quantifications ou tailles de batch.
L’API est plus simple, mais l’identité du modèle reste essentielle
L’accès hébergé direct utilise le modèle d1 à l’adresse https://api.liquid.ai/decisions/v1/systemone. Vercel utilise liquid/d1 ; sa page annonce un contexte de 66K et le même tarif de 0,04 $/M en entrée. L’annonce de Liquid du 5 octobre indiquait que Vercel et OpenRouter ne géraient alors que le texte, tandis que l’API directe de Liquid acceptait les images.
Les checkpoints ouverts emploient des méthodes Python locales fondées sur les mêmes concepts de décision, mais la similarité des interfaces ne prouve pas une équivalence de comportement. Leurs probabilités peuvent varier suffisamment pour faire basculer un cas de part et d’autre d’un seuil d’automatisation. Enregistrez l’ID exact du modèle, sa révision, le dtype, la probabilité et le seuil pour chaque branche évaluée.
Une migration devrait donc suivre quatre étapes :
- Constituez un jeu de données annoté issu de la distribution réelle en production, y compris les cas ambigus et les erreurs coûteuses.
- Exécutez les mêmes états, le même schéma de questions et les mêmes critères sur chaque candidat.
- Choisissez les seuils à partir des coûts de faux positifs et de faux négatifs, et non d’un score de benchmark global.
- Faites tourner le gagnant en shadow mode avant d’autoriser des actions destructrices, financières, de contrôle d’accès ou liées à la sécurité.
Quel Liquid d1 choisir ?
L’API hébergée est le choix par défaut pour la plupart des équipes. Son prix au token est trop faible pour qu’un petit pilote justifie un projet de service local, et elle évite de gérer les pilotes, la quantification, le warm-up et la capacité.
| Besoin | Choix | Pourquoi |
|---|---|---|
| Chemin le plus rapide vers la production | d1 hébergé | Endpoint managé et tarification explicite des entrées |
| Les données ne doivent pas quitter l’appareil ou le réseau | d1-3B | Le checkpoint ouvert le plus performant et une exécution locale |
| Meilleure qualité de décision publiée parmi les modèles ouverts | d1-3B | Decision Index de 48,57 contre 15,95 |
| Classification de commandes audio | d1-omni-600M | Seule option ici compatible avec l’audio, limité à 30 secondes |
| Plus petite empreinte expérimentale | d1-omni-600M | 587M paramètres, mais aucun tableau de latence officiel |
| Explications ouvertes ou actions générées | Aucun | Ajoutez un modèle génératif après l’étape de décision |
Préférez d1-3B à omni, sauf si l’empreinte 600M ou le parcours audio est indispensable. Une réduction par cinq du nombre de paramètres est séduisante, mais elle n’efface ni l’écart de 32,62 points au Decision Index ni le statut expérimental d’omni.
FAQ sur Liquid AI d1
Liquid AI d1 est-il gratuit ?
Le service d1 hébergé coûte 0,04 $ par million de tokens en entrée, sans frais sur les tokens de sortie. Les checkpoints ouverts sont téléchargeables sans coût par token, mais les conditions commerciales LFM 1.0 et les coûts de calcul local s’appliquent toujours.
d1-3B et d1-omni-600M sont-ils le modèle de l’API d1 hébergée ?
Liquid AI n’a documenté aucun de ces checkpoints comme étant identique au d1 hébergé. Considérez-les comme des produits liés, mais distincts, avec leurs propres ID de modèle, contextes, benchmarks et modes de déploiement.
Peut-on exécuter Liquid d1 avec Ollama ?
La page de d1-3B renvoie vers des quantifications destinées à llama.cpp, Ollama, LM Studio et aux applications compatibles. Vérifiez le quantificateur, la révision source, la prise en charge de l’API de décision et la précision avant de remplacer le chemin officiel via Transformers.
d1-3B prend-il en charge l’audio ?
Non. d1-3B accepte le texte, le JSON et les images. d1-omni-600M accepte du texte avec des images ou du texte avec un clip audio de 30 secondes maximum, mais ne peut pas recevoir image et audio dans la même requête.
De combien de VRAM d1 local a-t-il besoin ?
Liquid publie un fichier de poids BF16 de 6,25 Go pour d1-3B, mais ne fournit pas une exigence universelle en VRAM. Les surcoûts d’exécution, l’état de l’encodeur d’images, la longueur de contexte, la taille de batch, la précision et la quantification font tous varier le total ; mesurez la configuration visée au lieu d’assimiler la taille du fichier au pic de VRAM.
Quelle que soit l’option retenue, validez les seuils de probabilité sur des données de production annotées avant d’automatiser des décisions aux conséquences importantes.
À lire aussi : le test de l’API Liquid AI d1 hébergée détaille davantage l’endpoint direct, la facturation des images et le contrat de requêtes typées.