 AIREITER
Télécharger 17 Go ne suffit pas à obtenir un agent local agréable à utiliser. Qwen3.8-27B est un modèle open weight Apache-2.0 solide, mais son raisonnement extra-élevé activé par défaut peut transformer une tâche rapide en longue attente si la quantification, le budget de contexte et la pile de serving ne correspondent pas à votre machine.
Faut-il faire tourner Qwen3.8-27B en local ?
Qwen3.8-27B mérite d’être exécuté localement pour les développeurs disposant d’environ 24 Go de mémoire GPU ou unifiée, qui privilégient la gestion locale des données et acceptent une réactivité moindre qu’avec une API hébergée rapide. Son principal atout ne tient pas à un seul benchmark : c’est un modèle dense sous licence Apache-2.0, capable de traiter du texte, des images et des vidéos, avec un contexte natif de 262 144 tokens et un raisonnement configurable, dans un format déployable. La fiche modèle officielle de Qwen indique une sortie le 14 août 2026.
Il ne faut toutefois pas le considérer comme un remplaçant automatique de toutes les API. Les résultats officiels sont fournis par l’éditeur, les quantifications agressives modifient à la fois la qualité et la vitesse, et le raisonnement xhigh par défaut est rarement un bon point de départ pour des tâches locales interactives courantes.
Le matériel avant les benchmarks
Qwen3.8-27B est un modèle dense : chaque token généré mobilise donc l’intégralité du modèle. La bande passante mémoire, le cache KV, la quantification et la taille de contexte demandée deviennent alors déterminants, bien plus que ne le laisse penser la taille du seul fichier de poids. La fiche de Qwen annonce un contexte natif de 262K, mais une session locale peut être configurée bien en dessous afin de préserver mémoire et vitesse. Les exemples de serving de Qwen affichent un maximum de 262 144 tokens : c’est une limite de capacité, pas un réglage raisonnable par défaut sur toutes les machines grand public.
| Mémoire disponible | Point de départ réaliste | À quoi s’attendre | Recommandation |
|---|---|---|---|
| 12 Go | Quantification agressive de classe Q3 avec déport CPU/RAM | Contexte court et compromis importants sur la latence | Préférez un modèle plus petit, sauf si l’expérimentation locale est l’objectif |
| 16 Go | Q3 agressif ou quantification de type Q4 choisie avec soin | Utilisable pour des tâches courtes et supervisées ; contexte et vitesse restent limités | Testez avant d’adopter un workflow agentique |
| 24 Go | Quantification de classe Q4 | Le point d’entrée pratique pour le code, les outils et un contexte modéré | Le meilleur compromis pour la plupart des utilisateurs locaux de Qwen3.8-27B |
| 32 Go+ | Quantification de meilleure qualité ou davantage de marge pour le contexte | Moins de compromis autour du cache KV et des longues sessions | Préférez cette catégorie pour un travail agentique soutenu |
Ces recommandations concernent l’usage réel, pas des minimums annoncés par l’éditeur. Des utilisateurs indépendants rapportent qu’une RTX 3060 de 12 Go peut exécuter un build local et gérer les appels d’outils, tandis que d’autres jugent qu’un agent dense avec ce niveau de VRAM fonctionne mal ; ce désaccord illustre précisément pourquoi il ne faut pas confondre « peut se charger » et « fonctionne bien ». Voir les retours d’utilisateurs dans r/LLM.
Une carte de 24 Go constitue un plancher pour un workflow confortable en 4 bits, pas une garantie de confort sur de longs contextes. Une évaluation orientée déploiement estime la mémoire totale en 4 bits à 17-19 Go, tout en rappelant que le cache KV grossit rapidement lors des longues sessions agentiques. L’analyse de déploiement local de Neoteric est utile pour planifier, mais ne remplace pas une spécification matérielle officielle.
Pourquoi les réglages par défaut peuvent le rendre pénible
Qwen3.8-27B active le raisonnement par défaut. La fiche officielle propose notamment les valeurs xhigh, medium et low pour reasoning_effort, ainsi que enable_thinking=False pour les requêtes sans raisonnement ; preserve_thinking est lui aussi activé par défaut. La section des bonnes pratiques de Qwen précise qu’un effort de raisonnement moindre ne réduit pas toujours le temps total d’exécution, mais un niveau élevé reste un réglage coûteux pour les tâches triviales.
Le test local de Simon Willison rend l’écart très concret. Avec un build Q4_K_M dans LM Studio, il rapporte qu’une première tâche SVG a consommé 22 276 tokens de raisonnement et pris 21 minutes avec le réglage par défaut ; après désactivation du raisonnement, il a obtenu un résultat différent en 137 secondes. Sa configuration mesurée ne constitue pas un benchmark universel, mais elle met clairement en évidence le risque de configuration. Lire le test complet et les transcriptions.
« Je m’attendais à ce qu’il soit à peu près au niveau de 3.6 35b, mais plus lent à cause de la quantification lourde ; au final, il l’a surpassé partout. » u/AltruisticList6000, r/LocalLLaMA, à propos d’une expérimentation Q3 sur RTX 4060 Ti de 16 Go.
Ce résultat positif n’efface pas les compromis. Un autre retour d’utilisateur évoque un contexte limité à 32K et une session agentique devenue peu fiable, tandis qu’un autre recommande des instructions claires et atomiques pour le travail de programmation local. La discussion sur les workflows est ici.
Ce que Qwen3.8-27B propose officiellement
Qwen3.8-27B est un modèle dense nativement vision-langage, et non un modèle MoE. La fiche officielle mentionne des entrées texte, image et vidéo ; 64 couches ; une dimension cachée de 5 120 ; 262 144 tokens de contexte natif ; et une licence Apache-2.0. Elle documente également une extension YaRN jusqu’à 1M de tokens, en avertissant explicitement que YaRN statique peut dégrader les performances sur les textes courts. Les spécifications officielles et les indications sur le contexte priment sur les résumés de sortie tiers.
Le dépôt officiel cite Transformers, vLLM, SGLang, TokenSpeed, ainsi que des solutions locales quantifiées comme llama.cpp, Ollama et LM Studio. La compatibilité du runner est importante, car le modèle adopte une architecture hybride Gated DeltaNet et Gated Attention : mettez le runner à jour avant de conclure à une défaillance du modèle. Le dépôt quickstart de Qwen contient des exemples de serving compatibles OpenAI.
Ce que les benchmarks publiés prouvent, et ce qu’ils ne prouvent pas
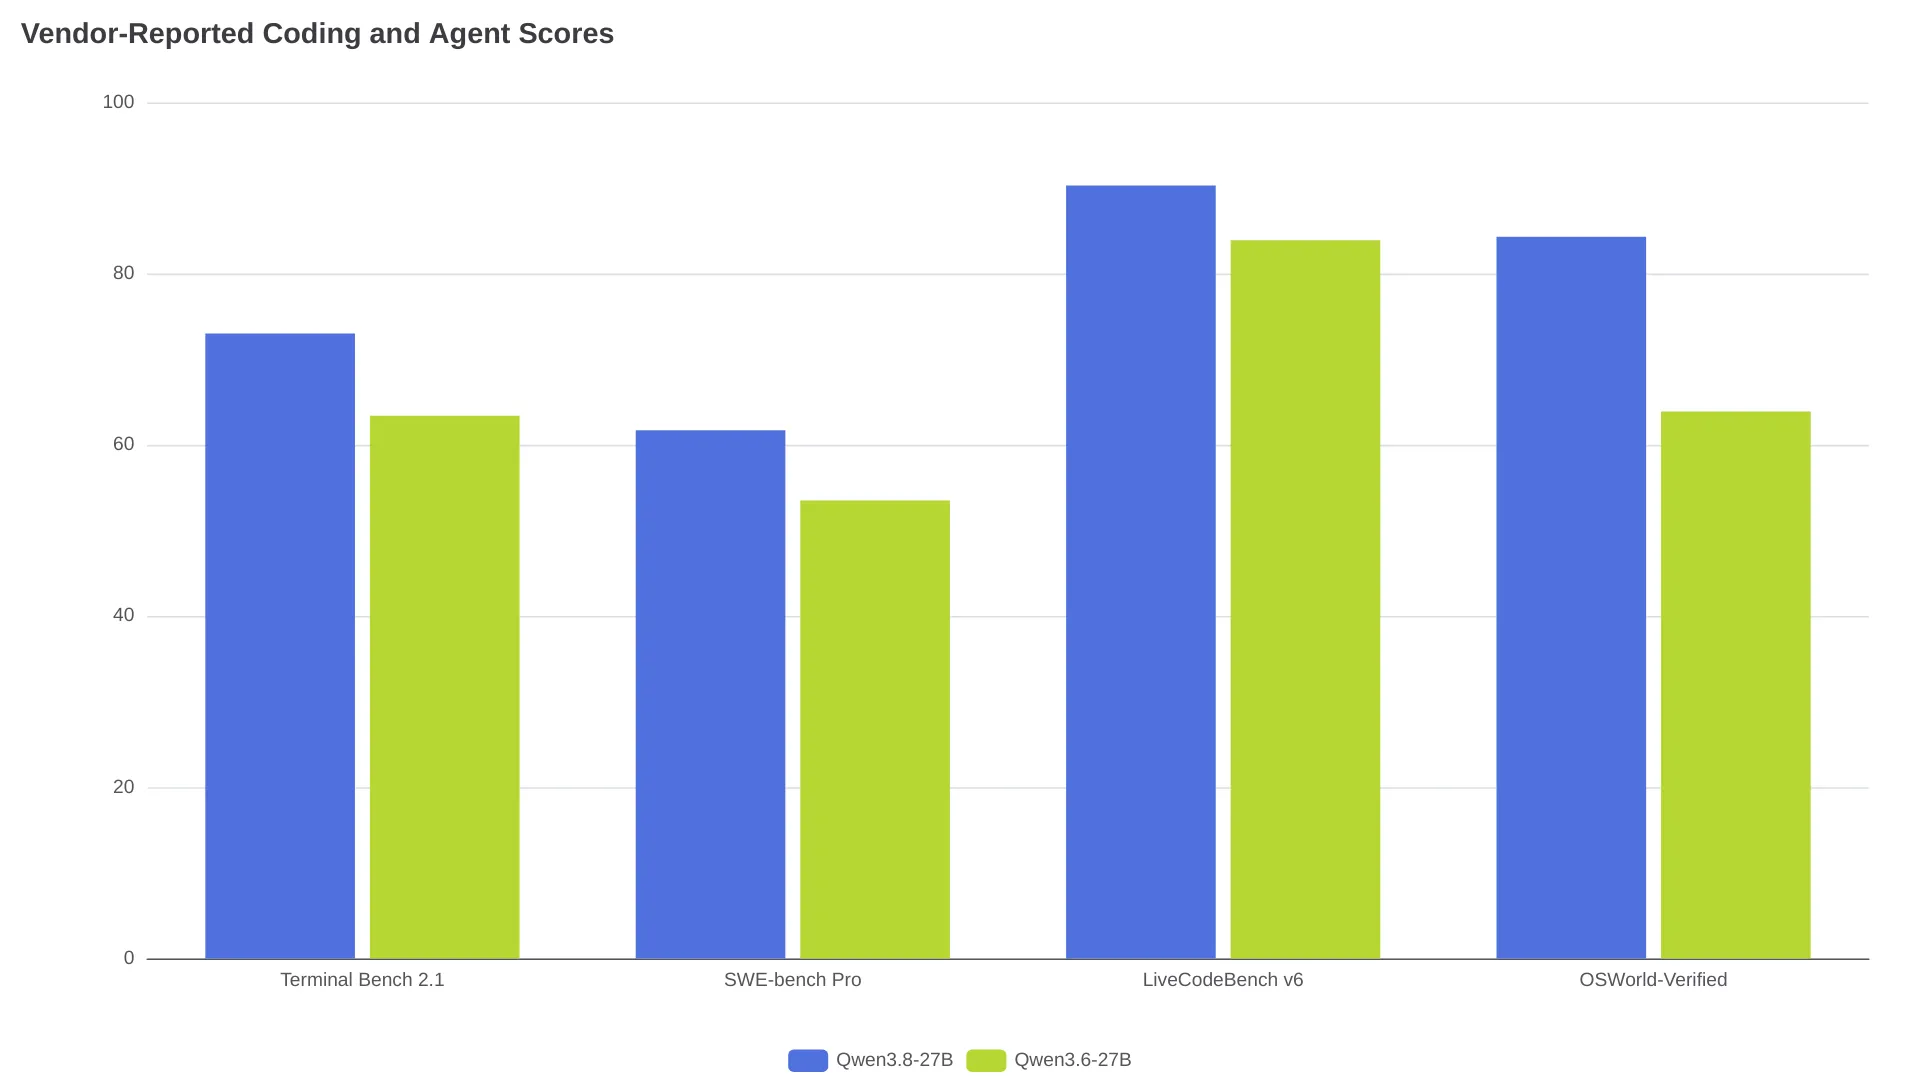
Qwen annonce des progrès notables face à Qwen3.6-27B dans les évaluations de code et d’utilisation d’ordinateur. Le graphique présente quatre scores fournis par l’éditeur depuis la fiche modèle officielle, et non des résultats reproduits indépendamment.
| Benchmark officiel | Qwen3.8-27B | Qwen3.6-27B | Comment l’interpréter |
|---|---|---|---|
| Terminal Bench 2.1 | 73.0 | 63.4 | Indicateur de code terminal agentique |
| SWE-bench Pro | 61.7 | 53.5 | Indicateur de résolution d’issues dans un dépôt |
| LiveCodeBench v6 | 90.3 | 83.9 | Indicateur d’évaluation en programmation |
| OSWorld-Verified | 84.3 | 63.9 | Indicateur d’utilisation d’ordinateur |
La fiche modèle publie la comparaison complète et sa méthodologie. Pour SWE-bench Pro et DeepSWE 1.1, Qwen indique avoir utilisé un harness Claude Code avec temperature=1.0, top_p=0.95 et un contexte de 256K ; elle inclut aussi des benchmarks internes tels que QwenSWEBench. Examinez la méthodologie avant de comparer les modèles. Ces chiffres étayent l’idée d’une « amélioration officielle substantielle par rapport à Qwen3.6-27B », pas celle d’un « remplaçant universel éprouvé pour une API de pointe ».
Une première installation locale raisonnable
Pour un premier déploiement local, mieux vaut privilégier un comportement prévisible qu’un raisonnement maximal. Utilisez un runner récent, commencez par une quantification de classe Q4 sur un matériel de classe 24 Go, fixez une limite de contexte volontairement modeste et testez de courtes tâches agentiques avant d’autoriser de longues boucles autonomes.
- Lancez un serveur compatible OpenAI avec un moteur pris en charge, tel que vLLM ou SGLang. Qwen publie des exemples utilisant
Qwen/Qwen3.8-27B,--reasoning-parser qwen3et--tool-call-parser qwen3_coder. Les commandes officielles figurent dans le dépôt. - Pour la classification courante, l’extraction ou des modifications de code rapides, réglez
enable_thinking=False. Qwen recommande, sans raisonnement, les valeurstemperature=0.7,top_p=0.80etpresence_penalty=1.5. Voir l’exemple d’API officiel. - Pour du débogage demandant beaucoup de raisonnement, essayez
lowoumediumavantxhigh, puis comparez le temps total de réponse et la qualité des appels d’outils sur une tâche réelle. - Désactivez la conservation du raisonnement lorsque les tâches sont indépendantes. Ne la préservez que si le contexte de raisonnement multi-tour justifie la pression supplémentaire sur le cache KV.
- Testez les appels d’outils, le respect du schéma de sortie et un renouvellement de contexte avant toute utilisation sans supervision. Un modèle capable d’écrire du bon code en une requête peut tout de même échouer dans une longue boucle agentique.
Quand Qwen3.8-27B n’est pas le bon choix local
Qwen3.8-27B n’est pas le premier choix à faire lorsqu’une limite stricte de 12 Go ou moins s’impose, lorsque la latence de réponse compte davantage que le contrôle local, ou lorsqu’un agent doit s’exécuter sans supervision avec un respect strict des formats. Il peut fonctionner sur des configurations contraintes, mais cela ne garantit ni un débit interactif fiable ni un contexte suffisant pour travailler sur un dépôt.
Des tests indépendants relèvent aussi une tendance aux sorties longues, une latence élevée en queue de distribution et un respect imparfait des instructions strictes. Une évaluation structurée a enregistré 4 timeouts sur 49 tests et un temps de réponse P95 de 143.32 secondes sur sa configuration de poste de travail. Ces chiffres ne sont pas des garanties de performance transposables, mais ils invitent à ne pas traiter un modèle local de 27B comme un composant d’automatisation sans relecture. Le rapport de test de CrucibleMark détaille la configuration et ses limites.
FAQ Qwen3.8-27B
Qwen3.8-27B est-il officiellement disponible ?
Oui. Le dépôt officiel de Qwen indique une sortie de Qwen3.8-27B sur Hugging Face Hub et ModelScope le 14 août 2026. La chronologie de sortie de Qwen est la source primaire.
Qwen3.8-27B peut-il tourner sur un GPU de 16 Go ?
Une configuration fortement quantifiée avec un contexte court peut fonctionner, mais il s’agit d’un déploiement contraint. Les retours d’utilisateurs vont de résultats Q3 prometteurs sur une RTX 4060 Ti de 16 Go à des avertissements sur les compromis majeurs de vitesse et de qualité pour un agent dense avec peu de VRAM. Discussion LocalLLaMA.
Qwen3.8-27B dispose-t-il d’une fenêtre de contexte de 1M de tokens ?
Son contexte natif est de 262 144 tokens. La fiche modèle décrit un contexte de 1M via une mise à l’échelle YaRN/RoPE et avertit que YaRN statique peut réduire les performances sur les textes courts. Documentation officielle sur le contexte.
Comment désactiver le raisonnement de Qwen3.8-27B ?
Définissez enable_thinking=False dans la requête API, comme illustré dans la fiche modèle de Qwen. Pour les tâches qui nécessitent du raisonnement, commencez par low ou medium plutôt que de supposer que xhigh convient. Exemple officiel sans raisonnement.
Les utilisateurs de Qwen3.6-27B devraient-ils effectuer la mise à niveau ?
Effectuez la mise à niveau si le matériel existant prend déjà en charge la même classe de déploiement et si votre charge de travail tire parti des améliorations en code, utilisation d’ordinateur ou multimodalité. Conservez Qwen3.6-27B si la pile actuelle est stable et que le nouveau runner, la quantification ou le comportement de raisonnement n’ont pas encore été validés sur le workflow réel.
Choisissez selon votre contrainte non négociable
| Contrainte | Meilleure prochaine étape |
|---|---|
| Gestion locale des données et 24 Go disponibles | Exécutez Qwen3.8-27B en Q4, avec un raisonnement faible ou désactivé au départ |
| 12 à 16 Go seulement | Testez un build de type Q3 pour des tâches courtes supervisées, ou choisissez un modèle plus petit |
| Longues sessions agentiques sur des dépôts | Prévoyez une marge de 32 Go+ et validez le comportement du cache KV avant adoption |
| Réponses interactives rapides | Utilisez une API hébergée ou un modèle local plus petit |
| Publication ou formatage strict sans supervision | Conservez une couche de validation et une revue humaine ; ne comptez pas sur le seul respect des consignes par le modèle |
Qwen3.8-27B élargit ce qu’un modèle 27B déployable localement peut tenter. Il ne supprime pas le travail d’intégration : choisissez la quantification adaptée au matériel, contrôlez délibérément le raisonnement et évaluez le modèle sur un workflow représentatif plutôt que sur la taille du téléchargement.