 AIREITER
Un utilisateur de Claude Code a recalculé le coût d’un mois de travail avec un forfait Max au tarif public de l’API : 7 470 $, contre une facture de 200 $. Le problème ne vient donc pas du prix unitaire des tokens. L’accès à l’usage retire simplement le plafond que l’abonnement imposait discrètement, tandis que les agents renvoient bien plus de contexte qu’un humain qui tape dans une interface de chat.
L’écart constaté par les développeurs
Les ratios publiés par les utilisateurs sont élevés et étonnamment cohérents. Une discussion sur r/ClaudeAI, basée sur des journaux de sessions Claude Code, estime qu’un mois d’utilisation Max représente environ 7 470 $ au tarif public de l’API, contre un abonnement à 200 $. Dans une autre discussion comparant abonnement et API, un utilisateur du forfait à 200 $ a évalué le même volume de travail entre 5 000 et 20 000 $ par mois.
Ces estimations ne sont pas auditées, mais elles mettent toutes en évidence le même scénario gourmand en tokens : un agent qui parcourt un dépôt de code en boucle.
« Je suis sur le forfait API Enterprise de mon entreprise via Claude Code et je peux vous confirmer qu’il est très facile de dépenser 100 à 200 $ par session en coûts d’API en codant normalement sur de gros projets. » — u/andywidjaja, r/ClaudeAI
Un forfait payant et une clé API, ce sont deux produits différents
Anthropic l’explique sans ambiguïté. Son article du centre d’aide, mis à jour le 16 mars 2026, présente les forfaits Claude et la Claude Console comme des « produits distincts conçus pour des usages différents » et précise qu’un abonnement payant « n’inclut pas l’accès à l’API Claude ni à la Console ». OpenAI applique la même séparation en gérant la facturation de ChatGPT et de la plateforme API via deux systèmes distincts.
Pour comprendre la différence, il faut regarder ce que vend réellement chaque formule :
| Forfait de chat payant | Clé API | |
|---|---|---|
| Unité vendue | Un siège utilisateur | Un volume de tokens |
| Plafond | Fenêtre glissante de 5 heures et limites hebdomadaires | Aucun quota inclus ; des limites de débit et de dépense s’appliquent tout de même |
| Accès | Applications web, ordinateur et mobile | Votre propre code |
| Structure tarifaire | Forfait mensuel fixe | Variable, au token |
| Alimenter votre propre produit | Ce n’est pas ce qui est vendu | C’est précisément l’objectif |
La page tarifaire de Claude affiche Pro à 20 $/mois en facturation mensuelle, ou 17 $/mois avec une facturation annuelle (200 $ payés d’avance), et Max à partir de 100 $/mois, avec un volume d’utilisation correspondant à 5 ou 20 fois celui de Pro par session de cinq heures. Anthropic ne publie pas de nombre de messages pour ces offres : la consommation dépend de la longueur des conversations, du modèle et des fonctionnalités utilisées. La comparaison oppose donc une quantité mesurée à une autre qui ne l’est pas.
La même page fournit un autre indice : Claude Enterprise associe un forfait mensuel de 20 $ par siège à une utilisation facturée aux tarifs de l’API. Les gros utilisateurs repassent donc directement au compteur.
Ce qu’un dollar d’abonnement achète au tarif public
Convertir le prix d’un forfait en tokens permet de mesurer concrètement l’écart. Voici les tarifs officiels par million de tokens (MTok), tirés de la documentation tarifaire de la plateforme Claude et de la page tarifaire de l’API OpenAI, vérifiés le 1er octobre 2026.
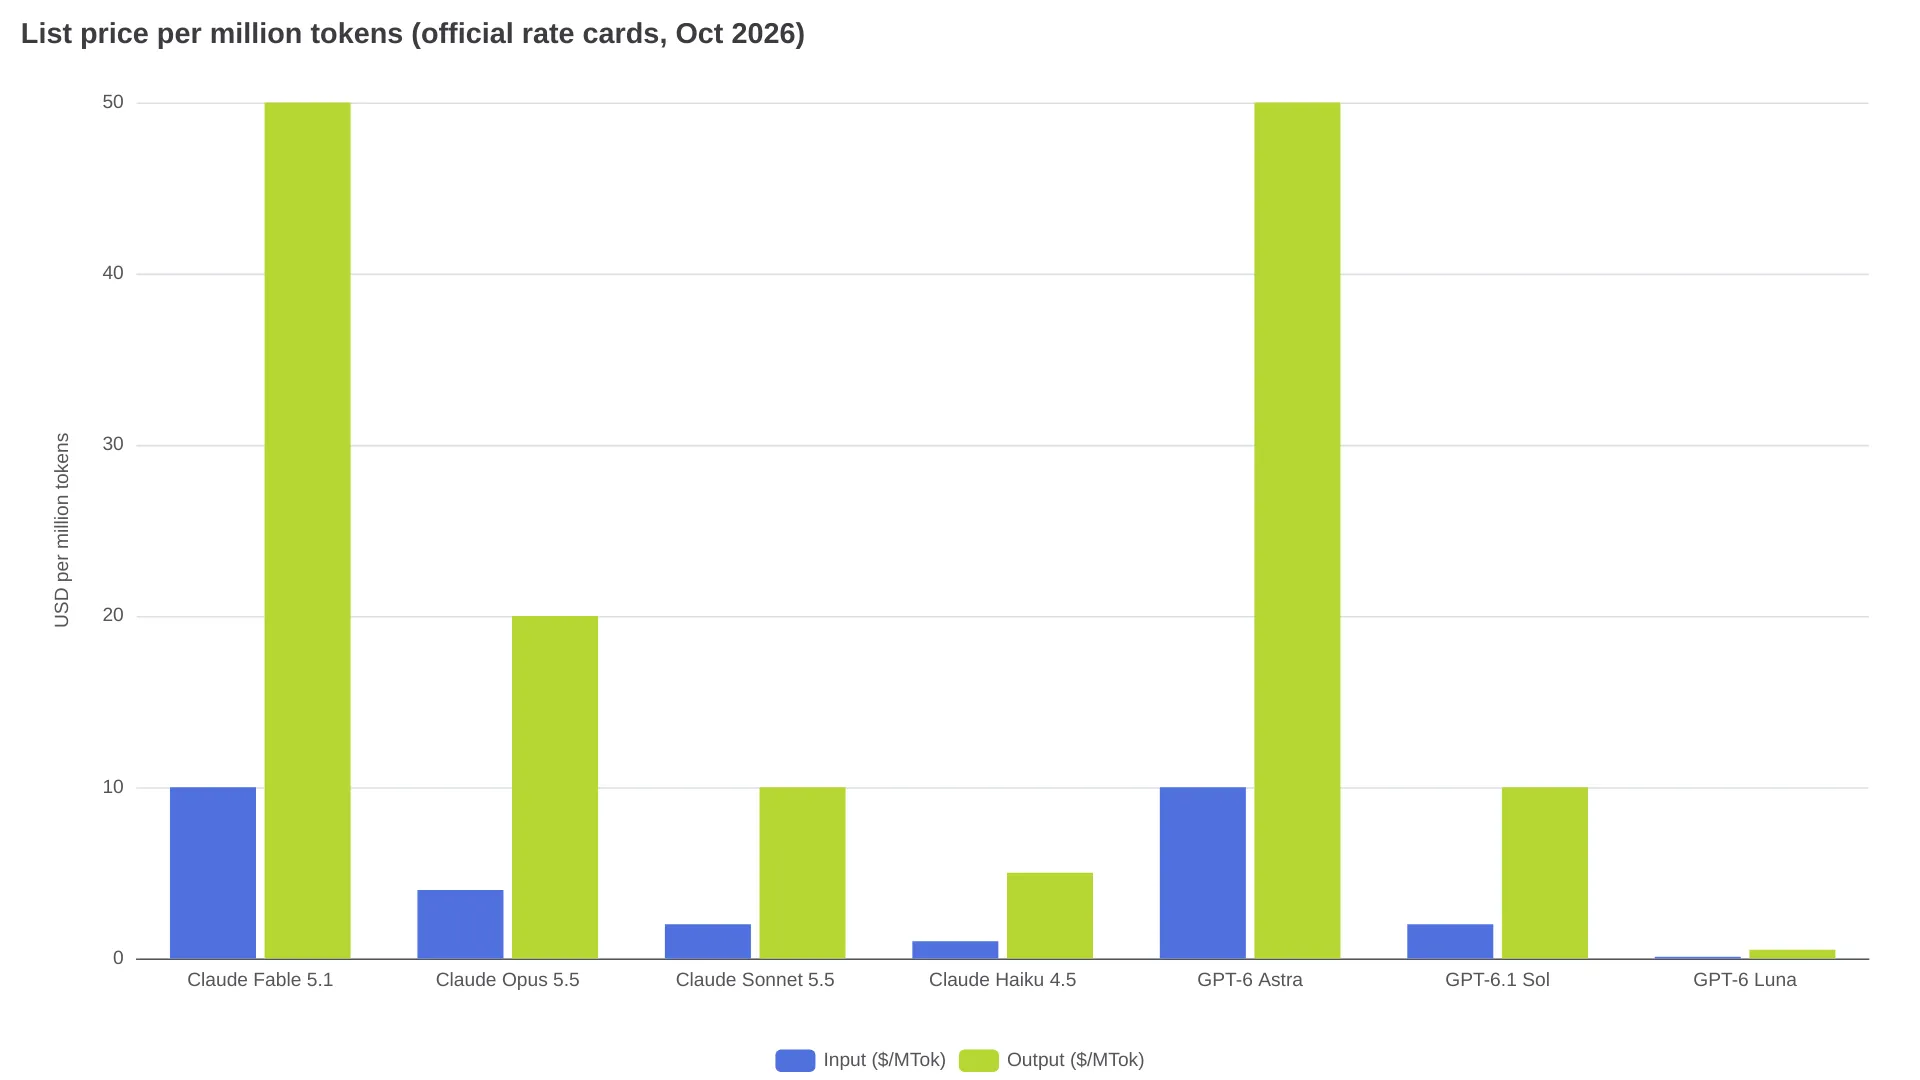
| Modèle | Entrée | Sortie | Lecture du cache | Batch (entrée/sortie) |
|---|---|---|---|---|
| Claude Fable 5.1 | $10 | $50 | $0.25 | $5 / $25 |
| Claude Opus 5.5 | $4 | $20 | $0.20 | $2 / $10 |
| Claude Sonnet 5.5 | $2 | $10 | $0.20 | $1 / $5 |
| Claude Haiku 4.5 | $1 | $5 | $0.10 | $0.50 / $2.50 |
| GPT-6 Astra | $10 | $50 | $1.00 | $5 / $25 |
| GPT-6.1 Sol | $2 | $10 | $0.10 | $1 / $5 |
| GPT-6 Luna | $0.10 | $0.50 | $0.01 | $0.05 / $0.25 |
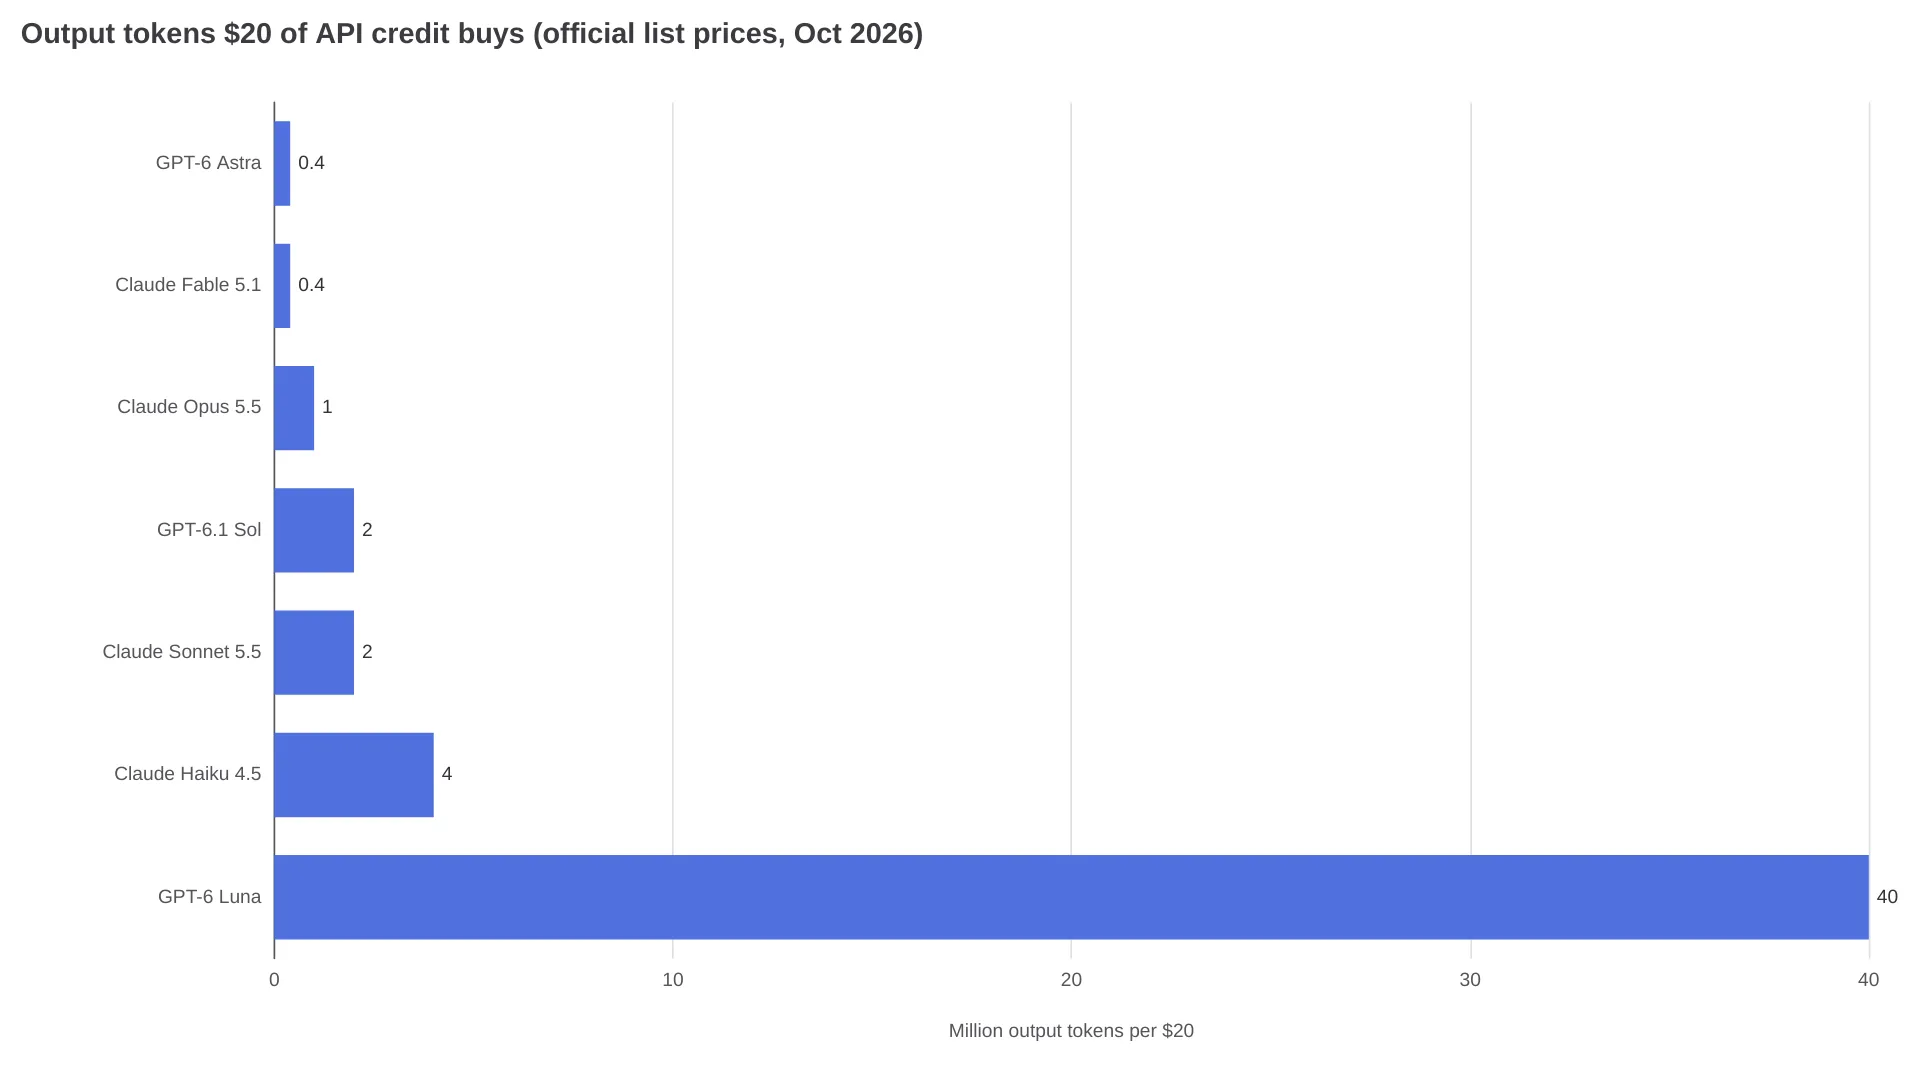
Pour un usage comparable à celui d’un chat, avec quelques milliers de mots de contexte et quelques centaines de mots en réponse, 20 $ de crédit Sonnet 5.5 couvrent environ 10 millions de tokens en entrée ou 2 millions en sortie. Votre propre calcul repose sur les quatre champs de la réponse API : (fresh input × input rate) + (cached input × cache-read rate) + (cache writes × write rate) + (output × output rate), auxquels s’ajoutent les multiplicateurs liés au batch, aux longs contextes et à la région. Journalisez ces quatre valeurs pour chaque endpoint pendant une semaine : vous obtiendrez une estimation mensuelle directement comparable au prix d’un siège.
Où partent réellement les tokens
Quatre sources fréquentes de dépenses inattendues se cachent derrière la grille tarifaire. Les trois dernières sont documentées dans l’analyse de LLM Cost Lab sur les coûts hors grille.
- La transcription, renvoyée à chaque tour. Dans une intégration de chat basée sur des requêtes successives, le client renvoie l’historique. Le vingtième tour contient donc les dix-neuf précédents. Si chaque tour ajoute à peu près la même quantité de contexte, le volume d’entrée augmente grosso modo avec le carré de la longueur de la conversation. C’est pourquoi cette analyse chiffre une session de 20 tours à 0,163 $, contre 0,063 $ lorsqu’on budgète les appels comme s’ils étaient indépendants : un écart de 2,6×.
- Le prompt système, répété à chaque appel. Un prompt système de 2 000 tokens envoyé avec 1 million de requêtes représente 2 milliards de tokens en entrée avant même qu’un utilisateur ait écrit quoi que ce soit.
- Les tokens de raisonnement invisibles. Sur les modèles qui facturent les traces de réflexion masquées comme des tokens de sortie, ces tokens peuvent être plusieurs fois plus nombreux que la réponse visible. Se baser uniquement sur le nombre de caractères renvoyés sous-estime donc la facture.
- Les résultats d’outils, les nouvelles tentatives et les générations abandonnées. Tout ce que le modèle génère est facturé, y compris la réponse rejetée par votre validateur JSON ou l’appel parallèle lancé en course et finalement abandonné.
Des tokens bon marché peuvent malgré tout représenter l’essentiel de la facture, ce qui déroute lorsqu’on consulte son tableau de consommation. Dans la discussion autour des 7 470 $, un commentateur a relevé que les lectures du cache représentaient 48 % du total, alors qu’il s’agit du type de token le moins cher de la grille.
« C’est déjà le type de token le moins cher de l’API. S’il reste majoritaire après application des tarifs publics, cela signifie que le workload consiste surtout à relire le contexte à chaque tour. » — u/YoanEdwin, r/ClaudeAI
Appliquez les tarifs d’Opus 5.5 à un tour d’agent transportant 150 000 tokens de contexte de dépôt, et la mécanique devient évidente :
| Opus 5.5, session de 60 tours, contexte de 150k + sortie de 2k par tour | Coût |
|---|---|
| Entrée fraîche à chaque tour, sans lecture du cache (150k @ $4) | $0.60 |
| Lecture du cache à chaque tour au lieu d’une entrée fraîche (150k @ $0.20) | $0.03 |
| Sortie à chaque tour (2k @ $20) | $0.04 |
| Une écriture de cache d’une heure par session (150k @ $8) | $1.20 |
| Total de la session, sans cache | $38.40 |
| Total de la session, avec cache | $5.40 |
Deux sessions avec cache par jour, sur 22 jours ouvrés, représentent environ 238 $, soit déjà plus qu’un forfait à 200 $. Sans cache, le même mois dépasse 1 600 $. Le tarif n’a pas changé ; c’est le nombre de tokens qui a explosé.
Il n’y a pas deux niveaux, mais trois
La plupart des comparaisons s’arrêtent au duel entre forfait et API. Il existe pourtant un troisième niveau, que les utilisateurs découvrent une fois leur quota épuisé : les crédits d’utilisation supplémentaires vendus à l’intérieur du produit d’abonnement.
Des témoignages publiés sur r/codex situent ce niveau au-dessus du tarif brut de l’API. Un utilisateur Pro a suivi environ 16 millions de tokens consommés via des crédits achetés pour quelque 40 $, puis a estimé le même volume à environ 12 $ au tarif public de l’API.
« Oui, le prix des crédits est à la limite de l’abus. 50 $ pour une seule landing page, c’est absurde quand l’API coûterait environ 2 $. » — u/AbjectBug5885, r/codex
Ces chiffres viennent d’utilisateurs et ne constituent pas des tarifs universels. Le prix des recharges varie selon le fournisseur et le forfait. Dans les cas Codex cités plus haut, ce niveau de recharge revenait environ 3 fois plus cher que la dépense équivalente au tarif public de l’API. Cela mérite d’être vérifié avec vos propres chiffres avant d’acheter des crédits une deuxième semaine de suite.
Cinq leviers pour faire baisser la facture
Chaque levier s’appuie sur un tarif officiel : vous pouvez donc vérifier les calculs directement sur la page du fournisseur.
- Le cache de prompt, en intégrant le coût d’écriture. La documentation tarifaire d’Anthropic fixe l’écriture d’un cache de 5 minutes à 1,25× le prix de base de l’entrée, et celle d’un cache d’une heure à 2×, tandis que les lectures coûtent 0,1× le prix de base (0,05× sur Opus 5.5, 0,025× sur Fable 5.1). Une écriture de 5 minutes est amortie après une lecture ; celle d’une heure après deux. Si le cache est écrit sans jamais être lu, il coûte plus cher que l’absence de cache. L’ordre des éléments compte autant que l’activation de la fonctionnalité : placez le contenu stable au début et les variations utilisateur à la fin, sinon le préfixe ne correspondra plus. Ce guide du prompt caching détaille le diagnostic du taux de réussite.
- Le batch pour tout ce qui peut attendre. Les deux fournisseurs réduisent de 50 % le tarif public pour le traitement asynchrone : Opus 5.5 passe à 2/10 $, Sonnet 5.5 à 1/5 $. La couverture reste toutefois inégale : LLM Cost Lab recense 26 modèles sur les 83 suivis qui proposent un niveau batch remisé. Vérifiez donc que votre modèle est concerné avant de bâtir votre architecture dessus. Le fonctionnement est expliqué dans notre guide des tarifs de l’API batch.
- Choisir le modèle selon la tâche. La classification, le routage et les décisions de récupération de données nécessitent rarement un modèle haut de gamme. Entre Haiku 4.5 à 1/5 $ et Fable 5.1 à 10/50 $, l’écart atteint 10× pour des étapes qui ne produisent que dix tokens.
- Limiter la sortie, pas seulement
max_tokens. La sortie est facturée 5× plus cher que l’entrée dans presque toutes les lignes du tableau ci-dessus. Un schéma qui interdit tout préambule ajoute un peu de structure, mais évite la prose qui vous aurait été facturée. De son côté,max_tokensest plus efficace comme plafond de sécurité que comme outil de mise en forme : une réponse tronquée peut imposer une deuxième tentative payante. - Surveiller les multiplicateurs qui s’ajoutent au tarif. Le niveau long contexte d’OpenAI double les tarifs d’entrée en contexte court, tandis que le mode Fast double à nouveau le prix standard. Anthropic facture 1,1× pour l’inférence localisée aux États-Unis et sa documentation tarifaire indique que Claude 4.7 et les versions ultérieures utilisent un nouveau tokenizer qui produit environ 30 % de tokens supplémentaires pour un même texte. Votre prompt n’a pas changé ; le compteur, si.
Une autre option structurelle ne figure pas dans cette liste : faire transiter le trafic programmatique par un seul endpoint facturé à l’usage plutôt que de multiplier les relations de facturation avec chaque fournisseur. C’est précisément le rôle de l’endpoint Claude API d’AIReiter. Au tarif public, un mois de dépassement avec 40 millions de tokens d’entrée de niveau Sonnet et 8 millions en sortie revient à 80 $ + 80 $. La comparaison avec un second siège ne prend donc qu’une minute.
Quel produit choisir ?
| Votre situation | Choix | Pourquoi |
|---|---|---|
| Chat, recherche et code occasionnel dans une application | Forfait payant uniquement | Dépense plafonnée, applications incluses et utilisation largement sous les limites du forfait |
| Développement agentique en solo, sur une seule machine | Forfait d’abord, clé facturée à l’usage pour le dépassement | Le forfait absorbe l’essentiel ; la clé évite d’attendre la réinitialisation hebdomadaire |
| Lancer un produit utilisé par d’autres personnes | API uniquement | Un siège couvre une personne ; vos utilisateurs ont besoin de leur propre volume de traitement |
| Tâches groupées périodiques : évaluations, backfills, classification | API avec niveau batch | 50 % de réduction sur le tarif public, la latence n’a pas d’importance |
| Acheter déjà des crédits supplémentaires la plupart des semaines | Comparer le dépassement au prix d’une clé | Les tarifs de crédits rapportés dépassaient ceux de l’API au tarif public |
FAQ
Un forfait ChatGPT ou Claude payant inclut-il des crédits API ?
Non. Le centre d’aide d’Anthropic précise qu’un forfait Claude payant « n’inclut pas l’accès à l’API Claude ni à la Console », tandis qu’OpenAI facture ChatGPT et la plateforme API via deux systèmes distincts. Si vous payez les deux, vous avez deux lignes de facturation.
Les tokens de raisonnement que je ne vois pas sont-ils facturés ?
Oui, pour les modèles qui exposent une réflexion ou un raisonnement étendu. Ces tokens sont facturés au tarif de sortie sans apparaître dans le corps de la réponse. Consultez donc l’objet usage.
La conversation entière est-elle facturée à chaque tour ?
Oui, sauf si une lecture du cache couvre le préfixe répété. En l’absence de fonctionnalité de gestion d’état côté serveur, votre client renvoie l’historique que le modèle doit voir. Cet historique est facturé comme une nouvelle entrée au tarif du modèle, ou au tarif de lecture du cache lorsque le préfixe correspond.
Une requête échouée ou relancée coûte-t-elle quand même de l’argent ?
Selon l’analyse de facturation de LLM Cost Lab, une requête qui atteint le modèle et reçoit une réponse est facturée même si votre application abandonne le résultat après une erreur de schéma ou un dépassement de délai côté client. Les requêtes rejetées avant la génération font exception.
Le compromis que personne n’a encore résolu
Les forfaits plafonnent la dépense, mais rationnent l’accès ; les clés facturées à l’usage font l’inverse. Aucun volume de tokens officiel n’étant publié pour les quotas des forfaits, répondre à la question « quelle option est la moins chère pour moi ? » nécessite de mesurer pendant une semaine votre propre trafic instrumenté, puis de le comparer au tableau ci-dessus.
À lire aussi : Cheapest LLM API in 2026 · Claude API pricing guide