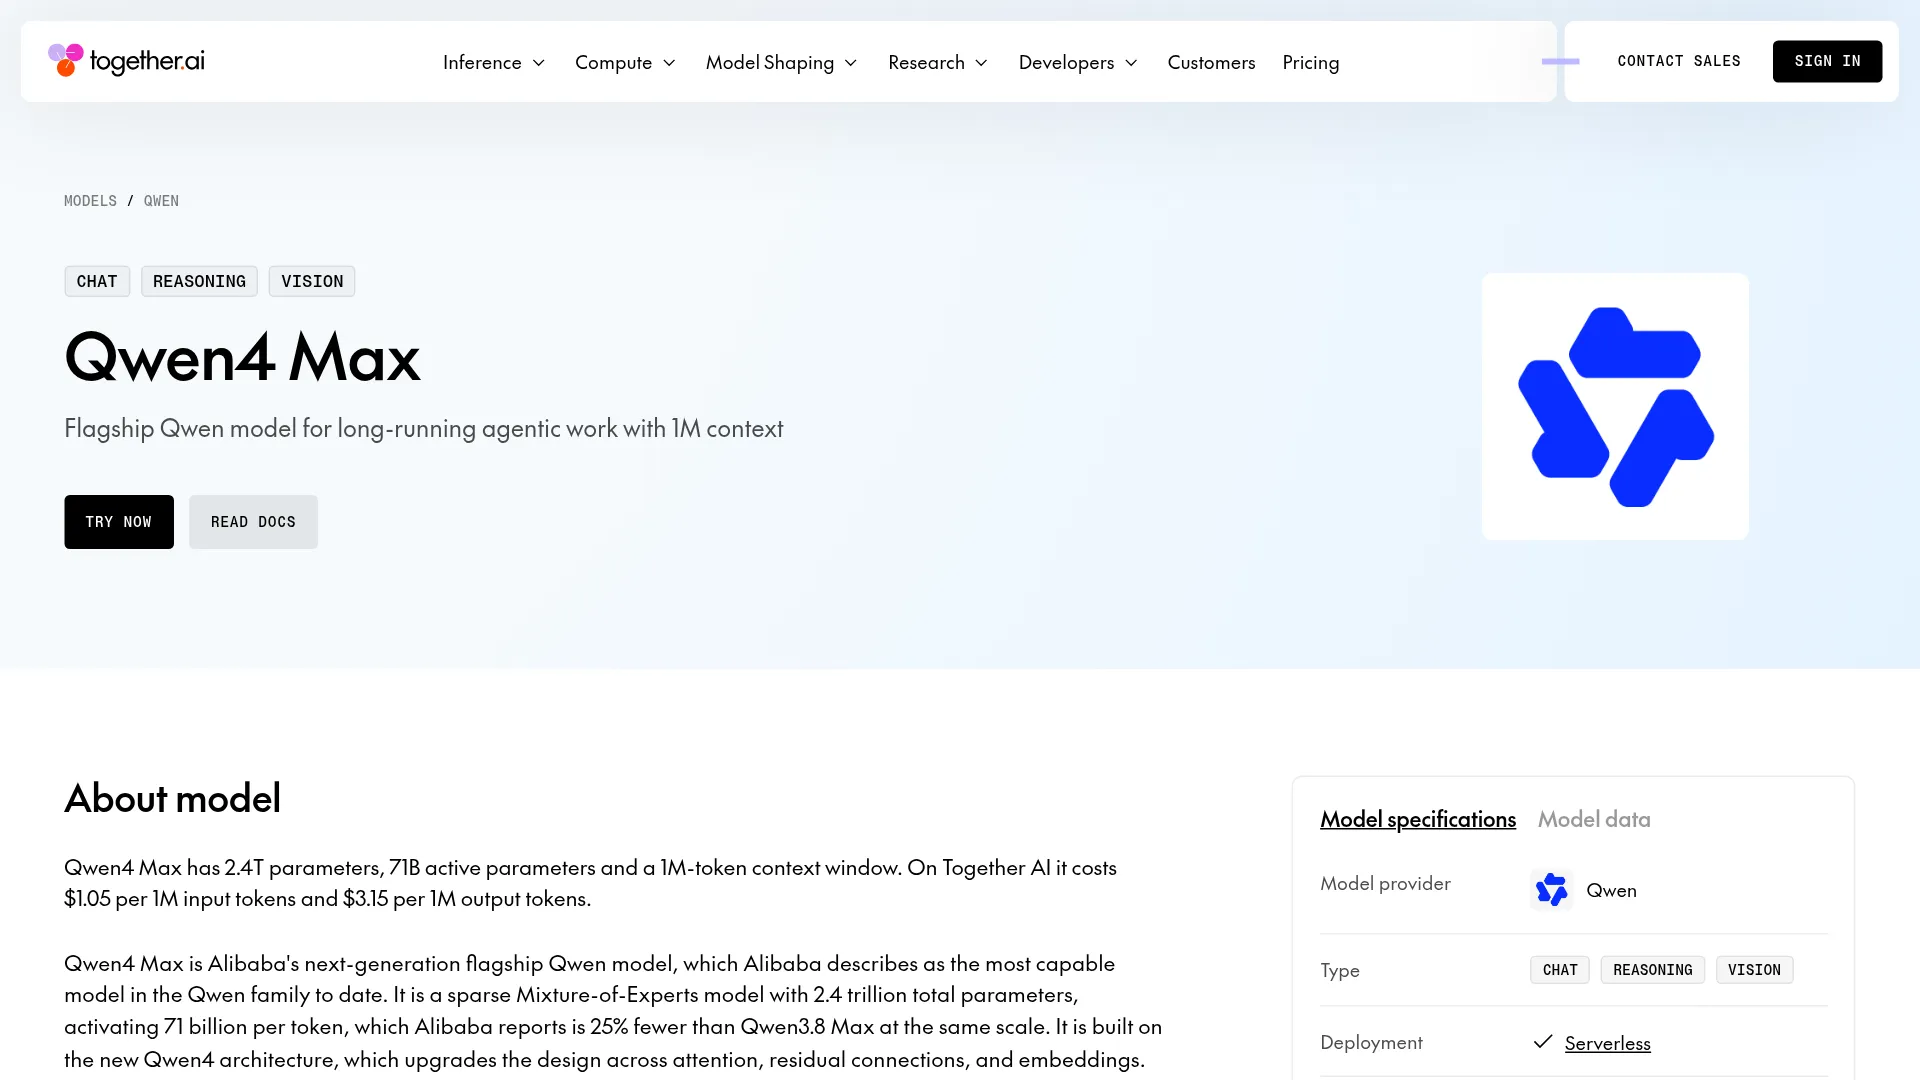
Together AI facture Qwen4 Max 1,05 $ par million de tokens en entrée et 3,15 $ par million en sortie. La promotion annoncée court jusqu'au 22 novembre 2026 ; vérifiez la page en direct au moment du basculement, car le tarif catalogue passera ensuite à 1,50 $ et 4,50 $. Pendant la promotion, Together AI est le moins cher. Après celle-ci, les prix s'alignent et ce sont le cache, la latence et le routage qui feront la différence.
L'endpoint Qwen/Qwen4-Max, le contexte d'1 M de tokens et les tarifs promotionnels sont indiqués sur la page du modèle de Together AI et dans l'article de lancement de Together AI publié le 21 novembre 2026.
Ce que 0,69 $ permet de faire : 344 fichiers en une seule requête
Together AI a envoyé les 344 fichiers de Tornado, soit 652 519 tokens en entrée, ainsi qu'un rapport de bug WebSocket dans une seule requête, sans système de recherche ni outil (article de lancement de Together AI). Qwen4 Max a identifié le problème, proposé un correctif, puis fait passer les nouveaux tests ainsi que les 1 673 tests existants. Le premier token est arrivé au bout de 54 secondes et la génération s'est terminée en 72 secondes (article de lancement de Together AI).
Cette exécution a coûté environ 0,69 $ au tarif promotionnel, ou 0,98 $ au tarif catalogue, presque entièrement à cause de l'entrée. Avec la mise en cache d'environ 630 000 tokens répétés, le coût d'entrée est passé d'environ 0,66 $ à 0,03 $ et le délai avant le premier token de 54 à 8 secondes. Attention toutefois : la mise en cache reste fournie au mieux des possibilités du service (article de lancement de Together AI).
« Je l'ai testé via le Token Plan d'Alibaba : il s'est montré meilleur que DeepSeek 4.1Flash (sur quelques tâches de programmation et de travail sur une instance distante), mais il a mis une éternité à terminer. » — u/FlounderRecent sur r/Qwen_AI
Les tarifs de Together AI en un coup d'œil
Together AI indique la date de fin de la promotion, mais pas l'heure ni le fuseau horaire de l'échéance (page du modèle). Vérifiez donc le tarif avant une exécution importante. Le coût se calcule ainsi : entrée / 1 M × tarif d'entrée, auquel on ajoute sortie et raisonnement / 1 M × tarif de sortie. Les tokens d'entrée mis en cache utilisent le tarif cache.
| Palier tarifaire | Entrée / 1 M | Entrée en cache / 1 M | Sortie / 1 M |
|---|---|---|---|
| Promotion Together AI (jusqu'au 22 nov. 2026) | 1,05 $ | 0,0525 $ | 3,15 $ |
| Tarif catalogue Together AI | 1,50 $ | 0,075 $ | 4,50 $ |
L'entrée en cache coûte 5 % du tarif normal. Les tokens de réflexion sont facturés comme des tokens de sortie (article de lancement de Together AI).
| Charge de travail | Entrée | Sortie | Coût promotionnel | Coût catalogue |
|---|---|---|---|---|
| Session de programmation agentique | 60 000 | 4 000 | 0,0756 $ | 0,108 $ |
| Requête sur le dépôt complet de Tornado | 652 519 | ~2 000 estimés | ~0,69 $ | ~0,98 $ |
| Répétition avec ~630 000 tokens en cache | ~630 000 en cache | faible | ~0,03 $ en entrée | ~0,047 $ en entrée |
La sortie de la ligne Tornado reste approximative, car le nombre de tokens de raisonnement facturés varie selon le niveau d'effort demandé.
Contexte d'1 M sur Together AI : capacité annoncée et volume réellement exploitable
Qwen4 Max annonce un contexte d'1 M de tokens partagé entre le prompt, le raisonnement et la sortie. Une vue d'ensemble d'une passerelle indique environ 984 000 tokens réellement disponibles pour l'entrée (Sovyron). De son côté, Vercel plafonne la sortie à 384 000 tokens, raisonnement compris. Au-delà de 900 000 tokens en entrée, gardez environ 100 000 tokens de marge.
Trois pièges de Together AI qui font échouer les premières requêtes
1. Les requêtes sans streaming renvoient streaming_required. Together AI n'accepte que le streaming (article de lancement). Une requête sans streaming renvoie une erreur HTTP 400. Il faut donc utiliser "stream": true ou stream=True.
2. La réflexion est activée par défaut et facturée comme de la sortie. Le flux sépare delta.reasoning de delta.content (article de lancement). Pour une extraction peu coûteuse, désactivez-la :
response = client.chat.completions.create(
    model="Qwen/Qwen4-Max",
    messages=messages,
    stream=True,
    reasoning={"enabled": False},
)
"reasoning_effort": "max" augmente l'effort consacré aux tâches plus difficiles (article de lancement).
3. Service serverless uniquement, cache non garanti et aucun secret dans le prompt. Il n'y a ni fine-tuning ni endpoint dédié (article de lancement). La mise en cache est automatique, mais fournie au mieux des possibilités du service. L'exemple recense chaque fichier suivi par git ls-files (article de lancement) : avant d'envoyer un dépôt complet, pensez donc à supprimer les secrets.
Together AI, QwenCloud ou OpenRouter : où appeler le modèle ?
| Fournisseur | Entrée / 1 M | Sortie / 1 M | Lecture du cache / 1 M | Remarques |
|---|---|---|---|---|
| Together AI en promotion | 1,05 $ | 3,15 $ | 0,0525 $ | Jusqu'au 22 nov. ; Qwen/Qwen4-Max, serverless uniquement, streaming obligatoire |
| Together AI au tarif catalogue | 1,50 $ | 4,50 $ | 0,075 $ | Même endpoint après la promotion |
| QwenCloud | 1,50 $ | 4,50 $ | 0,075 $ | Accès direct à Qwen au tarif indiqué pour Singapour |
| OpenRouter via Ailyre / CloudTweaks | 1,425 $ | 4,275 $ | ~0,071 $ | Routage mondial ; relevés des 20 au 22 nov. |
| Deep Infra / Novita AI via Sovyron | 1,413 $ | 4,24 $ | ~0,071 $ | Tarif hors promotion le plus bas dans le relevé Sovyron du 17 nov. |
| Vercel AI Gateway | 1,50 $ | 4,50 $ | 0,08 $ en lecture / 1,88 $ en écriture | Relevé : 3,3 s de latence, 52 tok/s, 93 % de succès du cache ; crédit de 5 $ |
Pendant la promotion, Together AI est le moins cher pour les prompts répétés. Ensuite, les relevés cités placent Deep Infra ou Novita AI parmi les options hors promotion les plus abordables. OpenRouter et Vercel demandent un léger supplément en échange du routage et des outils associés.
Lancer une requête en streaming sur Together AI
curl -X POST "https://api.together.ai/v1/chat/completions" \
  -H "Authorization: Bearer $TOGETHER_API_KEY" \
  -H "Content-Type: application/json" \
-d '{"model": "Qwen/Qwen4-Max", "messages": [{"role": "user", "content": "Hi"}], "stream": true}'from together import Together
client = Together()
response = client.chat.completions.create(
model="Qwen/Qwen4-Max",
messages=[{"role": "user", "content": "Explain this diff in 3 bullets."}],
stream=True,
)
for chunk in response:
print(chunk.choices[0].delta.content or "", end="")Pour travailler sur un dépôt complet, placez les fichiers dans le message système sous forme d'entrées === FILE: path ===, ajoutez le rapport de bug dans le message utilisateur, puis diffusez le correctif en streaming (article de lancement).
Faut-il faire passer Qwen4 Max par Together AI ?
| Charge de travail | Route recommandée cette semaine | Pourquoi |
|---|---|---|
| Analyse d'un dépôt complet (300 à 650 k tokens en entrée) | Promotion Together AI | Exécution autour de 0,69 $ ; pas besoin de pipeline de recherche |
| Boucles répétées sur la même base de code | Together AI (quel que soit le tarif) | La répétition passe d'environ 0,66 $ à environ 0,03 $ ; TTFT de 54 à 8 s |
| Traces de raisonnement lourdes en sortie | Le tarif de sortie vérifié le plus bas ; désactivez le raisonnement si la qualité le permet | La réflexion est facturée comme une sortie à 3,15-4,50 $ |
| Charges sensibles à la région | Consultez la documentation régionale de QwenCloud avant de router les requêtes | Together AI ne propose ni endpoint dédié ni fine-tuning |
| Solution de secours et tests dans un playground | OpenRouter / Vercel AI Gateway | Routage, nouvelles tentatives et crédit Vercel de 5 $ |
Dans le test Tornado cité, le prompt à froid de 650 k tokens a mis 54 secondes à produire le premier token. Ce profil convient donc mieux à une analyse par lots ou nocturne qu'à une boucle interactive dans un IDE. Le cache a accéléré la répétition, pas le premier passage : prévoyez le coût et le délai de cette première exécution.
FAQ
Quel est l'identifiant exact du modèle Together AI ?
Qwen/Qwen4-Max à l'adresse https://api.together.ai/v1/chat/completions.
Puis-je faire du fine-tuning de Qwen4 Max sur Together AI ?
Non. À la publication, le service est serverless uniquement et ne propose ni fine-tuning ni endpoint dédié (article de lancement).
Quand la promotion de Together AI prend-elle fin ?
Elle court jusqu'au 22 novembre 2026, sans heure d'échéance publiée. Consultez la page du modèle avant une exécution importante.
Together AI est-il moins cher que QwenCloud Singapore ?
Pendant la promotion, oui (1,05 $/3,15 $ contre 1,50 $/4,50 $). Ensuite, les tarifs affichés sont identiques et le choix dépend du cache, de la latence et du routage.