 AIREITER
Le tableau de bord d’OpenRouter affiche un taux de réussite du cache de 82,8 % à l’échelle de la plateforme (@OpenRouter). Sur le terrain, certains utilisateurs rapportent pourtant des taux inférieurs à 1 % (@miolini) et des factures 10 à 32 fois supérieures à leurs prévisions (r/openrouter). La mise en cache des prompts peut bien réduire le coût des tokens d’entrée, mais seulement après avoir éliminé quatre causes précises d’échec. Le levier le plus important consiste à conserver les requêtes consécutives chez un même fournisseur, tant que son cache est encore chaud. Et il y a une limite incontournable : si le prompt reste sous le seuil minimal imposé par le fournisseur, il ne sera jamais mis en cache, quelle que soit votre configuration.
À quoi correspond un cache hit dans OpenRouter
La mise en cache des prompts réutilise un préfixe stable qu’un fournisseur a déjà traité. Les tokens d’entrée répétés sont alors facturés à tarif réduit au lieu de l’être au prix normal. Le cache est propre au point d’accès du fournisseur qui a traité la requête initiale : le comportement du routage compte donc autant que la structure du prompt. Il ne faut pas confondre ce mécanisme avec le cache des réponses, qui renvoie gratuitement une requête complète strictement identique, avant même que le routage n’entre en jeu.
| Mise en cache du prompt | Mise en cache de la réponse | |
|---|---|---|
| Ce qui est réutilisé | Le préfixe stable d’une requête quelconque | Une requête identique octet par octet (SHA-256 du corps normalisé) |
| Activation | Le plus souvent automatique ; cache_control pour Anthropic, Qwen et Gemini | En-tête X-OpenRouter-Cache: true ou preset |
| Coût | Tokens mis en cache facturés entre 0,1 et 0,5 fois le prix d’entrée | Les hits sont gratuits, les échecs sont facturés normalement |
| Durée de vie | 3 à 5 min en général, jusqu’à 1 h (Anthropic) | 300 s par défaut, de 1 à 86 400 s |
| Ce qui bloque | Modification du préfixe, changement de fournisseur, minimum de tokens | La moindre modification du JSON, rotation de la clé API, ZDR du compte |
Le cache des réponses est idéal pour les nouvelles tentatives, les tests unitaires et les appels identiques répétés dans les workflows d’agents. Attention : l’ordre des propriétés JSON fait partie de la clé du cache. Une simple modification de sérialisation peut donc suffire à provoquer un échec. Pour comprendre le fonctionnement côté fournisseur, la référence reste le guide OpenRouter consacré à la mise en cache des prompts :
Tarifs de la mise en cache des prompts OpenRouter, fournisseur par fournisseur
La lecture d’un prompt mis en cache coûte partout une fraction du tarif d’entrée normal. En revanche, la création du cache peut être majorée : 1,25 fois le prix d’entrée habituel chez Anthropic avec la durée par défaut de 5 minutes, et 2 fois avec l’option d’une heure. Le calcul devient intéressant lorsque le même préfixe est relu suffisamment souvent pour amortir cette écriture. Pour une requête isolée, activer le cache peut même coûter plus cher que de s’en passer. Avec Claude Sonnet 4.6, les tokens d’entrée mis en cache coûtent 0,30 $/M, contre 3,00 $/M au tarif normal, selon les exemples chiffrés d’OpenRouter.
Voici les coefficients d’écriture et de lecture par fournisseur, d’après la même source :
| Fournisseur | Écriture du cache | Lecture du cache | Remarques |
|---|---|---|---|
| Anthropic | 1,25 fois (5 min) / 2 fois (1 h) | 0,1 fois | Durée sélectionnable pour chaque point de rupture |
| OpenAI, avant GPT-5.6 | Gratuite | 0,25–0,5 fois | Automatique à partir de 1 024 tokens |
| OpenAI GPT-5.6+ | 1,25 fois | 0,25–0,5 fois | Les points de rupture explicites sont désormais pris en charge |
| Google Gemini | Gratuite | 0,25 fois | Implicite à partir de 2.5+, durée d’environ 3–5 min |
| Grok | Gratuite | 0,25 fois | Automatique |
| Moonshot | Gratuite | 0,25 fois | Automatique |
| Groq | Gratuite | 0,5 fois | Modèles Kimi K2 uniquement |
| DeepSeek | 1,0 fois | 0,1 fois | Les écritures sont facturées comme des entrées normales |
| Alibaba Qwen | 1,25 fois | 0,1 fois | cache_control explicite obligatoire |
| Z.AI | Gratuite | ~0,2 fois | Le stockage mis en cache est indiqué comme gratuit pour une durée limitée |
Dans son tutoriel, OpenRouter modélise 10 000 tokens répétés sur six tours : 6,0 fois le coût d’un seul tour sans cache, 1,75 fois avec le cache Anthropic de 5 minutes et le routage persistant, et 2,25 fois chez un fournisseur dont l’écriture est gratuite et la lecture facturée à 0,25 fois. Le modèle ne tient compte ni de l’allongement des messages ni des tokens de sortie.
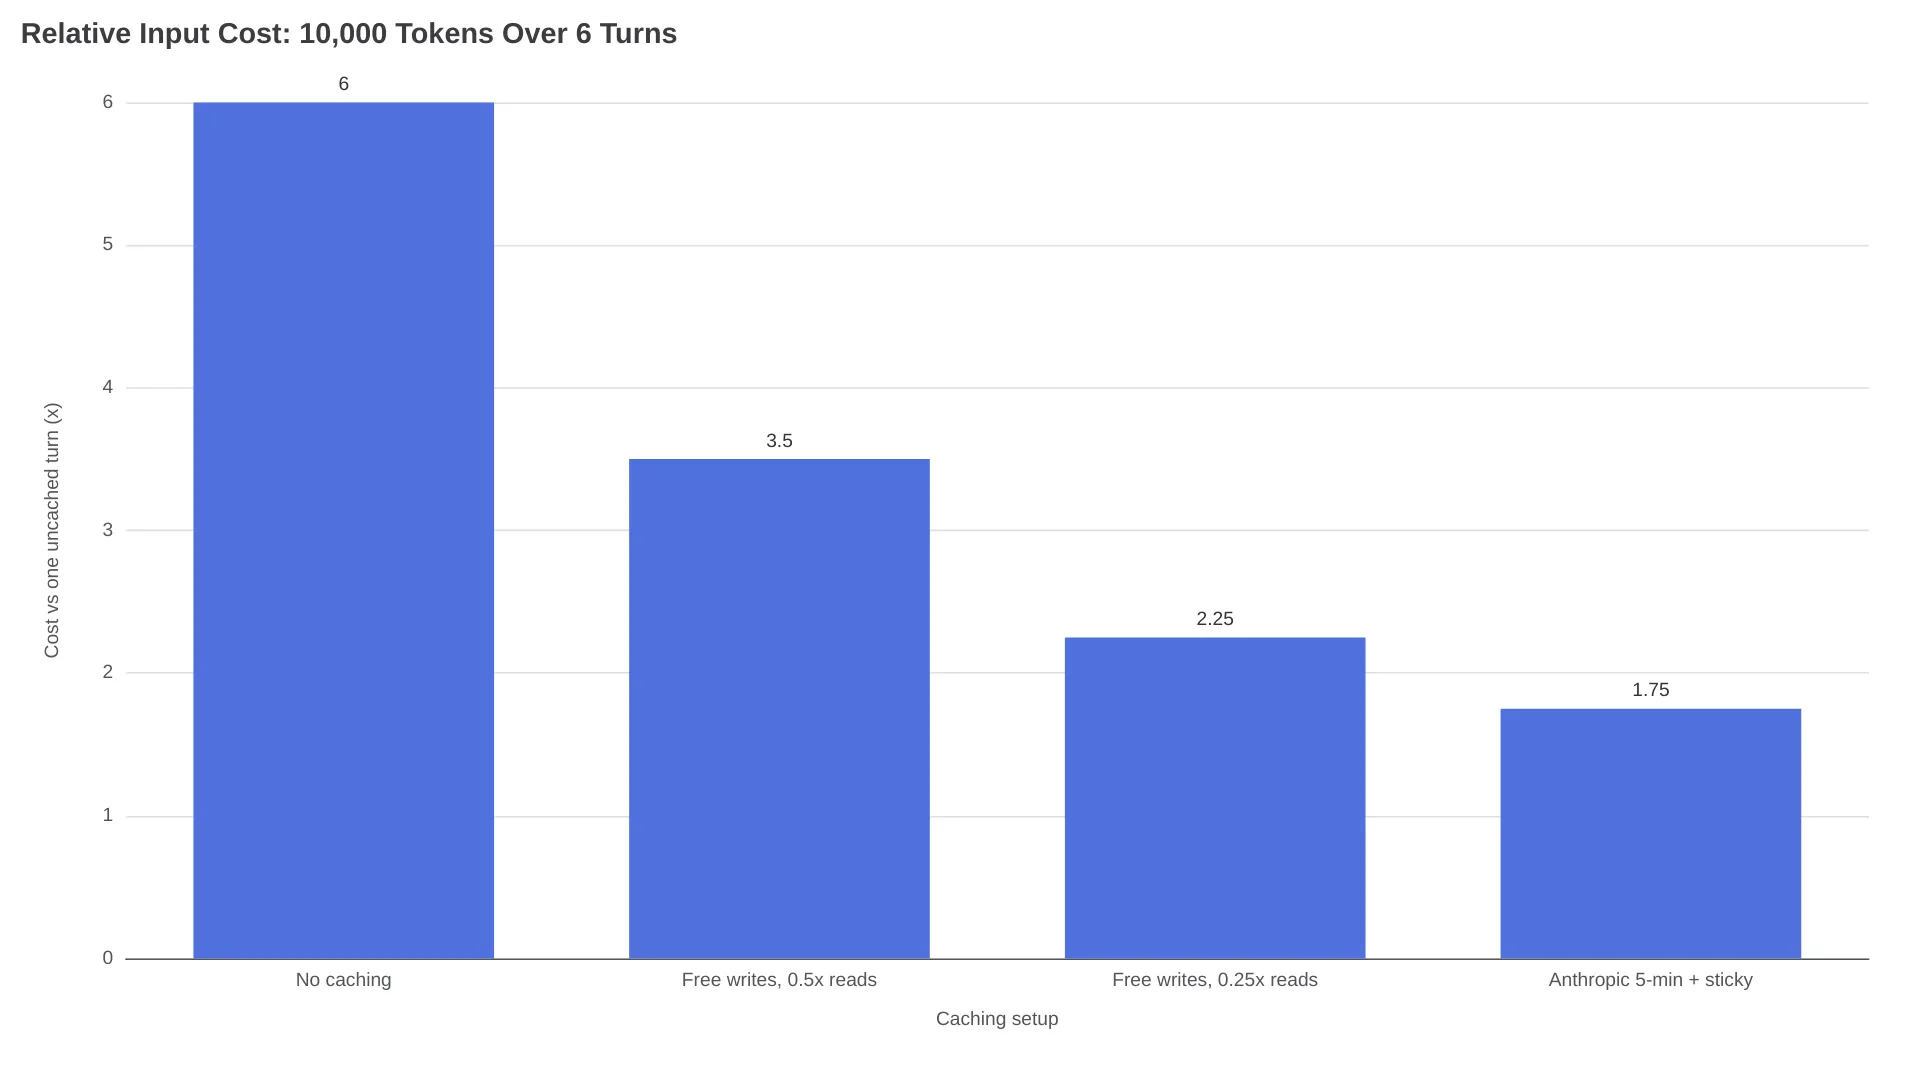
À six tours, l’écriture coûteuse d’Anthropic devient rentable, car ses lectures à 0,1 fois dominent dès le deuxième tour. L’écart continue de se creuser lorsque les tours s’accumulent. Le résultat s’inverse toutefois si la durée de vie de 5 minutes expire entre deux tours : vous repayez alors l’écriture à 1,25 fois à chaque requête, soit 7,5 fois sur six tours — davantage que sans cache. Avec un fournisseur à écriture gratuite et entrée à 1,0 fois, vous retombez simplement au même coût que les 6,0 fois sans mise en cache.
Mesurez avant de chercher la panne : trois valeurs qui prouvent un hit
Chaque réponse OpenRouter contient le verdict dans son objet usage : cached_tokens, cache_write_tokens et cache_discount. La signification de ces champs est documentée dans le guide de mise en cache d’OpenRouter. Les consulter avant de modifier votre configuration permet de distinguer un véritable échec de cache d’une simple surprise tarifaire. Si cached_tokens est supérieur à zéro, la requête a utilisé un cache chaud. À zéro, elle ne l’a pas fait, quoi qu’indique le tableau de bord Activity.
"usage": {
  "prompt_tokens": 10339,
  "prompt_tokens_details": {
    "cached_tokens": 10318,
    "cache_write_tokens": 0
  }
}
Cette réponse correspond à un taux de réussite de 99,8 % : 10 318 des 10 339 tokens du prompt viennent du cache. cache_write_tokens apparaît lors de la première requête qui crée le cache. cache_discount indique le montant économisé et peut devenir négatif lors des écritures Anthropic, puisque la majoration de 1,25 fois est bien facturée avant d’être compensée par les lectures suivantes. Vous pouvez retrouver ces mêmes valeurs dans la vue détaillée de la génération, dans Activity (notre guide du tableau de bord Activity indique où les trouver), ou via /api/v1/generation.
Les métadonnées brutes font foi, pas l’interface. Un utilisateur de SillyTavern a longtemps traqué un problème de cache fantôme avant de consulter directement les logs :
« Les métadonnées brutes d’OpenRouter indiquent clairement
native_tokens_cached: 0[et]usage_cache: null. » — u/HauntingWeakness
Si ces trois valeurs restent à zéro jour après jour, l’une des quatre causes suivantes neutralise votre cache.
Les quatre raisons pour lesquelles un cache chaud refroidit
La documentation d’OpenRouter et les retours de la communauté convergent vers quatre causes fréquentes d’effondrement du taux de réussite : prompt sous le minimum requis, expiration du TTL entre deux tours, préfixe modifié et changement de fournisseur. Chacune laisse une signature différente dans les logs et appelle un correctif spécifique.
1. Le prompt n’atteint pas le minimum requis par le fournisseur
Les fournisseurs compatibles avec la mise en cache imposent un seuil de tokens propre à chaque modèle. Un prompt système de 900 tokens ne sera donc jamais mis en cache sur un modèle Claude. Ajouter du texte artificiel n’est d’ailleurs pas recommandé : « N’ajoutez pas de texte de remplissage uniquement pour forcer la mise en cache », rappelle le tutoriel OpenRouter. Ces seuils varient du simple au quadruple selon les modèles :
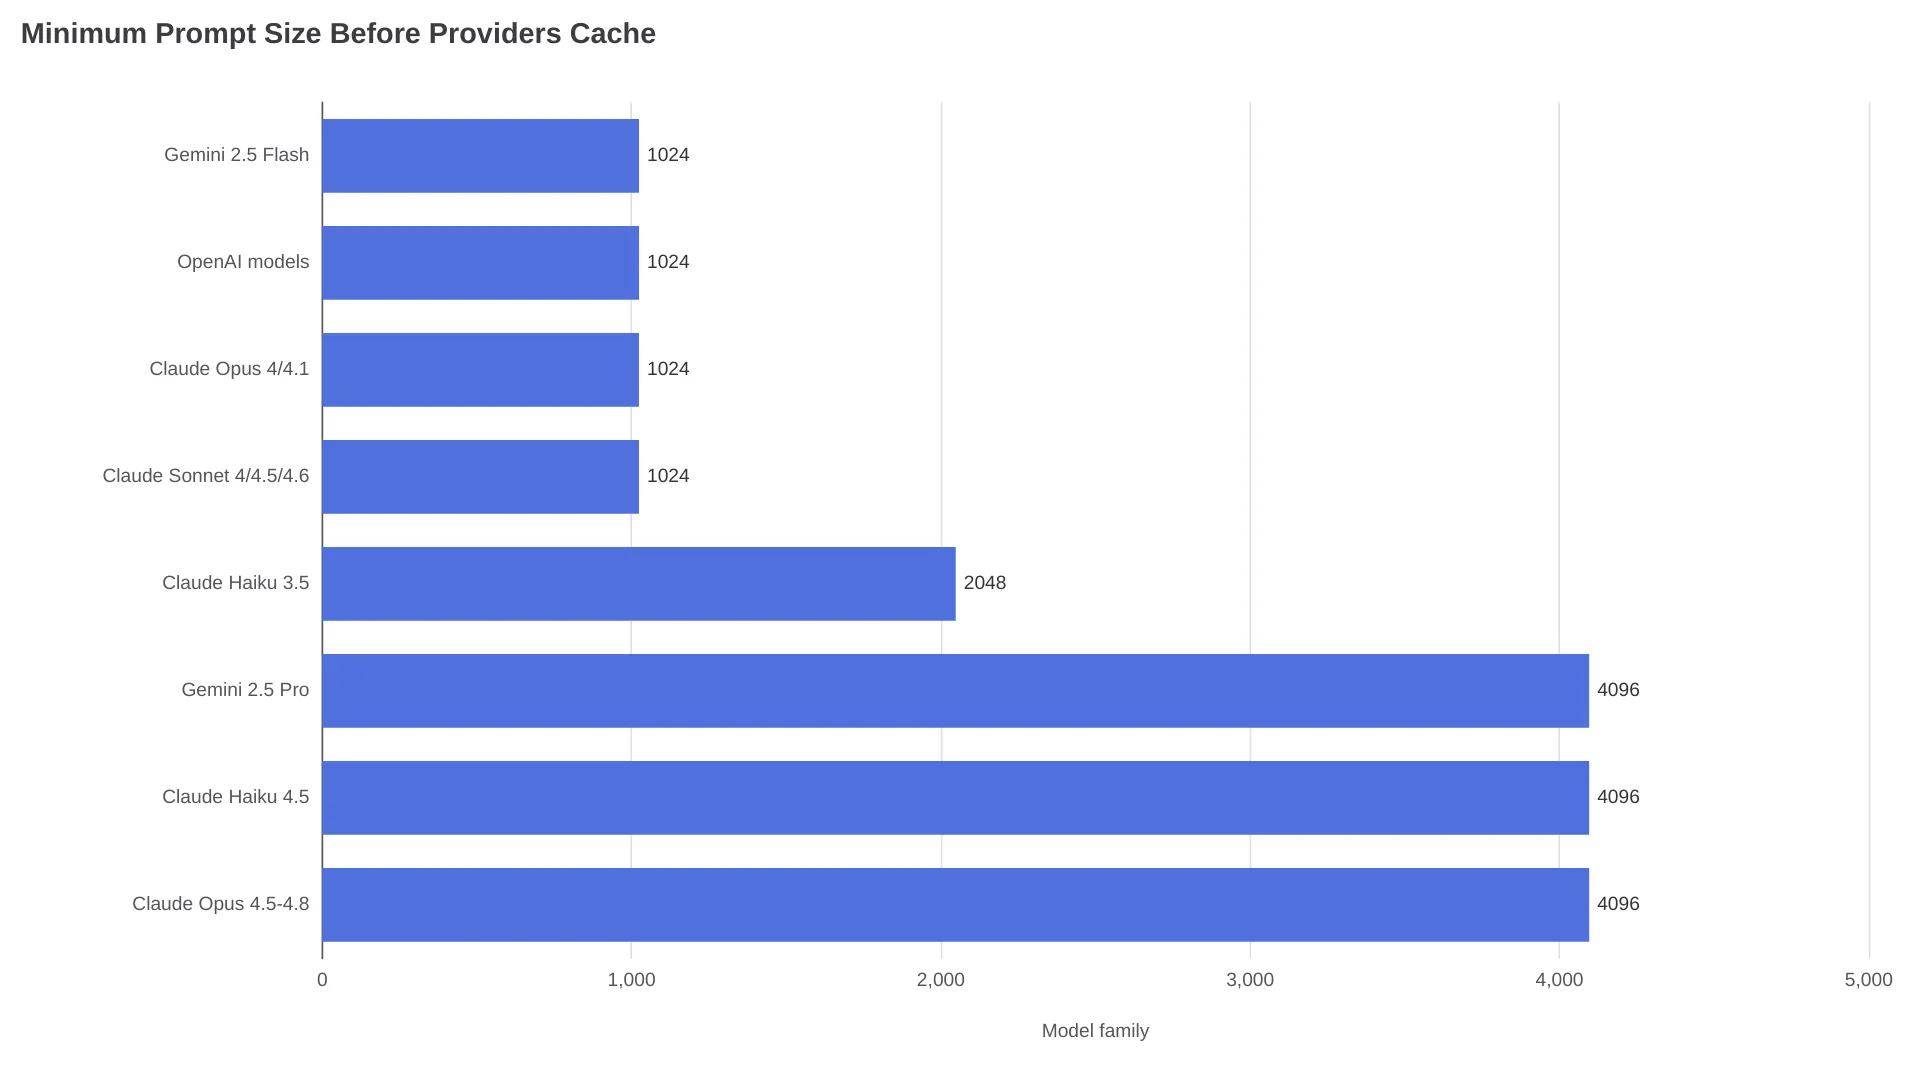
D’après les notes d’OpenRouter sur les fournisseurs, Claude Opus 4.5–4.8 exige 4 096 tokens avant de mettre quoi que ce soit en cache. Sonnet 4/4.5/4.6 et Opus 4/4.1 se contentent de 1 024 tokens. Gemini 2.5 Pro se situe à 4 096, tandis que Gemini 2.5 Flash démarre à 1 024 ; les modèles OpenAI mettent également en cache à partir de 1 024 tokens. Avec un prompt court sur Opus 4.8, la mise en cache est donc impossible par conception. Il faut soit regrouper les éléments statiques — schémas d’outils, documents de référence et exemples few-shot — dans un même préfixe, soit choisir un modèle dont le seuil est inférieur.
2. Le cache a expiré entre deux tours
Le cache Anthropic dure 5 minutes par défaut ; le TTL d’une heure entraîne une écriture facturée 2 fois. Le cache implicite de Gemini tient environ 3 à 5 minutes et, point important, les lectures ne réinitialisent pas le compteur, comme le précise le tutoriel d’OpenRouter. De son côté, la session persistante qui vous maintient chez le même fournisseur disparaît après 10 minutes d’inactivité. Les boucles d’agents qui patientent 5 à 6 minutes entre deux appels peuvent donc dépasser toutes ces fenêtres :
« OpenRouter est excellent pour tester des modèles. Pour les agents en production, c’est discrètement catastrophique. Le secret ? Dans les vrais workloads, le taux de cache est pratiquement nul. » — @ran_cohenn, à propos d’intervalles de 5 à 6 minutes entre les appels d’agents, qui font expirer l’affinité persistante et provoquent des échecs complets de cache ainsi que des écritures coûteuses
Le TTL Anthropic d’une heure, malgré son écriture facturée 2 fois, devient préférable au paiement répété d’une écriture à 1,25 fois toutes les cinq minutes, à condition que la session reprenne dans l’heure. Avec des pauses utilisateur de vingt minutes, aucun TTL disponible ne tient : la mise en cache n’aide alors qu’au sein d’une série rapprochée de tours.
3. Le préfixe a changé sans que vous vous en rendiez compte
Par défaut, OpenRouter construit la clé de conversation en calculant le hash du premier message système et du premier message qui ne l’est pas. Toute modification au début du prompt invalide donc le cache à partir de ce point. Les coupables habituels sont le contexte RAG injecté avant le prompt système, les horodatages ou identifiants de requête placés dans le premier message, les définitions d’outils réécrites à chaque appel et les applications de chat qui insèrent des messages au milieu de l’historique.
« Le taux d’échec du cache augmente dès qu’un élément au début du prompt change constamment. » — u/Exact_Law_6489
Le changement peut aussi venir d’un outil que vous ne contrôlez pas. « J’ai découvert que Claude Code provoquait des problèmes de cache chez moi ; je pense que cela vient de sa manière d’injecter les outils », explique u/askchris. Gemini ajoute deux pièges : OpenRouter n’utilise que le dernier point de rupture cache_control envoyé, et l’instruction système est considérée comme un contenu mis en cache immuable. Les éléments dynamiques doivent donc être déplacés dans un message utilisateur ultérieur, plutôt que placés après le prompt système. Dans tous les cas, la règle est la même : prompt système statique, schémas d’outils et documents de référence en tête ; variations propres à chaque requête à la fin.
4. La requête est arrivée chez un fournisseur sans cache chaud
OpenRouter répartit les requêtes entre plus de 70 fournisseurs (selon son propre tutoriel), tandis qu’un cache de prompt reste local au point d’accès qui l’a créé. Le routage persistant renvoie les requêtes suivantes vers le fournisseur déjà chaud, mais seulement lorsque les lectures de cache de celui-ci sont moins chères que ses entrées normales. Un provider.order défini manuellement annule complètement cette persistance. Une erreur du fournisseur libère également l’association.
Les données remontées par la communauté sont particulièrement parlantes :
- @bruceforai a mesuré le même nom de modèle chez différents fournisseurs et observé des taux de cache allant de 95,3 % à 0 %, certains caches tiers étant facturés 10 fois le tarif officiel.
- @Bryan_1269 a obtenu un taux très faible pour GLM 5.2 via OpenRouter, contre plus de 85 % avec le même prompt envoyé directement à Fireworks.
- @miolini, à propos du routage via OpenRouter : « Le taux de cache est vraiment mauvais, inférieur à 1 %. »
La position officielle d’OpenRouter est que l’épinglage fonctionne bien : « lorsqu’un modèle ou un fournisseur vous met en cache, vous y restez épinglé jusqu’à l’expiration du cache » (@OpenRouter). Cela correspond à la documentation et désigne donc la variation entre fournisseurs — plutôt qu’un problème d’épinglage — comme le paramètre à maîtriser.
Où placer cache_control — et ce qui peut le supprimer
Avec les modèles Anthropic sur OpenRouter, la mise en cache fonctionne de deux façons. On peut utiliser un objet cache_control unique au niveau supérieur, qui avance automatiquement à mesure que la conversation s’allonge — c’est l’approche recommandée par OpenRouter pour les conversations à plusieurs tours. On peut aussi définir des points de rupture explicites sur des blocs de contenu individuels, jusqu’à quatre, pour les gros éléments fixes comme les schémas d’outils, documents RAG, exports CSV ou fiches de personnages. La forme au niveau supérieur fonctionne avec Anthropic natif, Vertex, Azure et Bedrock ; dans ce dernier cas, OpenRouter la transforme en point de rupture final, car l’API Bedrock refuse le champ au niveau supérieur. Pour définir un TTL explicite, il faut utiliser Chat Completions ou l’API Anthropic Messages, et non Responses.
{
  "role": "system",
  "content": [
    {
      "type": "text",
      "text": "<20k tokens of tool schemas and reference docs>",
      "cache_control": { "type": "ephemeral", "ttl": "1h" }
    }
  ]
}
OpenAI fonctionne autrement : la mise en cache est automatique à partir de 1 024 tokens. Les marqueurs explicites prompt_cache_breakpoint existent uniquement sur GPT-5.6 et les versions ultérieures ; ils se placent sur un bloc input_text ou text, avec un TTL minimal de 30 minutes lorsqu’il est demandé.
OpenRouter fait la conversion entre les différents formats, comme l’expliquent ses notes sur les fournisseurs : un marqueur Anthropic cache_control devient un point de rupture OpenAI, tandis qu’un point de rupture OpenAI devient un marqueur Anthropic par défaut de 5 minutes. Les valeurs de TTL ne sont jamais transférées. Qwen exige des marqueurs cache_control explicites, conserve le cache pendant 5 minutes et ne les prend en charge que sur certains modèles (qwen3-max, qwen-plus, qwen3-coder-plus et d’autres ; les snapshots comme qwen3.5-plus-02-15 sont exclus).
Il existe une panne plus discrète : certains clients et gateways placés entre votre application et OpenRouter suppriment les champs non standard avant de transmettre la requête :
« Quand la mise en cache des prompts Anthropic tombe à zéro derrière des gateways, c’est généralement un bug de marshalling. ... Les marqueurs cache_control sont silencieusement supprimés avant d’être transmis à OpenRouter. On ne peut pas abstraire les fournisseurs en supprimant leurs extensions de schéma. » — @SiddharthInk_
Vérifiez que le marqueur arrive bien à destination : inspectez les métadonnées brutes de la requête dans le détail de la génération Activity, ou envoyez une requête de test avec curl afin qu’aucun intermédiaire ne puisse la modifier. Un outil qui aplatit les messages en un seul bloc détruit les points de rupture, même si vous les aviez placés correctement. Le dépôt d’exemples OpenRouter propose des exemples exécutables en TypeScript, avec le SDK Vercel AI et avec Effect, qui préservent ces marqueurs.
Épingler le fournisseur : session_id et ordre de routage
Une identité de session stable constitue le levier de routage le plus efficace : session_id épingle les requêtes suivantes au fournisseur qui a traité la première requête réussie, avant même qu’un hit de cache soit détecté. Sans ce paramètre, la persistance ne commence qu’après le premier hit identifié. L’identité par défaut — un hash du premier message système et du premier message non système — change silencieusement dès que le préfixe est modifié, ce qui nous ramène à la troisième cause d’échec, comme l’explique la documentation de routage d’OpenRouter.
{
  "model": "anthropic/claude-sonnet-4.6",
  "session_id": "user-8801-thread-3",
  "messages": [ ... ]
}
Quelques détails à retenir : session_id peut être transmis dans le corps de la requête ou dans l’en-tête x-session-id (la valeur du corps est prioritaire si les deux sont présents ; 256 caractères maximum). Si aucun des deux n’est fourni, OpenRouter utilise le prompt_cache_key au format OpenAI.
Deux réserves figurent dans la documentation : les erreurs du fournisseur libèrent l’épinglage, et les lignes de l’API Batch sont exécutées simultanément et dans un ordre imprévisible. Une écriture de cache effectuée par une ligne n’est donc pas forcément visible par la suivante. Vous pouvez partager un préfixe avec "ttl": "1h" entre les lots, ou le préchauffer avec une première requête synchrone. (Le guide Auto Router explique comment le routeur réutilise au mieux le modèle résolu.)
Si l’épinglage ne suffit pas, réduisez directement la liste des fournisseurs :
« La solution que j’ai trouvée consiste à définir une liste de fournisseurs préférés, utilisés dans l’ordre de préférence. » — u/nabil9506
Une liste provider.order de deux ou trois fournisseurs proposant des lectures de cache peu coûteuses sacrifie une partie de la tolérance aux pannes au profit de la localité du cache. Pour les workloads d’agents, le compromis est souvent raisonnable. u/welcome_to_milliways considère que la configuration manuelle est « un défaut assez fondamental d’OR » ; qu’on partage ou non ce jugement, c’est bien le fonctionnement actuel.
Quand passer par un routeur ne vaut plus le coup
La mise en cache via OpenRouter cesse d’être rentable dans trois cas faciles à reconnaître : les prompts qui n’atteignent jamais le seuil minimal du modèle, les sessions entrecoupées de pauses plus longues que tous les TTL disponibles et les requêtes isolées dont la majoration d’écriture n’est jamais compensée par une lecture à tarif réduit. Il faut ajouter un quatrième cas : les outils impossibles à modifier qui retirent cache_control avant que la requête n’atteigne le routeur. @grapeot rappelle l’ampleur du problème : quand le cache échoue au niveau de la gateway, l’écart de coût atteint un ordre de grandeur et dépasse largement les frais de routage.
Pour les workloads qui dépendent réellement du cache et auxquels aucun de ces correctifs ne s’applique, un fournisseur amont unique est préférable à un routeur : le comportement du cache devient déterministe et il n’y a plus d’épinglage à gérer. Un endpoint direct vers l’API Claude, avec le système de cache d’Anthropic, constitue la solution de repli la plus simple lorsque les changements de fournisseur sont impossibles à éviter.
La conservation zéro donnée au niveau du compte (Zero Data Retention) désactive entièrement le cache des réponses. Pour la mise en cache des prompts sous ZDR, consultez l’analyse d’OpenRouter sur la question de savoir si le cache implicite constitue une conservation de données.
L’ordre dans lequel corriger le problème
En commençant par les mesures, puis en remontant la chaîne du prompt vers le routage et le TTL, on récupère généralement l’essentiel des économies sans bouleverser l’architecture :
| # | Action | Ce que cela permet de trancher |
|---|---|---|
| 1 | Lire cached_tokens et cache_discount sur quelques requêtes réelles | Problème de taux de réussite ou simple mauvaise estimation tarifaire |
| 2 | Comparer la taille du prompt au seuil de tokens du modèle | Écarte d’abord le cas d’un prompt qui ne peut jamais être mis en cache |
| 3 | Figer le préfixe : prompt système statique, schémas et documents en tête ; horodatages et RAG à la fin | Élimine les invalidations silencieuses |
| 4 | Transmettre session_id à chaque requête d’une même conversation | Épinglage du fournisseur dès le premier tour, et non après le premier hit |
| 5 | Définir provider.order avec deux ou trois fournisseurs offrant des lectures de cache peu coûteuses | Supprime les changements de fournisseur imprévisibles |
| 6 | Ajouter "ttl": "1h" (Anthropic) ou choisir un fournisseur dont l’écriture est gratuite pour les longues sessions | Limite les expirations entre deux tours |
Les étapes 1 à 3 traitent les causes que vous pouvez corriger dans le code. Les étapes 4 à 6 permettent ensuite de comprendre comment les taux inférieurs à 1 % peuvent coexister avec les 82,8 % annoncés. Pour aller plus loin, consultez le guide des tarifs OpenRouter sur l’impact des tokens mis en cache sur la facture, le guide Auto Router sur l’épinglage des modèles et le guide du tableau de bord Activity pour suivre l’évolution des taux de réussite.