 AIREITER
Le 17 août 2026, OpenRouter a révélé qu’un de ses propres modèles en préversion lui coûtait discrètement environ 6,2 K$ par mois : près de 25 fois le tarif moyen pondéré de l’organisation. 98 % de la dépense remontaient à une seule clé API utilisée par un pipeline batch. Lancé le même jour, le tableau de bord Activity vise précisément à faire émerger ce type d’erreur en quelques minutes plutôt qu’après plusieurs mois. Sa partie interface est déjà très convaincante : dépenses, tokens, taux de cache hit et détails requête par requête sont réunis au même endroit. L’API Analytics bêta qui l’alimente est plus rugueuse ; voici où se situent ses limites.
La leçon à 6,2 K$ que détecte Activity
L’étude de cas interne publiée avec le lancement illustre exactement le problème que ces outils cherchent à résoudre. Un modèle preview avait englouti 6 185 $ pour 250 M de tokens en un mois, soit environ 24,7 $ par million de tokens, avec un taux de cache hit de 7,6 %. Le détail par clé API a ensuite isolé batch-pipeline : 6 067 $ sur 127 M de tokens et 37 000 requêtes. Cela représente environ 48 $/Mtok pour un traitement batch à fort volume et faible complexité. La correction tenait en un changement de modèle sur une ligne de code (détail complet dans le cookbook de contrôle des coûts).
Le lancement comprend aussi Explore pour les requêtes personnalisées, Trends pour détecter les variations, Guardrails pour les événements d’injection de prompt et de données sensibles, les journaux au niveau des requêtes, l’API Analytics bêta et une skill openrouter-analytics installable depuis GitHub pour les agents de code.
À quoi sert chaque onglet d’Activity ?
Le tableau de bord OpenRouter Activity est pensé autour des questions à se poser, pas autour d’une simple arborescence de menus. Trois onglets concentrent l’essentiel du suivi des coûts, chacun avec son propre rôle.
Overview : combien dépense-t-on ?
Overview affiche d’emblée cinq indicateurs : dépense totale, nombre de requêtes, volume de tokens, taux de cache hit et coût moyen pondéré par million de tokens. Chacun est accompagné d’un sparkline et d’une comparaison avec la période précédente. Plus bas, on trouve les principaux utilisateurs et applications, les dépenses par modèle, la répartition entre crédits OpenRouter et dépenses BYOK estimées, ainsi que les volumes de tokens de prompt et de complétion. C’est l’onglet à garder ouvert lorsque la question porte avant tout sur le montant.
Trends : qu’est-ce qui a changé ?
Trends classe les évolutions plutôt que les volumes absolus, par modèle, utilisateur, clé API et application. Il sert à repérer un agent qui s’emballe, un modèle soudainement très adopté ou un outil interne passé sans transition du statut d’expérience à celui de choix par défaut. Overview vous dit qu’un élément coûte cher ; Trends vous montre qu’il vient de le devenir.
Explore : comment découper les données à ma façon ?
Explore est le constructeur de requêtes. Les métriques disponibles couvrent les dépenses, les requêtes, plusieurs catégories de tokens, le taux de cache hit, le coût moyen par million, la part BYOK face aux crédits, ainsi que la latence et le débit P50/P90/P99.
Le regroupement est limité à deux dimensions simultanées, à choisir parmi le modèle, le fournisseur, la clé API, l’application, l’utilisateur, l’espace de travail, le pays, la région, la longueur de contexte, la session, la génération, les identifiants personnalisés et les classifieurs. La granularité temporelle va de la minute au mois ; les graphiques peuvent être en barres, en lignes ou en points, et peuvent être enregistrés en privé ou partagés à l’échelle de l’organisation. Deux réserves : une troisième dimension de regroupement est refusée sans nuance, et le contenu des prompts et complétions dans les logs n’apparaît que si la journalisation privée des entrées/sorties était activée avant l’exécution de la requête.
Exporter en CSV ou PDF, sans passer par l’API
Ni les équipes comptables ni les tableurs n’ont besoin de l’API. La page Activity permet d’exporter les mêmes données agrégées sous forme de rapports synthétiques ou détaillés, dans deux formats et sans code. Le processus d’export officiel se résume à cinq étapes :
- Ouvrez la page Activity.
- Choisissez une période et un regroupement : modèle, clé API ou créateur.
- Ouvrez le menu d’options dans le coin supérieur droit.
- Sélectionnez Export to….
- Choisissez CSV ou PDF.
L’export par défaut est un résumé combinant dépenses, tokens et requêtes. Pour obtenir un rapport détaillé, ouvrez d’abord la carte correspondant à une métrique précise, puis lancez l’export : la version détaillée ventile alors cette métrique selon le regroupement choisi. Le choix de période détermine automatiquement le sous-intervalle :
| Filtre temporel | Sous-intervalle |
|---|---|
| 1 heure | par minute |
| 1 jour | par heure |
| 1 mois | par jour |
| 1 an | par mois |
Deux précisions importantes dans la documentation : les dépenses BYOK figurant dans ces rapports sont une estimation basée sur les tarifs publics des fournisseurs. Elles peuvent différer de votre facture externe réelle, car les remises propres à chaque fournisseur ne sont pas prises en compte. Les tokens de raisonnement sont facturés au sein des tokens de complétion, mais affichés séparément : la part consacrée à la « réflexion » reste donc visible sans être comptée deux fois.
Votre première requête Analytics API en cinq minutes
L’API Analytics expose les mêmes données qu’Explore via deux endpoints. Elle est explicitement en bêta : mieux vaut donc commencer par découvrir ce qu’elle accepte, avant de lancer vos requêtes.
La clé de gestion est obligatoire
Les endpoints Analytics nécessitent une clé de gestion ; une clé d’inférence standard reçoit une réponse HTTP 403. L’inverse est également vrai, selon le cookbook de contrôle des coûts : les clés de gestion ne peuvent pas envoyer de requêtes aux modèles. Cela réduit le rayon d’impact en cas de fuite, même si la clé donne toujours accès au détail complet des dépenses de l’organisation. Le conseil du cookbook est sans détour : traitez-la comme n’importe quel autre secret d’accès.
Commencez par meta, puis interrogez les données
GET /api/v1/analytics/meta renvoie les métriques, dimensions, opérateurs de filtre et granularités actuellement pris en charge. Interrogez-le avant chaque exécution automatisée, car le périmètre de cette API bêta évolue. L’endpoint de requête proprement dit est POST /api/v1/analytics/query. Voici l’exemple cURL documenté :
curl -X POST https://openrouter.ai/api/v1/analytics/query \
  -H "Authorization: Bearer <management-key>" \
  -H "Content-Type: application/json" \
  -d '{
    "metrics": ["request_count"],
    "dimensions": ["model"],
    "granularity": "day",
    "limit": 100,
    "time_range": {
      "start": "2026-08-01T00:00:00Z",
      "end": "2026-08-08T00:00:00Z"
    }
  }'
Les réponses placent les lignes sous data.data et ajoutent un bloc metadata contenant query_time_ms, row_count et truncated. Le cookbook donne des exemples à 17 ms pour une seule ligne : les appels sont donc peu coûteux, et le flux est décrit comme en lecture seule et gratuit en dehors de vos frais d’utilisation existants. Les erreurs documentées sont 400 pour une requête invalide, 401 sans authentification, 403 avec un mauvais type de clé, 408 et 500.
Quatre requêtes pour débusquer les surcoûts
Le cookbook officiel propose cinq recettes. Organisées en séquence, elles forment une méthode reproductible pour remonter à l’origine d’une dépense excessive.
1. Quel modèle consomme le plus ? La première requête du cookbook demande total_usage, request_count, tokens_total et cache_hit_rate, regroupés par model et triés par dépense :
{
  "metrics": ["total_usage", "request_count", "tokens_total", "cache_hit_rate"],
  "dimensions": ["model"],
  "order_by": { "metric": "total_usage", "direction": "desc" },
  "limit": 10,
  "time_range": { "start": "2026-07-01T00:00:00Z", "end": "2026-08-01T00:00:00Z" }
}
Le chiffre le plus utile à en tirer est le coût effectif par million de tokens : total_usage / tokens_total × 1e6. Comparez-le à votre tarif moyen pondéré, calculé avec la même formule mais sans dimensions. L’heuristique du cookbook est simple : un modèle dont le tarif dépasse largement ce taux moyen est le meilleur candidat à examiner. C’est ainsi que l’anomalie du modèle preview à 25x a été mise au jour.
2. Quelle clé API en est responsable ? Ajoutez un filtre sur le slug exact du modèle, puis regroupez par api_key_id. Les résultats résolvent les noms en libellés lisibles, ce qui a permis d’identifier batch-pipeline comme source de 6 067 $ sur les 6 185 $ du problème. Regroupez par api_key_id, plutôt que de filtrer sur les noms de clés résolus, et utilisez le user_email renvoyé pour rapprocher les dépenses de vos registres internes.
3. Qu’a réellement acheté cette dépense ? Ventilez les dépenses quotidiennes en composantes :
| Métrique | Signification |
|---|---|
usage_upstream | coût brut d’inférence |
usage_cache | économies de cache, ou coût d’écriture dans le cache |
usage_data | remises, généralement négatives |
usage_web | surcoût de recherche web |
usage_file | surcoût de traitement de fichiers |
Un ratio prompt/complétion proche de 20:1 signale un contexte démesuré, tandis qu’une forte part de tokens de raisonnement indique que vous payez peut-être pour une réflexion superflue. Le meilleur candidat pour optimiser le cache est un trafic riche en prompts avec un faible taux de cache hit ; si ce taux est déjà élevé, examinez plutôt le mix de modèles. Les prompts lourds sont la norme, pas une anomalie : une analyse des données publiques d’OpenRouter dans la catégorie programmation a mesuré que 93,4 % de ces tokens étaient des entrées.
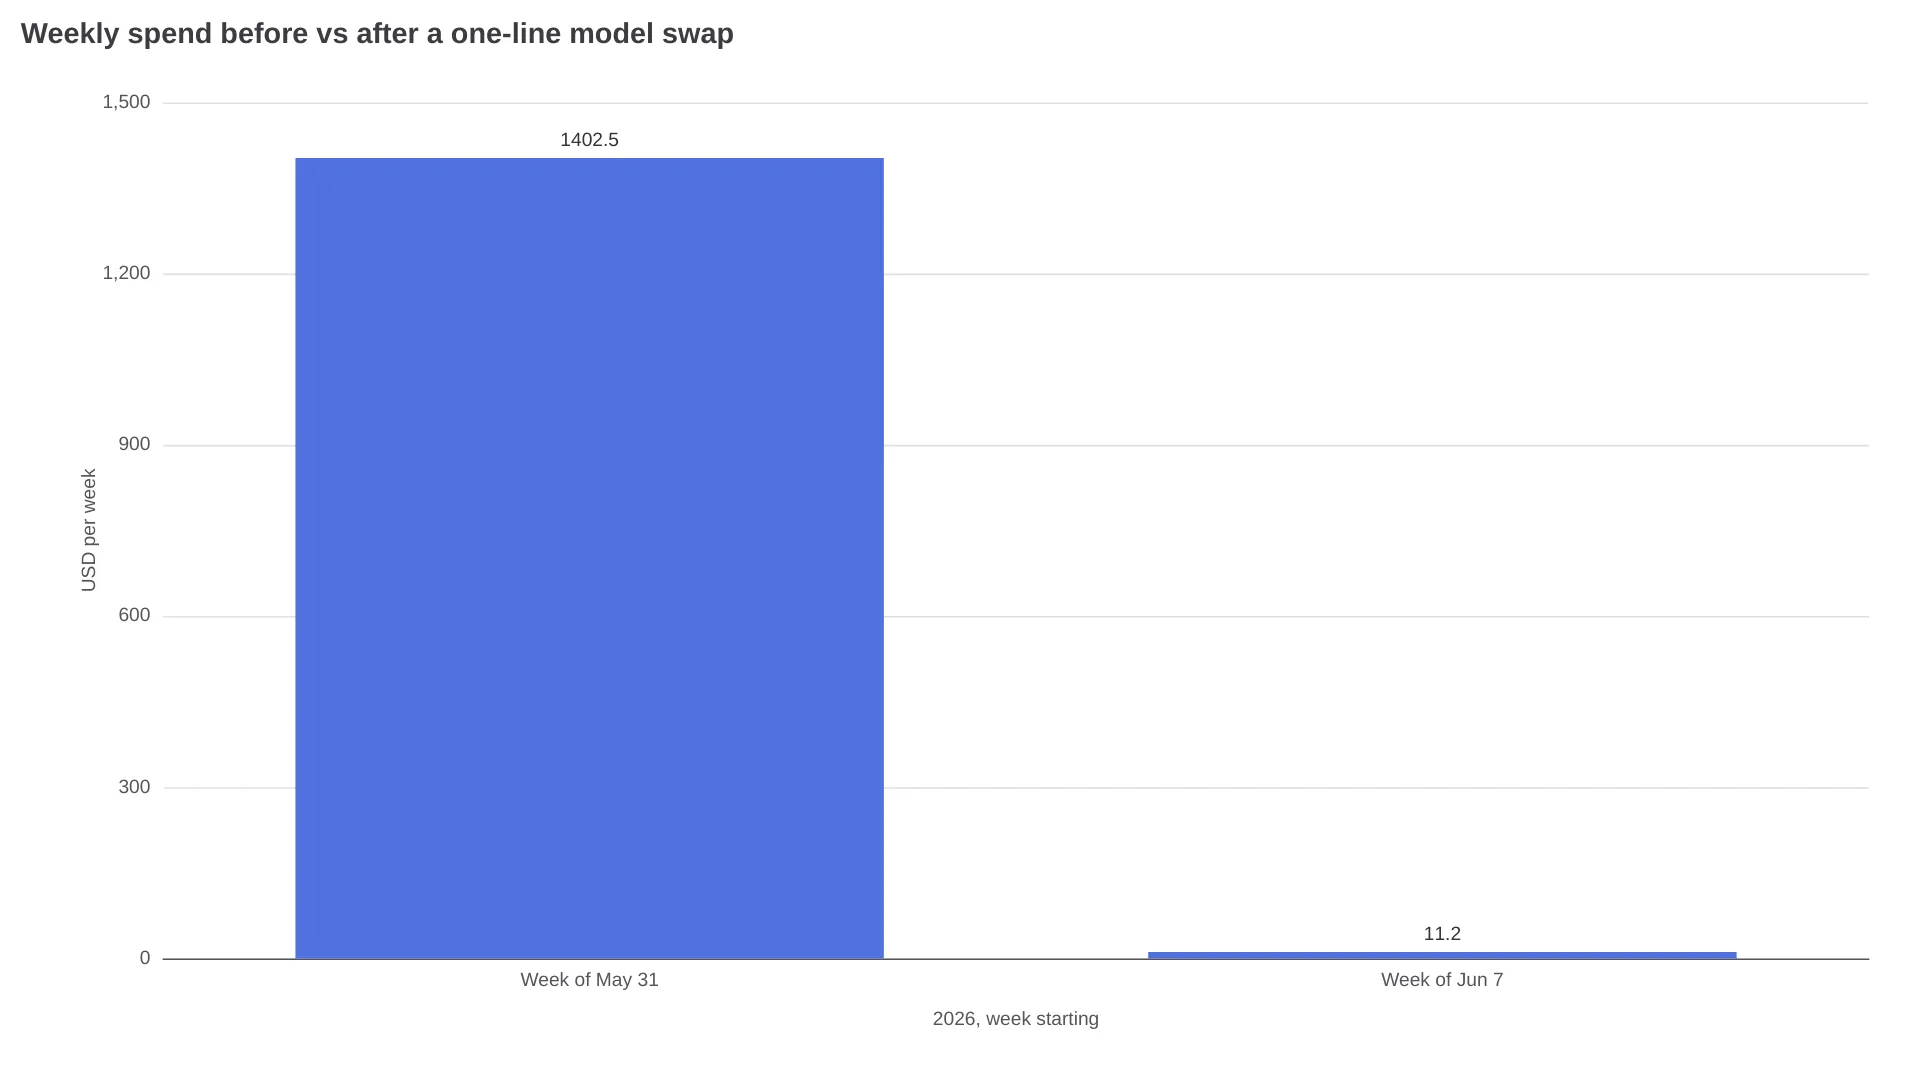
4. La correction a-t-elle vraiment fonctionné ? Relancez la requête 1 sous forme de série hebdomadaire, regroupée par api_key_id. Dans l’exemple officiel, la clé batch-pipeline est passée de 1 402,50 $ pour la semaine du 31 mai à 11,20 $ pour celle du 7 juin. Quand un changement de modèle produit l’effet attendu, la courbe chute comme une falaise, pas comme une pente.
Si l’étape suivante consiste à migrer vers un modèle moins cher, la couche de routage d’OpenRouter est l’endroit où cette décision s’applique. Notre guide de l’auto-router OpenRouter détaille les compromis entre routage automatique et routage épinglé.
Six pièges de la bêta que la référence n’explicite pas
L’API fonctionne conformément à la documentation une fois la requête correcte. Les cas d’échec ci-dessous y sont eux aussi évoqués, mais dispersés dans les notes de bas de page du cookbook.
- Trois dimensions renvoient une erreur 400. La limite est fixée à deux ;
model × key × dayimpose donc plusieurs requêtes ou une granularité temporelle. group_limitpeut tronquer silencieusement des tranches temporelles. Laissez-le vide pour qu’OpenRouter calcule une valeur sûre ; réglez-le trop bas et des semaines disparaissent de la série. Il est totalement ignoré lorsqu’aucune dimension n’est fournie.- Les métriques de comptage arrivent parfois sous forme de chaînes. La référence affiche des nombres, mais l’API peut renvoyer des chaînes : votre parseur doit accepter les deux.
- Les noms de colonnes des séries temporelles sont ambigus. Un même bucket apparaît sous
date__dayoucreated_at__day, selon la forme de la requête. - Les composantes de coût inutilisées renvoient
null, pas zéro. Toute agrégation automatisée doit donc prévoir une vérification de valeur nulle. metadata.truncated: truesignifie que vos totaux sont incomplets. Augmentezlimit, fixé par défaut à 1 000, ou réduisez la période avant de relancer la requête.
Tableau de bord, API ou pipeline maison ?
Les outils natifs répondent aux questions au niveau du compte. L’auto-hébergement ne devient pertinent qu’au-delà :
| Votre besoin | Solution |
|---|---|
| Dépenses, tokens et taux de cache en un coup d’œil | Activity Overview |
| Comprendre les changements et les pics | Trends |
| Analyse ponctuelle et partage | Explore + export CSV/PDF |
| Rapports planifiés, alertes et tableaux internes | Analytics API |
| Agrégation multi-fournisseurs, budgets par utilisateur, détection d’anomalies personnalisée | Un pipeline sur mesure basé sur les logs d’usage et les webhooks |
La voie de l’auto-hébergement est déjà bien balisée. Un participant de r/FinOps résume ainsi son expérience :
« J’ai construit mon propre suivi des coûts IA dans Obsidian parce que le prix d’un modèle est passé de quelques centimes à 3 € du jour au lendemain. »
Ce fil et la discussion r/openrouter « Long context pricing should be more transparent » ont une même origine : les estimations locales divergent des montants facturés à cause du routage, du cache, des tokens de raisonnement et de la tarification des longs contextes. L’usage enregistré dans le tableau de bord Activity fait foi ; si vous hébergez votre propre suivi, rapprochez-le de cette référence plutôt que de votre seule grille tarifaire.
Une astuce d’attribution plus légère, partagée par un développeur ayant six mois d’expérience sur la plateforme : étiquetez les requêtes avec des en-têtes X-Title. Chaque application ou expérience apparaît alors sous son propre nom dans Activity. Et si vos dépenses sont déjà réparties entre plusieurs fournisseurs plutôt que concentrées chez un routeur, une configuration d’API unifiée, dont AIReiter, simplifie le problème d’agrégation dès le départ.
FAQ
Une clé de gestion est-elle nécessaire pour le tableau de bord Activity ?
Non. Le tableau de bord est accessible depuis l’interface avec votre connexion de compte habituelle ; la clé de gestion n’est requise que pour les endpoints de l’API Analytics, /api/v1/analytics/meta et /api/v1/analytics/query.
Les appels à l’API OpenRouter Analytics sont-ils gratuits ?
Le cookbook présente le flux Analytics comme gratuit et en lecture seule : vous interrogez vos propres données d’usage, sans payer chaque appel. Vous réglez toujours, en revanche, l’inférence décrite par ces données.
Jusqu’à quand remontent les données Activity d’OpenRouter ?
L’ancien endpoint /api/v1/activity couvre les 30 derniers jours UTC terminés. La documentation de la nouvelle API Analytics ne précise pas de limite de conservation, même si ses exemples de requêtes portent sur un mois. Considérez donc l’historique à long terme comme non garanti et exportez des CSV pour toute donnée que vous devez conserver.
Pourquoi mes logs Activity n’affichent-ils pas les prompts et les réponses ?
Le détail des prompts et des complétions n’existe que pour les requêtes dont la journalisation privée des entrées/sorties était activée au moment de leur exécution. L’annonce l’indique explicitement : sans cette option, le contenu historique des prompts n’est pas disponible. Les totaux d’usage sont enregistrés ; le contenu, lui, nécessite une activation préalable.
Le compromis à intégrer au calcul
Tout ce qui précède est exploitable dès aujourd’hui, et la seule requête 1 justifie l’installation de cinq minutes. Le risque ouvert reste l’évolution de l’API : elle porte le label bêta, ses métriques et dimensions prises en charge peuvent changer, et OpenRouter demande lui-même aux automatisations de relire /meta avant de se fier à un schéma. Protégez vos tâches cron par une vérification de meta plutôt que par des noms de champs codés en dur : la visibilité du tableau de bord résistera alors à l’adolescence de l’API.
À lire aussi : Guide de l’auto-router OpenRouter · Meilleurs modèles OpenRouter gratuits pour programmer · Guide des tarifs OpenRouter