 AIREITER
MuseTalk tient sur le GPU d'un ordinateur portable équipé de 4 Go de VRAM : le README officiel indique qu'une RTX 3050 Ti Laptop en FP16 met environ cinq minutes pour traiter un clip de huit secondes. Toute la question est là : faire tourner MuseTalk est une chose, obtenir un débit réellement exploitable en est une autre. La différence se retrouve dans la résolution, l'installation et le tableau des coûts ci-dessous.
Ce que MuseTalk modifie dans vos vidéos — et ce qu'il laisse intact
MuseTalk redessine la bouche et le bas du visage dans une vidéo existante afin de synchroniser les lèvres avec une piste audio fournie. La position de la tête, les mouvements des yeux, les expressions, l'arrière-plan et les mouvements de caméra proviennent toujours de la vidéo source. On parle donc d'une retouche locale, pas d'un générateur de talking head : il faut déjà disposer d'une séquence où le visage est clairement visible.
Cette rapidité vient de son architecture. Le dépôt, publié par le Lyra Lab de Tencent Music, encode le visage masqué avec le VAE gelé sd-vae-ft-mse, extrait les caractéristiques audio avec un modèle Whisper-tiny également gelé, puis fusionne les deux via une cross-attention dans un UNet issu de Stable Diffusion v1.4. Le modèle effectue un inpainting en espace latent en une seule étape, plutôt qu'une boucle itérative de débruitage. C'est ce qui permet aux auteurs d'annoncer 30 images par seconde ou davantage sur une NVIDIA Tesla V100.
Ce que représente la zone faciale de 256x256 sur une vidéo source en 1080p
Les 256x256 correspondent à la taille de la zone du visage retouchée, pas à la résolution finale. Votre vidéo 1080p reste en 1080p et conserve sa cadence d'origine ; seule une zone de 256x256 est régénérée avant d'être fondue autour de la bouche. Plus le visage est petit dans l'image, plus le résultat a de chances de rester convaincant. En gros plan, en revanche, le manque de netteté devient visible à côté du reste du visage.
Deux solutions permettent de limiter le problème, avec un coût dans les deux cas. Supprimer --use_float16 améliore la qualité, mais demande davantage de VRAM et allonge les temps de traitement. Passer la vidéo finale dans GFPGAN ou CodeFormer pour restaurer le visage renforce la netteté de la bouche, au prix d'une étape supplémentaire et d'une légère modification de l'apparence du sujet.
La qualité en chiffres : les points forts de MuseTalk et l'avantage persistant de Wav2Lip
L'avantage mis en avant par MuseTalk concerne la qualité d'image davantage que la précision brute de la synchronisation. Sur le jeu de données HDTF, le rapport technique de MuseTalk lui attribue un FID de 6.43, contre 7.27 pour DI-Net, 10.93 pour VideoRetalking et 11.21 pour Wav2Lip.
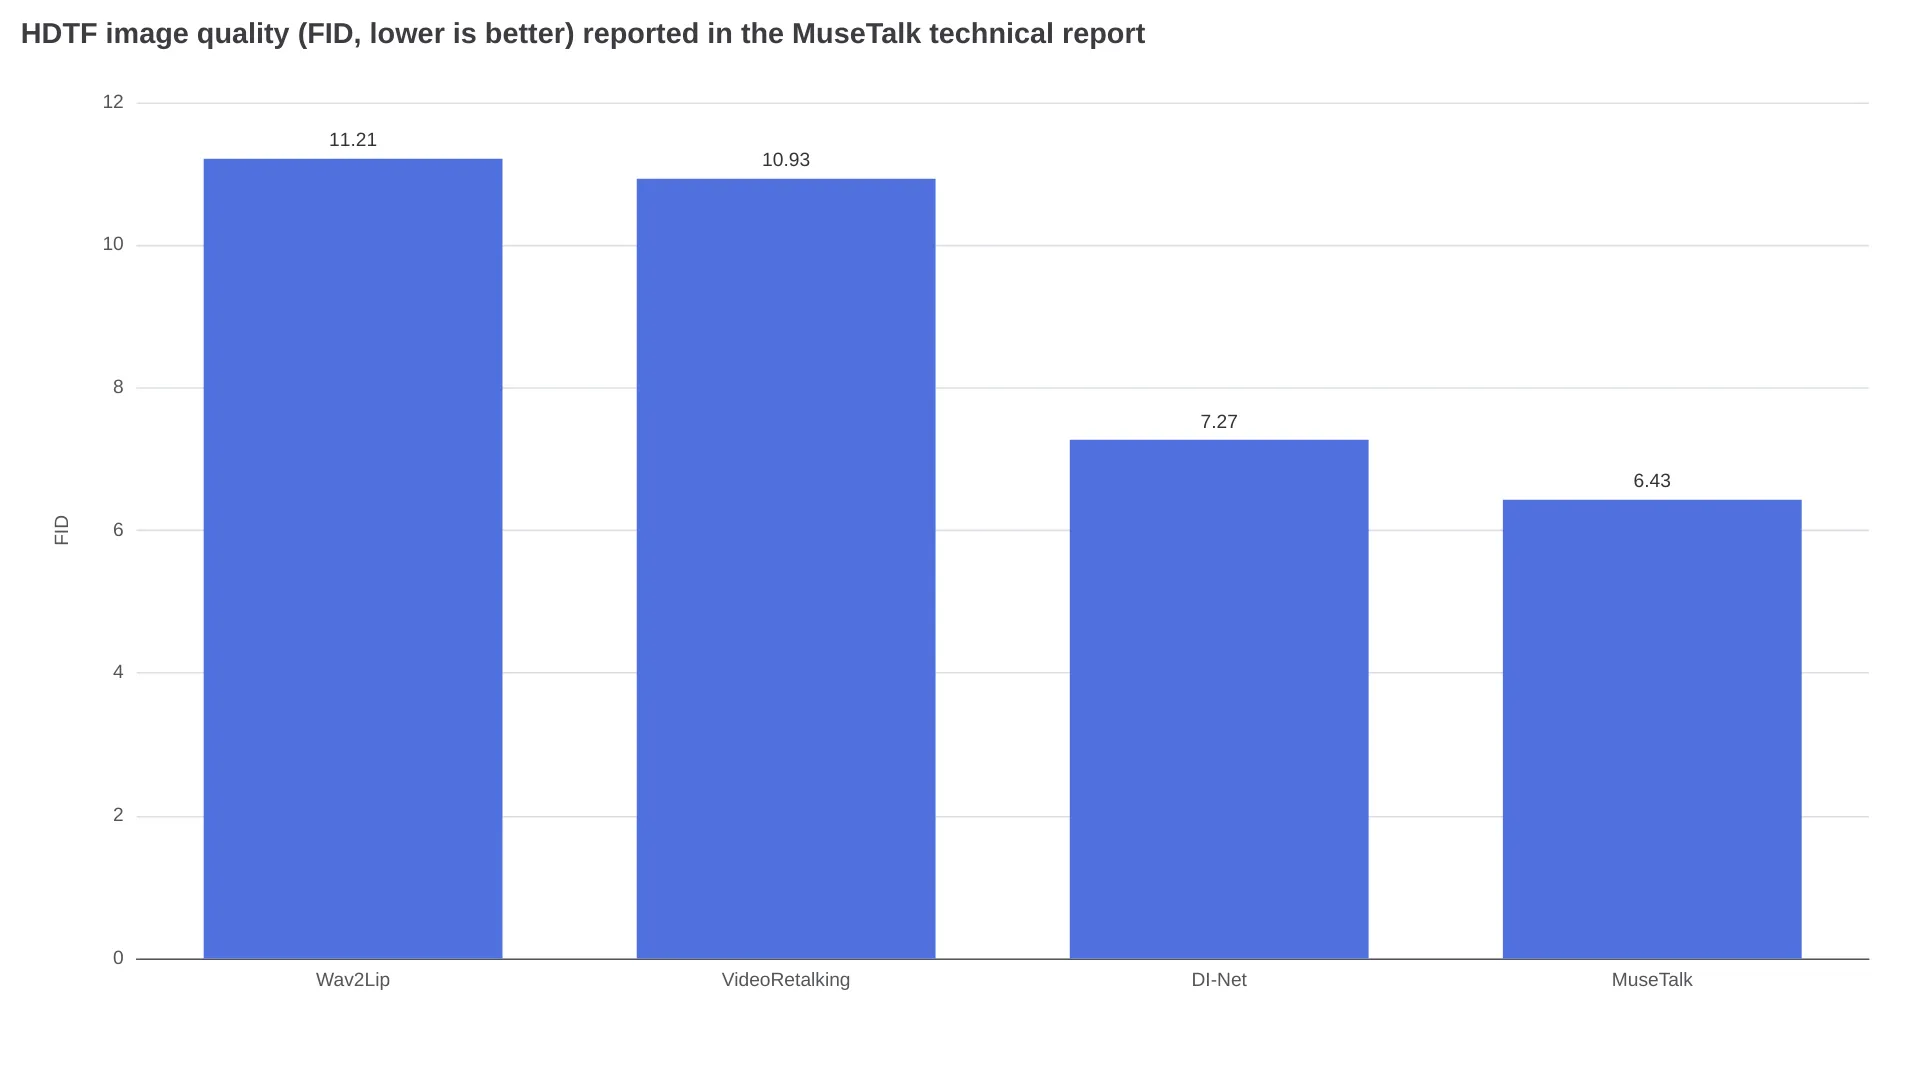
Sur la métrique de synchronisation, le classement s'inverse. Le même rapport donne un LSE-C de 7.46 à Wav2Lip, contre 6.53 pour MuseTalk. Ce dernier prend toutefois l'avantage sur la similarité d'identité, avec un CSIM de 0.8225 contre 0.8184. En clair : le vieux modèle GAN suit mieux les mouvements des lèvres, tandis que MuseTalk préserve mieux la qualité visuelle. L'étude utilisateur du rapport reste assez mesurée pour l'ensemble des modèles : 3.62 sur 5 en qualité visuelle, 3.55 pour l'identité et 3.41 pour la synchronisation labiale.
À la lumière de cette limite de 256x256, ces chiffres décrivent un modèle convaincant en plan moyen, mais moins à l'aise dès qu'il faut tenir un gros plan en 4K.
Combien coûte une minute de lip sync ?
C'est ici que l'open source devient particulièrement intéressant. Les tarifs publiés des modèles de lip sync hébergés vont de 1,50 $ à presque 8,00 $ par minute de sortie.
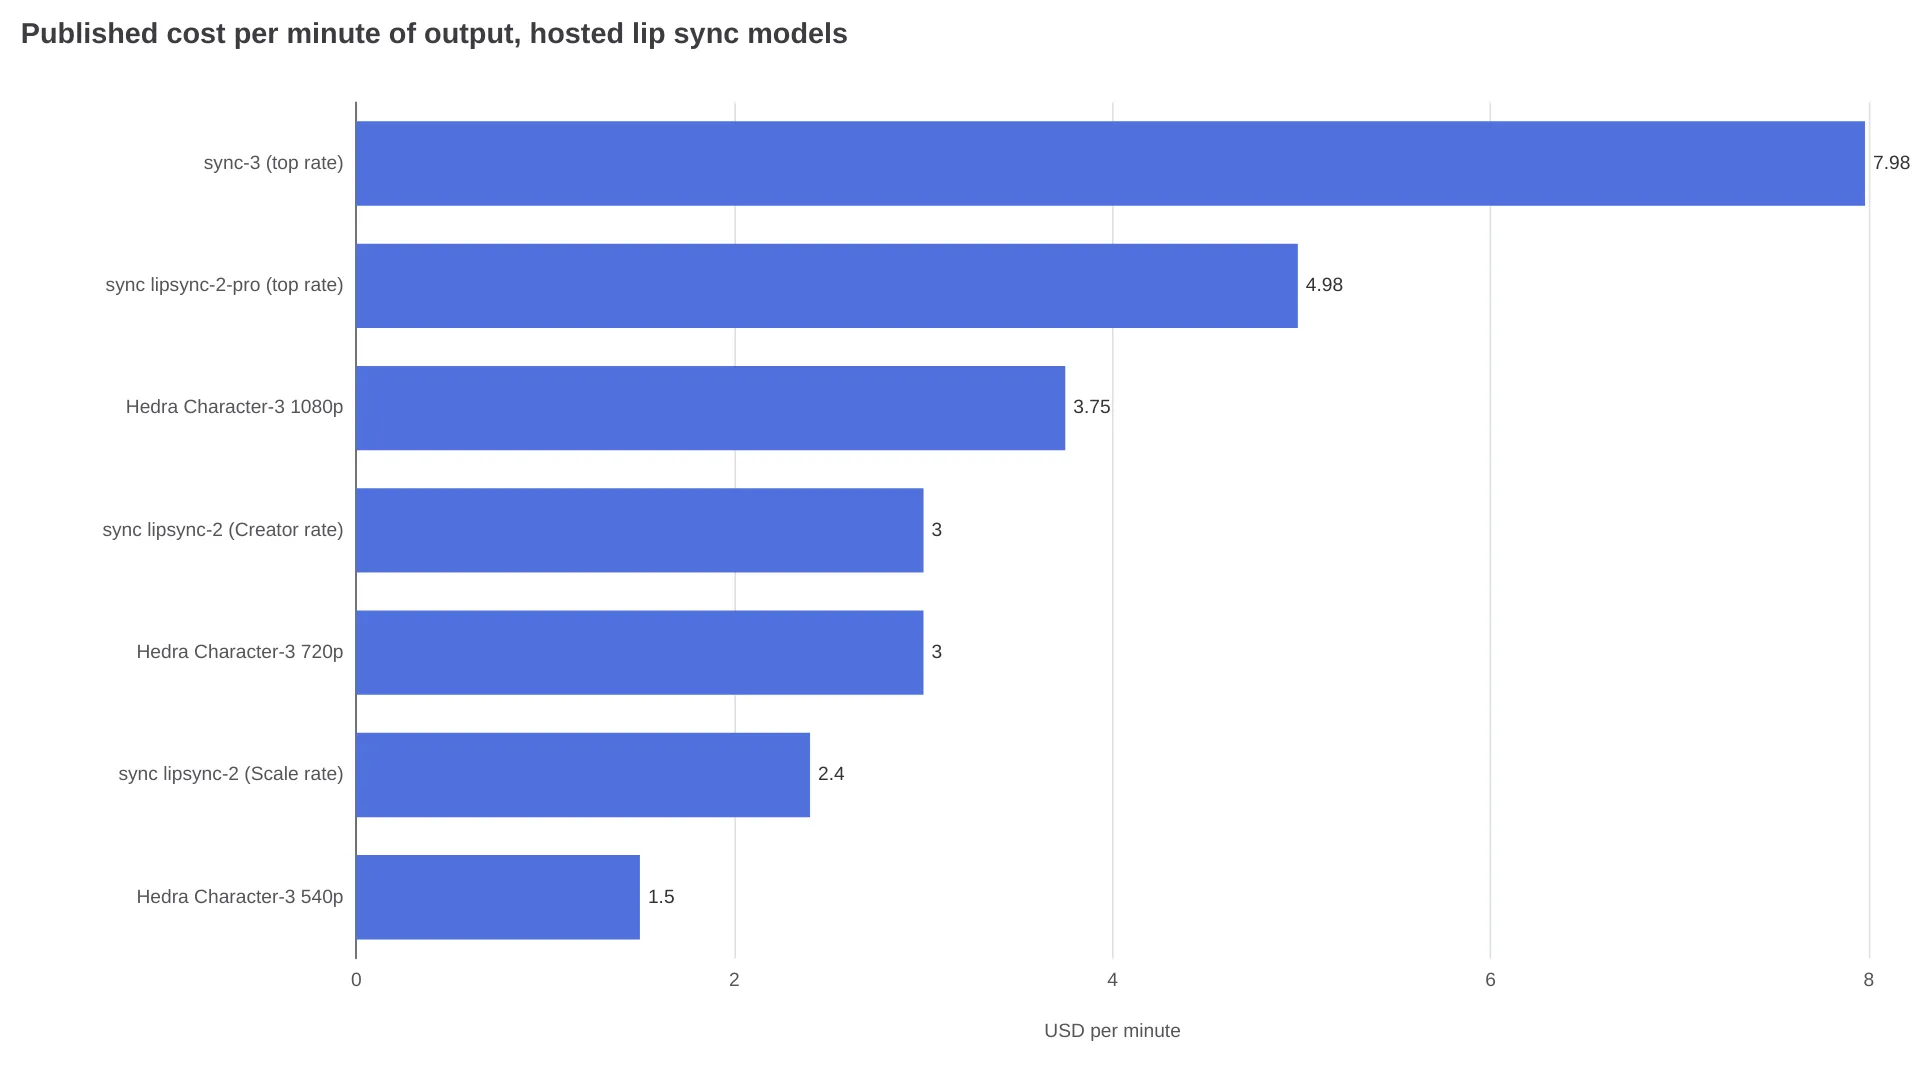
| Solution | Tarif publié (unités de facturation différentes) | Par minute de sortie | Résolution du visage |
|---|---|---|---|
| MuseTalk auto-hébergé, location d'une Tesla V100 | 0,188 $ / heure GPU | ~0,006 $ pour 2 minutes GPU par minute de clip | 256x256 |
| MuseTalk sur Replicate | ~0,052 $ / exécution, 54 s d'exécution typiques selon la page du modèle | Facturé à l'exécution, pas à la minute | 256x256 |
| MuseTalk sur fal.ai | Facturé à la seconde de calcul | Non publié sur la page du modèle | 256x256 |
| Hedra Character-3 540p / 720p / 1080p — image-to-video, pas une solution directe pour une vidéo existante | 2,5 ¢ / 5 ¢ / 6,25 ¢ par seconde | 1,50 $ / 3,00 $ / 3,75 $ | n/a |
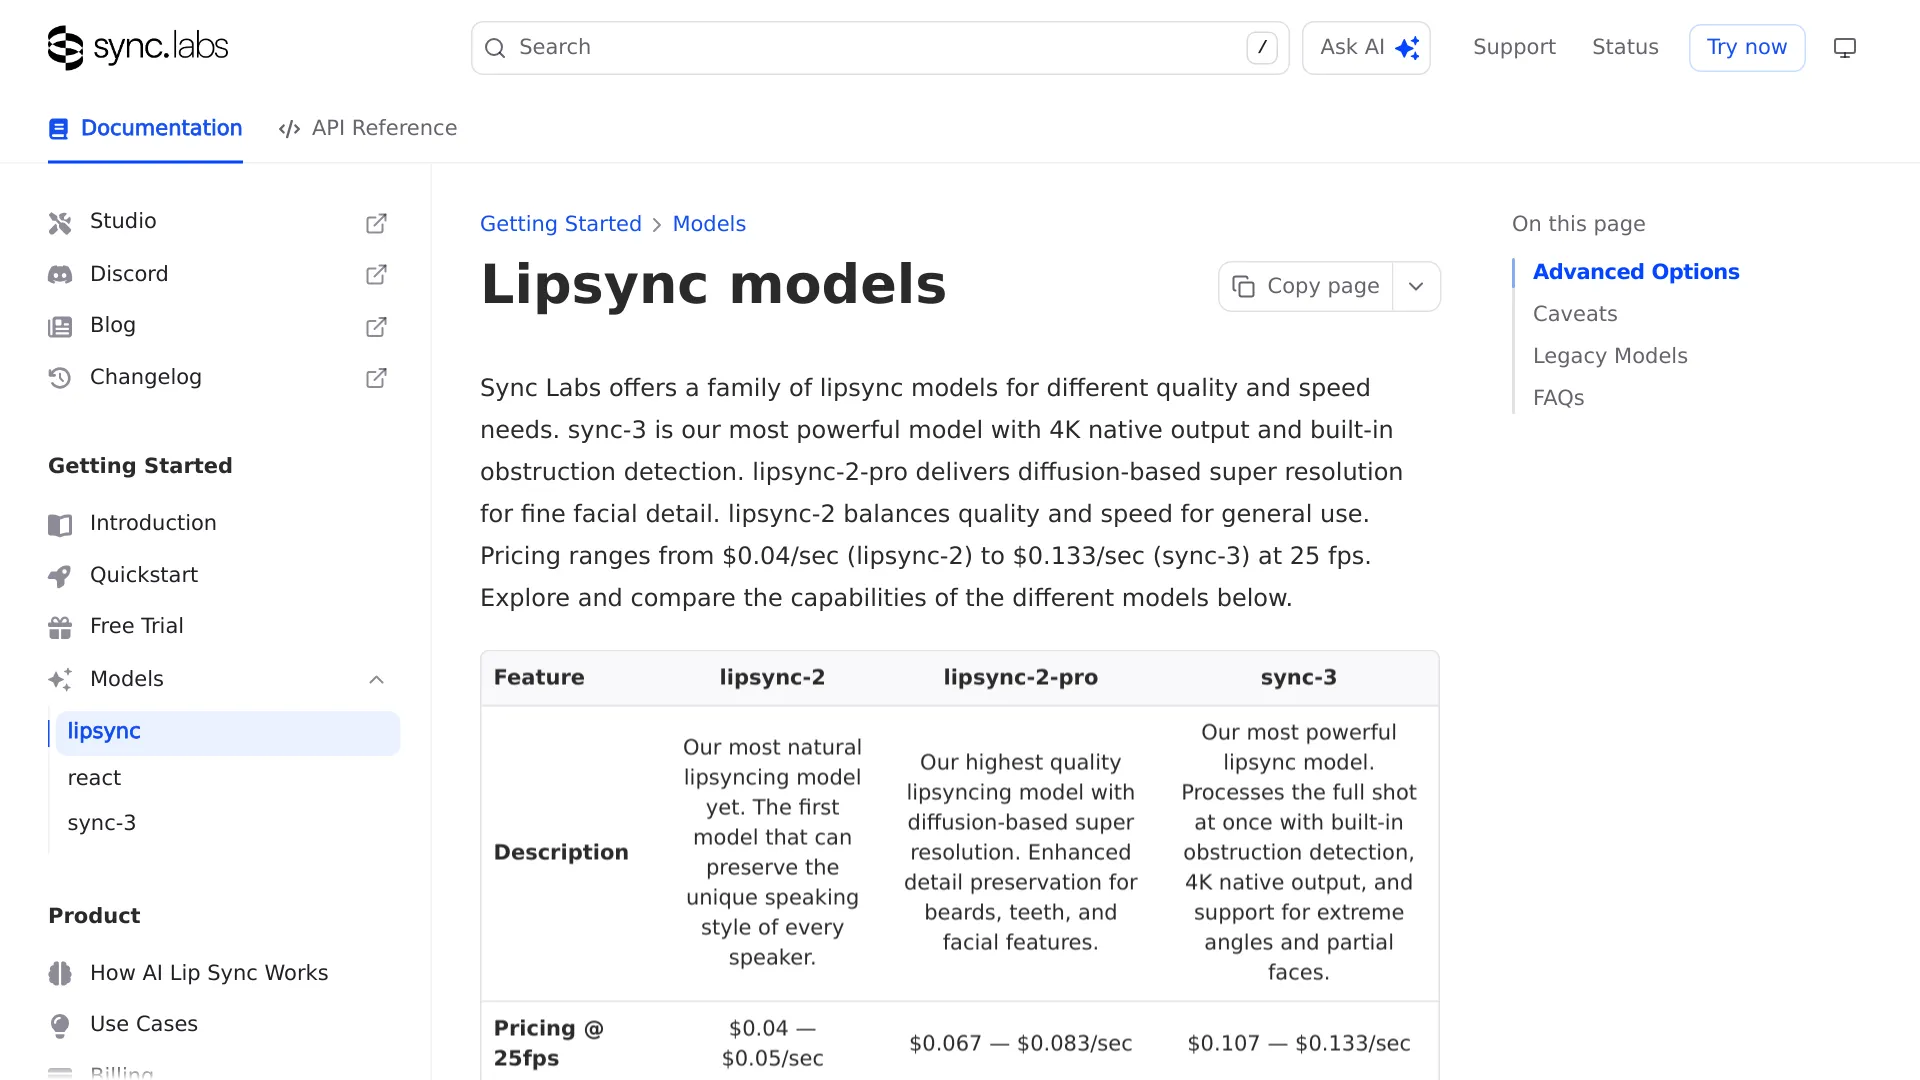
| sync lipsync-2 | 0,04–0,05 $ / s à 25 i/s | 2,40–3,00 $ | 512x512 |
| sync lipsync-2-pro | 0,067–0,083 $ / s | 4,02–4,98 $ | 512x512 + passe de détail |
| sync-3 | 0,107–0,133 $ / s | 6,42–7,98 $ | 4K natif |
Le chiffre de l'auto-hébergement vient de l'analyse des coûts publiée par NexGPU, qui prévoit deux minutes de temps GPU de bout en bout pour chaque minute de vidéo : inférence, détection DWPose, encodage/décodage du VAE et multiplexage FFmpeg. Cent clips d'une minute reviennent à environ 0,63 $ de calcul sur une V100 facturée 0,188 $/heure, auxquels s'ajoutent environ 0,09 $ de temps de préparation. Il s'agit uniquement de coûts de location GPU : le temps d'ingénierie, le stockage et les frais d'exploitation ne sont pas compris.
Sur un projet de localisation, l'écart devient vite impossible à ignorer. Cinq cents minutes de vidéo doublée représentent environ 3 $ de location GPU avec MuseTalk auto-hébergé, contre 1 200 $ avec sync lipsync-2 au tarif Creator.
Quand la solution gratuite cesse de l'être
Le supplément payé à la minute finance des avantages très concrets :
- La résolution de génération du visage. D'après la documentation des modèles sync, lipsync-2 et lipsync-2-pro génèrent les visages en 512x512, soit le double de la zone utilisée par MuseTalk ; sync-3 produit directement du 4K avec une super-résolution intégrée.
- Les plans difficiles. La même documentation indique que sync-3 gère nativement les profils, les plans par-dessus l'épaule et les visages partiellement visibles, tout en détectant automatiquement les obstructions. MuseTalk effectue une détection du visage à chaque image : un visage tourné ou une main devant la bouche font donc partie des cas d'échec documentés.
- Les vidéos avec plusieurs personnes. La détection du locuteur actif est proposée en option sur les trois modèles sync actuels ; MuseTalk ne propose aucun réglage équivalent.
- Le temps d'installation. Avec un déploiement auto-hébergé, vous le payez une seule fois, mais la facture est loin d'être négligeable.
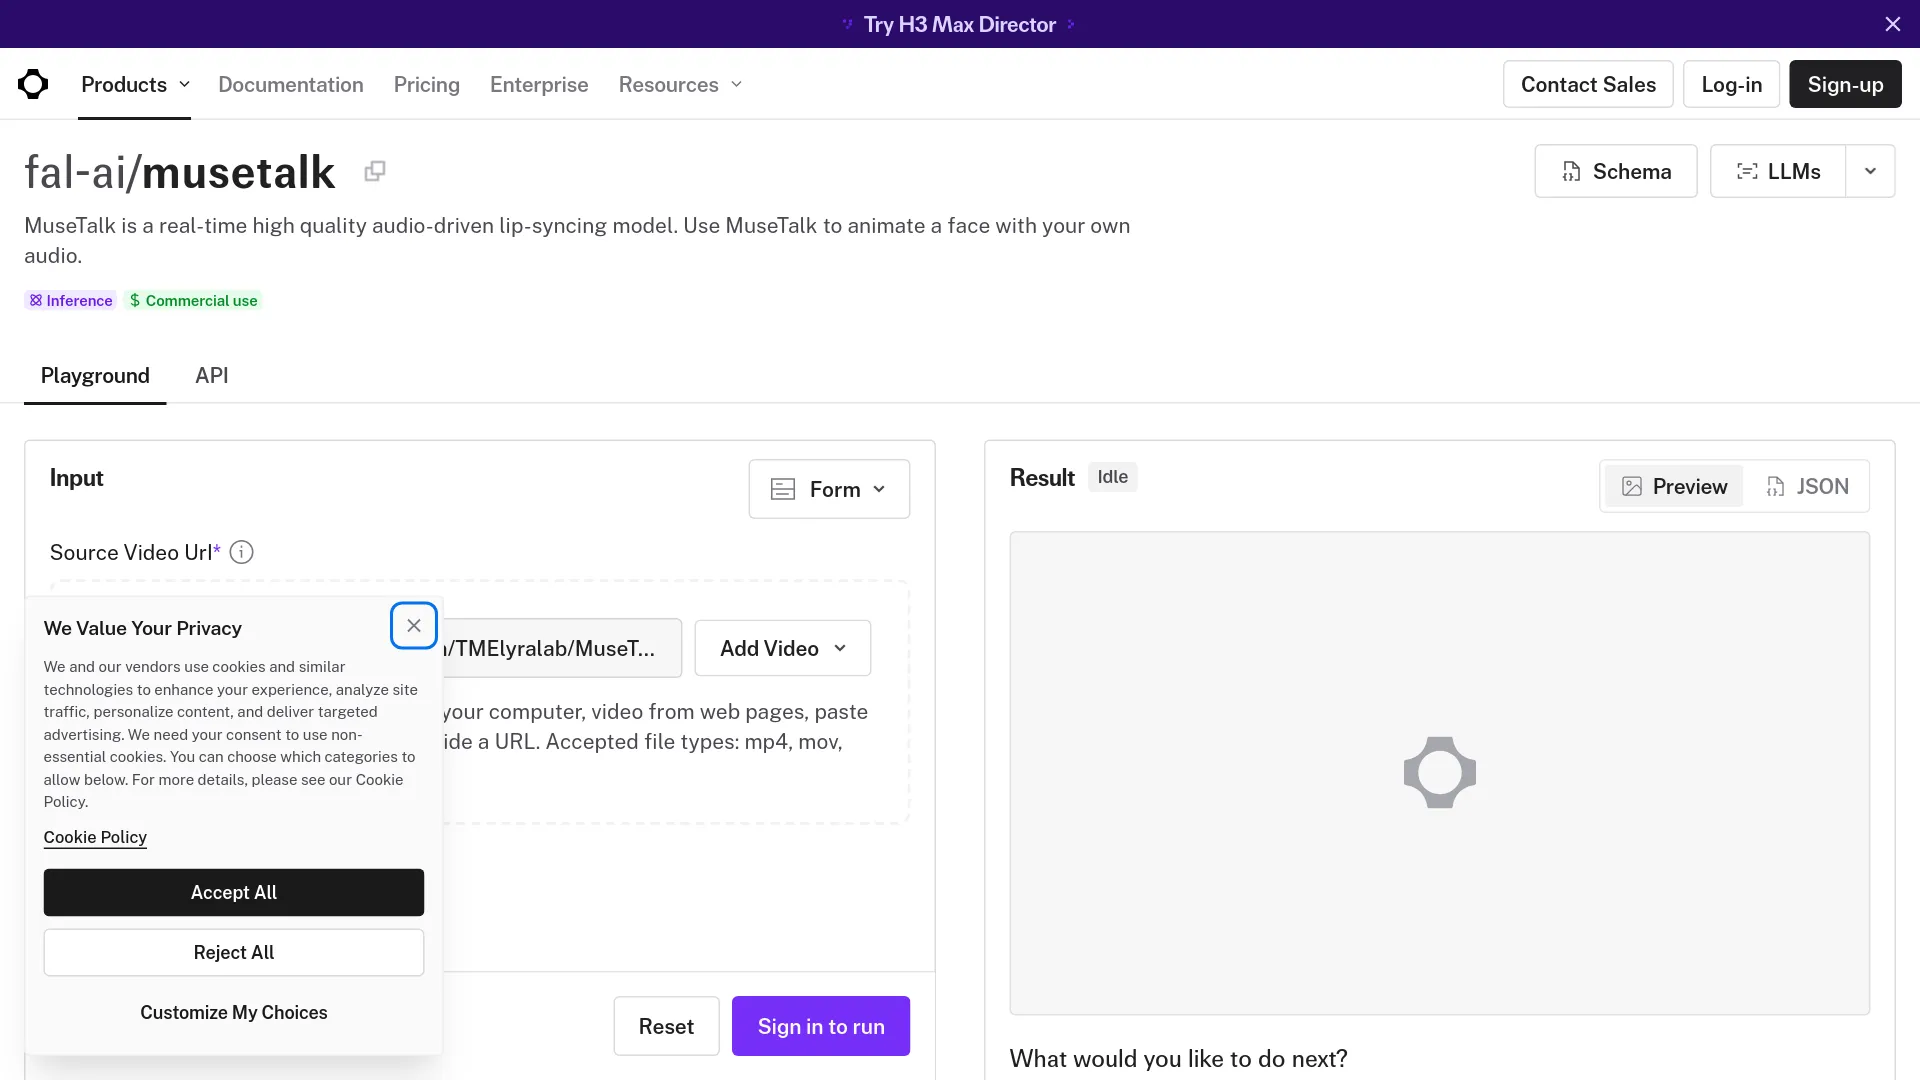
La page fal.ai de MuseTalk montre exactement ce que ce dernier avantage apporte : une URL de vidéo source, une URL audio et rien de plus. Pas d'environnement conda, pas de versions CUDA à respecter, pas d'arborescence de poids à télécharger.
Installer MuseTalk sans se battre avec les dépendances
Les retours récurrents de ceux qui ont utilisé le modèle ne concernent pas la qualité de sortie. Ils visent surtout la pile OpenMMLab. Sur r/StableDiffusion, un utilisateur qui comparait plusieurs modèles de lip sync résumait ainsi son expérience après avoir testé MuseTalk et LatentSync :
"LatentSync and Musetalk work and have similar performance... Musetalk is a hassle to set up since it depends on OpenMMLab libraries." — u/Traditional_Tap1708, r/StableDiffusion
Installez les versions indiquées dans le README avec mim, et non avec un simple pip :
- Python 3.10 dans un nouvel environnement conda, avec PyTorch 2.0.1, torchvision 0.15.2 et torchaudio 2.0.2.
mim install mmengine "mmcv==2.0.1" "mmdet==3.1.0" "mmpose==1.1.0". Une version plus récente de mmcv est la cause la plus fréquente des erreurs d'importation de mmdet.- FFmpeg dans le
PATH, vérifié avecffmpeg -version, ou indiqué explicitement via--ffmpeg_pathsous Windows. sh download_weights.shpour récupérer toute l'arborescence. Le seul UNet ne suffit pas : le script télécharge aussi sd-vae-ft-mse, Whisper,dw-ll_ucoco_384.pthde DWPose et les poids de segmentation faciale BiSeNet. Lorsqu'un fichier manque, l'erreur apparaît souvent sous la forme d'un échec de détection du visage ou de fusion, plutôt que d'un message explicite.- Convertissez la source en 25 i/s avec
ffmpeg -i input.mp4 -r 25 output.mp4. Le dépôt recommande une entrée à 25 i/s, la cadence utilisée pour l'entraînement du modèle ; une cadence différente est la cause habituelle des décalages de synchronisation. - Indiquez votre vidéo et votre fichier audio dans
configs/inference/test.yaml, puis lancezpython -m scripts.inference --inference_config configs/inference/test.yaml --result_dir results/test --unet_model_path models/musetalkV15/unet.pth --unet_config models/musetalkV15/musetalk.json --version v15.
Pour générer plusieurs fois des séquences avec le même visage, définissez une fois preparation: true dans configs/inference/realtime.yaml. Laissez le programme mettre en cache coords.pkl, latents.pt et les masques dans results/v15/avatars/, puis repassez la valeur à false. L'ajout de --skip_save_images est plus important qu'il n'y paraît : l'écriture des PNG sur le disque peut devenir le goulot d'étranglement, devant le modèle lui-même.
MuseTalk 1.5 ou 1.0 : quels poids télécharger ?
Choisissez la version 1.5. Le dépôt la présente comme la dernière version, datée du 28 mars 2025, et attribue à ses pertes perceptuelle, GAN et de synchronisation, ainsi qu'à son entraînement en deux étapes, une meilleure netteté, une meilleure cohérence d'identité et un meilleur alignement entre les lèvres et la parole.
Le seul argument en faveur de la version 1.0 est bbox_shift, qui ne fonctionne qu'avec cette version. Ce paramètre déplace verticalement la limite du masque : les valeurs positives ouvrent davantage la bouche, les valeurs négatives la referment.
Lancez d'abord le réglage par défaut : le script affichera la plage ajustable pour votre clip. Dans l'exemple du README, la plage obtenue est [-9, 9] et la valeur retenue est -7. Faites plusieurs rendus dans la plage indiquée : descendez vers les valeurs négatives si la bouche paraît trop ouverte, et montez vers les positives si elle s'ouvre à peine.
Les problèmes que vous rencontrerez — et ceux que les réglages peuvent corriger
| Symptôme | Cause | Corrigeable ? |
|---|---|---|
| L'exécution s'arrête, aucun visage détecté | Une image contient un visage tourné, masqué ou absent | Oui. Recadrez ou coupez le passage concerné |
| La bouche bouge à peine | La voix est noyée dans la musique ou la limite du masque est trop haute | Oui. Isolez les voix ; utilisez une valeur positive de bbox_shift avec la v1.0 |
| Les lèvres se désynchronisent en cours de route | La source n'est pas à 25 i/s | Oui. Convertissez-la avant le traitement |
| La bouche est floue sur un visage net | Le visage est trop petit dans l'image pour la zone de 256x256 | Partiellement. Recadrez plus serré, désactivez fp16 et ajoutez une restauration faciale |
| Jointure visible, moustache mal conservée | La synthèse du bas du visage remplace certains détails d'identité | Non. C'est une limite connue du modèle |
| Tremblements d'une image à l'autre | Les images sont générées individuellement | Partiellement. Le dépôt attribue une meilleure cohérence à l'entraînement en deux étapes de la v1.5 |
| Échec sur un visage de dessin animé ou stylisé | La distribution d'entraînement contient des visages réels | Non |
| Audio énergique sur un locuteur immobile | MuseTalk ne modifie ni les mouvements de tête ni les expressions | Non. Il faut retourner la séquence ou changer la vidéo source |
Un utilisateur qui testait le modèle avec peu de VRAM rapportait « 171s for 7 seconds of audio » et ajoutait qu'il « only works with realistic images » (u/Bartholomheow, r/StableDiffusion). Quant à la promesse de « real time », elle décrit un débit soutenu après la préparation de l'avatar, et non une latence de bout en bout. Un développeur de talking heads sur r/LocalLLaMA expliquait ainsi que, avec MuseTalk, « the preparation time is too long » (u/lonyPorgrammer) pour son cas d'usage interactif.
Quelle solution de lip sync choisir selon le projet ?
| Solution | À choisir quand | Principal compromis |
|---|---|---|
| MuseTalk auto-hébergé | Vous avez un volume important et des vidéos faciles à traiter : brouillons de localisation, avatars interactifs réutilisant un même visage sur des milliers de pistes audio, vidéos de formation internes | L'installation se compte en heures, pas en minutes ; le débit dépend du GPU loué |
| MuseTalk hébergé (Replicate, fal.ai) | Vous avez quelques clips à produire, ou souhaitez tester la qualité sur vos propres vidéos avant de déployer la solution | La même limite de 256x256, aucun indicateur de cache d'avatar dans le schéma de l'un ou l'autre endpoint, et une facturation à l'exécution |
| Modèle de lip sync payant (sync-3, lipsync-2-pro) | Vous devez livrer un résultat destiné à un client, de gros plans, des profils, des visages partiellement masqués, plusieurs locuteurs ou une sortie en 4K | 4–8 $ par minute, et les vidéos quittent votre infrastructure |
Louez une V100 pour reproduire le débit annoncé officiellement, ou une 4090 si vous diffusez en direct. Pour les endpoints hébergés, nous détaillons les deux plateformes dans notre test de Replicate et notre test de fal.ai.
FAQ sur MuseTalk lipsync
MuseTalk peut-il fonctionner sur un GPU de 6 ou 8 Go ?
Oui. Le README documente un test sur une RTX 3050 Ti Laptop de 4 Go en FP16 : l'inférence de base tient donc dans une VRAM limitée. En pratique, c'est surtout le débit qui posera problème.
256x256 est-ce la résolution de sortie ?
Non. Il s'agit de la zone faciale retouchée, ensuite réintégrée dans une vidéo qui conserve la résolution et la cadence de la source.
MuseTalk fonctionne-t-il avec des visages de dessins animés ou d'anime ?
Pas de manière fiable. Le modèle a été entraîné sur des vidéos de personnes réelles parlant face caméra, et les utilisateurs qui l'ont testé sur des entrées stylisées rapportent des résultats irréguliers.
Le chiffre de « 30 fps real time » inclut-il le prétraitement ?
Non. Il décrit le débit de génération sur une Tesla V100 après la préparation de l'avatar. La détection du visage, l'encodage latent et la première mise en cache ont lieu avant cette étape.
MuseTalk ou LatentSync ?
Choisissez MuseTalk lorsque la latence et le volume sont prioritaires : l'inférence en une étape et les avatars mis en cache réduisent fortement le coût par clip. L'utilisateur de r/StableDiffusion cité plus haut, qui a testé les deux solutions, jugeait leurs performances similaires. Le débit, plutôt que la fidélité visuelle, devient donc le critère décisif.
MuseTalk peut-il être utilisé commercialement ?
Le dépôt place son code sous licence MIT, mais les licences des dépendances ne sont pas uniformes. Whisper, le VAE, DWPose, l'analyse faciale BiSeNet et SyncNet sont distribués selon leurs propres conditions, tandis que le dépôt signale également des restrictions distinctes pour les données d'exemple. Vérifiez chaque licence avant toute mise en production.
Le compromis que ce prix ne résout toujours pas
MuseTalk permet d'aller très loin pour ainsi dire gratuitement. Là où il atteint ses limites, c'est dans la préservation de l'identité : une moustache, la forme exacte des lèvres, un visage qui remplit le cadre ou un locuteur qui tourne la tête en pleine phrase.
Pour la plupart des équipes, la réponse ne tient pas à un seul outil. MuseTalk fait le travail sur les gros volumes, tandis qu'un modèle payant prend le relais pour les plans qui seront vus en plein écran.
À lire aussi
- Higgsfield AI : avis et tarifs face à l'accès API
- Guide d'installation locale de Kokoro 82M TTS, pour générer la piste audio utilisée par MuseTalk
- Guide de Wan 2.2 Animate