託管服務的圖表標示每秒 280 tokens,但在筆電上實際執行時,速度會因硬體與執行環境不同,落在 8 到 220 tok/s 之間。Inkling 2 Mini 是離線程式代理的強力選擇:它採用開放權重、規模為 26.4B,容量約 20GB。不過,下載之前仍要先了解它在聊天、事實正確性與 API 支援方面的不足。
誰適合使用 Inkling 2 Mini?誰應該跳過?
Inkling 2 Mini 很適合某一類工作,卻不適合另外幾類,因此真正決定它是否值得用的,是工作負載,而不是排行榜上的數字。搭配工具與搜尋功能進行離線程式輔助,是它最擅長的場景;如果主要需求是聊天,或只能透過 API 使用,就不太合適。
| 你的工作負載 | Mini 的評價 |
|---|---|
| 在 32GB 以上的 Mac 或 DGX Spark 上執行離線程式代理 | 非常適合:目前最佳成績都出現在這類場景 |
| 私有長上下文工作(名義上最高 1M tokens) | 值得測試:實際使用建議先從 32K context 開始 |
| 多輪聊天或嚴格遵循指令 | 跳過:Qwen3.8-27B 在這方面的測試表現更好 |
| 目前使用託管 API | 跳過:尚未有 serverless listing,目前只有取樣與微調費率 |
接下來會拆解這個分野背後的數字:循環式架構改變了什麼、哪些 benchmark 值得參考、本機速度實際如何,以及這個價格究竟買到什麼。
Inkling 2 Mini 的架構,以及循環運算如何運作
Thinking Machines Lab 在 November 20, 2026 發表 Inkling 2 Mini,採 Apache 2.0 授權並開放權重。模型權重放在 Hugging Face,名稱為 thinkingmachines/Inkling-2-Mini;支援文字與圖片輸入、文字輸出,標示的最大 context 為 1-million-token。
| 規格 | Inkling 2 Mini |
|---|---|
| 發布資訊 | November 20, 2026,Thinking Machines Lab |
| 授權 | Apache 2.0 |
| 參數 | 總計 26.4B / 每個 token 啟用 3.4B / 循環後有效 5.4B |
| 層數 | 儲存 24 層;中間 12 層每個 token 執行 3 次(6 + 3x12 + 6 = 48 次運算) |
| MoE 路由 | 每層每個 token 從 128 個 experts 中選 8 個 |
| 精度 | 20 層採 NVFP4,最後 4 層採 MXFP8;checkpoint 約 20GB(19.5GB + 0.64GB predictor) |
| Context / 模態 | 最高 1M tokens;輸入文字 + 圖片,輸出文字 |
| 本機目標平台 | 透過 Ollama 在 32GB 以上記憶體的 Mac 上執行,或按照 model card 使用一台 NVIDIA DGX Spark |
3.4B 指的是儲存狀態下的啟用參數;把三次循環都算進去後,有效運算量約為 5.4B。權重重複使用讓模型檔案保持精簡,但也讓每個 token 需要更多運算,Hugging Face 的技術解析有更完整的說明。
循環增加的是運算量,不是儲存的知識。發布公告指出,Mini 在事實回憶方面不如更大的 Inkling 模型,因為知識量主要仍會隨總參數量增加。這也是為什麼搜尋與工具對這個模型格外重要。
哪些 benchmark 值得相信?哪些數字要打折看待?
以下分數全部來自該實驗室透過 Hugging Face model card 公開的測試工具。Mini 在工具驅動的程式工作與搜尋方面領先,但在推理、視覺能力與聊天紀律上則持平或落後。
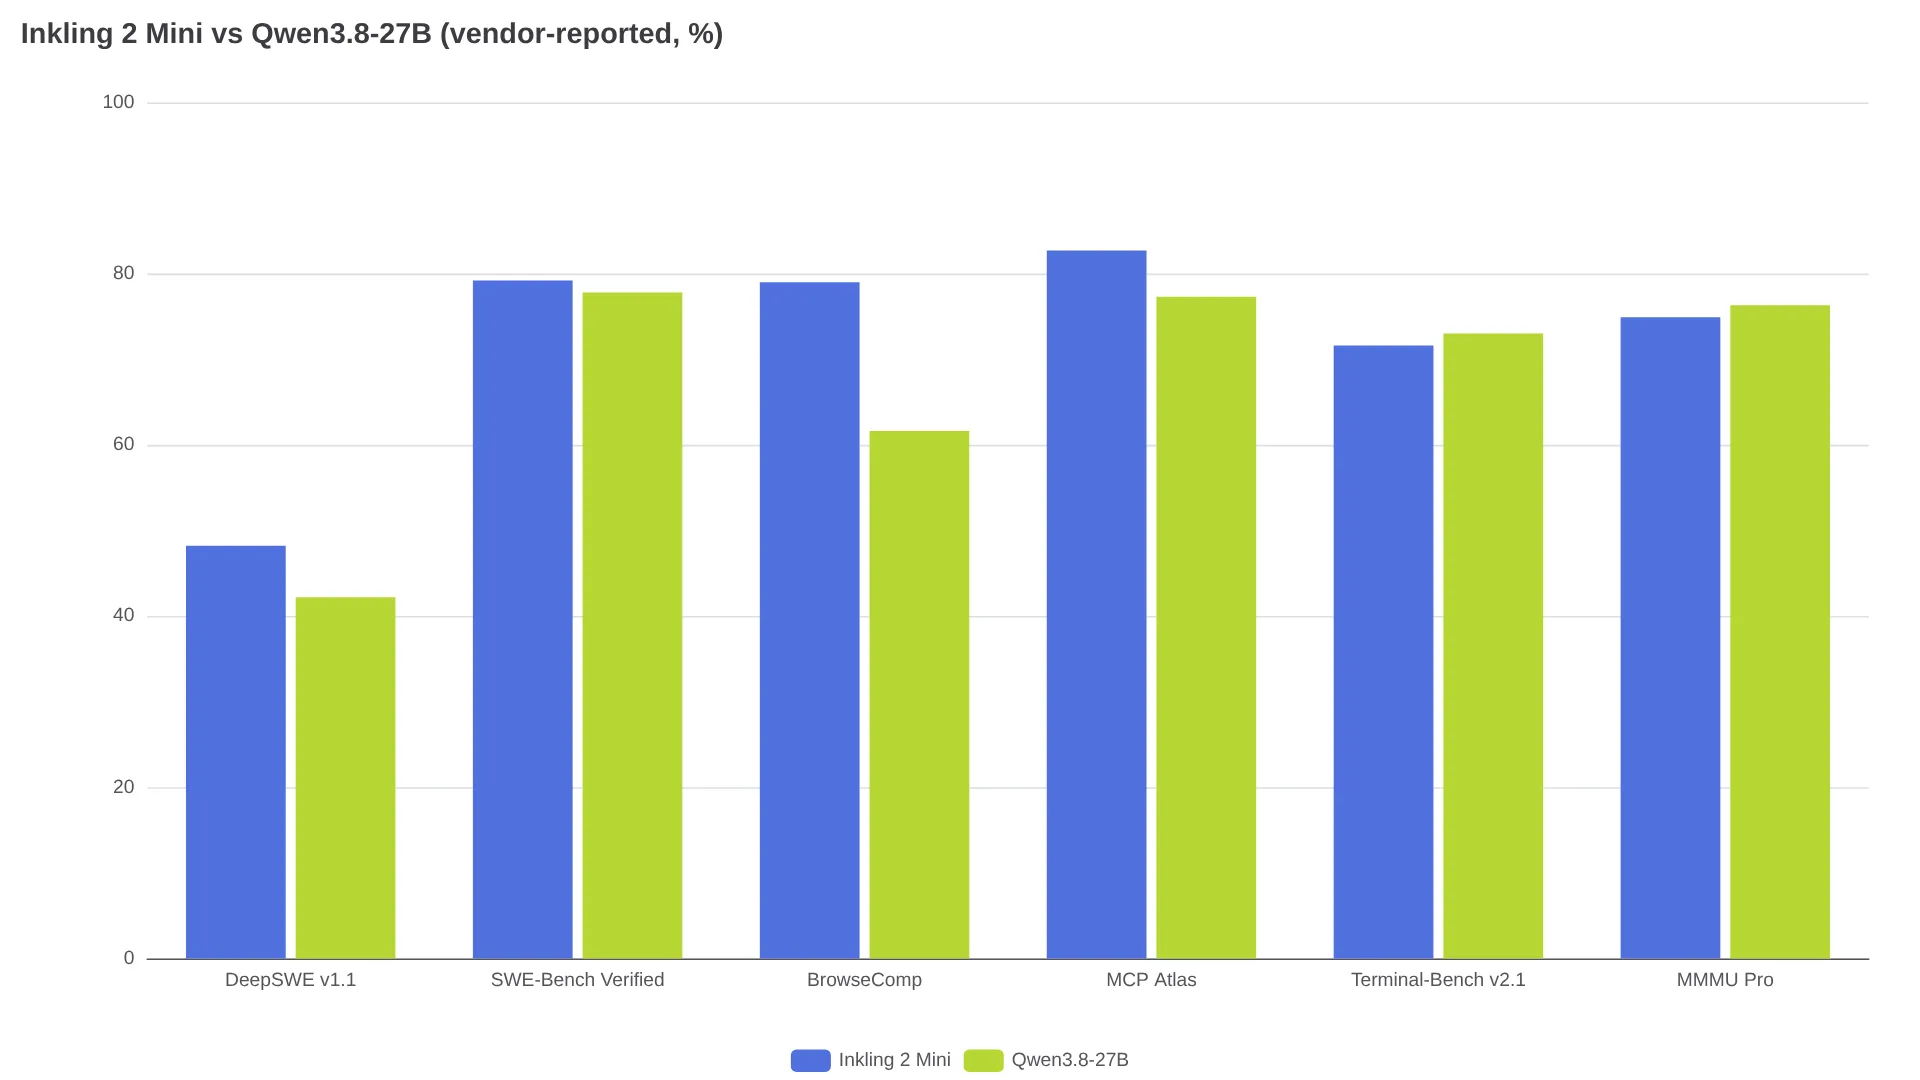
Mini 在 DeepSWE v1.1 以 48.2% 領先 Qwen3.8-27B 的 42.2%,SWE-Bench Verified 則是 79.2% 對 77.8%,BrowseComp 為 79.0% 對 61.6%,MCP Atlas 為 82.7% 對 77.3%。Artificial Analysis 的 Intelligence Index 兩者同為 20.1,但 Mini 完成該 index 任務只需 9.0 分鐘,Qwen 則需 38.2 分鐘。ARC Prize 在最高推理設定下,測得 ARC-AGI-1 為 84.5%,ARC-AGI-2 為 49.3%。
不過,同一份 model card 也列出了 Mini 落後的項目:HLE-Diamond 為 15.2% 對 15.3%,MMMU Pro 為 74.9% 對 76.3%,Terminal-Bench v2.1 為 71.6% 對 73.0%。事實正確性的差距更明顯,AA-Omniscience non-hallucination 為 63.4%,Qwen 則是 71.4%。ComplexConstraints(33.4%)與 MultiChallenge(50.0%)也落後 Qwen。
本機執行的速度,不能只看一個數字
官方 Ollama listing 與 model card 都列出 32GB Mac 或 DGX Spark,但循環式模型在早期的支援狀況,讓實際速度差異非常大。託管環境在 Artificial Analysis 測得的 280 tok/s,並不能很好預測筆電上的速度。
| 環境 | 測得速度 | 來源 |
|---|---|---|
| 託管評測(Artificial Analysis) | 280 tok/s | 第三方測量 |
| RTX 4090、修補版 vLLM + FP8/NVFP4 + drafter | 約 190-220 tok/s | Reddit 使用者,僅限修補後(基準為 117) |
| M5 Max MacBook Pro | 約 125 tok/s | @alexocheema |
| M1 Max MacBook Pro 64GB、4-bit quant | 約 20 tok/s | Hacker News 使用者 gregsadetsky,經由 eesel 的發布評測引用 |
| 早期 llama.cpp builds、各種硬體 | 約 5-10 tok/s | r/LocalLLM 討論串 |
「連 5 t/s 都跑不到。」— u/KURD_1_STAN,r/LocalLLM 比較討論串
執行環境支援度與量化方式,是速度差異的主要原因:目前的 build 比首日版本更能處理循環層,而 quant 選擇也會改變模型佔用空間。在長 context 進一步增加 KV-cache 壓力之前,建議先注意 4-bit quant 的容量;根據 Unsloth 指南(由 Crewmark 引用),建議值約為 17.6GB,另加 639MB 的 vision projector。
在一次等延遲的付款配對測試中,Qwen 以 98.2% 準確率、零筆誤配勝出;Mini 則是 96.9% 準確率、五筆誤配:
「我們在實際付款配對工作負載上測試了 Inkling 2 Mini 與 Qwen3.8-27B……Qwen:98.2% acc,0 false matches……Inkling:96.9%,5 false matches……這項工作還是用 Qwen。」— @exebat3(貼文)
實際使用上的建議是:先從 32K context 開始,遇到記憶體壓力就降低,並在評估品質之前確認你的執行環境支援循環層。
有費率,卻沒有結帳按鈕
根據 Artificial Analysis model page 引用的 Tinker 費率,每百萬輸入 tokens 為 $0.15,快取輸入為 $0.015,輸出為 $0.50;微調則是 $0.75(64K)與 $1.50(256K)。套用到實測 token 用量後,每個 index 任務約為 $0.59,Qwen3.8-27B 則是 $3.53。
但 $0.59 只是估算值,不代表目前可以直接購買的託管價格。評測當時,Mini 尚未出現在任何 serverless inference listing 中;eesel 的評測也記錄了它對 Tinker 與 OpenRouter 的查詢結果。此外,Mini 在 index 執行中產生了 161M output tokens,中位數則是 85.7M,因此每 token 價格較低的優勢,會被更高的輸出量抵銷一部分。若要自行託管,應該把硬體、電費與設定成本,和託管版 Qwen 或 frontier API 一起比較。
兩個設定值,決定它能不能順利工作
Reasoning effort 從 none(0.0)、minimal(0.1)、low(0.2)、medium(0.7)、high(0.9,預設值),一路到 xhigh/max(0.99)。根據 model card,設為 minimum 並不會完全停用推理。
較低的設定反而可能更好用:在 r/LocalLLM 的 Terminal-Bench 討論中,一名使用者在 13 項子集以 low effort 得到 10/13,但 medium effort 卻反覆逾時。另一方面,eesel 評測引用的一名 Hacker News 測試者,在未使用工具時消耗了 19,200 個 thinking tokens 仍未完成任務;開啟搜尋後雖然找到解法,卻用了錯誤的 hook 名稱。
請限制輸出 tokens 與 agent turns,將檔案系統存取放進 sandbox,並要求人工審核後再投入正式環境。model card提醒,模型可能在未經確認的情況下執行破壞性操作,也可能陷入推理循環,尤其是在除錯程式時。
下載之前,先接受這個取捨
Mini 透過重複使用中間層,在不增加 checkpoint 大小的前提下換取更多運算;該實驗室也提供可變循環的研究 checkpoint,用來研究這種行為(walkthrough)。它的問題並非抽象的理論風險,而是很具體:除錯時陷入循環、使用者回報回覆中途切換成日文,以及需要嚴格限制的工具呼叫。如果你的目標是搭配防護措施進行離線程式工作,Mini 值得下載;如果需要穩定的聊天體驗或一鍵可用的 API,則應該先等等。
常見問題
Inkling 2 Mini 能在筆電上執行嗎?
可以,但前提是使用合適的 build:透過 Ollama 或目前版本的 llama.cpp,在 32GB 以上的 Apple silicon Mac 上執行,最好使用 4-bit(約 17.6GB,另加 projector)。較舊的 M1 Max 預期約 20 tok/s,M5 硬體則可達 100+ tok/s;未修補的執行環境可能只有個位數速度(請參考上表)。
Inkling 2 Mini 比 Qwen3.8-27B 好嗎?
程式代理方面是,聊天方面不是。請參考上方圖表:Mini 在 DeepSWE、SWE-Bench Verified、BrowseComp 與 MCP Atlas 領先;Qwen 則在 Terminal-Bench v2.1、MMMU Pro、事實正確性與受限指令方面領先。所有數字都是透過 model card 公開的供應商測試結果。
為什麼來源同時寫 3.4B 與 5.4B active parameters?
3.4B 是儲存狀態下的啟用參數;5.4B 則是在此基礎上加上三次循環,每次約 1.0B。評估記憶體需求時看 3.4B,評估運算量時看 5.4B。
現在可以透過託管 API 呼叫 Inkling 2 Mini 嗎?
不行,評測當時尚未有 first-party serverless endpoint。根據 eesel 的查詢,Tinker 提供取樣與微調費率,但沒有 Mini 的 serverless listing。你可以在本機執行 Hugging Face 權重,或等待託管服務支援。
如何避免推理循環?
依照 model card 的建議,先嘗試 low(0.2)effort,限制輸出 tokens 與 agent turns,並將工具放進 sandbox。
延伸閱讀:想了解 594B sibling Mini 的答案,可參考 Inkling 2 Small review and API pricing;想把 Mini 放進各種代理選項中比較,可閱讀 Best LLM for coding agents in 2026;若要了解 Mini 在本機依賴的執行環境,請看 llama.cpp v1.0 guide。