如果你的長上下文 Agent 最怕的是答錯,而非單純追求最低 Token 單價,Neon 的 high 模式是這批模型裡最值得看的選擇。至於每個任務的最低成本,Astra 和 Sol 仍更便宜。本文彙整上市當日可取得的官方規格、排行榜與獨立測試;我沒有親自執行 Neon 測試。
Gemini 4 Neon:面向 Agent 的更快 Carbon,但有一項取捨
根據 Google 與 9to5Google,Gemini 4 Neon 於 2026 年 11 月 18 日以 gemini-4-neon 發表,定位在 Gemini 4 的 Hydrogen 與 Carbon 之間。Google 表示,它能以更低的單一任務成本,比 Carbon 更快完成端到端工作;DeepMind 員工也形容它比 Carbon 更便宜、更快(@_mohansolo)。它在 Artificial Analysis Index 的 xhigh 設定以 61 分名列第 3,並在 Agent Arena 的 4,200 多次工作階段中,以 1336 分排第 2。此次查閱的發表資料未公布 Opus 5.5 和 Fable 5.2 在同一 Arena 看板上的成績,因此下文改以指數排名與相同任務測試進行比較。
API 定價、上下文長度與可用平台
依 Google 公布資料,Neon 每百萬輸入 Token 為 $3、輸出 Token 為 $15,快取輸入 Token 為 $0.15。上下文窗口是 1,048,576 Token,單次回應上限為 65,536 Token。推理等級分為 low、medium、high(預設)與 xhigh,都會按輸出計費;等級愈高,可能用掉更多推理 Token,帳單也會上升。DataCamp 的等級說明與 SpringPrompt 的 API 備註皆記載預設值為 high。
根據 eesel 的 API 檢查,Neon 僅提供付費方案,沒有免費層級。依 Google 和 9to5Google 資訊,可在 AI Studio 的付費 API、Gemini for business、Antigravity(Pro/Ultra)、Gemini app(Pro/Ultra,取代 Argon)、Android Studio 使用;也已登上 Cursor,在 CursorBench 預設 effort 下達 63.7%,高於 Hydrogen 的 57.3%,數據出自 Cursor。
| 模型 | 每 1M 輸入/輸出 | 預設推理等級 |
|---|---|---|
| Gemini 4 Neon | $3/$15,快取 $0.15 | high |
| Gemini 4 Hydrogen | $1.50/$7.50 | high |
| Gemini 4 Carbon | 至 11 月 30 日為 $2/$10,之後為 $4/$20 | medium |
| Claude Opus 5.5 | $4/$20,測試使用 max 設定 | 測試使用 max |
| GPT-6.2 Sol | $2/$10,測試使用 max 設定 | 測試使用 max |
競品價格與最佳設定標示整理自 eesel 的比較表。從 12 月 1 日起,Neon 的每 Token 成本會比 Carbon 低 25%。更多細節見:Neon pricing。
若要固定推理等級,請用 API;若希望由平台管理額度,則使用 app 或 Antigravity。額度回報僅能作為規劃時的軼聞參考:依 使用者回報,每次聊天約消耗 Pro 額度的 ~1–3%,一次 10 分鐘、使用 3 個子 Agent 的執行則約 ~5%。
對上 Opus 5.5、Fable 5.2 與 Sol 的基準成績
以下成績由供應商透過 Google 回報,並由 eesel 與 DataCamp 彙整。
| 測試 | Neon | 競品 | 重點 |
|---|---|---|---|
| Vals Index | 70.9%,第 2 | Fable 約 71.3% | 接近榜首 |
| AutomationBench | 56.3%,第 1 | Opus 42.5%,Sol 41.3% | Agent 領先 |
| GraphWalks 256K–1M | 95.2% | Opus 66.8%,Sol 80.1% | 長上下文領先;部分 Argon 使用者回報過度摘要,建議先重跑最長檔案(thread) |
| Terminal-Bench 4.1 | 65.2% | Opus 65.8% | 幾乎平手,Opus 高 0.6 |
| FrontierCode 2.0 | 46.2% | Opus 47.3% | Opus 高 1.1 |
| CursorBench 4.1 | 63.7–65.4% | Opus 58.1% | Neon 在預設 effort 領先 |
若改看每個任務的成本,Token 單價得出的印象就會翻轉,資料來自 Artificial Analysis via eesel:
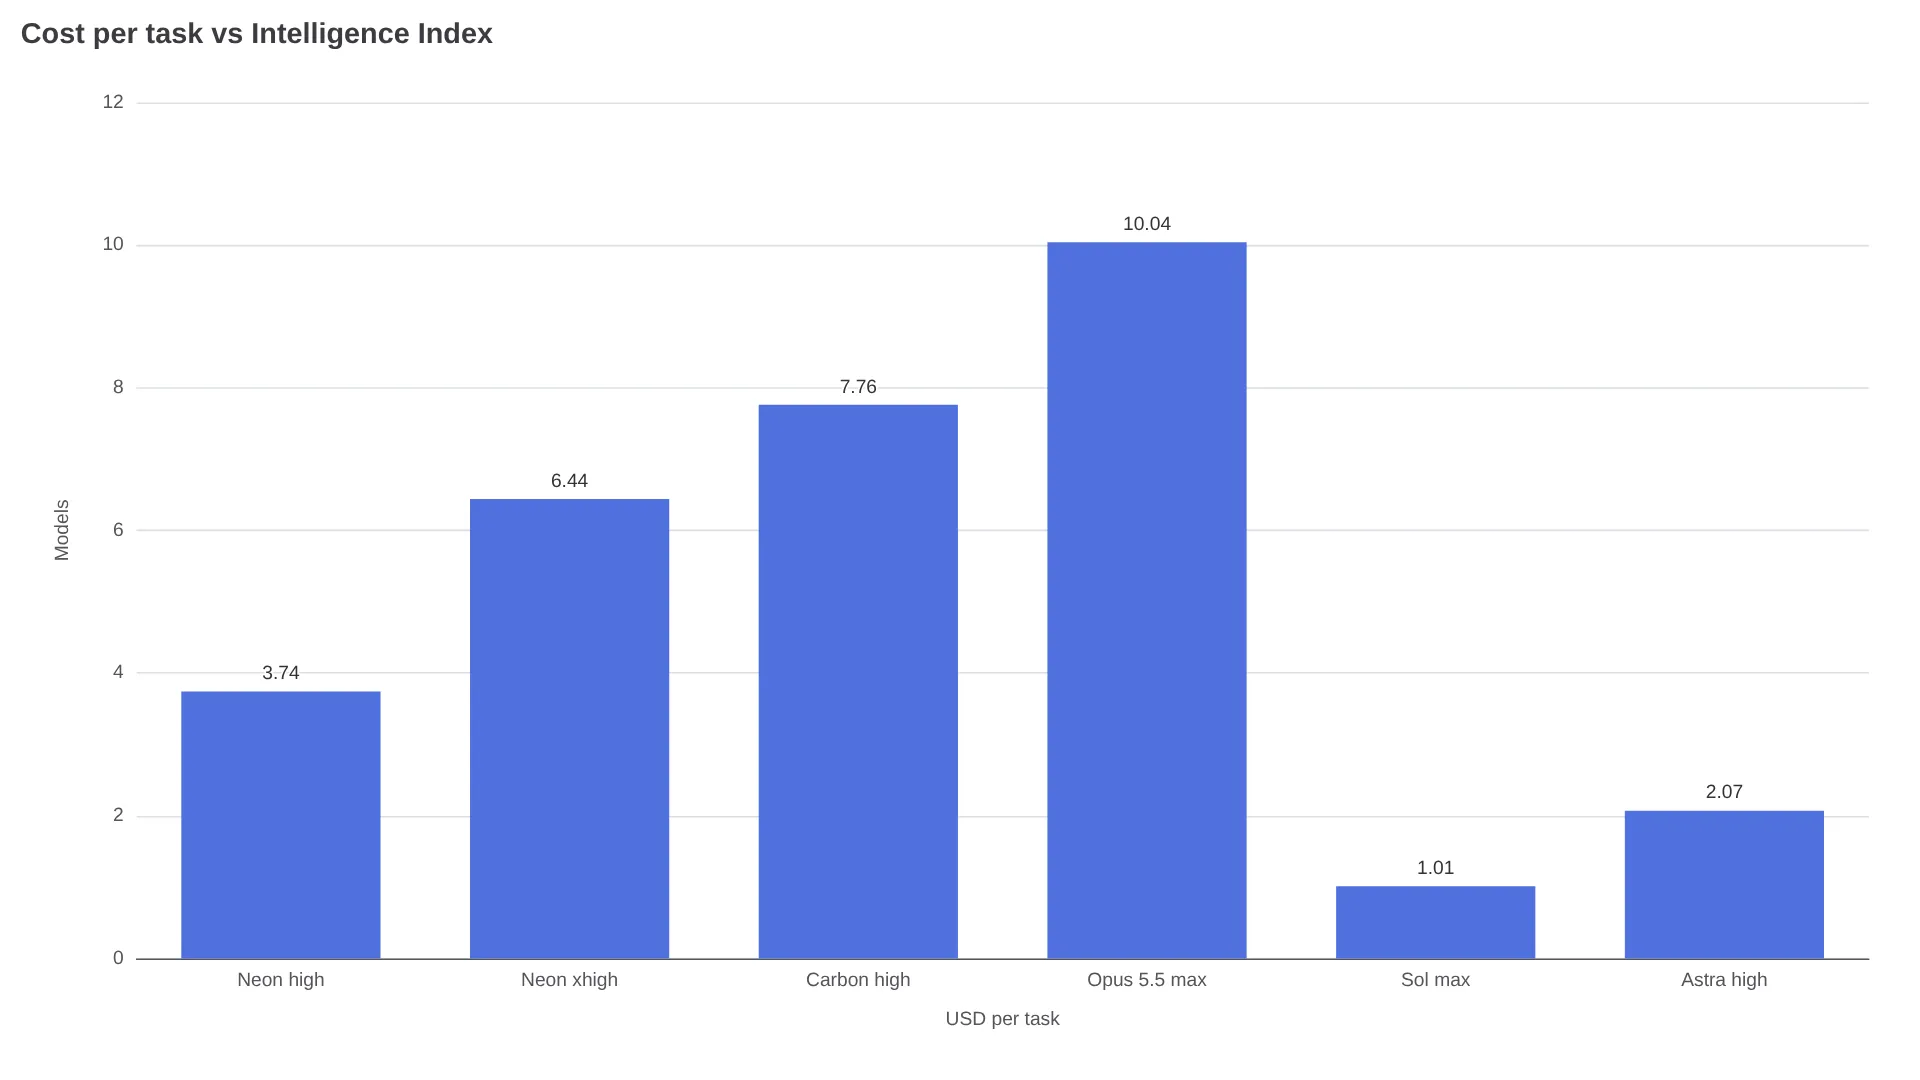
Neon high 得分 59.6,成本 $3.74、耗時 14.8 分鐘;Carbon high 為 60.0,成本 $7.76、耗時 37.2 分鐘;Opus max 為 59.1、成本 $10.04;Astra high 為 60.1、成本 $2.07;Sol max 為 57.3、成本 $1.01。Neon xhigh 可達 61.4,成本 $6.44、耗時 21.5 分鐘。除非多出的 1.8 分值得 $2.70 和 6.7 分鐘,否則建議使用 high。
Neon 對 Fable 5.2:早期回饋更適合分工搭配
在供應商測試框架的 SWE-sweep(Antigravity harness)中,Neon 為 39.0%,Opus 為 10.1%,Sol 為 8.3%。換成共用 mini-SWE harness,成績則為 Neon 12.8%、Sol 11.6%、Opus 3.6%,資料出自 DataCamp。這個看似巨大的落差,很大一部分來自測試框架,而不是模型本身的純粹差異。
「我讓 Fable 5.2 負責編排與開發,Neon 擔任程式撰寫 Agent;這是我跑過最好的組合。」— u/1969Stingray(thread)
從軼聞回饋看,使用者傾向讓 Fable 負責編排、Neon 負責實作,但仍應在自己的儲存庫驗證。依 eesel 數據,AA-Omniscience 上,Neon 的「明知不該答卻給出錯誤答案」比例為 14%,低於 Opus 的 50%、Sol 的 55%,以及 Astra 和 Fable 的 58%;但其正確覆蓋率為 59–60%,低於 Astra 的 66% 與 Fable 的 77%。
實測觀察:西洋棋、商品頁與 105 個真實 bug
| 測試 | 結果 | 限制 |
|---|---|---|
西洋棋頁面,medium 跑 3 次(DataCamp) | Neon 3/3,成本 $0.83–$1.06;Carbon 1/3,兩次碰到 65K 上限;完成 16 局,零非法走法 | 僅一項任務;Carbon 若使用背景模式,可能可以完成 |
| CatalogBench 事實正確性(SpringPrompt) | 3 次皆有 78.6% 可直接發布,35 個模型中第 1;能從包裝讀取規格 | 銷售僅 32.1%,簡報排第 24,問卷預算項排第 22 |
| 105 個重新植入的 bug(@PawelHuryn) | Neon xhigh 63,Astra 62.7、Fable 58、Carbon 57.3 | 單一測試者 |
SpringPrompt 透過 OpenRouter 使用 medium,Google API 的預設則是 high,因此輸出冗長程度不同。另有零星 AI Studio 洩漏回報(thread)。聊天場景方面,eesel 的計時顯示 Neon xhigh 首 Token 要 56.5 秒,因此互動式回覆宜選 medium 或 Hydrogen。
依工作負載選模型
| 工作負載 | 建議選擇 | 原因 |
|---|---|---|
| 高難度 Agent、長文件、重構 | Neon high | 59.6 分、成本 $3.74、Agent Arena 第 2、西洋棋 3/3 |
| 最長期的建置工作 | Carbon,依 Google 的產品家族定位 | Google 將 Carbon 保留給最困難的專案;本文沒有同任務的驗證測試 |
| 編排加程式撰寫 | Fable 主導 + Neon 程式 Agent | 依上述軼聞組合;先自行驗證 |
| 最低單一任務帳單 | Sol max $1.01;Astra high $2.07 且分數更高 | 兩者在 AA-Omniscience 的錯答率都更高 |
| 互動式聊天 | Hydrogen 或 Neon medium | xhigh 的首 Token 延遲對聊天太高 |
| 受監管的使用情境 | 等文件齊備後再決定 | 截至 11 月 19 日,完整安全報告仍待發布;僅在符合自身所需文件後核准使用 |
用一個下午自行驗證
以相同提示、相同檔案與相同推理預算,分別測試 Neon high、你目前的預設模型,再加上一個低價替代方案。記錄成功率、成本、時間與錯誤答案。對你的工作佇列而言,這一次比較比任何排行榜都更有意義。Opus 端的成本計算可參考:Opus 5.5 review、Fable 5.2 review。